Raven: 하네스의 하네스, 모델-하네스 쌍을 조합하는 에이전트 생태계
"이제 질문은 '한 도메인에 더 강한 하네스를 어떻게 만들까'가 아니라, '전문 하네스를 자동으로 만들고, 경험으로 개선하고, 도메인을 넘어 조합하려면 어떻게 해야 하나'다."
2026년 9월, EverMind AI가 Raven: The Harness of Harnesses for Composable Agentic Intelligence(arXiv 2609.33439)를 공개했다. 제목이 꽤 직설적이다. 하네스(harness)란 모델을 둘러싼 도구 인터페이스, 컨텍스트/메모리 관리, 스킬, 실행 정책, 복구 메커니즘의 묶음인데, Raven은 이 하네스들을 다시 묶는 상위 하네스를 표방한다. 코드는 github.com/EverMind-AI/Raven에 공개되어 있다.
이 블로그에서 예전에 다룬 Effective harnesses for long-running agents 글이 "하나의 코딩 에이전트를 장시간 돌리기 위해 하네스를 어떻게 설계하나"를 다뤘다면, 이번 글은 그 후속편으로 "서로 다른 하네스를 가진 에이전트 여러 개를 어떻게 하나의 작업 그래프로 엮나" 를 다룬다. 그 글 말미의 열린 질문, "범용 에이전트 하나가 나을까, 특화된 여러 에이전트가 나을까"에 대한 한 가지 답변이기도 하다.
원문: https://arxiv.org/abs/2609.33439
🤔 배경: 하네스가 복잡해질수록 생기는 두 가지 문제
에이전트의 실질적 능력은 모델만으로 정해지지 않는다. 같은 모델이라도 어떤 도구를 노출하고, 컨텍스트를 어떻게 자르고, 완료를 어떻게 판정하느냐에 따라 결과가 갈린다. 저자들은 여기서 두 가지 문제를 짚는다.
- 수동 하네스 설계는 확장이 안 된다. 도구와 실행 조건이 늘수록 서로 얽힌 설계 선택지가 폭발하고, 이걸 모델마다·도메인마다 손으로 맞추기 어렵다.
- 특화 하네스는 일반성이 떨어진다. 리서치용 하네스와 코딩용 하네스는 도구, 작업 컨텍스트, 출력 형식에 대한 가정이 다르다. 둘을 합치려면 서브태스크를 적절한 실행자에 매칭하고 호환되는 핸드오프를 만들어야 한다.
논문이 드는 예는 FPS 게임 개발이다. 요구사항 조사, 게임플레이 프로그래밍, 비주얼 디자인, 통합 테스트, 운영까지 단계마다 도구와 완료 기준이 다르고, 앞 단계의 산출물이 뒤 단계의 입력이 된다. 이걸 하나의 범용 하네스로 때우기보다, 각 단계에 맞는 모델-하네스 쌍을 조합하자는 것이 Raven의 출발점이다.
🧠 핵심 아이디어: 모델-하네스 쌍이 조합의 단위다
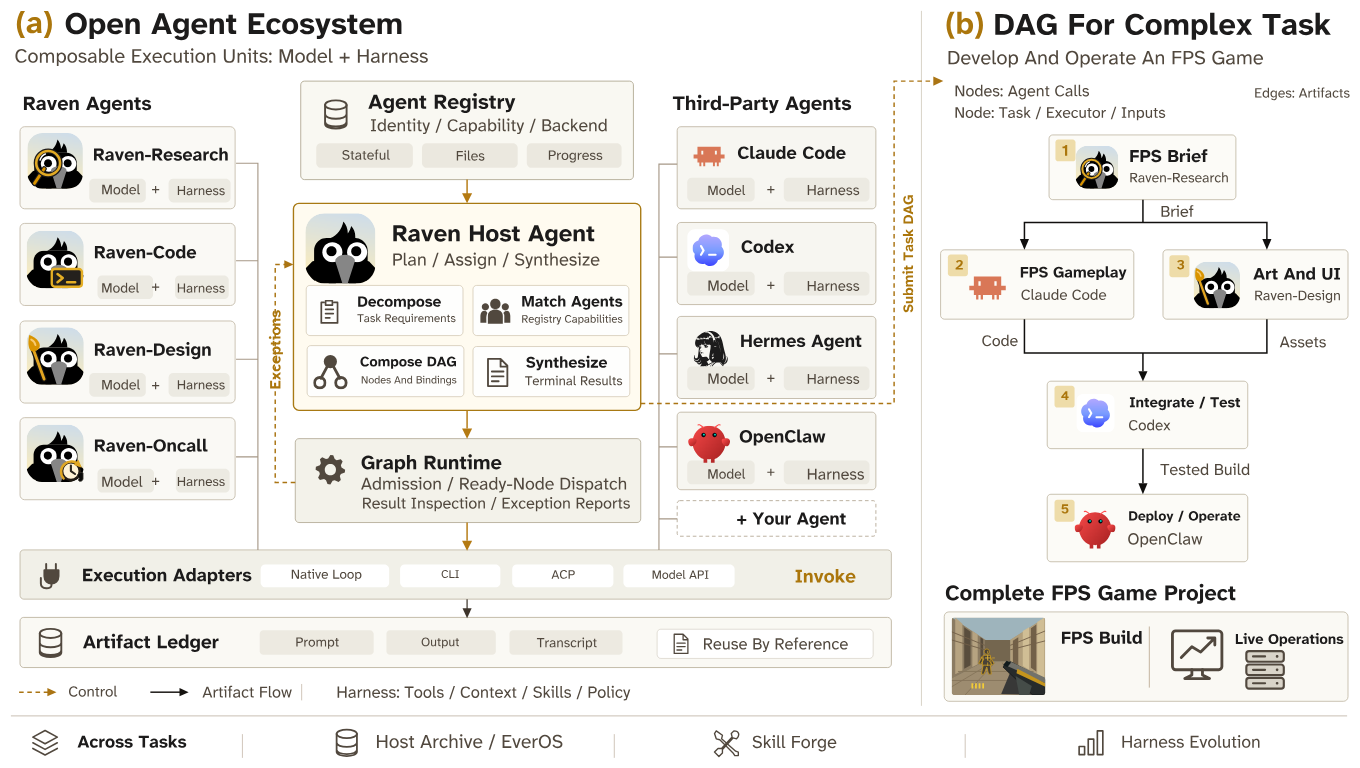
그림 (a)가 전체 구조다. 왼쪽에는 Raven이 직접 만든 네 전문 에이전트(Raven-Research, Raven-Code, Raven-Design, Raven-Oncall), 오른쪽에는 Claude Code, Codex, Hermes Agent, OpenClaw 같은 독립적으로 개발된 에이전트가 있다. 이들은 전부 "Model + Harness"라는 동일한 단위로 Agent Registry에 등록된다. 레지스트리 항목은 이름, 능력 설명, 실행 백엔드(인프로세스 Raven 루프 / CLI 프로세스 / ACP 연결 / OpenAI 호환 API)를 묶고, 계획에 영향을 주는 세 가지 능력 태그(대화 지속 가능 여부, 로컬 파일 접근 가능 여부, 진행 상황 스트리밍 여부)를 기록한다.
가운데 Host Agent가 핵심이다. 사용자 목표를 분해하고(Decompose), 레지스트리 능력에 맞춰 에이전트를 매칭하고(Match Agents), 노드와 바인딩으로 DAG를 구성하고(Compose DAG), 마지막 결과를 합성한다(Synthesize). 실행 어댑터는 각 에이전트의 도구와 내부 실행 정책을 그대로 보존한 채 공통 오케스트레이션 인터페이스에 연결한다. 즉 Claude Code는 Claude Code답게 돌되, 입출력만 Raven의 아티팩트 장부(Artifact Ledger)를 통과한다.
그림 (b)의 FPS 예시가 이 구조의 쓰임새를 보여준다. 노드는 에이전트 호출, 엣지는 아티팩트 의존성이다. 리서치 브리프가 게임플레이 개발과 아트 제작에 병렬로 들어가고, 둘의 산출물이 통합/테스트 노드로 모인 뒤 배포/운영으로 이어진다. 하단에는 작업을 넘어 유지되는 세 축, Host Archive/EverOS(메모리), Skill Forge(스킬), Harness Evolution(하네스 진화) 이 깔려 있다.
📐 이론: 조합이 언제 개별 에이전트보다 넓은 task coverage를 주는가
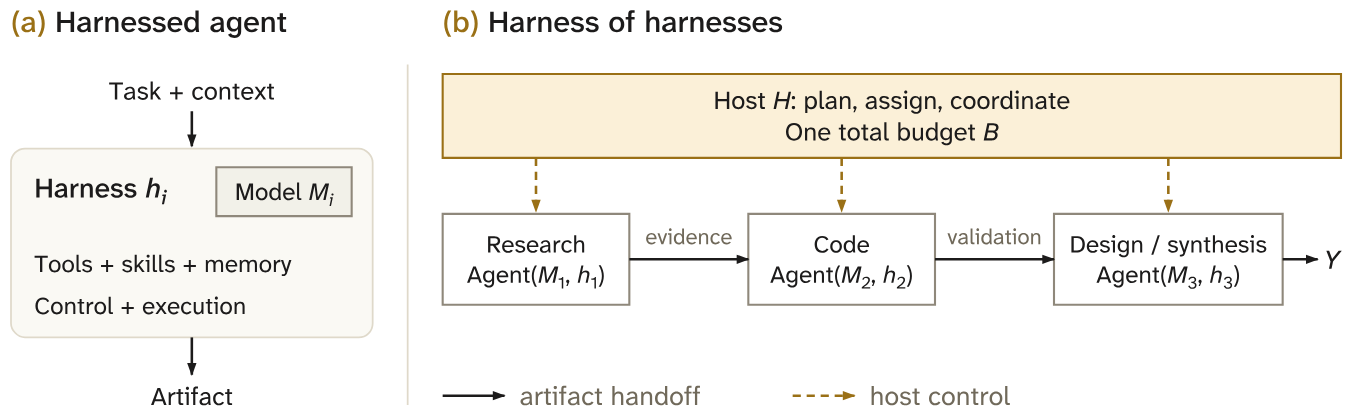
이 논문의 차별점 중 하나는 "조합하면 좋다"를 말로 하지 않고 공통 자원 예산 아래의 신뢰 가능한 task coverage로 형식화했다는 점이다. 핵심 정의만 따라가 보자.
모델 와 하네스 가 만드는 에이전트 는 관측 이력을 받아 행동 분포를 내는 확률적 정책이다. 시스템 (호스트가 조정하는 또는 단독 에이전트 )가 과제 를 예산 안에서 성공시킬 확률과 capability set은 다음과 같다.
여기서 중요한 건 의 비용 에 계획, 워커 실행, 핸드오프, 런타임 검증, 재시도가 전부 포함된다는 점이다. "조정 비용은 공짜"라는 흔한 가정을 쓰지 않는다. 또 성공 판정 는 객관적 정답 기준이지, 에이전트나 판정 모델이 "완료"라고 선언하는 것과 구분된다.
계획 는 DAG , 노드별 실행자 배정 , 입력 조립 , 계약(contract) , 스케줄 , 예산 할당 로 구성된다. 각 노드에는 전제조건 와 사후조건 , 각 엣지에는 전달 충실도 라는 타입된 계약이 붙는다. 이 계약들이 맞물리고(호환성) 각 노드의 지역 오류가 이하로 묶이면, 호스트 수준 신뢰도는 다음과 같이 내려온다(Proposition 1).
는 호스트가 유효한 계획을 못 내놓을 확률(계획 오류), 는 노드·엣지 오류를 누적한 상한이다. 그리고 개별 에이전트를 넘어서는 능력(Corollary 1)은 조건 하나로 정리된다.
즉, 조합 시스템의 신뢰도 하한이 임계값 를 넘고, 동시에 어떤 단독 에이전트도 같은 예산에서 그 임계값에 못 미치면, 그 과제는 "조합으로만 풀리는 새 과제" 에 들어간다. 이를 위한 전제가 분해 수준 상보성(Definition 3)이다. 모든 노드에 적격 실행자가 있어야 하고(), 동시에 모든 노드를 혼자 다 맡을 수 있는 실행자는 없어야 한다().
논문은 장난감 예시로 이를 명시적으로 구성한다. 독립 공정 비트 의 패리티를 묻는 과제에서 은 만, 는 만 읽을 수 있고 는 둘 다 못 읽는다. 각 단독 에이전트의 성공률은 를 못 넘지만, 세 노드 계획(읽기 → 읽기 → 패리티 계산)은 예산만 충분하면 이다. 저자들은 솔직하게 덧붙인다. 이 결과는 새 과제 coverage를 보장할 뿐, 단독 에이전트의 coverage를 전부 포함한다거나 평균 성능이 오른다는 뜻은 아니며, 두 인터페이스를 다 가진 단일 하네스보다 낫다는 주장도 아니다. 그래서 실험에는 비슷한 모델·도구·총비용을 쓰는 강한 단독 에이전트 베이스라인이 필요하다고 못박는다.
Corollary 2는 이를 과제 패밀리로 확장한다. 패밀리 전체에서 균일하게 , , 가 성립하면 패밀리 전체가 에 포함된다. 이 이론이 Raven 구성요소에 역할을 부여한다. 오케스트레이션은 계획을 만들고(), 내장·연결 에이전트는 계약 실현자 후보를 공급하고(), EverOS와 Skill Forge는 컨텍스트와 스킬을 구성하며, 하네스 진화는 비교 대상 정책 자체를 바꾼다.
🔍 방법 상세 1: Host Agent의 분해·할당·의존성 관리
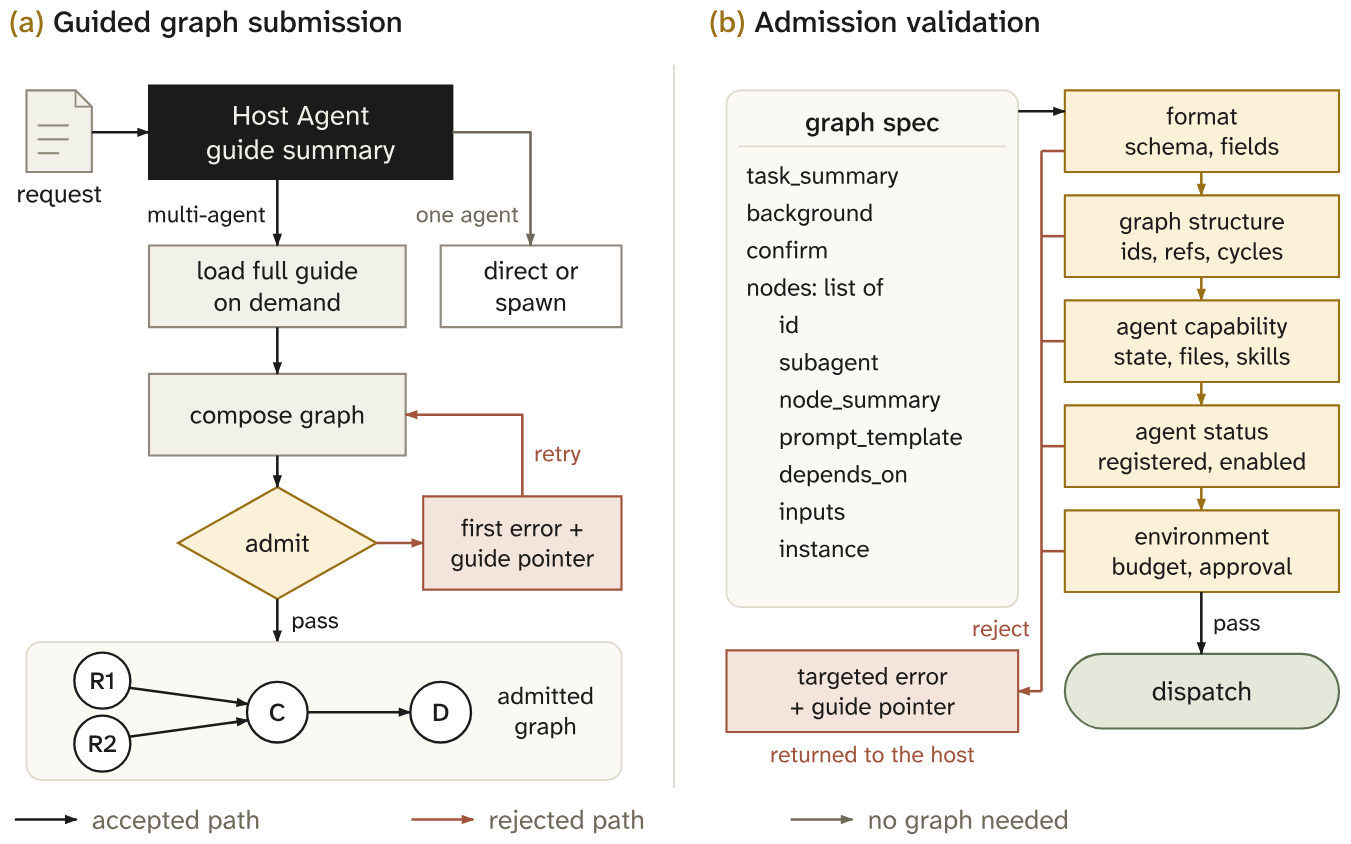
AutoGen이나 MetaGPT처럼 하나의 프레임워크 안에서 역할 프롬프트로 에이전트를 구분하는 방식과 달리, Raven은 도구·컨텍스트 처리·제어 정책이 전부 다른 이질적 하네스를 묶는다. 그래서 협업 구조를 명시적으로 만든다. 호스트는 타입된 의존성 그래프를 제출하고, 런타임은 워커 시작 전에 검사하며, 모든 핸드오프는 기록된 아티팩트를 통과한다.
단계적 가이드 공개. 모든 턴의 컨텍스트에 오케스트레이션 규칙 전체를 넣으면 그래프가 필요 없는 턴에도 입력 비용이 든다. 그래서 평소엔 짧은 요약만 싣고, 여러 에이전트가 필요하다고 판단한 시점에 전체 가이드(노드 배선, 플레이스홀더 문법, 동시성 한도, 단일 위임이 나은 경우)를 로드한다. 거부된 그래프는 검증 오류와 가이드 포인터를 함께 돌려받는다.
역방향 그래프 구성. 호스트는 요청된 산출물에서 거꾸로 노드를 만든다. 각 노드는 식별 가능한 출력과 그것을 만들 실행자가 있어야 하고, 한 노드의 입력이 다른 노드의 출력을 요구할 때마다 의존성을 추가한다. 노드 레코드는 다음 필드로 구성된다.
프롬프트 템플릿 에는 {{ id.output }}로 상위 노드 출력을 끼워 넣거나, {{ id.output_path }}로 경로만 넘길 수 있다. 파일 접근이 가능한 코딩 에이전트에게는 긴 리서치 보고서를 통째로 프롬프트에 넣는 대신 경로를 주고, 파일 접근이 안 되는 에이전트에게는 내용을 준다. 삽입된 파일·노드 내용은 untrusted data로 표시되어 호스트 지시와 구분된다. 는 상태 유지 에이전트의 대화를 이어가는 핸들로, 같은 핸들을 공유하는 노드는 같은 세션에서 순차 실행된다.
Admission 검증. 디스패치 전에 다섯 그룹의 검사를 순서대로 통과해야 한다(표 1). 형식(JSON 파싱, 필드 타입), 그래프 구조(고유 식별자, 해석 가능한 의존성, 경로 범위, 비순환성), 에이전트 능력(상태 없는 에이전트에 인스턴스 공유 금지, 파일 접근 없는 에이전트에 경로 참조 금지), 에이전트 상태(등록·활성화 여부), 환경(서브에이전트 내부에서의 재귀 위임 거부, 디스패치 예산, 사용자 승인). 첫 실패에서 멈추고 문제 노드와 필드를 지목하며, 여러 메시지는 수정 방법까지 제안한다. 검증이 디스패치보다 앞서므로 거부된 그래프는 호스트 턴 하나만 소비하고 부분 실행을 남기지 않는다.
의존성 기반 스케줄링과 완료 판정. 노드는 모든 선행 노드가 completed이면서 판정이 끝난(settled) 상태일 때만 ready가 된다. 에이전트가 응답을 돌려줬다고 완료가 아니기 때문이다. 출력 한도에 걸려 끊겼거나, 요청된 아티팩트 없이 성공을 보고했을 수 있다. 그래서 독립적인 판정 모델 호출이 프롬프트, 출력, 실행 기록 꼬리를 읽고 accomplished / not accomplished를 제약된 도구로 답한다. 부정 판정은 범주(사용자 입력 누락, 도구 실패, 상위 출력 사용 불가, 출력 한도 등)와 근거를 명시하고, 해당 노드의 출력 참조는 사라져 후속 노드가 소비할 수 없다.
예외 해결과 명확화 요청. 판정에 실패한 노드는 exception 상태로 걸리고, 호스트는 보고서를 보고 계속(continue), 포기(abandon), 남은 워크플로 재계획(replan) 중 하나를 고른다. 재계획은 새 run ID로 시작하되 완료된 노드는 참조로 재사용한다. 워커가 실행 중에 질문을 던지면 호스트가 먼저 대화와 EverOS 기억으로 답을 시도하되, push, delete, send, pay 같은 행동 승인 요청에는 절대 자동 응답하지 않는다.
💡 방법 상세 2: 경험 축적 — 하네스 진화, EverOS, Skill Forge
하네스 자기 진화 (HarnessBank)
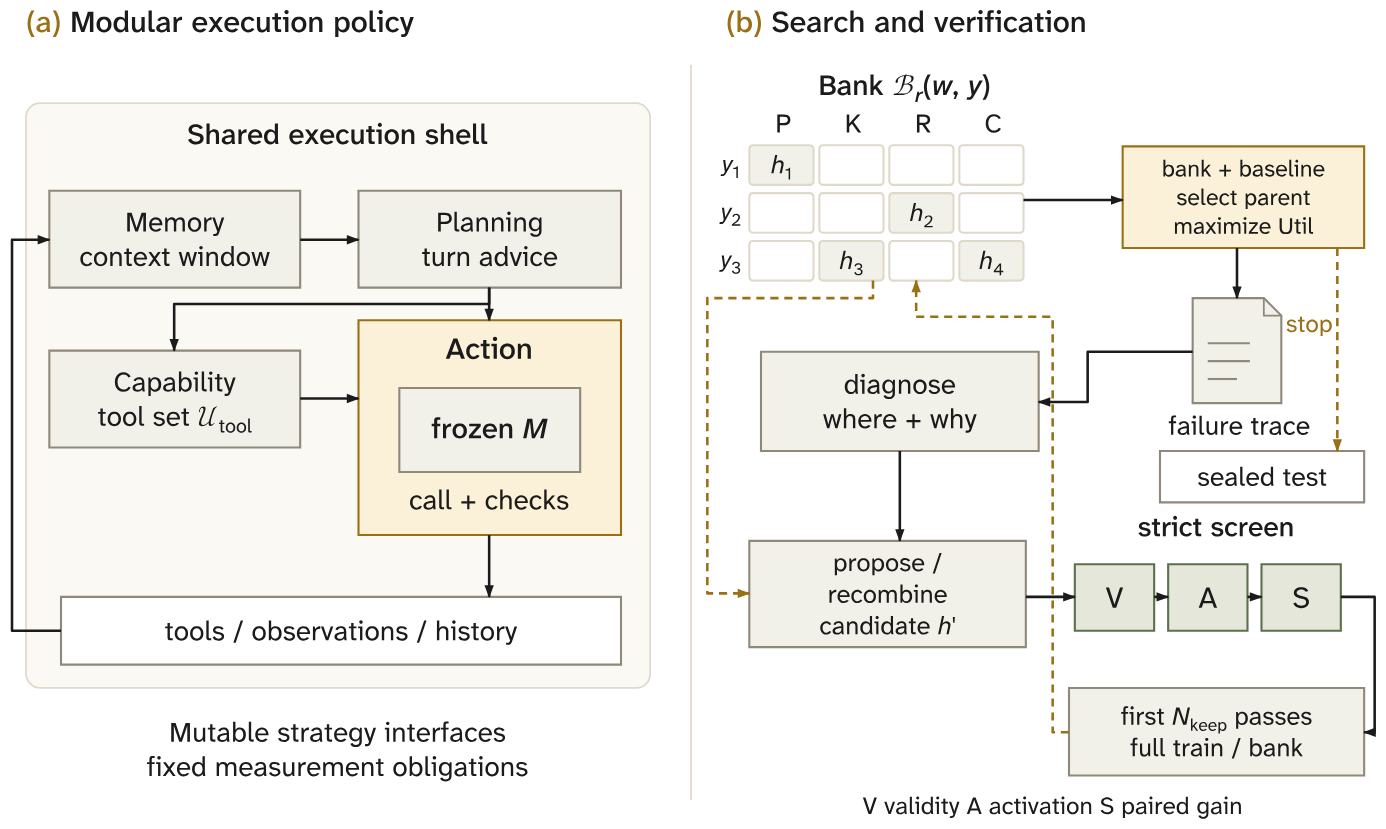
여기서 "하네스"는 frozen 모델 을 둘러싼 정책 다. 는 프롬프트, 도메인 지시, 설정이지 모델 가중치가 아니다. 네 전략 인터페이스(메모리, 계획, 능력, 행동)는 편집 가능하고, 평가·장부·필수 인터페이스를 담은 불변 커널 는 보호된다.
진화 루프는 Task Agent(실행), Evolver Agent(수정 제안), 고정 Evaluator(측정)로 돈다. Evolver는 부모 하네스의 실패 트레이스에서 증상, 근거 이벤트, 편집 위치, 기대 행동 변화를 잇는 진단을 만든다. 예컨대 추론 예산 소진 후 빈 응답이면 복구 개입을, 테스트 안 된 코드 변경이면 최종 검증 체크를 제안한다. 각 제안은 패치, 의미 기술자(편집 유형 × 병리 라벨), 그리고 활성화 명세(그 메커니즘이 실제로 실행됐는지 확인할 로그 이벤트)를 사전에 선언한다.
Harness Gene Bank는 편집 유형 {prompt, knowledge, runtime, config} × 병리 라벨 셀마다 하나의 엘리트를 보관하는 quality-diversity 아카이브다. 현재 최고보다 못한 후보도 다른 실패 모드를 다루면 보관되며, 이후 라운드에서 재조합 재료가 된다. 선별은 유효성 → 활성화 → paired gain 세 관문을 거치고, 통과한 첫 개만 전체 학습 세트 평가를 받아 셀 경쟁에 들어간다. 저자들은 HarnessDev가 보고한 경고도 인용한다. 진화로 얻은 이득은 불안정할 수 있고, held-out 과제로 부분적으로만 전이되며, 실행 모델에 강하게 의존한다.
Host archive와 EverOS 메모리
Host archive는 사용자 컨텍스트를 보관하고, 선택적 백엔드 EverOS는 과거 경험에 대한 의미적 접근을 제공한다. EverOS는 메시지 스트림을 LLM 경계 탐지기로 의미 단위 세그먼트로 자르고, 각 세그먼트를 MemCell 로 만든다. 3인칭 에피소드 서사, 개별 검색 대상이 되는 원자적 사실, 유효 기간 이 붙은 전망(foresight), 출처 메타데이터다. 마감일 같은 시한부 정보와 지속적 선호를 구분하기 위한 설계다. 사용자 트랙은 에피소드를 MemScene으로 묶어 프로필을 갱신하고, 에이전트 트랙은 실행 케이스를 재사용 가능한 절차로 통합한다. 저장은 Markdown 레코드 + SQLite + LanceDB 인덱스이며, 기록은 비동기라 후속 노드 실행을 지연시키지 않는다.
Skill Forge
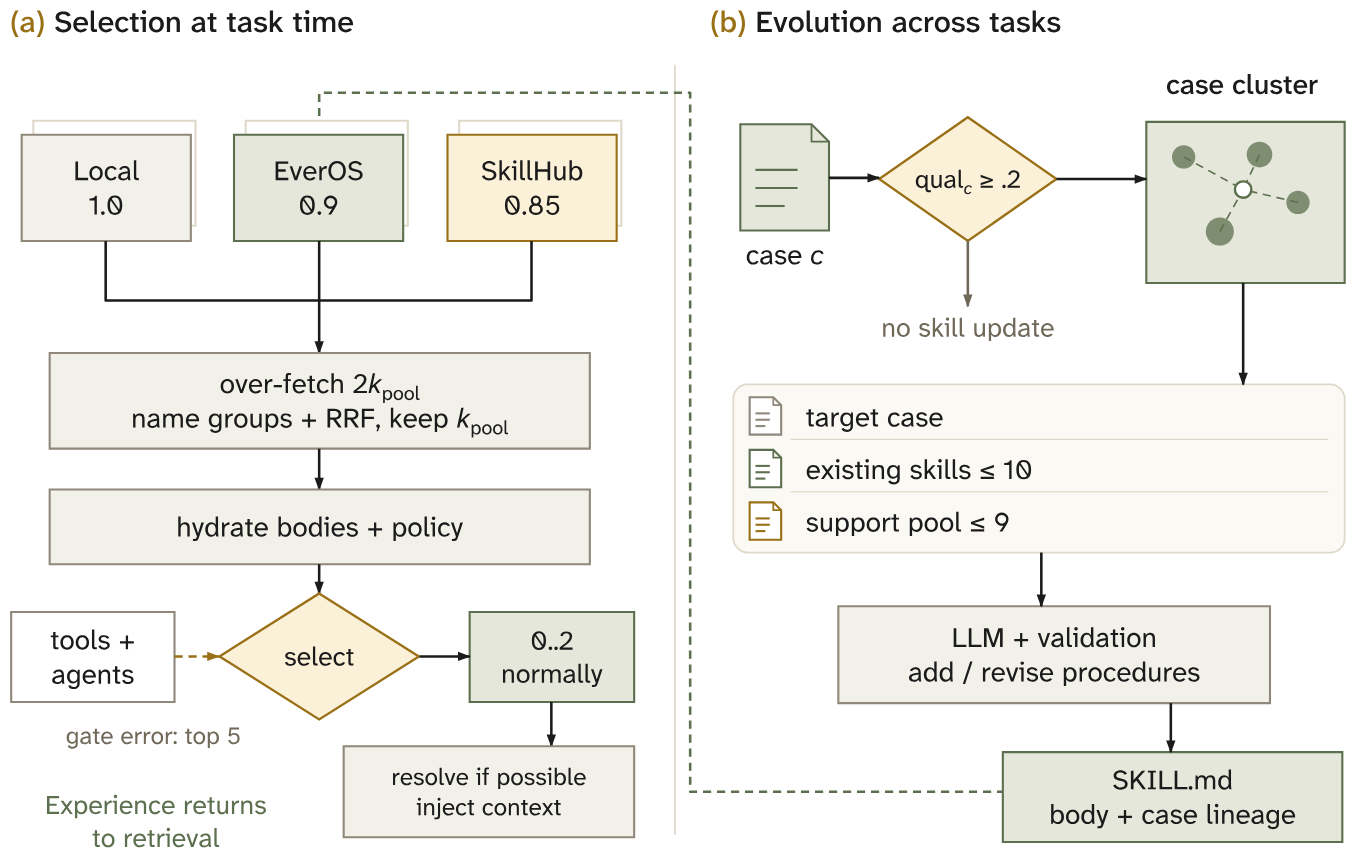
Skill Forge는 세 단계다. (1) 큐레이션된 카탈로그 SkillHub 구축 — SkillCorpus 파이프라인으로 공개 스킬을 모아 파싱, 필터, 임베딩 기반 중복 제거, 품질 평가(utility/robustness/safety, 19개 이슈 플래그), 릴리스 승인(prompt_injection, cmd_injection 등 hard flag 시 제외)을 거쳐 96,401개 활성 스킬을 만들었다. (2) 작업별 검색·선택 — 로컬, EverOS 메모리, SkillHub 세 소스를 동시에 질의하고 이름별 가중 RRF로 융합한다.
LLM 선택기가 보통 최대 2개의 스킬 본문을 컨텍스트에 주입한다. (3) 경험 기반 자기 진화 — EverOS가 실행 세그먼트에서 케이스 를 추출하고, intent 임베딩으로 클러스터링한 뒤 기존 스킬과 지원 케이스를 조건으로 SKILL.md를 생성·수정한다. 저장된 스킬은 인덱싱 후 다시 검색 후보가 된다.
📊 실험 결과
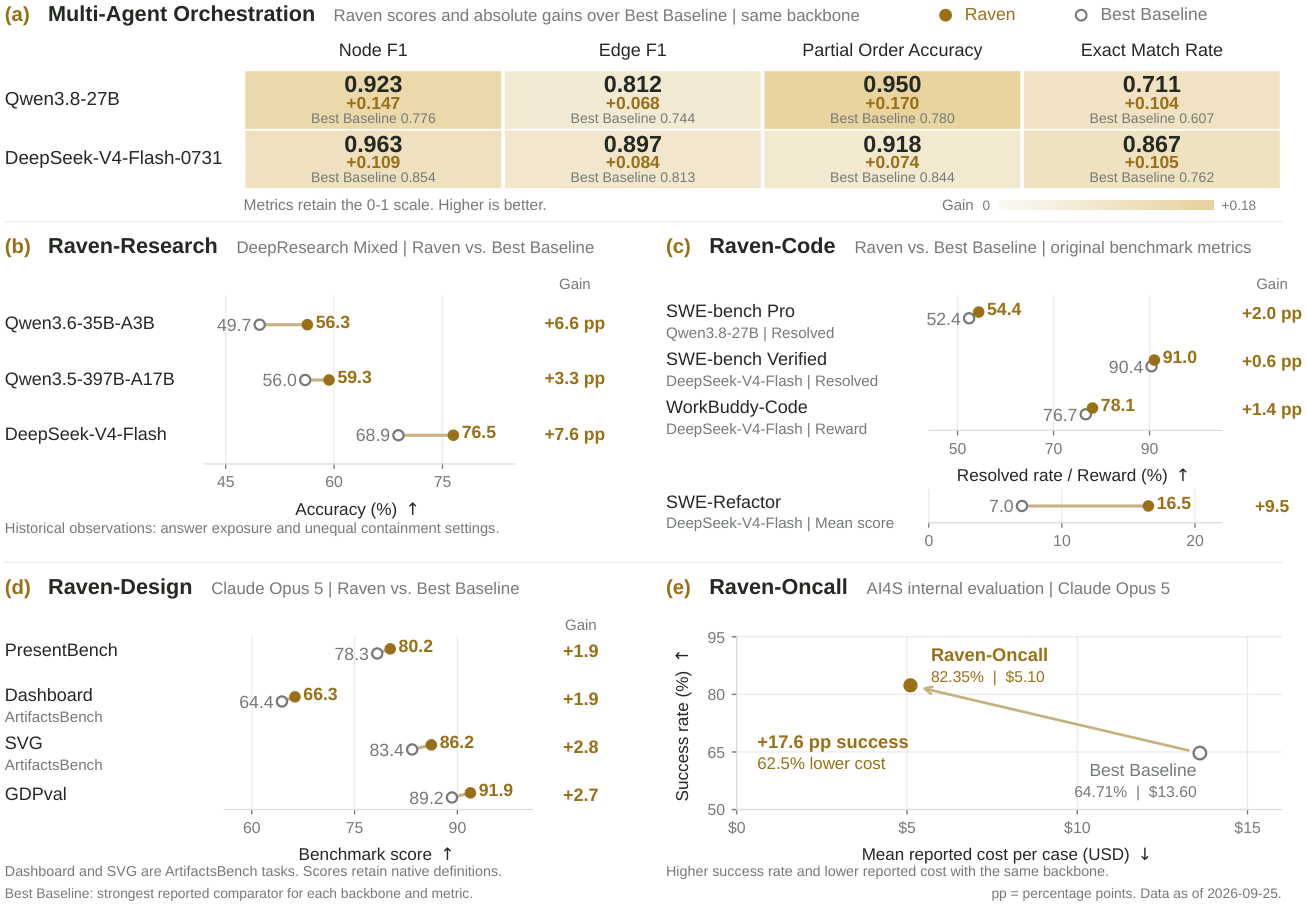
평가는 계획 품질, 전문 에이전트 실행, 하네스 적응, 스킬 재사용을 분리해서 측정한다. 그림 1이 전체 요약이다.
오케스트레이션: MAOB 벤치마크
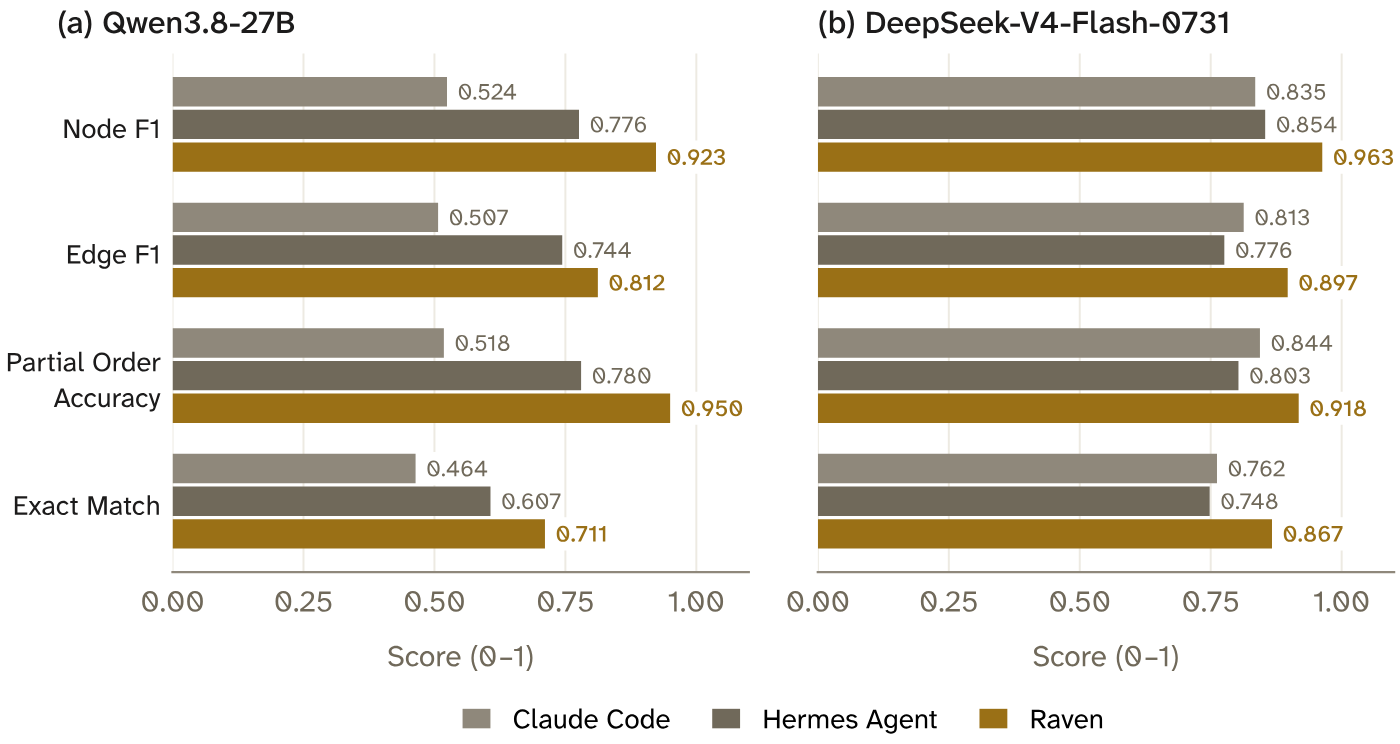
end-to-end 정확도는 계획 오류와 실행 오류가 섞이므로, 저자들은 워커를 돌리기 전 호스트가 제출한 그래프 자체를 평가하는 Multi-Agent Orchestration Benchmark(MAOB)를 만들었다. 직업 과제를 본뜬 140개 요청에 research/coding/content/oncall 네 전문가 도메인에 대한 참조 DAG가 붙어 있다. 참조 그래프를 먼저 Claude Opus 5로 만들고 GLM-5.2로 요청문을 역생성한 뒤, "first… then… finally"처럼 순서를 나열하거나 도메인명을 직접 쓴 요청은 걸러낸다. 네 도메인의 2개 이상 부분집합 11가지를 전부 포함하며, 평균 2.72 노드, 1.84 엣지, 98개는 순차·42개는 병렬 구조다.
지표는 Node F1(전문가 선택), Edge F1(전이 축약 후 의존성), Partial Order Accuracy(공유 노드 간 순서), Exact Match(노드 집합과 도달 가능성 완전 일치) 네 가지로, 합산하지 않는다. Claude Code, Hermes Agent와 동일 백본·동일 요청문·동일 위임 지시로 비교했을 때 Raven은 두 백본 모두 네 지표 전부 1위다. Exact Match는 Qwen3.8-27B에서 0.711 vs 0.607(+10.4pp), DeepSeek-V4-Flash-0731에서 0.867 vs 0.762(+10.5pp). 모든 시스템에서 Edge F1이 Node F1보다 낮은데, 어떤 전문가를 쓸지보다 누가 누구의 출력을 받아야 하는지 맞히기가 더 어렵다는 뜻이다.
하네스 자기 진화
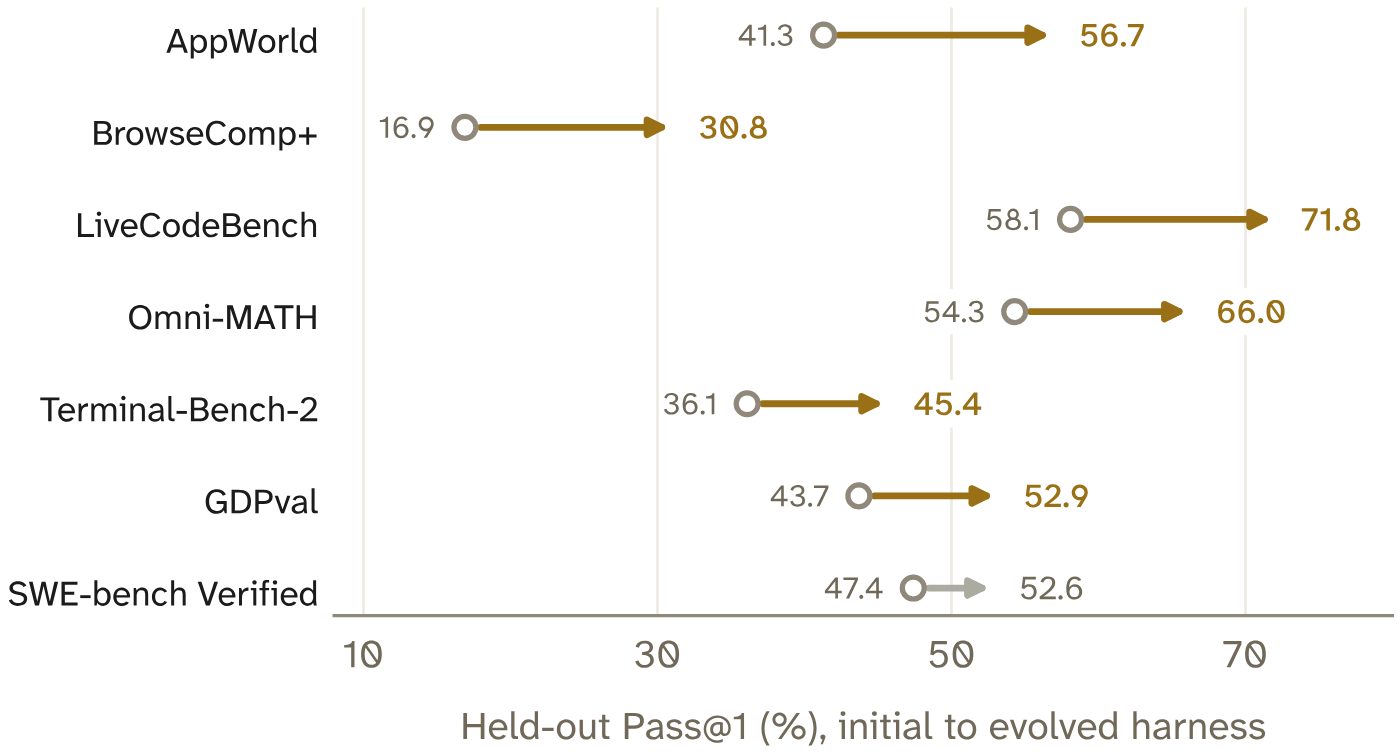
frozen Qwen3.6-27B 백본으로 7개 벤치마크에서 진화된 하네스가 held-out Pass@1을 전부 올렸다. 최대 이득은 AppWorld +15.4pp, BrowseComp+ +13.9pp, LiveCodeBench +13.7pp. 여섯 비교는 paired-gain 기준을 통과했고 SWE-bench Verified는 올랐지만 26개 테스트 분할이라 기준은 통과하지 못했다. 모델 가중치는 손대지 않았고 테스트 과제는 진화에서 제외되었으므로, 모델 주변의 정책만 바꿔도 여러 도메인에 걸쳐 전이되는 개선이 가능하다는 증거다.
장기 과제: 네 전문 에이전트
Raven-Research는 DeepResearch Mixed(BrowseComp, FRAMES, HLE 텍스트, xBench-DeepSearch 혼합)에서 MiroFlow, DeepSeek-Harness와 동일 백본·동일 검색 도구로 비교했다. 세 백본 모두 최고: Qwen3.6-35B-A3B 56.3%(+6.6pp), Qwen3.5-397B-A17B 59.3%(+3.3pp), DeepSeek-V4-Flash 76.5%(+7.6pp). DeepSeek-V4-Flash에서 질문당 비용 0.0242 USD로 두 베이스라인 사이에 있으면서 정확도는 가장 높았고, Gemini Deep Research(63.2%), Perplexity Sonar Deep Research(52.0%) 같은 상용 서비스도 넘었다(단, 상용 서비스는 모델·검색 스택·비용 계산이 다르다). 하네스는 반복 검색 후 페이지 미열람, 늦은 재시작, 답 없는 턴 종료를 루프 고정 단계의 체크로 막고, 전달 전 컨텍스트 없는 별도 리뷰어가 핵심 주장을 증거와 대조한다.
Raven-Code는 8개 설정 중 6개에서 최고였고, 가장 큰 격차는 수 시간에 걸쳐 저장소 전체를 새 스택으로 옮기는 SWE-Refactor(DeepSeek-V4-Flash +9.5점, GPT-5.6 Luna +3.0점)에서 났다. SWE-bench Pro(731개)에서는 같은 Qwen3.8-27B로 Claude Code보다 15개 더 해결했다. 하네스는 AGENTS.md/CLAUDE.md를 매 호출에 포함하고, 현재 버전을 읽지 않은 파일의 편집을 거부하며, 과제 종료 시 base commit·diff로 구성된 manifest를 남겨 모델의 자기 보고와 독립적인 실행 기록을 만든다. DataAgentBench에서는 Claude Opus 5로 Pass@1 0.8762를 기록해 2026년 8월 24일 기준 리더보드 1위였다.
Raven-Design은 렌더링 후 검사를 워크플로에 넣는다. PresentBench(238개 슬라이드 과제)에서 Claude Opus 5로 80.2점(Claude Code 78.3), GPT-5.6 Luna로 72.9점(Claude Code 52.4)을 받았다. 두 번째 백본에서 20.5점 차이가 난 점이 눈에 띈다.
Raven-Oncall은 장시간 작업을 "캠페인"(목표, 측정값, 허용 행동, 예산을 담은 영속 레코드)으로 관리한다. 한 라운드를 제출하고 모델 호출 없이 대기하며, 모델 없는 모니터가 완료나 발산을 감지하면 조기에 깨운다. 대기·종료·재제출 결정은 최근 측정값을 인용해야 하고, 보고서는 베이스라인 없거나 기록과 모순되면 게이트에서 거부된다. nanochat 기반 autoresearch 과제(5 GPU-hour 예산)에서 Claude Opus 5로 1.038 BPB(Claude Code 1.053, 시작 1.108)를 더 적은 토큰과 비용으로 달성했고, DeepSeek-V4.1-Flash로는 1.037 BPB를 3.74시간, 0.97 USD에 얻었다. 내부 AI4S 17개 과학 과제에서는 14개 성공(Claude Code 11개)에 평균 비용도 낮았다.
스킬 재사용
SkillCorpus 실험에서 Raven과 OpenClaw에 동일한 스킬 선택을 주입했을 때 12개 셀-벤치마크 비교 전부에서 성능이 올랐다. 풀링 이득은 SkillsBench +7.5±2.3, GDPval +1.51±0.49, QwenClawBench +2.79±0.70. 같은 스킬을 줘도 Raven이 더 많이 얻었다. SkillsBench에서 Raven은 Qwen3.5-27B/397B-A17B로 +6.5/+13.4점, OpenClaw는 +4.2/+5.8점. 트레이스를 보면 OpenClaw는 추론 후 멈추거나 생성한 스크립트를 실행하지 않고 끝나는 경우가 많았고, Raven은 execute–verify–fix 루프를 완주했다. 큐레이션과 학습된 검색기를 각각 떼어내면 22.6% → 14.9%, 13.8%로 떨어져 둘 다 필요함을 보였고, 스킬 커버리지 점수가 높은 과제일수록 이득이 컸다(0.75 이상 17개 과제 평균 +25.1점).
🧭 정리, 한계, 열린 질문
Raven이 제안하는 그림은 명확하다. (1) 모델-하네스 쌍을 조합 단위로 레지스트리에 등록하고, (2) Host Agent가 역방향으로 DAG를 짜서 admission 검증 → 의존성 스케줄링 → 독립 판정 → 예외 보고의 루프를 돌리며, (3) 하네스 진화·EverOS 메모리·Skill Forge가 작업을 넘어 경험을 축적한다. 그리고 이 조합이 언제 개별 에이전트보다 넓은 coverage를 주는지 상보성·계약 호환성·오류 상한이라는 충분조건으로 형식화했다.
읽으면서 좋았던 점은 저자들이 스스로 한계를 반복해서 명시한다는 것이다.
- 이론은 충분조건이다. 구현된 에이전트와 호스트가 계약 전제를 만족하는지는 별도로 측정해야 하고, 평균 성공률만으로는 조건부 신뢰도 전제가 성립한다고 말할 수 없다.
- Corollary 1은 새 과제 coverage만 보장한다. 조합이 단독 에이전트의 coverage를 다 포함한다거나 평균 성능이 오른다는 보장은 없고, 조정 비용이 이득을 상쇄할 수 있다는 선행 연구도 인용한다.
- MAOB는 계획만 측정하며 의미적 타당성(리서치 과제가 사용자 질문을 제대로 다루는지)은 측정하지 않는다. 완료 판정 모델의 verdict도 객관적 정확성을 보증하지 않는다.
- 하네스 진화의 이득은 불안정하고 실행 모델에 의존할 수 있다(HarnessDev 인용). AI4S는 내부 벤치마크이고, 일부 디자인 점수는 공식 리더보드와 비교 불가다.
- 아직 matched 조건에서 "조합 vs 강한 단독 에이전트"의 end-to-end 비교는 제시되지 않았다. 논문 스스로 research–code–design 워크플로가 그런 비교의 후보이지 이득의 증거는 아니라고 쓴다.
열린 질문으로는, 이질적 서드파티 하네스를 묶을 때 계약 를 실제로 누가 어떻게 명시하느냐가 가장 궁금하다. 지금은 프롬프트 템플릿과 판정 모델이 그 역할을 대신하는 것으로 보인다. 또 향후 계획으로 제시된 디바이스별 Raven 인스턴스 간 A2A 협업(All-Domain Collaboration Network)은 MCP, A2A 프로토콜을 다룬 이 블로그의 다른 글들과 자연스럽게 이어지는 주제다. 하나의 하네스를 잘 만드는 단계에서, 하네스들을 조합·진화시키는 단계로 넘어가는 흐름은 당분간 계속될 것으로 보인다.
📚 참고
- 원문: Raven: The Harness of Harnesses for Composable Agentic Intelligence (arXiv 2609.33439) / HTML 버전
- Hugging Face Papers: https://huggingface.co/papers/2609.33439
- 코드: github.com/EverMind-AI/Raven, github.com/EverMind-AI/EverOS
- 관련 글: Effective harnesses for long-running agents
본 글의 그림은 원문에서 가져왔습니다.