RRSI: 하네스가 스스로를 고칠 때 벤치마크 과적합을 막는 정규화
"재귀적 자기 개선은 '무엇을 바꿀 수 있나'뿐 아니라 '반복된 피드백이 어떻게 영구 상태로 굳어지나'까지 통제해야 한다."
2026년 9월 Google Cloud AI Research의 Peng Xia 등이 RRSI: Regularized Recursive Self-Improvement of Agent Harnesses(arXiv 2609.24972)를 공개했다. 이 블로그에서 Effective harnesses for long-running agents 글은 사람이 하네스를 설계하는 이야기였고, Raven: 하네스의 하네스 글은 하네스들을 조합하고 HarnessBank로 진화시키는 이야기였다. Raven 글 말미에 "진화로 얻은 이득은 불안정하고 held-out 과제로 부분적으로만 전이된다"는 경고를 인용했는데, RRSI는 바로 그 지점을 정면으로 다룬다. 하네스가 스스로를 반복 개선할 때 왜 과적합이 생기고, 어떻게 막을 것인가.
원문: https://arxiv.org/abs/2609.24972
🤔 배경: 진화 세트 점수는 오르는데 새 벤치마크에서는 사라진다
논문은 에이전트를 , 즉 고정된 백본 정책 와 하네스 의 쌍으로 본다. 하네스는 가중치 바깥의 전부다. 시스템·과제 프롬프트, 언제 계획하고 행동하고 반성하고 멈출지 정하는 제어 흐름, 도구 인터페이스와 설명, 메모리와 스킬 파일, 그리고 매 스텝 정책이 무엇을 볼지 정하는 컨텍스트 관리까지 포함한다. 최근 에이전트 제품의 진전 상당수가 새 가중치가 아니라 하네스 엔지니어링에서 나왔는데, 이 작업은 사람이 실패 트레이스를 읽고 손으로 고치는 방식이라 엔지니어가 읽을 수 있는 트레이스 수에 묶여 있다.
그래서 Meta-Harness, AHE, TTHE, HarnessX 같은 방법들이 이 루프를 자동화한다. 라운드 마다 현재 하네스 를 진화 세트 에서 실행하고, 트레이스를 피드백 로 요약하고, 제안자 LLM이 후보 하네스들을 만들고, 같은 진화 세트에서 평가해 최고 후보를 다음 incumbent로 삼는다.
저자들은 이것이 에이전트 시스템 수준의 재귀적 자기 개선(RSI) 이라고 본다. 문제는 가 유한한 진화 세트에서 확률적 실행 회로 얻은 경험적 점수라는 점, 그리고 라운드 의 후보가 이전 라운드에서 같은 과제로 측정한 값에 의존하는 적응적 재사용이라는 점이다. 표현력이 극도로 큰 검색 공간 위에서 같은 데이터를 적응적으로 재사용하면, 진화 세트 점수는 오르는데 새 과제에서는 그렇지 않은 과적합이 생긴다.
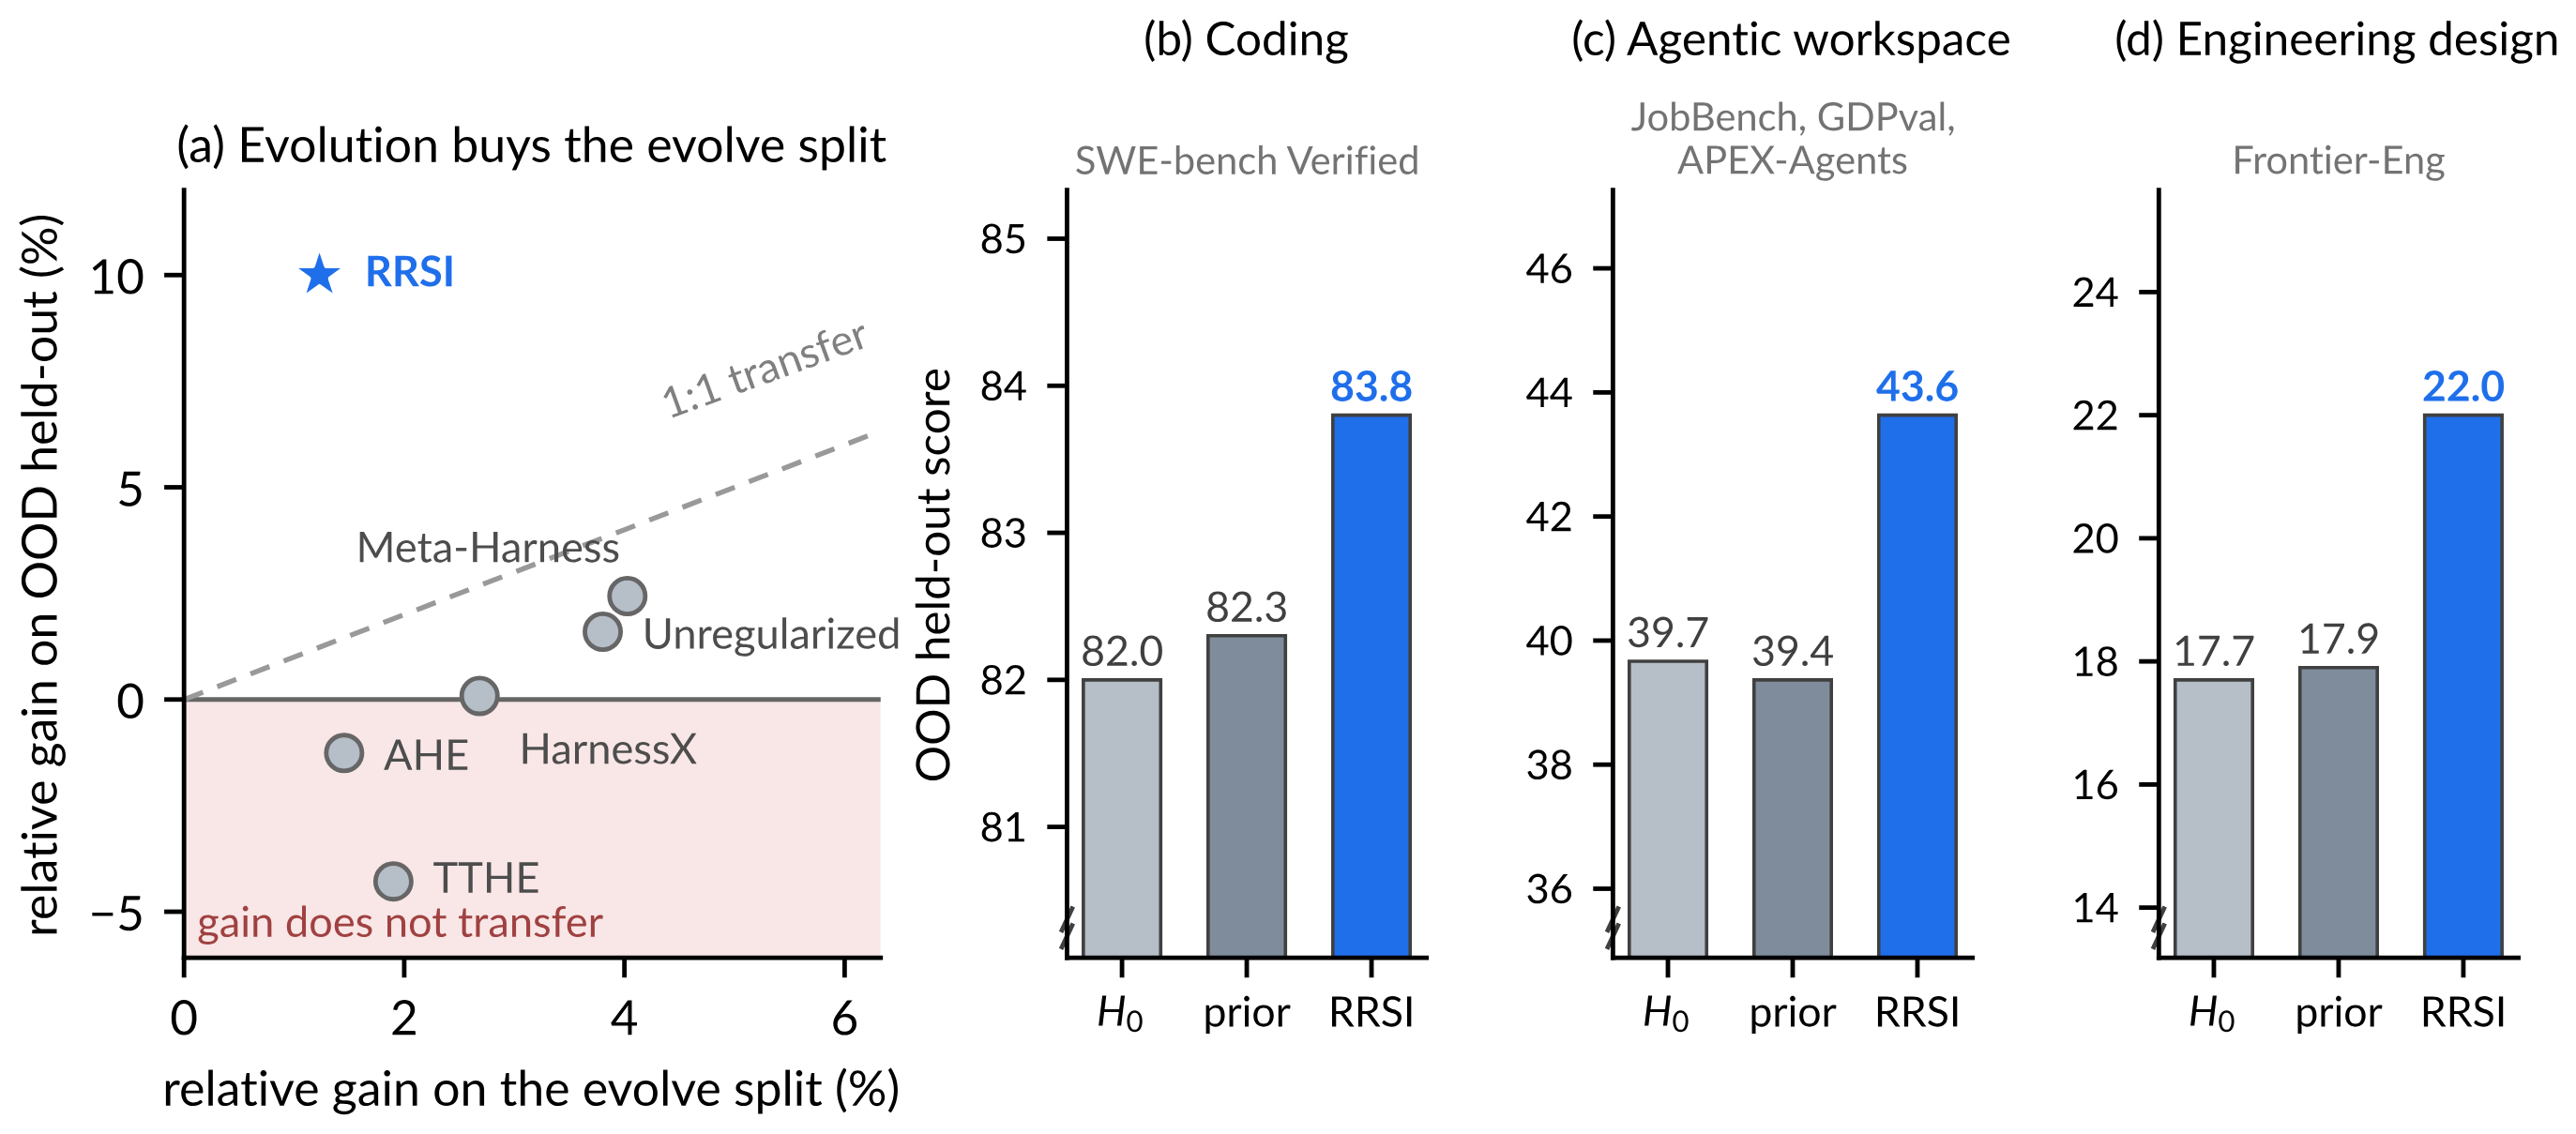
그림 1(a)가 문제를 한 장으로 보여준다. 에이전트 워크스페이스 도메인에서 기존 방법들은 진화 분할에서 2~4%를 벌지만 OOD에서는 그 일부만 남기거나, AHE와 TTHE처럼 시작 하네스 보다 아래로 떨어진다. 저자들은 과적합이 세 가지 결합된 행동으로 생긴다고 정리한다. 벤치마크 특유의 패턴을 하네스에 새기는 benchmark-specific fitting, 평가 노이즈가 밀어준 후보를 고르는 noise chasing, 메커니즘은 개선하지 않으면서 점수만 올리는 complexity accumulation이다.
🧠 핵심 아이디어: 편집 공간은 열어 두고 검색 궤적을 정규화한다
RRSI의 설계 원칙은 하나다. 하네스에서 무엇을 고칠 수 있는지()는 제한하지 않는다. 프롬프트, 제어 흐름, 설정, 컨텍스트 관리, 도구, 스킬, 메모리, 서브에이전트 전부 추가·수정·삭제 가능하다. 대신 그 공간을 지나가는 검색 궤적을 양쪽에서 정규화한다.
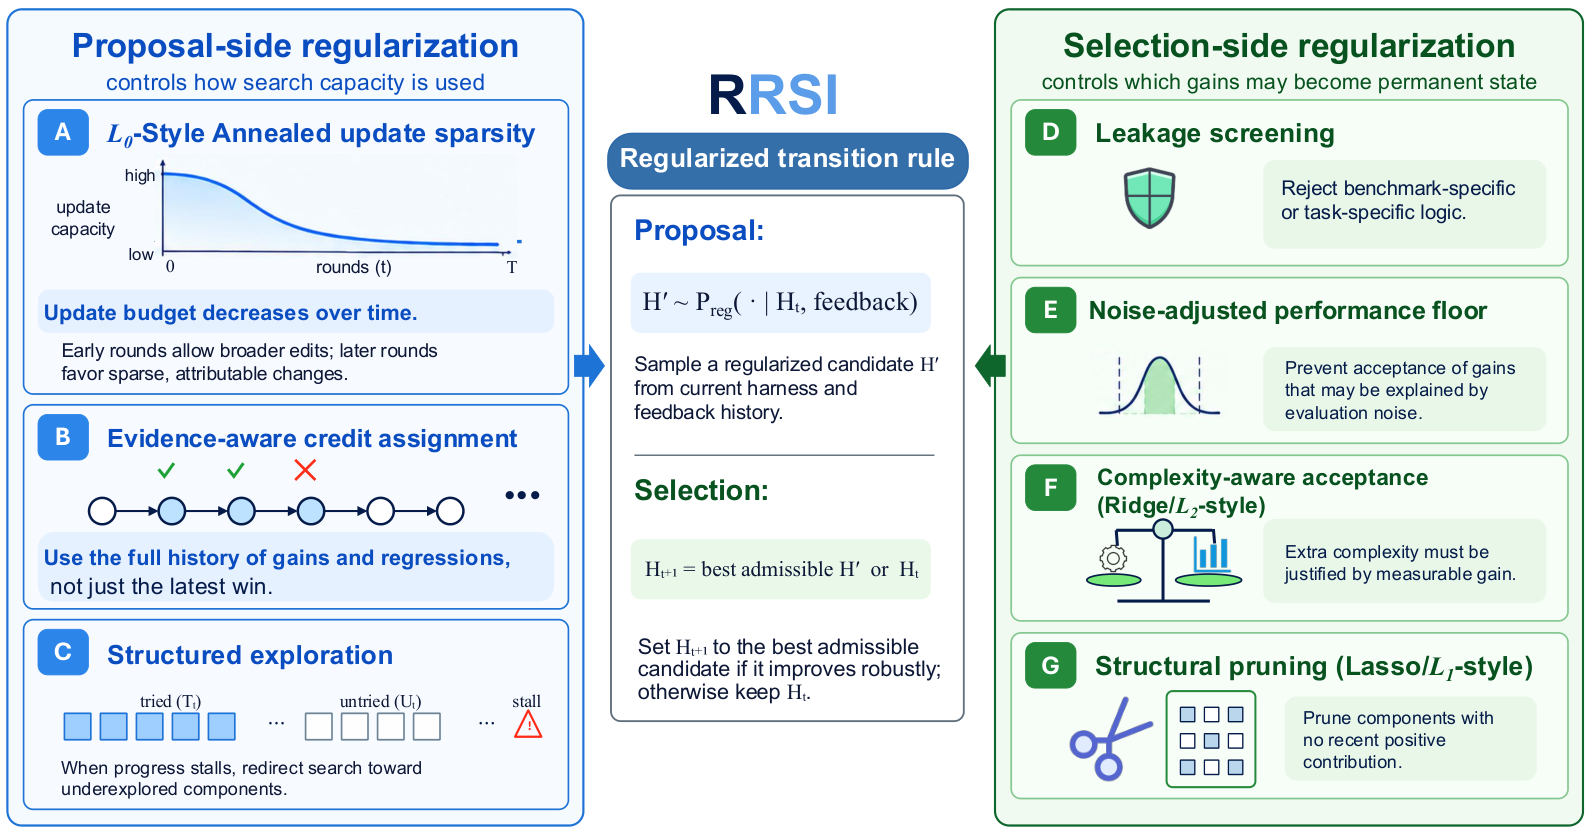
- 제안 측: 한 라운드에서 얼마나 많은 적응 용량을 쓸 수 있는지, 그 용량을 어디에 쓸지 제한한다.
- 선별 측: 측정된 개선 중 어떤 것이 충분히 강하고, 충분히 효율적이며, 누수가 없어서 살아남을 수 있는지 제한한다.
저자들은 이를 고전적 정규화에 빗댄다. 편집 예산은 한 업데이트에서 독립적으로 활성화된 편집 수를 직접 제한하니 카디널리티 제약에 가깝고, 구조 가지치기는 쓸모없는 구성요소를 제거해 구조를 희소하게 만드니 Lasso/, 복잡도 인지 수용은 특정 구성요소를 없애지 않으면서 총 자원 발자국의 성장을 억제하니 Ridge/에 해당한다. 단, 논문 스스로 이 대응은 정성적 유추이며 실제로 노름 페널티 목적함수를 최적화하는 것은 아니라고 반복해서 못 박는다.
📐 방법 상세 1: 제안 분포 정규화
시간에 따라 줄어드는 편집 예산
제약 없는 제안자는 관련 없는 수정 여러 개를 한 후보에 묶는다. 이런 후보는 유효 용량이 커서 현재 피드백의 특이점을 더 많이 맞출 수 있고, 점수 변화를 어느 메커니즘 덕으로 돌릴지도 알 수 없다. RRSI는 한 제안에 포함될 수 있는 독립 편집 수를 코사인 스케줄로 제한한다.
초반 라운드는 개(실험에서는 3 또는 4)의 조율된 변경을 묶어 새 메커니즘을 발견하고, 후반으로 갈수록 로 수렴해 마지막 라운드들은 효과가 명확한 단일 편집만 싣는다. 제안자가 매 라운드 80개 정도의 편집 풀을 만든다는 점을 생각하면 상당히 빡빡한 예산이다.
증거 기반 크레딧 할당과 구조화된 탐험
예산 제한은 검색이 이전에 무엇을 확인했는지 알 때만 의미가 있다. 매 평가가 같은 유한 세트를 또 한 번 적응적으로 들여다보는 것이므로, 이미 기각된 가설을 다시 시험하는 건 증거 없이 용량만 쓰는 일이다. RRSI는 평가된 모든 후보에 대해 수정한 구성요소 , 가설 , 소스 diff, 점수·비용 변화, 채택 여부를 이력 로 기록하고 제안자가 이를 조건으로 삼는다. 기각된 메커니즘은 부정 증거로, 성공한 메커니즘은 명시적 크레딧으로 남는다.
같은 이력은 제안자가 좁은 편집 패밀리(예: 프롬프트만 계속 고치고 구조는 안 건드림)에 갇혔는지도 드러낸다. 이전 라운드의 진척이 노이즈 밴드 안에 머물면 정체로 판정하고, 제안 슬롯 일부(개 중 개)를 아직 손대지 않은 구성요소에 예약한다. 구성요소 어휘는 prompt, control_flow, config, output_plumbing, context_mgmt, client_tool, skill, memory, subagent 아홉 가지다. 엔트로피 정규화처럼 탐험을 유도하되, 하네스가 가질 수 있는 메커니즘의 종류는 바꾸지 않는다.
🔍 방법 상세 2: 후보 선별 정규화
표준 진화는 측정 점수가 가장 높은 후보를 그 점수가 명시적 누수, 확률적 변동, 비싼 성장에서 왔더라도 채택한다. RRSI는 같은 경험적 목적을 유지하되, 후보가 incumbent를 대체하려면 서로 보상되지 않는(non-compensatory) 여러 기준을 전부 통과해야 한다.
누수 스크리닝(critic). 전체 평가 전에 비평가 LLM이 후보 diff를 읽고, 과제 이름·엔티티 이름·과제별 값·정답 등 진화 벤치마크에 특정한 로직을 명시적으로 인코딩한 편집과 작동하지 않는 기계 장치를 추가하는 편집을 기각한다. 평가 전에 거르는 이유가 중요하다. 누수 후보가 일단 부풀려진 진화 세트 점수를 받으면 이후 라운드가 그쪽으로 끌리기 때문이다. 부록의 사례를 보면 이 비평가는 키워드 검사가 아니다. 후보가 제안 근거에서 고칠 과제 이름을 언급하는 건 자유지만, 그 내용이 배포되는 diff로 넘어가면 안 된다. 코딩 런의 스크리닝된 38개 후보 중 유일한 전면 기각은 선언한 구성요소와 실제 diff가 바뀐 구성요소가 달랐던 경우였다.
안정성 인지 수용. 진화 전에 변경 없는 기본 하네스를 반복 평가해 경험적 노이즈 밴드 를 추정한다. 지금까지 관측된 최고 진화 세트 점수를 라 할 때, 후보는 다음 하한을 넘어야 한다.
이 하한은 각각 노이즈로 착각할 만큼 작은 퇴보를 연달아 받아들이며 내리막을 걷는 것을 막는다. 하이퍼파라미터 표를 보면 는 Terminal-Bench 2.1에서 3 pass, Harvey LAB에서 60개 criterion 판정, EngDesign에서 5 pass에 해당하며, 저자들은 이 값만큼은 절대 튜닝하면 안 된다고 쓴다. 를 낮추면 노이즈만으로 진화 세트 점수를 살 수 있기 때문이다.
복잡도 인지 수용(Ridge/ 스타일). 점수 이득이 노이즈 밴드를 넘는 후보()라도 정책 토큰 비용의 상대 증가 가 다음을 만족해야 한다.
는 이득이 거의 없을 때 허용되는 비용 증가, 은 이득이 클수록 추가로 허용되는 비용이다. 코딩 인스턴스에서 1 pass당 25%의 토큰 증가를 허용하도록 잡았는데, 예컨대 7 pass 가치의 후보는 성장이 허용되어 측정된 130% 증가가 수용되지만, 1 pass짜리 후보는 35%만 허용되어 같은 비용이면 기각된다. 이득이 안에 머무는 후보는 별도 규칙을 쓰는데, 코딩 인스턴스에서는 점수 가중치 이라 밴드 안의 점수 상승만으로는 절대 채택되지 않고 비용 절감이나 처음 시도하는 구조적 구성요소(client_tool, skill, memory, subagent)의 신규성으로만 통과할 수 있다.
구조 가지치기(Lasso/ 스타일, pruner). 어닐링된 예산이 각 업데이트를 희소하게 만든다면, 가지치기는 유지되는 하네스를 희소하게 만든다. 최근 가지치기 윈도우( = 4~5 라운드) 동안 한 번도 양의 측정 이득을 내지 못한 구성요소는 삭제 대상 로 제안자에게 보고된다. 점수만 보는 진화는 무언가를 제거할 유인이 없는데, 여기서는 메커니즘이 계속 자기 자리를 벌어야 한다.
📊 실험 결과
세 도메인, 여덟 벤치마크다. 코딩은 Terminal-Bench 2.1(89개 컨테이너 과제)에서 진화하고 SWE-bench Verified로 OOD 평가, 에이전트 워크스페이스는 법률 업무 벤치마크 Harvey LAB(진화 120개 + ID held-out 40개)에서 진화하고 JobBench·GDPval·APEX-Agents로 OOD 평가, 엔지니어링 설계는 EngDesign(61개, 시뮬레이터 채점)에서 진화하고 Frontier-Eng으로 OOD 평가한다. 정책은 전 도메인 Claude Opus 4.8로 고정, 제안자·분석가·비평가도 Claude Opus 4.8이다. 기본 하네스는 코딩에서 Terminus-2, 나머지는 MCP 도구 게이트웨이 위의 ReAct 루프에 동적 툴벨트와 ReSum 스타일 컨텍스트 관리를 얹은 것이다.
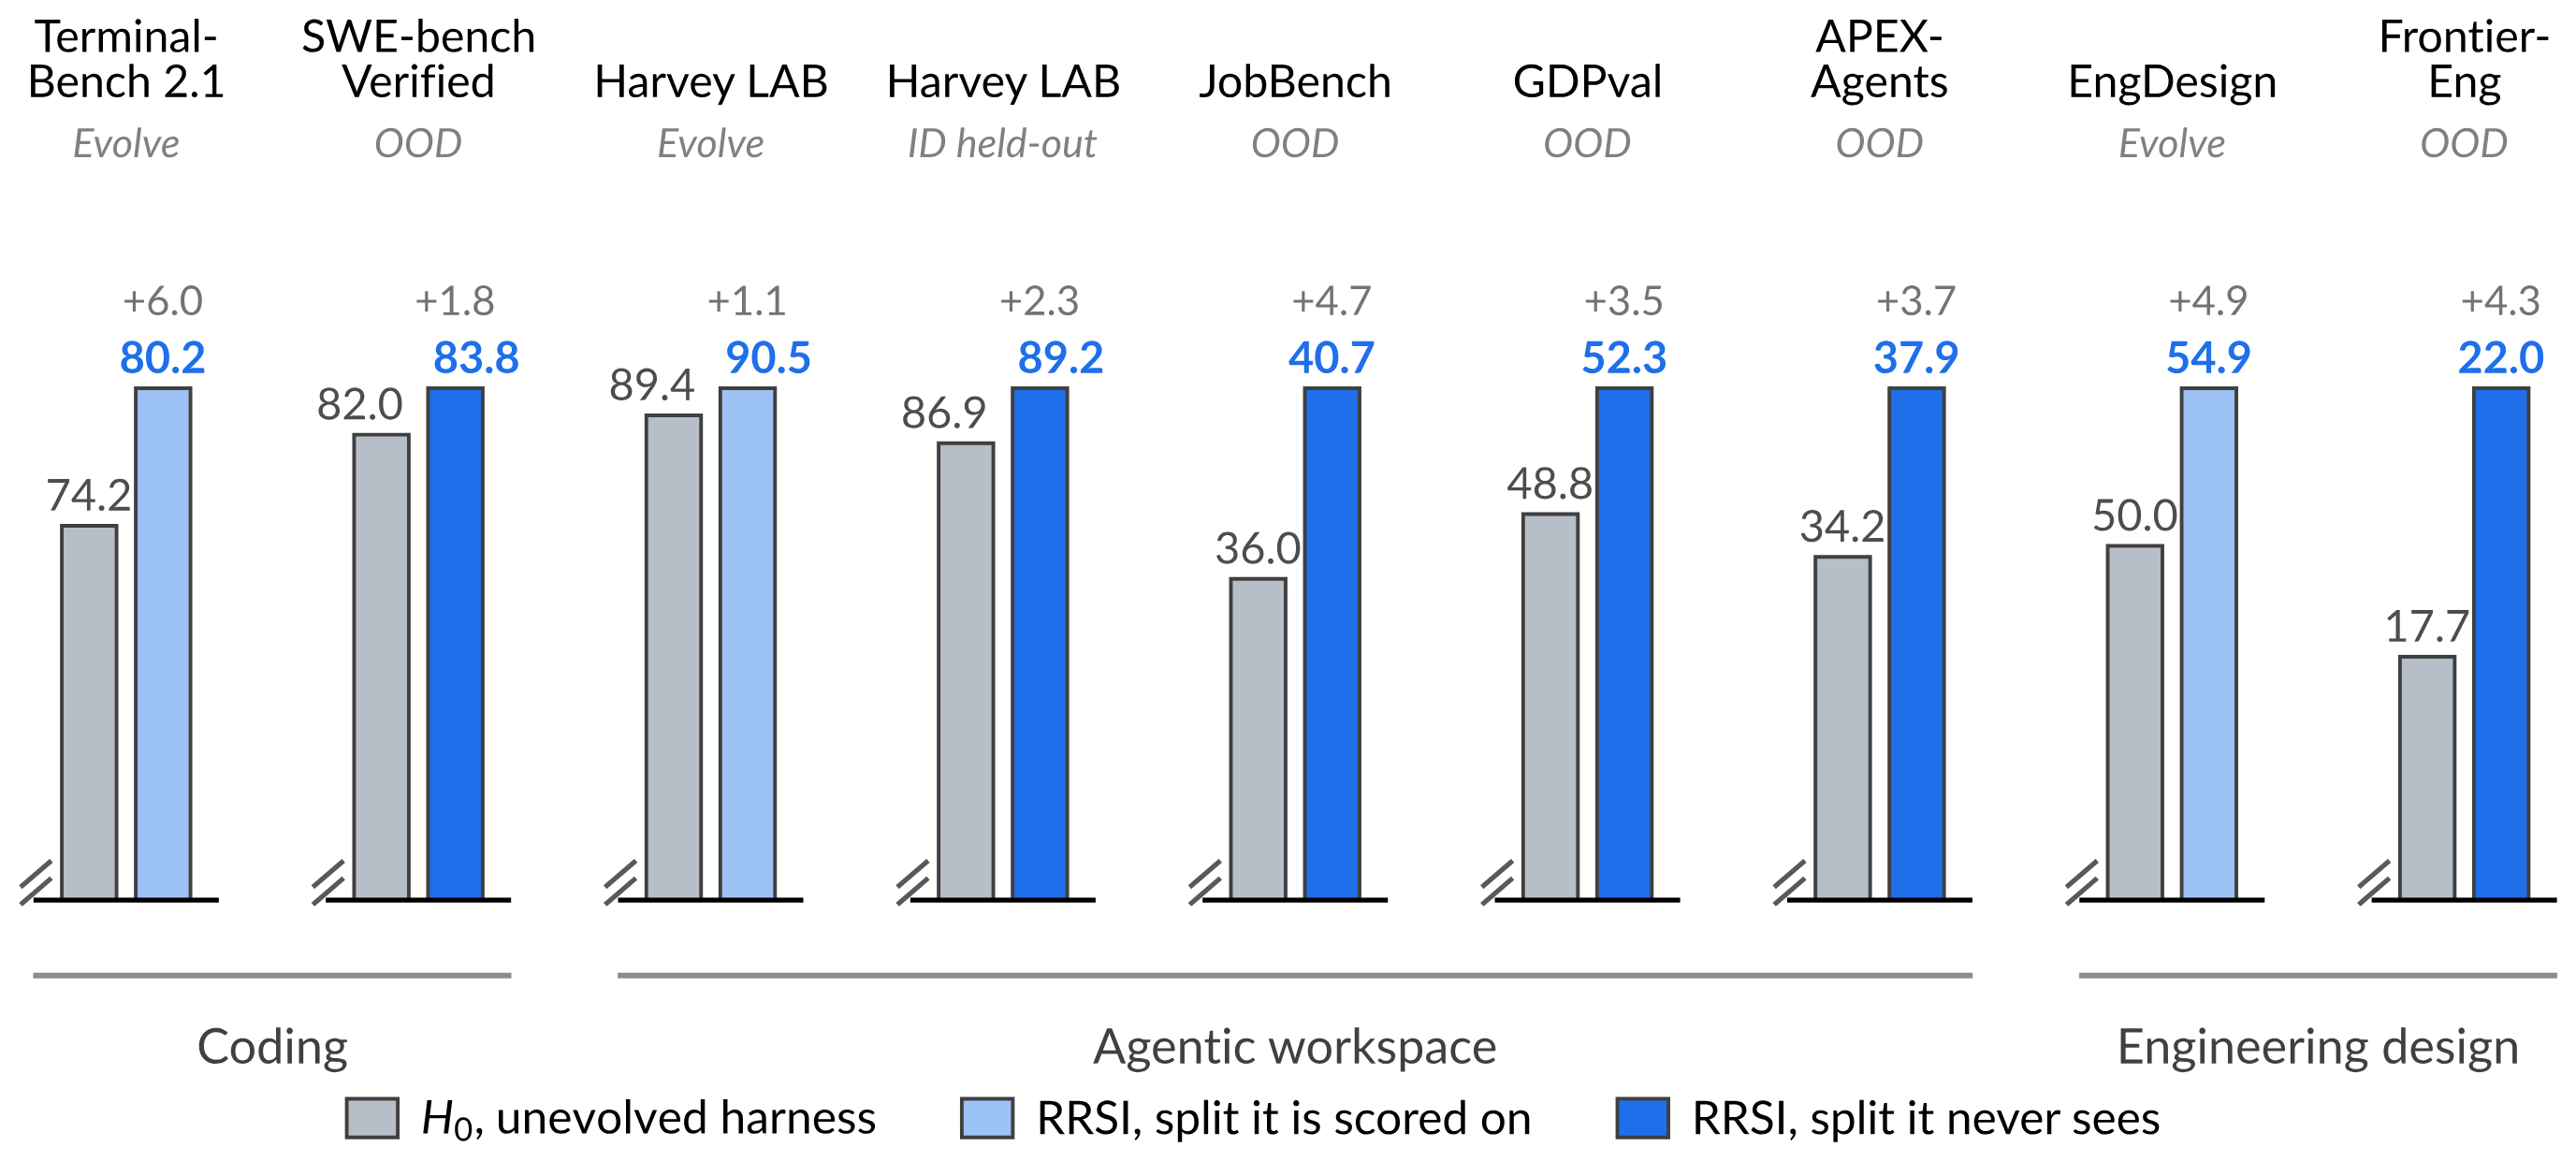
진화 세트 이득은 Terminal-Bench 2.1 +6.0, EngDesign +4.9, Harvey LAB +1.1이다. 중요한 건 하네스가 그 분할을 떠난 뒤다. 한 번도 채점에 쓰이지 않은 SWE-bench Verified에서 +1.8, Harvey LAB ID held-out에서 +2.3, 세 OOD 에이전트 벤치마크에서 +3.5~+4.7(상대 7.2~13.1%), Frontier-Eng에서 +4.3 Medal 점수(상대 24.3%)다. held-out 분할 중 퇴보한 곳이 하나도 없다. 부록의 과제 단위 paired bootstrap(10,000회)에서 아홉 비교 모두 95% 신뢰구간 하한이 0 위에 있고, 제안자 난수만 바꿔 전체 진화를 한 번 더 돌린 재현 실험에서도 에이전트 워크스페이스 OOD 평균이 43.6 대 43.7로 거의 같았다.
Harvey LAB·JobBench·GDPval은 LLM 판정 채점이라 하네스가 "판정자가 좋아하는 문체"를 익혀 점수를 올릴 가능성이 있는데, EngDesign과 Frontier-Eng은 각 과제의 고정 시뮬레이터·테스트벤치가 결정론적으로 채점하므로 그 경로가 막혀 있다. 그런데도 이득이 그대로 남는다는 점을 저자들은 강조한다.
기존 방법과의 비교: 진화 세트에서 가장 적게 벌고 OOD에서 가장 많이 남긴다
| 방법 | Harvey LAB (Evolve) | Harvey LAB (ID Held-out) | JobBench | GDPval | APEX-Agents |
|---|---|---|---|---|---|
| (진화 없음) | 89.4 | 86.9 | 36.0 | 48.8 | 34.2 |
| Meta-Harness | 93.0 | 89.2 | 37.1 | 49.1 | 35.7 |
| AHE | 90.7 | 88.7 | 37.2 | 47.2 | 33.1 |
| TTHE | 91.1 | 88.5 | 35.2 | 47.0 | 31.7 |
| HarnessX | 91.8 | 89.1 | 36.3 | 48.5 | 34.3 |
| RRSI | 90.5 | 89.2 | 40.7 | 52.3 | 37.9 |
네 기존 방법을 같은 , 같은 진화 분할, 같은 후보 예산으로 돌렸다. 전부 진화 세트에서는 잘 되고 ID held-out도 비슷하다. 차이는 OOD에서 나며 순위가 뒤집힌다. 진화 세트 최강인 Meta-Harness는 OOD 평균에 0.9점을 더하고, HarnessX는 제자리, AHE와 TTHE는 시작 하네스보다 낮게 끝난다(TTHE는 -1.7). RRSI는 진화된 하네스 중 진화 세트 이득이 가장 작고, 유일하게 OOD 평균이 를 1점 넘게 앞선다(43.6 대 39.7). 정규화기가 하도록 설계된 트레이드가 정확히 이것이다.
어떤 구성요소가 일반화를 만드는가
| 변형 | Harvey LAB (Evolve) | ID Held-out | OOD 평균 | 토큰/trial (M) |
|---|---|---|---|---|
| 89.4 | 86.9 | 39.7 | 1.56 | |
| 정규화 없는 진화 | 92.8 | 88.9 | 40.3 | 3.80 |
| 제안 측 정규화 제거 | 90.7 | 88.8 | 41.9 | 2.69 |
| 수용 측 정규화 제거 | 91.5 | 88.7 | 41.0 | 3.59 |
| RRSI | 90.5 | 89.2 | 43.6 | 2.42 |
제거 실험이 흥미롭다. 어느 쪽 정규화기를 빼도 진화 세트 점수는 오르고 전이는 떨어진다. 수용 측을 빼면 진화 세트는 90.5→91.5로 오르는데 OOD 평균은 43.6→41.0으로 떨어지고 토큰은 1.5배가 된다. 제약 없는 선별 규칙이 채택한 편집 대부분을 메커니즘이 아니라 노이즈와 컨텍스트에 쓴다는 뜻이다. 제안 측을 빼면 진화 세트는 0.2점만 손해지만 OOD는 1.7점 손해인데, 아무것도 기각하지 않더라도 검색이 어디를 보는지 조향하는 것 자체가 중요하다는 신호다. 둘 다 빼면 진화 세트 점수는 92.8로 모든 변형 중 최고가 되지만 OOD 평균은 40.3으로 진화 안 한 하네스에서 1점 이내이고, trial당 토큰은 3.80M 대 2.42M이다. 초록에서 말하는 "정규화 없는 진화 대비 30% 적은 정책 토큰"이 이 비교다.
정성 분석(부록 F)이 실제로 무엇이 남았는지 보여준다. Harvey LAB에서 진화한 최종 하네스를 나란히 놓으면, Meta-Harness는 730단어짜리 필수 작업 방법을 시스템 메시지로 주입했는데 과제 이름은 없지만 "산출물은 항목별 엄격한 루브릭으로 채점되며 파일만 읽힌다"는 채점 방식 자체를 재진술한다. TTHE는 약 8,500단어의 프로토콜 블록 열 개를 요약에도 살아남는 시스템 메시지로 실었고, 그중 약 1,000단어는 redline/tracked-changes 산출물에만 적용된다. 그 장르가 없는 벤치마크에서는 블록이 발화하지 않으면서 매 trial 컨텍스트 비용만 든다. 반면 RRSI는 20라운드 동안 평가한 32개 후보 중 4개만 채택했고, 전부 기본 하네스에 이미 있던 단일 pre-finalize 점검에 연결된다. 커버리지·깊이 재확인 하나와, 산출물을 다시 읽어 "산술 약어가 전개되지 않았다", "소스 값이 어떤 파일에도 없다" 같은 구조적 사실을 보고하는 표준 라이브러리 프로브 세 개다. 루브릭 어휘도 도메인 어휘도 없으니 JobBench, GDPval, APEX-Agents에서도 그대로 작동한다.
정책 가족·모델 크기를 넘는 전이와 비용
| 정책 | 벤치마크 | RRSI | ||
|---|---|---|---|---|
| Claude Opus 4.8 | Terminal-Bench 2.1 (Evolve) | 74.2 | 80.2 | +6.0 |
| Claude Opus 4.8 | SWE-bench Verified (OOD) | 82.0 | 83.8 | +1.8 |
| Gemini 3.5 Flash | Terminal-Bench 2.1 (Evolve) | 64.6 | 78.7 | +14.1 |
| Gemini 3.5 Flash | SWE-bench Verified (OOD) | 76.8 | 79.0 | +2.2 |
Gemini 3.5 Flash로 독립적으로 코딩 진화를 돌려도 같은 패턴이다. Terminal-Bench 2.1 +14.1, 본 적 없는 SWE-bench Verified +2.2. 더 나아가 Gemini 3.5 Flash로 진화한 하네스를 검색에 전혀 참여하지 않은 더 작은 Gemini 3.1 Flash Lite로 돌리면 Terminal-Bench 2.1이 11.2→14.6(+3.4, 상대 30.4%)으로 오른다. 하네스는 가중치가 아니라 프로그램이므로, 검색에 쓴 정책에서만 통하는 메커니즘은 재사용 가능한 메커니즘이 아니라는 저자들의 기준에서 이 실험이 중요하다.
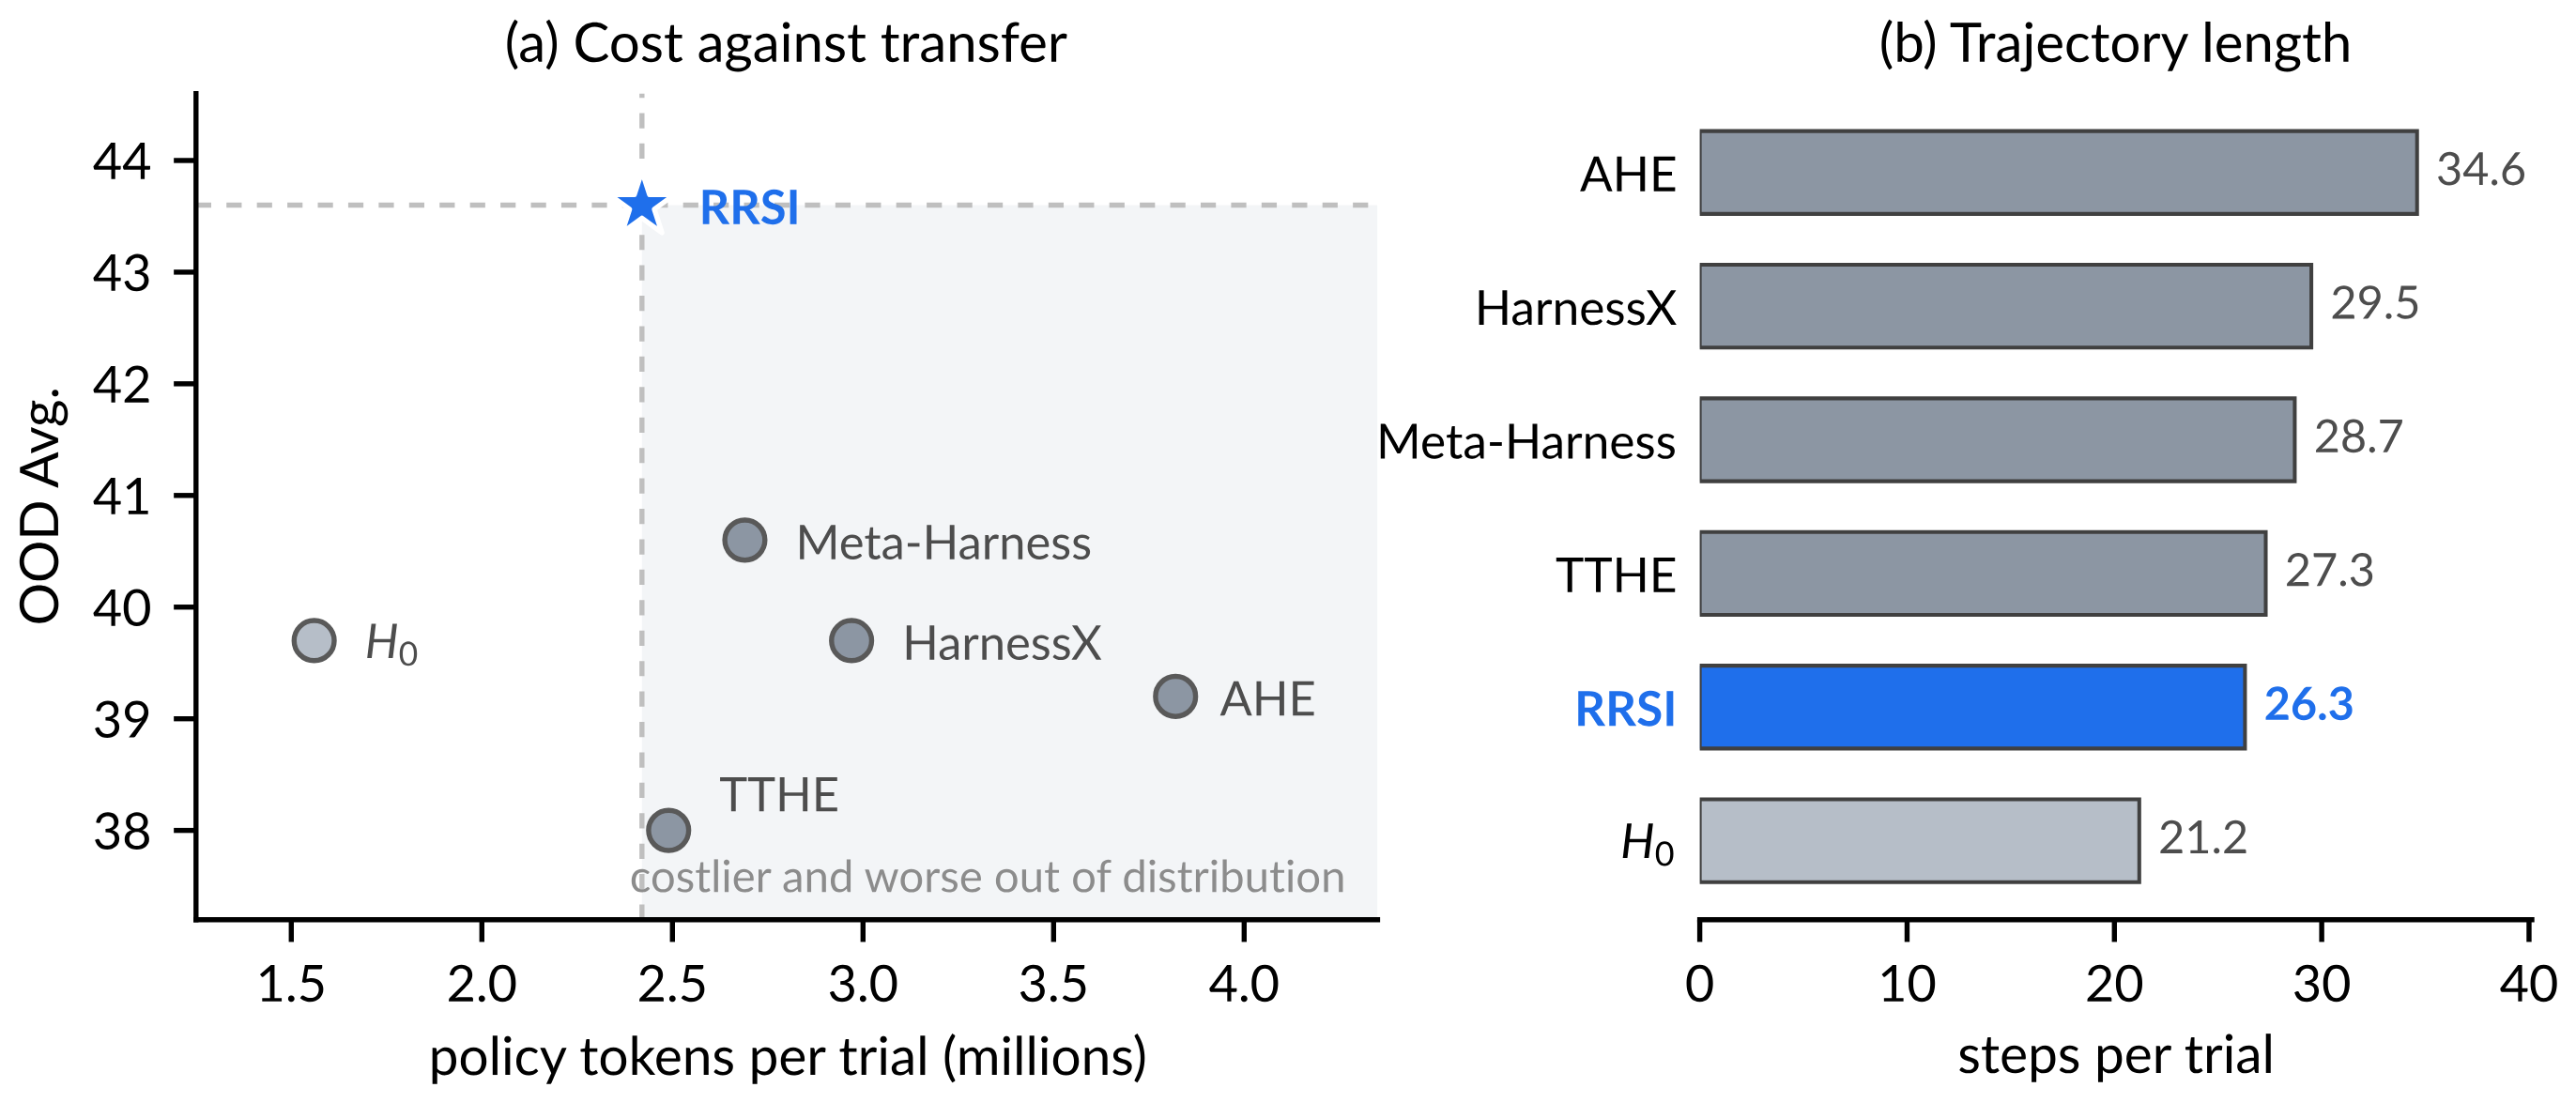
그림 4(a)는 RRSI가 지배하는 영역을 회색으로 칠했다. 네 기존 방법 전부 그 안에 있다. 극단은 AHE로, trial당 3.82M 토큰을 써서 RRSI보다 58% 비싸면서 OOD는 4.4점 낮다. 궤적 길이도 RRSI 26.3 스텝 대 기존 27.3~34.6이다. 다만 어떤 진화 하네스도 (1.56M 토큰, 21.2 스텝)만큼 싸지는 않다. 진화는 이득의 일부를 테스트 시점 연산으로 사는 것이고, 예산이 그 양을 정한다.
🧭 정리, 한계, 열린 질문
RRSI가 하는 일은 "하네스 자기 개선 루프에 머신러닝 정규화의 상식을 이식하는 것"으로 요약된다. (1) 편집 예산을 코사인으로 어닐링해 후반 라운드를 단일 귀속 가능 편집으로 만들고, (2) 전체 진화 이력을 증거로 삼으며 정체 시 미탐험 구성요소를 강제로 시도하고, (3) 비평가가 평가 전에 누수를 거르고, 노이즈 보정 하한·비용 조건·가지치기가 무엇이 영구 상태가 될지 결정한다. 결과는 진화 세트에서 가장 적게 벌고 OOD에서 가장 많이 남기며, 가장 가벼운 하네스다.
Raven 글에서 다룬 HarnessBank가 유효성·활성화·paired gain 세 관문과 quality-diversity 아카이브로 진화를 관리했다면, RRSI는 그 관문에 누수·노이즈·비용이라는 축을 더하고 제안 단계 자체를 희소화한다는 점에서 상보적으로 보인다. 두 논문이 모두 "진화 이득은 전이되지 않을 수 있다"는 같은 경고에서 출발한 것도 흥미롭다.
읽으면서 남는 한계와 질문은 다음과 같다.
- 저자 스스로 밝힌 한계: 백본이 고정된 하네스 수준 RSI만 다루며 가중치가 바뀌는 설정은 다루지 않는다. 유한한 진화 세트와 여러 정규화 하이퍼파라미터에 의존하므로 피드백 신호의 품질과 검색 예산에 효과가 좌우될 수 있다. 다른 에이전트 아키텍처, 도구 생태계, 더 긴 자기 개선 과정으로의 일반화는 추가 검증이 필요하다.
- // 대응은 명시적으로 유추일 뿐이다. 왜 이 조합이 다른 조합보다 나은지에 대한 이론적 근거는 없고, 제거 실험이 유일한 증거다.
- Harvey LAB에서의 진화 세트 이득이 +1.1로 작은 것은 정규화의 대가다. "진화 세트에서 덜 벌어야 OOD에서 더 남는다"가 일반 법칙인지, 아니면 이 벤치마크 조합의 특성인지는 더 봐야 한다.
- EngDesign은 61개 과제라 ID held-out 분할이 없고, Frontier-Eng은 47개 중 38개 과제만 채점에 기여했다. 신뢰구간이 넓은 이유다(Frontier-Eng +4.3의 95% CI는 [+1.1, +12.1]).
- 정체 판정이나 비평가의 "벤치마크 특정 로직" 판단은 결국 LLM의 판단이다. 비평가가 못 잡는 더 교묘한 누수, 예컨대 채점 방식 자체를 재진술한 Meta-Harness의 사례 같은 것을 RRSI의 비평가가 체계적으로 막는지는 사례 하나로는 알 수 없다.
하네스를 사람이 짜던 단계에서, 조합하는 단계를 거쳐, 이제 스스로 고치는 단계에 왔다. 이 논문의 메시지는 그 마지막 단계가 공짜가 아니라는 것이다. 자기 개선 루프는 그 자체로 과적합하는 학습기이고, 학습기에는 정규화가 필요하다.
📚 참고
- 원문: RRSI: Regularized Recursive Self-Improvement of Agent Harnesses (arXiv 2609.24972, v3 2026년 10월 4일)
- HTML 버전: https://arxiv.org/html/2609.24972
- Hugging Face Papers: https://huggingface.co/papers/2609.24972
- 코드/프로젝트: github.com/google-research/rrsi, regularized-rsi.com
- 관련 글: Raven: 하네스의 하네스, Effective harnesses for long-running agents
본 글의 그림은 원문에서 가져왔습니다.