Paper2Agent: 논문을 MCP 서버로 바꾸면 논문끼리 대화한다
"1665년 이래 학술지는 사람이 읽으라고 쓴 정적인 기록이었다. 논문이 스스로 실행되고, 다른 논문과 대화한다면?"
2026년 9월 16일, 스탠포드 의대 James Zou 교수와 박사후 연구원 Jiacheng Miao가 이끄는 팀이 Paper2Agent: Reimagining Research Papers As Interactive and Reliable AI Agents 를 Nature에 실었다. arXiv 프리프린트(2509.06917)는 2025년 9월에 먼저 공개됐고, GitHub 저장소는 이 글을 쓰는 시점에 스타 3,700개를 넘겼다.
아이디어는 단순하면서 과감하다. 논문의 본문, 보충자료, 코드, 데이터를 MCP(Model Context Protocol) 서버 하나로 묶고, 거기에 Claude Code 같은 채팅 에이전트를 연결해 "그 논문의 가상 교신저자" 역할을 하는 논문 에이전트(paper agent) 를 만든다. Zou의 표현을 빌리면 "돌에 새기던 지식을 종이 위 글자로 옮긴 것은 큰 발전이 아니었다. 이제는 수동적 기록물을 능동적 지식 개체로 바꿀 기회"라는 것이다.
원문: Nature · arXiv 2509.06917 · GitHub
🤔 문제: 논문은 읽을 수 있지만 "쓸 수" 없다
논문이 새 계산 방법을 제안하면, 독자가 그 방법을 자기 데이터에 적용하기까지의 거리는 꽤 멀다. 저장소를 찾고, 의존성을 깔고, 환경을 맞추고, API 계층과 파라미터 의미를 해독해야 한다. 저자들은 DeepMind의 유전체 파운데이션 모델 AlphaGenome 을 예로 든다. 모델 자체는 강력하지만, 코드로 쓰려면 환경 설치, API 키로 클라이언트 생성, variant 객체 구성, 출력 모달리티 선택까지 거쳐야 해서 생물학자에게는 진입장벽이 높다.
Papers with Code, Binder, CodeOcean 같은 "실행 가능한 논문" 시도는 재현성을 높였지만, 코드를 이해하고 커스터마이즈해서 새 문제에 적용하는 장벽은 그대로 남았다. Paper2Agent는 여기서 한 발 더 나간다. 논문을 "지식을 담은 문서"에서 "실행과 대화가 가능한 지식 개체"로 바꾸겠다는 것이다. 단순히 논문 텍스트에 RAG를 거는 것이 아니라, 본문·보충자료·코드·데이터·예제·분석 워크플로우 전체를 에이전트화한다.
🧠 핵심 아이디어: 논문 하나 = MCP 서버 하나
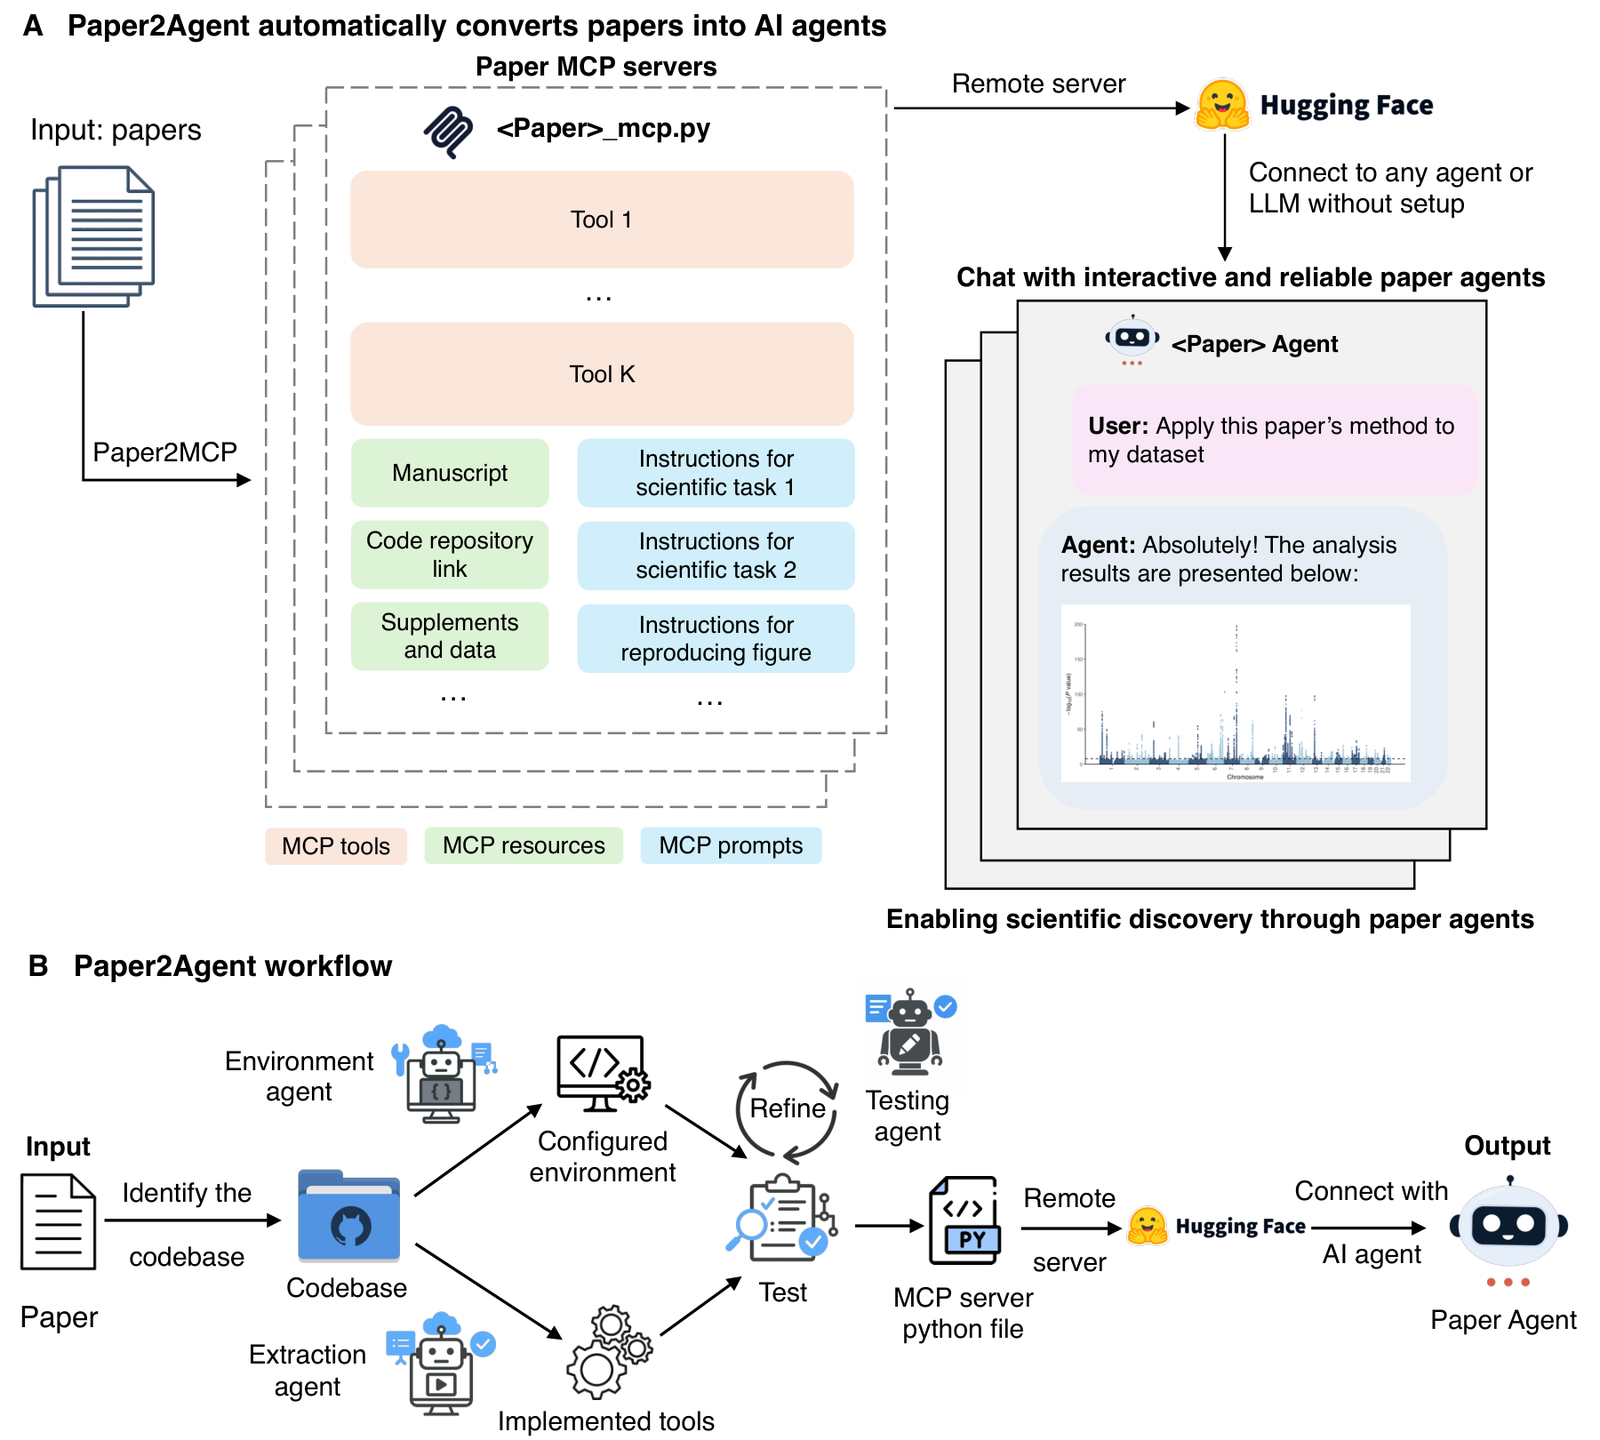
Paper2Agent는 두 층으로 구성된다.
- Paper2MCP: 논문과 코드베이스에서 정보를 뽑아 원격 MCP 서버를 만든다.
- 에이전트 층: 각 MCP 서버를 컨텍스트 제공자로 감싸 논문 전용 에이전트를 만든다.
MCP 서버 하나는 MCP 스펙의 세 가지 프리미티브를 그대로 활용한다. 이전에 올린 MCP 글 두 편(MCP 완전 정복, MCP 업데이트)에서 다룬 Tools/Resources/Prompts가 논문이라는 도메인에 어떻게 매핑되는지 보면 흥미롭다.
| MCP 구성요소 | Paper2Agent에서의 역할 | 예시 |
|---|---|---|
| Tools | 논문의 방법론적 기여를 실행 가능한 함수로 캡슐화. 환경이 미리 구성됨 | AlphaGenome의 score_variant_effect(), visualize_variant_effects() |
| Resources | 원고 본문, 코드 저장소, 데이터셋, 표, 그림 등 정적 자산 | AlphaGenome 학습 데이터 링크 |
| Prompts | 논문/코드에서 추출한 다단계 워크플로우 지시문 | Scanpy의 전처리→클러스터링 순서 |
서버는 Hugging Face Spaces 같은 곳에 원격 호스팅되므로 사용자는 로컬 의존성 지옥을 겪지 않는다. MCP는 모듈형이라 여러 논문의 MCP를 한 에이전트에 동시에 꽂을 수 있고, 이것이 뒤에 나올 "논문 간 협업"의 기반이 된다.
저자들이 강조하는 설계 원칙은 신뢰성(reliable) 이다. 각 도구는 원본 코드베이스의 예제 데이터로 결과와 그림을 검증한 뒤 고정(lock) 된다. LLM이 매번 코드를 새로 생성하다가 틀린 과학적 결과를 내는 "코드 환각"을 막기 위해서다. 모든 도구에는 원 논문 코드로의 참조 링크가 달려 추적 가능하다.
📐 파이프라인 상세: 여섯 단계, 여섯 서브에이전트
Paper2Agent 자체는 Claude Code의 Agent SDK 위에 구현된 멀티 에이전트 시스템이다. 오케스트레이터 에이전트가 역할별 서브에이전트를 순차적으로(튜토리얼이 여럿이면 병렬로) 호출하고, 단계 사이는 표준화된 JSON 리포트와 파일 규약으로 데이터를 넘긴다.
- 코드베이스 탐색·다운로드: 원고 본문, 참고문헌, 보충자료에서 저장소를 자동 식별. 실패하거나 후보가 여럿이면 사용자가 URL 지정.
- 환경 구성 (Environment manager): 격리된 가상환경을 만들고 의존성을 설치.
- 튜토리얼 발견 (Tutorial scanner): 저장소에서 진짜 튜토리얼과 그 외 파일을 구분해 분류 인덱스(JSON)를 생성.
- 튜토리얼 실행·감사 (Tutorial executor): 선택된 튜토리얼을 예제 데이터로 끝까지 실행해 입력·출력·그림·실행 제약을 캡처. 이것이 이후 테스트의 "정답(gold standard)"이 된다.
- 도구 추출·테스트·개선: Tool extractor-implementor가 튜토리얼을 재사용 가능한 함수로 변환(하드코딩된 경로·임계값·컬럼명을 파라미터화, 파일 기반 I/O 강제, MCP 도구 데코레이터 부착). 이어 Test verifier-improver가 함수별 테스트를 작성·실행·수정한다.
- MCP 서버 조립: 검증된 도구 모듈을 매니페스트, 버전, 기본 보안 설정과 함께 하나의 MCP 서버로 통합.
테스트 통과 기준이 구체적이다. 기대 파일이 생성되고, 수치가 튜토리얼 출력과 일치하며(부동소수점 3% 허용오차), 그림이 레퍼런스와 일치해야 한다(perceptual hashing, Hamming distance < 20). 함수당 최대 6회 수정 시도 후에도 실패하면 MCP 데코레이터를 떼고 실패 코멘트를 남겨 서버에서 제외한다.
GitHub README를 보면 현재는 이 파이프라인이 코딩 에이전트용 스킬(skills/paper2agent) 형태로 배포되어, Claude Code나 Codex에 스킬을 설치한 뒤 /paper2agent Convert <GITHUB_URL> into tested MCP tools in <DIR> 식으로 호출하게 되어 있다.
📊 사례 1: AlphaGenome 에이전트 — 정확도와 속도
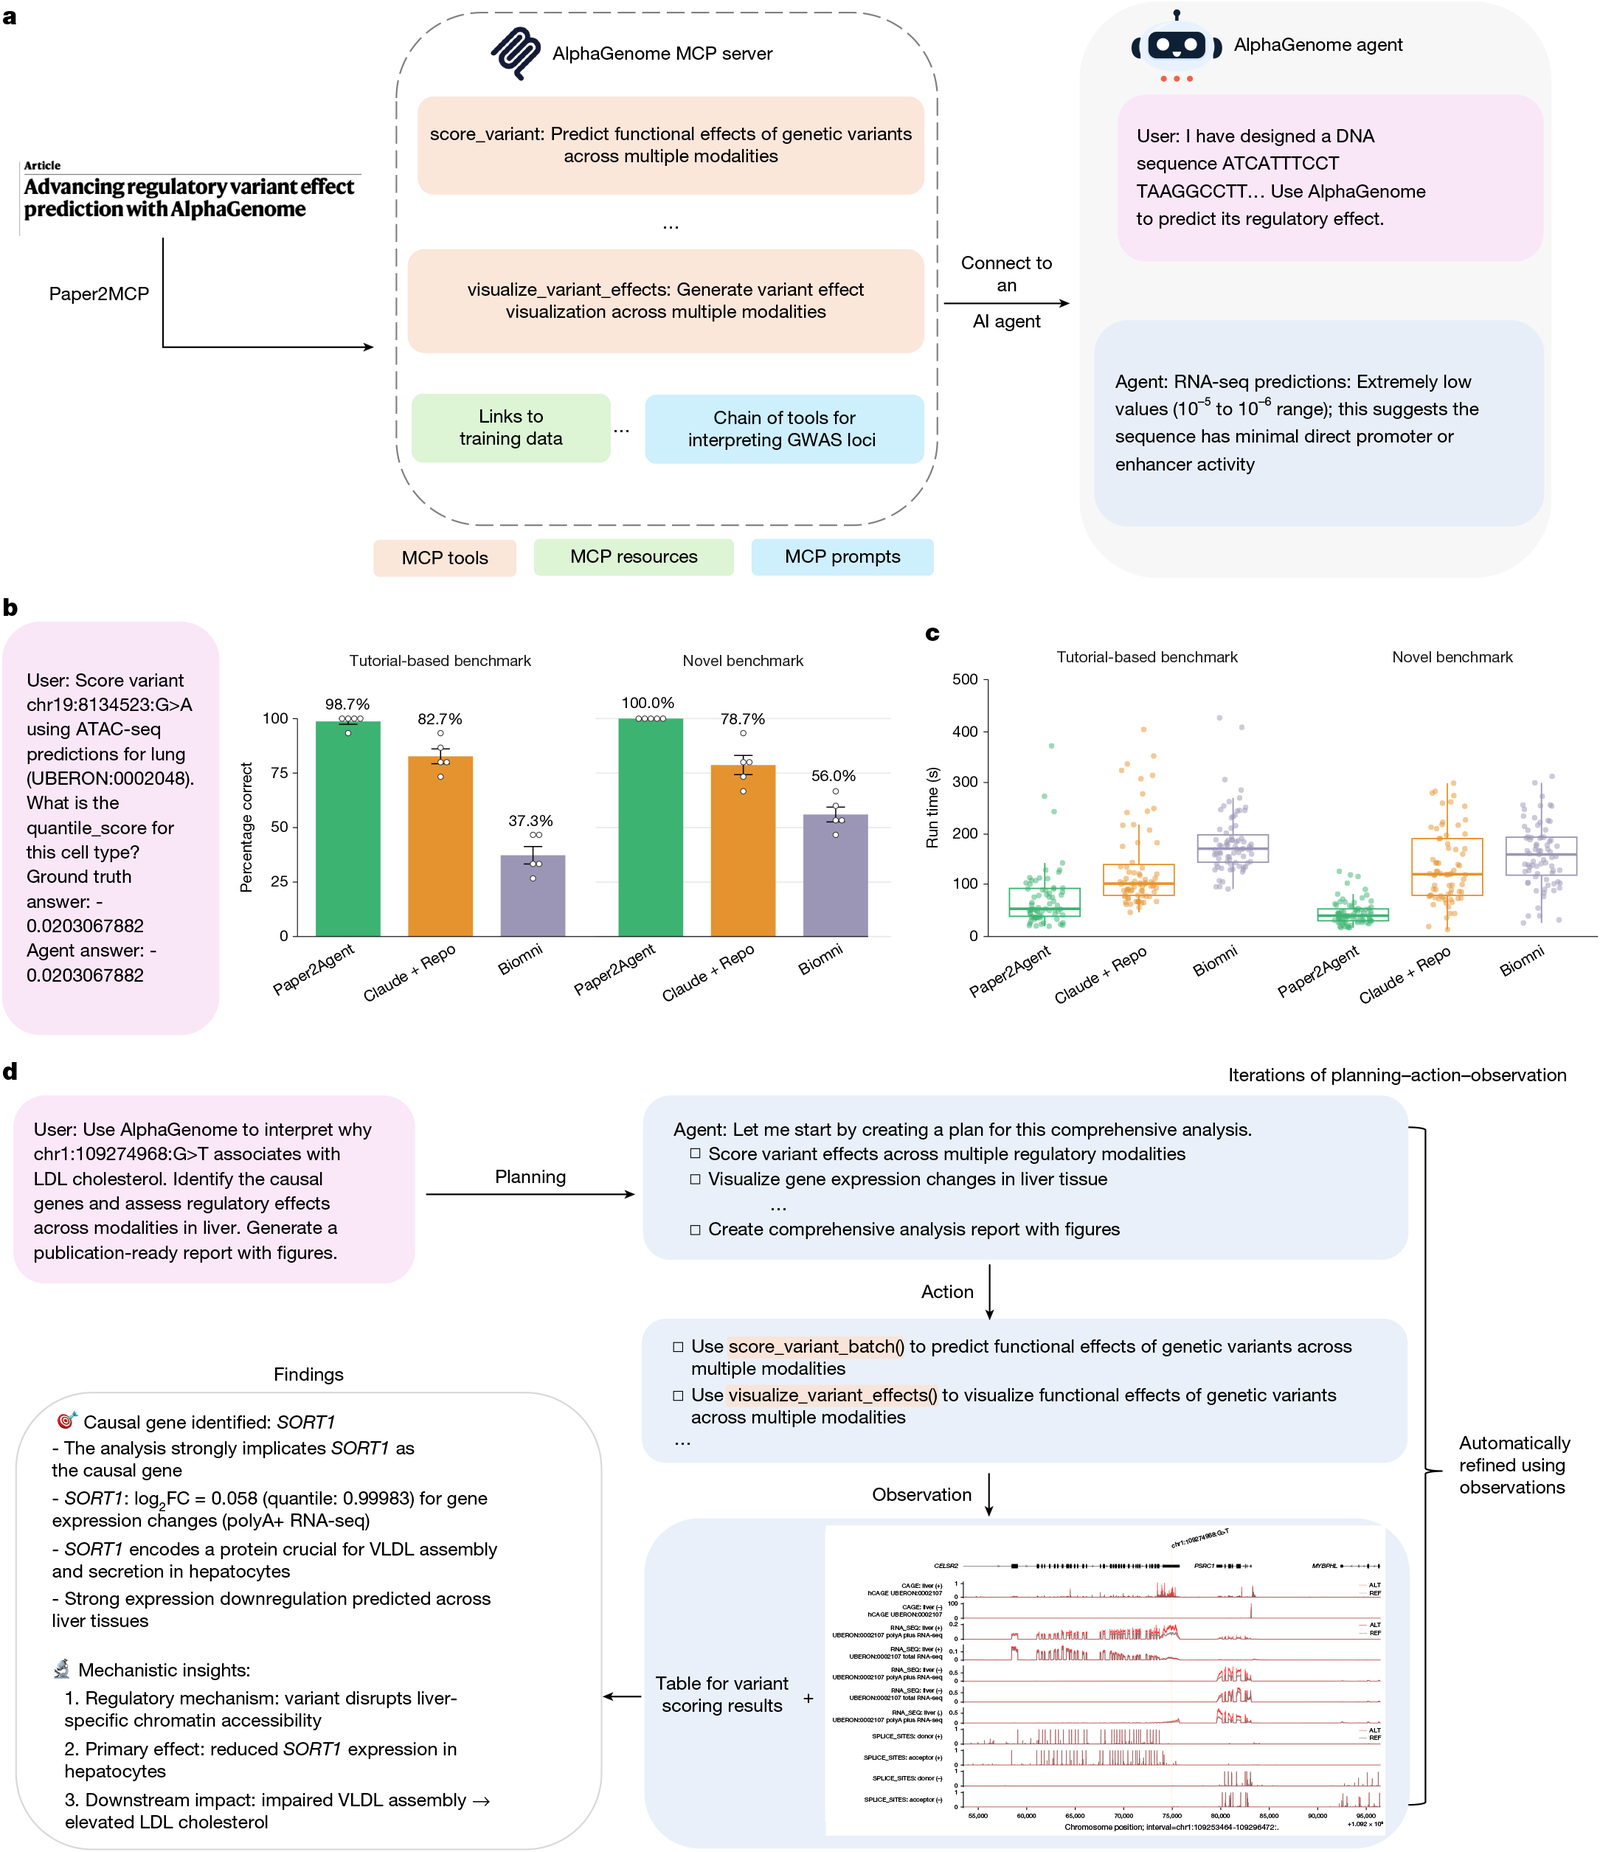
AlphaGenome 논문에 Paper2Agent를 돌리자 약 45분, 14달러 비용으로 개인 노트북에서 사람 개입 없이 22개 MCP 도구가 생성됐고 전부 자동 검증을 통과했다. 단일/배치 변이 스코어링, 서열 수준 예측, 조직 온톨로지 탐색, 시각화 도구까지 포함한다.
벤치마크는 세 가지 설정을 비교했다. 평가 중 Paper2Agent 에이전트는 원고나 원본 저장소에 접근하지 못했고, 두 명의 전문가가 사전 정의된 루브릭으로 채점했다(평가자 간 일치율 96.7%).
| 벤치마크 (5회 반복) | Paper2Agent | Claude + Repo | Biomni |
|---|---|---|---|
| 튜토리얼 기반 15문항 | 98.7 ± 1.3% | 82.7 ± 3.4% | 37.3 ± 4.0% |
| 신규 15문항 | 100.0 ± 0.0% | 78.7 ± 4.4% | 56.0 ± 3.4% |
| 개방형 연구자 스타일 30문항 | 82.7 ± 2.4% | 56.7 ± 2.3% | 72.2 ± 2.2% |
실행 시간도 중앙값 기준 튜토리얼 쿼리에서 Claude+Repo 대비 1.9배, Biomni 대비 3.1배 빨랐고, 신규 쿼리에서는 각각 2.9배, 3.8배였다. 저자들에 따르면 이 격차는 프롬프트 패러프레이징에도 유지됐고, 베이스라인을 Claude Opus 4.6 같은 최신 모델로 올려도 남았다.
그림 (d)의 LDL 콜레스테롤 사례가 흥미롭다. 원 AlphaGenome 논문은 chr1:109274968:G>T 변이의 인과 유전자로 CELSR2와 PSRC1을 강조했는데, 에이전트는 SORT1 을 1순위로 꼽았다. 간 조직 발현 quantile score 0.99983, 그리고 SORT1이 LDL/VLDL 분비에 직접 관여하는 sortilin을 코딩한다는 근거였다. GTEx eQTL을 확인하니 이 변이는 SORT1의 유의한 eQTL이었다(). 다만 CELSR2, PSRC1 역시 높은 점수(0.99998)와 유의한 eQTL을 보여, 결국 "여러 인접 유전자의 eQTL인 복잡한 GWAS 좌위에서 인과 유전자를 확정하기 어렵다"는 본질적 난제를 드러낸 셈이다. 저자들은 이를 "프롬프트 하나로 발표된 결론을 독립적 모델 증거로 재평가할 수 있다"는 강점으로 해석한다.
📊 사례 2: Scanpy 에이전트 — MCP Prompts로 워크플로우 고정
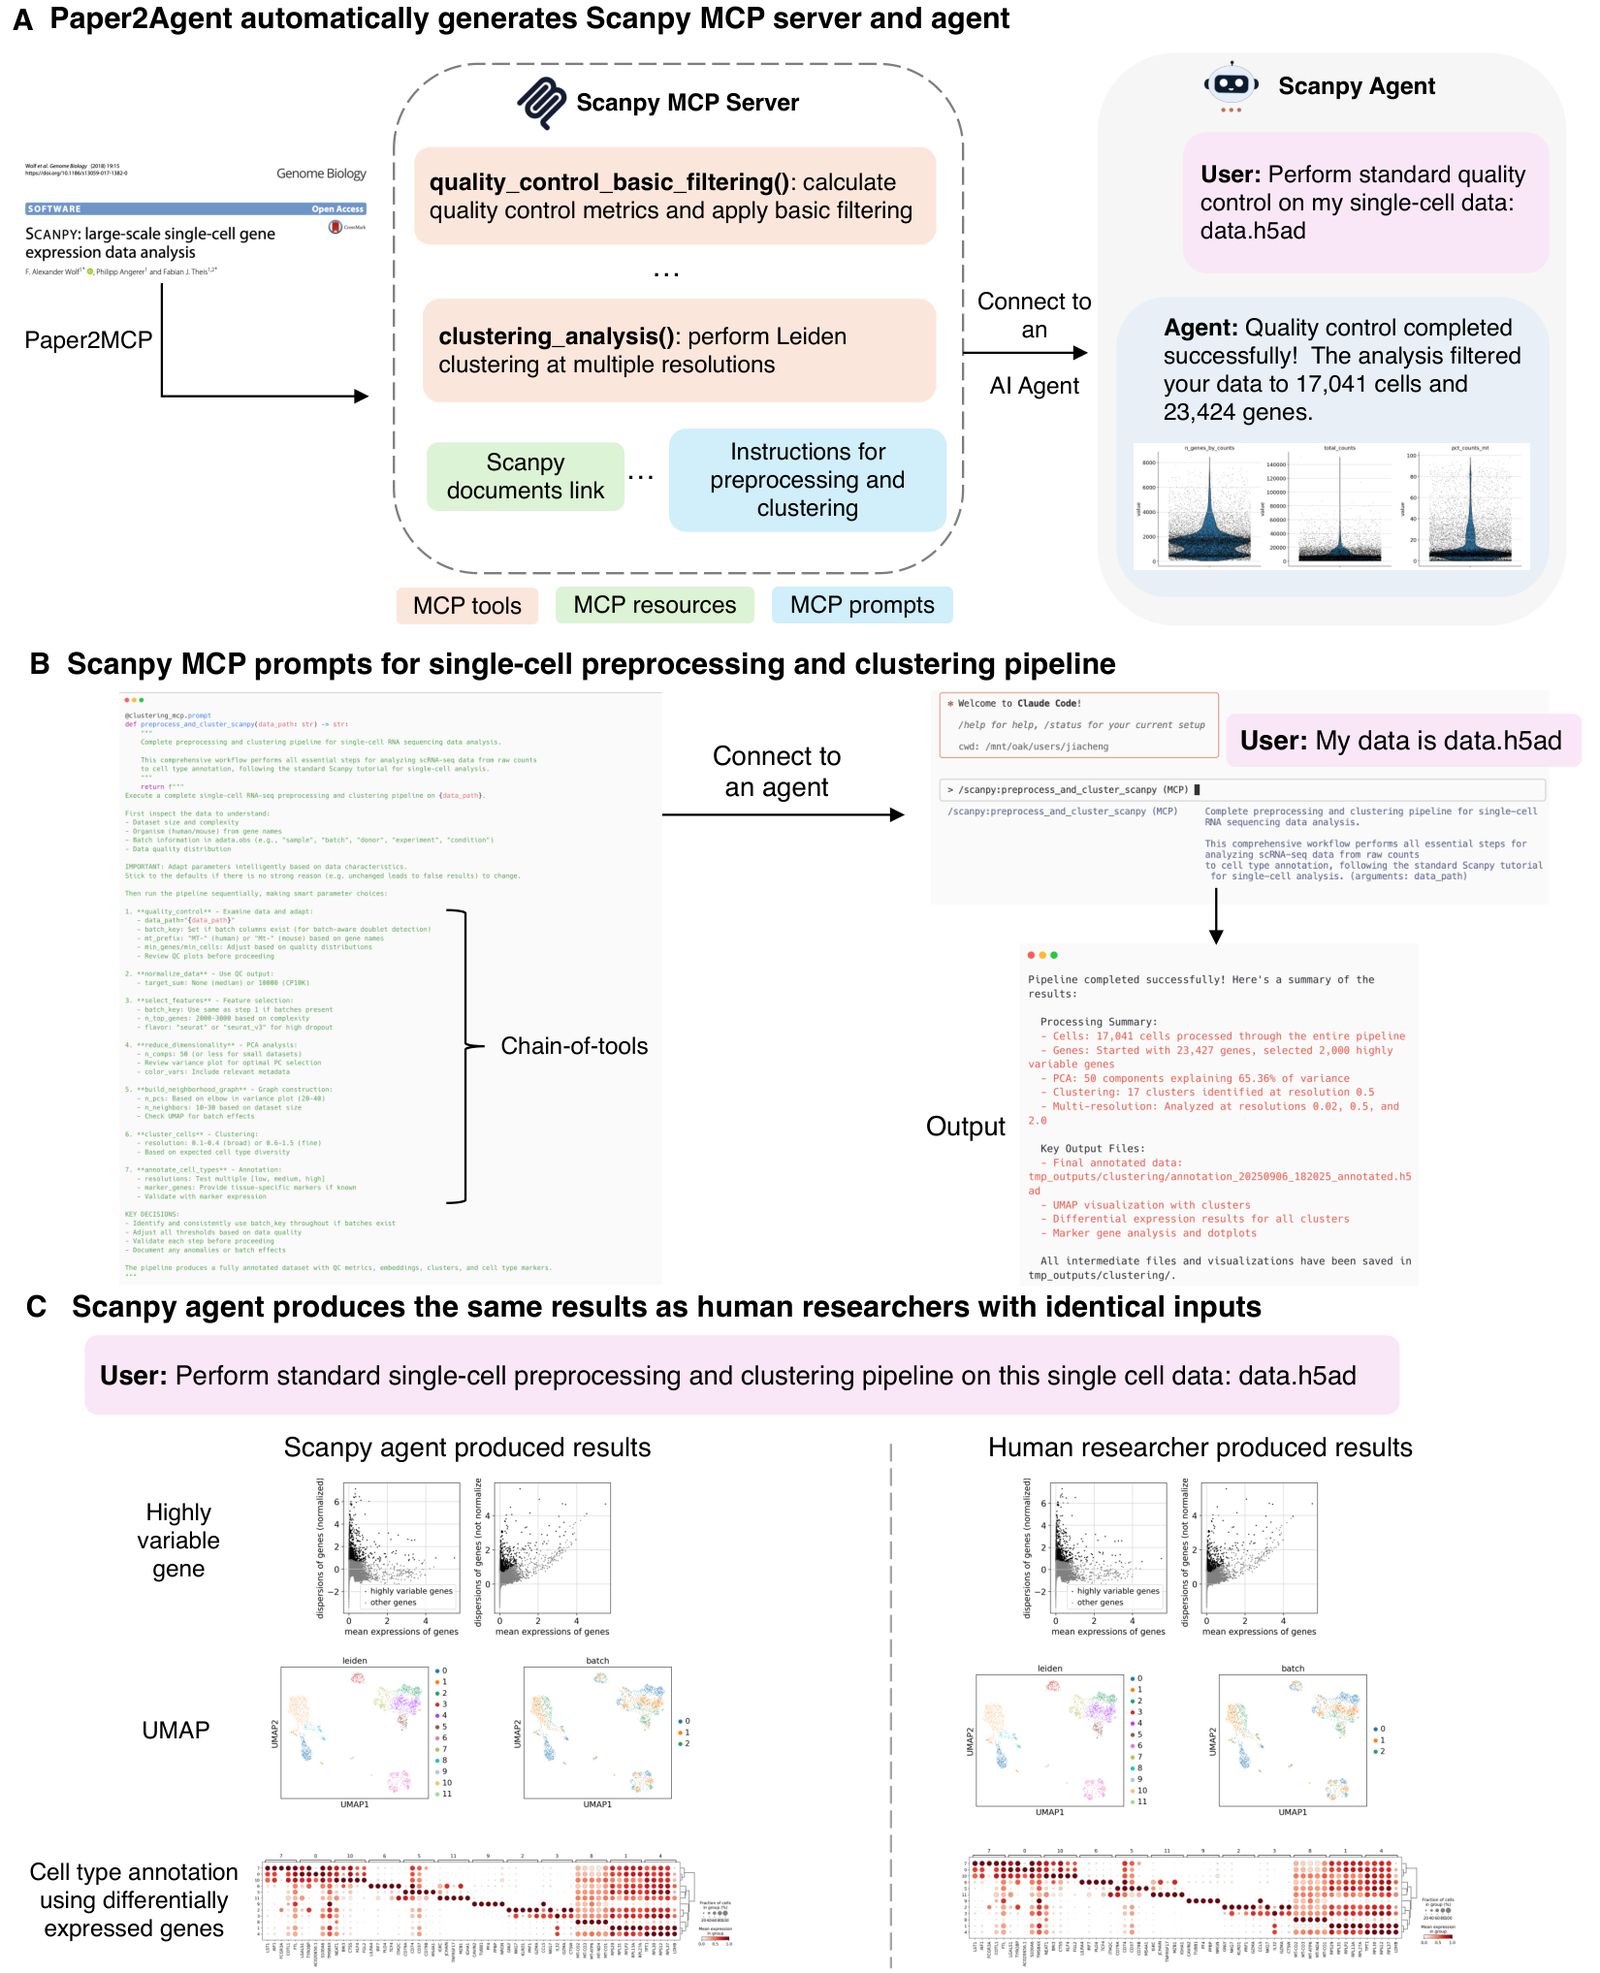
단일세포 분석 패키지 Scanpy에서는 가장 흔한 용도인 전처리·클러스터링에 집중해 7개 도구가 약 45분, 13달러에 생성됐다. 여기서 핵심은 MCP Prompts 의 쓰임새다. 전처리 파이프라인은 도구를 올바른 순서로 실행해야 하는데, 에이전트가 그 순서를 "알고" 있거나 사용자가 정교한 프롬프트를 써야 한다. Paper2Agent는 논문과 코드에서 워크플로우를 추출해 MCP prompt로 인코딩하고, 사용자는 데이터 경로만 주면 된다.
그림 (B)의 프롬프트를 보면 "먼저 데이터를 점검하고(크기, 생물종, 배치 정보), 명확한 이유가 없으면 기본값을 유지하라"는 지시와 함께 7단계 chain-of-tools가 적혀 있다. 공개 데이터셋 4종에서 에이전트 결과는 사람 연구자와 QC 후 세포·유전자 수, 클러스터별 상위 마커 유전자가 일치했고, 7종의 다양한 데이터셋에서는 데이터 특성에 따라 파라미터를 적응적으로 조정했다.
📊 대량 평가: 100편 중 74편 에이전트화
스케일 검증으로 세 코퍼스를 수동 정리·코드 수정·개입 없이 끝까지 처리했다.
- 계산생물학 논문 100편 (bioRxiv bioinformatics에서 문서 품질 필터링 없이 시간 역순 샘플링): 74편 성공, 제안된 도구 599개 중 593개 가 자동 검증 통과. 실패 원인은 실행 가능한 코드 부재, 데이터/모델 아티팩트 누락, 환경·의존성 실패, 일반화 불가능한 스크립트.
- 튜토리얼 기반 300문항에서 Paper2Agent(Sonnet 4) 91.2 ± 1.6% vs. Claude Code+Repo Sonnet 4 80.3 ± 2.3%, Sonnet 4.6 86.3 ± 1.1%. 쿼리당 비용·지연도 0.20달러/1.6분 vs. 0.38달러/4.3분.
- 비생물학 계산 논문 10편 (grf, SAELens, SAM2, TabPFN, emcee 등): 실행 기반 42개 과제에서 98.1 ± 0.8%.
- 데이터·발견 중심 논문 26편: 실행 도구를 만들 수 없어도 리소스 층만으로 100개 종합 질문에서 89.0 ± 3.1%, Claude 브라우저 사용 베이스라인(82.0%) 대비 34배 저렴, 15배 빠름.
추가로 순열 벤치마크(논문-질문을 섞음)에서 범위 밖 질문을 100% 거부했고, 의존성·경로·오타·폐기 API를 일부러 주입한 "저장소 드리프트" 테스트에서도 MCP 서버를 복구했다고 한다.
🔍 논문 에이전트끼리 협업하기: ADHD와 MPHOSPH9
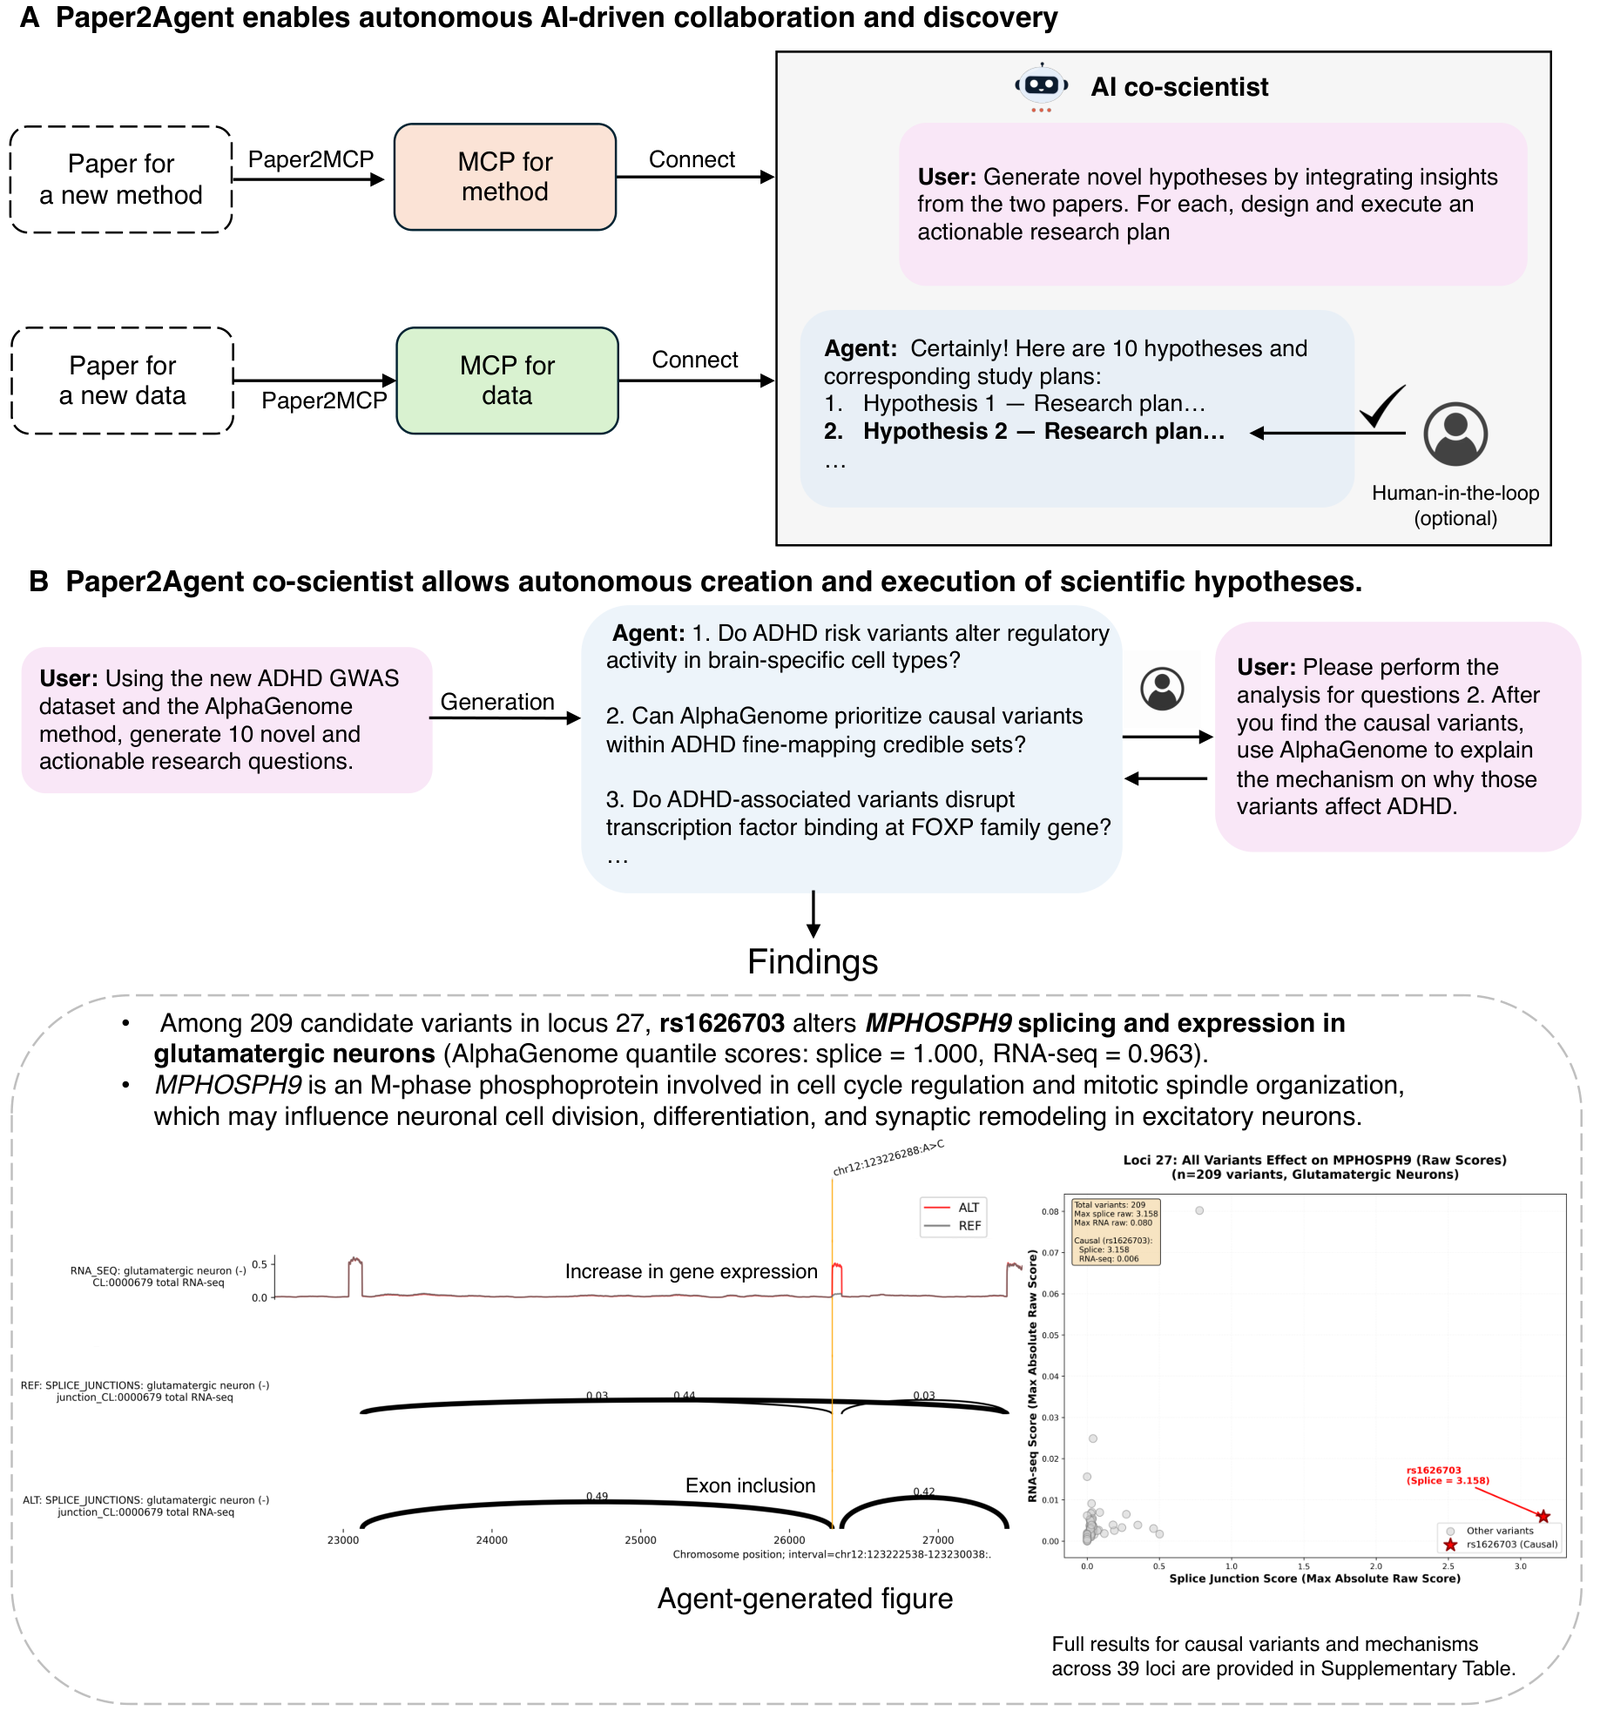
이 논문에서 가장 눈길을 끄는 부분이다. 사람의 과학 협업은 종종 "새 방법을 새 데이터에 적용"하면서 진전되는데, 두 연구 그룹이 서로를 찾아내는 과정 자체가 느리다. Paper2Agent에서는 방법 논문의 에이전트와 데이터 논문의 에이전트를 같은 co-scientist에 꽂으면 된다.
스탠포드 뉴스와 arXiv 버전이 중심으로 소개한 사례는 AlphaGenome(방법) + ADHD GWAS(데이터) 조합이다. 사용자가 "두 논문을 통합해 새롭고 실행 가능한 연구 질문 10개를 만들어 달라"고 하자 에이전트는 "ADHD 위험 변이가 뇌 특이적 세포 유형의 조절 활성을 바꾸는가?", "AlphaGenome으로 fine-mapping credible set 안의 인과 변이를 우선순위화할 수 있는가?" 같은 질문을 제시했다. 사람이 2번을 고르자 에이전트는 다음을 수행했다.
- 좌위 27의 credible set 후보 변이 209개 중 인트론 변이 rs1626703 을 인과 변이로 우선순위화
- AlphaGenome으로 이 변이가 글루탐산성 뉴런에서 MPHOSPH9 의 스플라이싱과 발현을 바꾼다고 예측(quantile score: splice junction 1.000, RNA-seq 0.963). 대립유전자에서 exon inclusion이 강화되어 발현이 올라가는 메커니즘
- 이어 39개 좌위 전체 에 대해 credible set 추출 → 뉴런에서 기능 스코어링 → 단백질 코딩 유전자 필터링 → 모달리티별 최대 quantile 점수로 순위화 → 좌위별 마크다운 리포트 작성 워크플로우를 스스로 구성해 2시간 내 완료
Zou는 스탠포드 뉴스에서 MPHOSPH9 근처 변이와 ADHD 위험의 연결이 "이전에 보고된 적 없는" 것이라고 말했다. 다만 Nature 본문은 이 결과를 "후속 인간 평가가 필요한 가설"로 위치시키며, 본문의 메인 발견 사례는 아래 건선 사례로 바꾸고 ADHD 사례는 Extended Data Fig. 2와 Supplementary Note로 옮겼다.
Nature 본문의 메인 사례: 건선 변이 rs887314과 GPR137
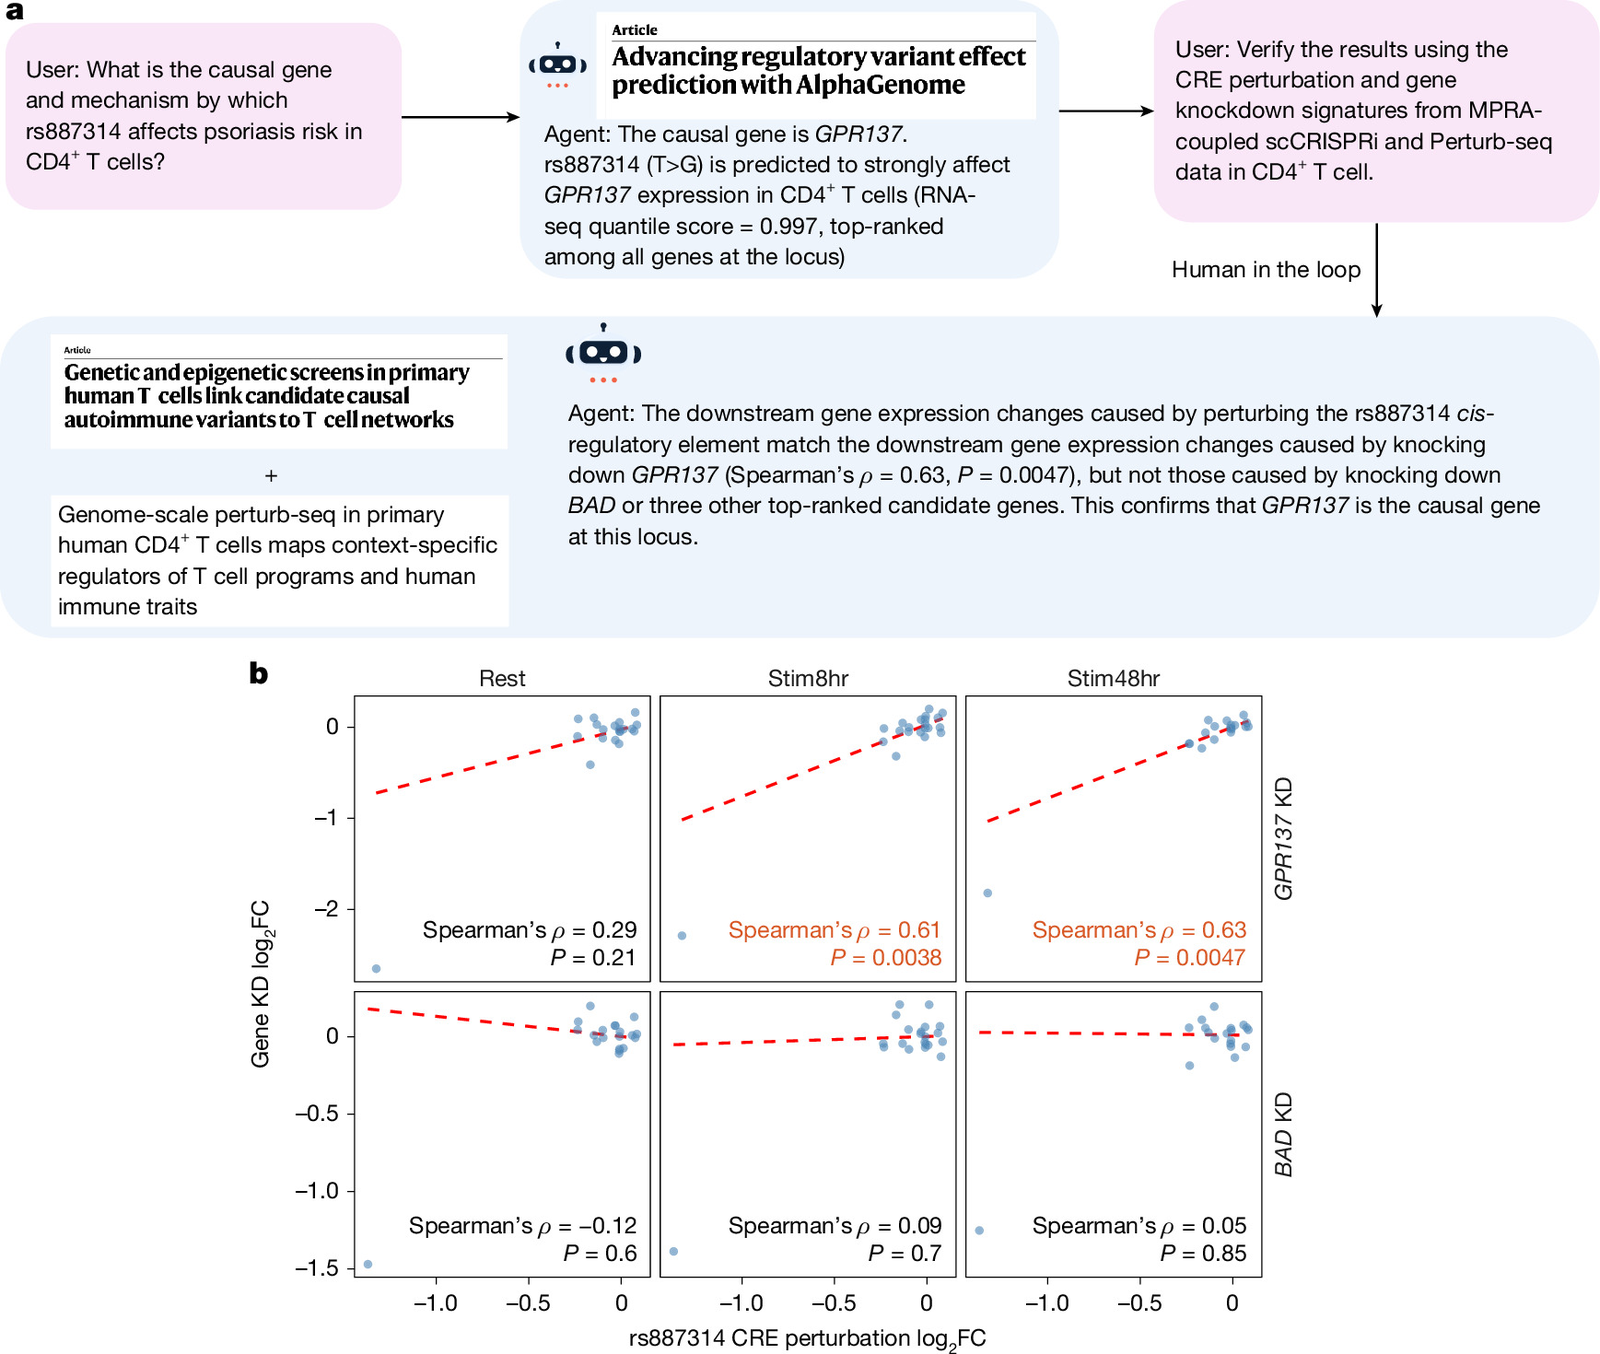
Nature 버전은 세 개의 논문 에이전트 를 엮었다. AlphaGenome 에이전트가 rs887314 좌위에서 GPR137 을 1순위 유전자로 예측(RNA-seq quantile 0.997)하자, 연구자는 MPRA-coupled scCRISPRi 스크린 논문과 CD4+ T세포 Perturb-seq 논문의 에이전트로 교차 검증을 지시했다. co-scientist는 두 논문의 보충 표와 차등발현 통계를 스스로 분석해 10개의 검증 전략 을 제안했고, 사람이 그중 "시그니처 상관 분석"을 골랐다. 결과적으로 GPR137 knockdown만 CRE 교란 시그니처와 유의하게 일치했고(Stim8hr , Stim48hr , FDR < 0.05), 휴지 상태에서는 유의하지 않아(ρ=0.29) 활성화 의존적 역할로 해석됐다.
저자들이 굳이 짚는 점은, 이 "scCRISPRi의 CRE 교란 시그니처와 Perturb-seq의 knockdown 시그니처를 상관시킨다"는 전략 자체가 원 논문 어디에도 없던 새 데이터 통합 방법 이라는 것이다. 에이전트가 두 논문을 읽고 조합해 만들어낸 분석 설계인 셈이다.
💡 정리와 한계, 열린 질문
잘한 것
- MCP라는 표준 위에 논문을 올려 "어떤 에이전트든 바로 꽂아 쓰는" 모듈성을 확보했다. 이전 MCP 글에서 다뤘듯 Tools/Resources/Prompts 삼분법이 논문의 방법/자산/워크플로우에 거의 1:1로 대응한다는 점이 설계의 핵심이다.
- "코드 생성"이 아니라 "검증된 도구 고정"으로 재현성을 확보했다. 테스트 기준(3% 오차, pHash 거리 20, 6회 재시도)이 명시적이다.
- 단일 논문 사례를 넘어 100편 규모에서 성공률(74%)과 실패 원인을 솔직하게 보고했다.
한계와 조건
- 모든 논문이 에이전트가 되지는 않는다. 코드 불완전, 문서 부재, 환경 구성 불가 저장소는 실패한다. 저자들은 역으로 "에이전트화되는 정도가 재현성의 실용적 지표가 될 수 있다"고 말하며, 데이터·코드 가용성 섹션처럼 "agent availability" 섹션 이 논문에 생길 것으로 전망한다.
- 개방형 과학 추론(가설 생성, 메커니즘 해석)은 human-in-the-loop 로 남는다. 단일 정답과의 일치로 채점하는 벤치마크는 "분석적 타당성"이 아니라 "충실한 실행"의 척도로 봐야 한다고 저자 스스로 선을 긋는다.
- 연구 코드를 실행 가능한 에이전트로 노출하는 데 따르는 보안, 지식재산, 저작자 표시 문제가 남아 있다. Zou는 "최종 발견을 원 논문과 원 저자에게 귀속시키는 것이 여전히 중요하다"고 강조한다.
- 논문 에이전트도 업스트림 코드와 의존성이 바뀌면 유지보수가 필요하다. 저자들은 이를 실행 가능한 연구를 출판하는 데 내재된 특성으로 본다.
열린 질문
- 현재 100개 이상의 논문 에이전트가 만들어졌지만, Zou가 말하는 "수백만 논문 에이전트가 서로를 찾아 협업하는" 규모에서는 어떤 에이전트가 어떤 에이전트와 만나야 하는지 를 결정하는 탐색 문제가 핵심이 된다. 이 블로그의 arxiv-graph 프로젝트처럼 논문 간 시맨틱 유사도·공저자 그래프를 깔아두면, 그래프의 간선이 곧 "에이전트 페어링 후보"가 될 수 있다는 점에서 자연스러운 접점으로 보인다.
- SORT1 사례처럼 에이전트가 원 논문과 다른 결론을 낼 때, 그것을 "재평가"로 볼지 "오류"로 볼지 판단할 평가 체계가 아직 없다.
논문이 수동적 PDF에서 벗어나 MCP 서버로 살아 움직이고, 다른 논문과 대화하며 가설을 만든다. 아직은 사람이 가설을 고르고 검증 전략을 선택하지만, "지식의 표현 형식" 자체를 바꾸자는 제안으로서 이 논문은 충분히 읽어볼 가치가 있다.
📚 참고
- 원문(Nature): Reimagining research papers as interactive and reliable AI agents (Miao, Davis, Zhang, Pritchard, Zou, 2026.09.16)
- arXiv 프리프린트: Paper2Agent: Reimagining Research Papers As Interactive and Reliable AI Agents (2509.06917v2)
- GitHub: jmiao24/Paper2Agent
- 스탠포드 의대 뉴스: Manuscripts-turned AI agents can now 'talk' to each other, make new discoveries (Hanae Armitage, 2026.09.16)
- MCP 스펙: modelcontextprotocol.io
본 글의 그림은 원문에서 가져왔습니다.