Hippo: 하네스 대신 기억을 고친다, 해마 재생에서 빌려온 학습 없는 에이전트 자기 진화
"통합 없이 경험을 계속 쌓기만 하면 초기의 이득이 깎여 나가고, 결국 기억이 없는 기준선보다 못해진다." — 논문 1장, 세 번째 기여
2026년 10월 17일 UC Irvine의 Yutong Song, 독립 연구자 Jiang Wu, Rice 대학의 Yuxuan Ren, Zillow Group의 Tony Qin과 Baoyuan Wang이 Hippo: Training-Free Agent Self-Evolution via Hippocampal Replay(arXiv 2610.24453)를 공개했고, 10월 29일 v2가 올라왔다. 코드 저장소는 논문과 arXiv 페이지 어디에도 없다. 이 글은 v2 HTML 본문과 부록을 기준으로 쓴다.
이 블로그의 하네스 시리즈에서 "스스로를 고치는 에이전트"는 세 편이 있었다. RRSI는 하네스를 LLM이 반복 편집할 때 벤치마크 과적합을 막는 정규화였고, Harness²는 정답 없이 하네스를 고치고 고친 경험까지 쌓는 두 층의 재귀였으며, ScholarEvolve는 고칠 재료를 자기 실패 로그가 아니라 논문에서 가져왔다. 셋 다 편집 대상이 하네스 코드와 프롬프트다. Hippo는 그 대상을 한 칸 더 바깥으로 옮긴다. 모델도 하네스도 고정한 채 외부 메모리 뱅크만 쓰고 지운다. 그래서 질문도 바뀐다. 하네스를 어떻게 고칠 것인가가 아니라, 무엇을 기억하고 그 기억을 언제 지울 것인가다. 하네스 비교 논문이 "하네스는 점수를 거의 못 움직인다"고 했다면, 이 논문은 "같은 모델·같은 하네스에서 기억만 바꿔도 WebArena 8.7점이 움직인다"고 주장하는 셈이다.
원문: https://arxiv.org/abs/2610.24453
🤔 배경: 기억은 쌓을수록 좋아지지 않는다
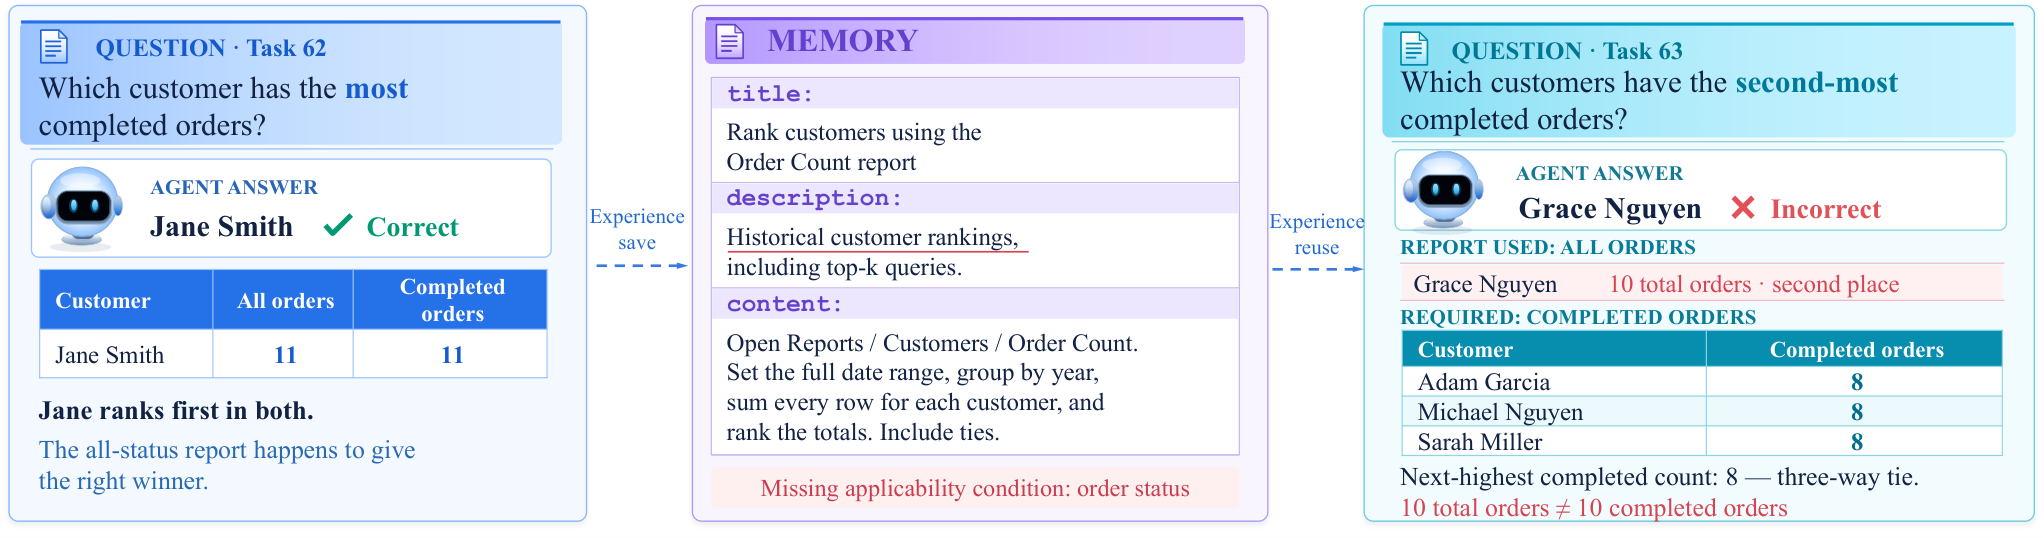
그림 1이 논문의 문제의식을 한 장에 담는다. WebArena Shopping Admin의 62번 과제에서 에이전트는 상태 필터가 없는 "Order Count" 보고서를 보고 답했는데, 하필 1위 고객이 전체 주문과 완료 주문 모두 1위라 정답으로 채점된다. 이 시도를 성공 사례로 반성하면 "Order Count 보고서로 순위를 매겨라"는 교훈이 메모리에 남고, 바로 다음 63번 과제("두 번째로 많은")에서 그 교훈을 검색해 따라가다 틀린다. 정답이 잘못된 추론을 가리고, 잘못된 교훈이 "믿을 만한 선례"로 반복 검색된다는 것이다.
저자들이 든 두 번째 근거는 실험이다. 성공·실패를 가리지 않고 통합 없이 경험을 추가하는 축적 기준선(append-all)을 돌리면 성능이 역U 곡선을 그린다. 처음엔 오르다가 내려와 결국 기억이 없는 기준선 아래로 떨어진다(4.2절, 아래 그림 4). 관련 연구로는 Reflexion, ExpeL, Agent Workflow Memory(AWM), ReasoningBank, Mem0, A-MEM 등을 들고, 특히 ReasoningBank의 MaTTS가 "여러 궤적을 비교해 메모리를 만든다"는 점에서 가장 가깝지만 보고된 통합 구현이 새 항목을 덧붙이기만 하고 가지치기·병합은 하지 않는다고 선을 긋는다. Harness² 글에서 ReasoningBank가 코딩 과제에서 base보다 최대 6.6점 떨어졌던 것을 기억한다면, 이 논문은 그 현상의 원인을 "메모리 유지 정책"에서 찾는 셈이다.
🧠 핵심 아이디어: 해마에서 두 가지를 빌린다
논문 제목의 두 단어를 구체적으로 풀면 이렇다.
Training-free. 모델 파라미터를 한 번도 갱신하지 않는다. 메모리 정책을 RL로 학습하는 Memory-R1·MEM1이나 검색 효용을 런타임 RL로 다듬는 MemRL과 달리, 실행·판정·메모리 갱신 전부를 고정된 같은 모델이 프롬프트로 수행한다(부록 C). 따라서 "진화"하는 것은 모델도 하네스 코드도 아니고, 다음 과제의 컨텍스트에 주입되는 텍스트 뱅크 뿐이다.
Hippocampal replay. 신경과학에서 두 현상을 가져온다. 하나는 선택적 부호화다. 해마–VTA 루프 모델(Lisman et al., 2005)에서 새로움 신호가 장기 부호화를 강화하고, 학습된 사건 순서가 깨질 때 해마가 반응한다(Kumaran et al., 2006). Hippo는 이를 "놀라움(surprise)이 있을 때만 반성한다"로 옮긴다. 과제가 성공했고 추론도 옳았으면 아무것도 쓰지 않는다. 실패했거나, 맞았지만 이유가 틀린 시도만 에피소드 반성 을 남긴다. 다른 하나는 **재생(replay)**이다. 깨어 있을 때의 해마 활동 패턴이 수면 중 재활성화되고(Wilson et al., 1994), 상보적 학습 시스템 이론에서는 이 재활성화가 새 경험을 기존 신피질 지식에 점진적으로 통합한다. Hippo는 이를 "에피소드 반성 을 기존 메모리 와 대조해 병합·삭제한다"로 옮긴다.
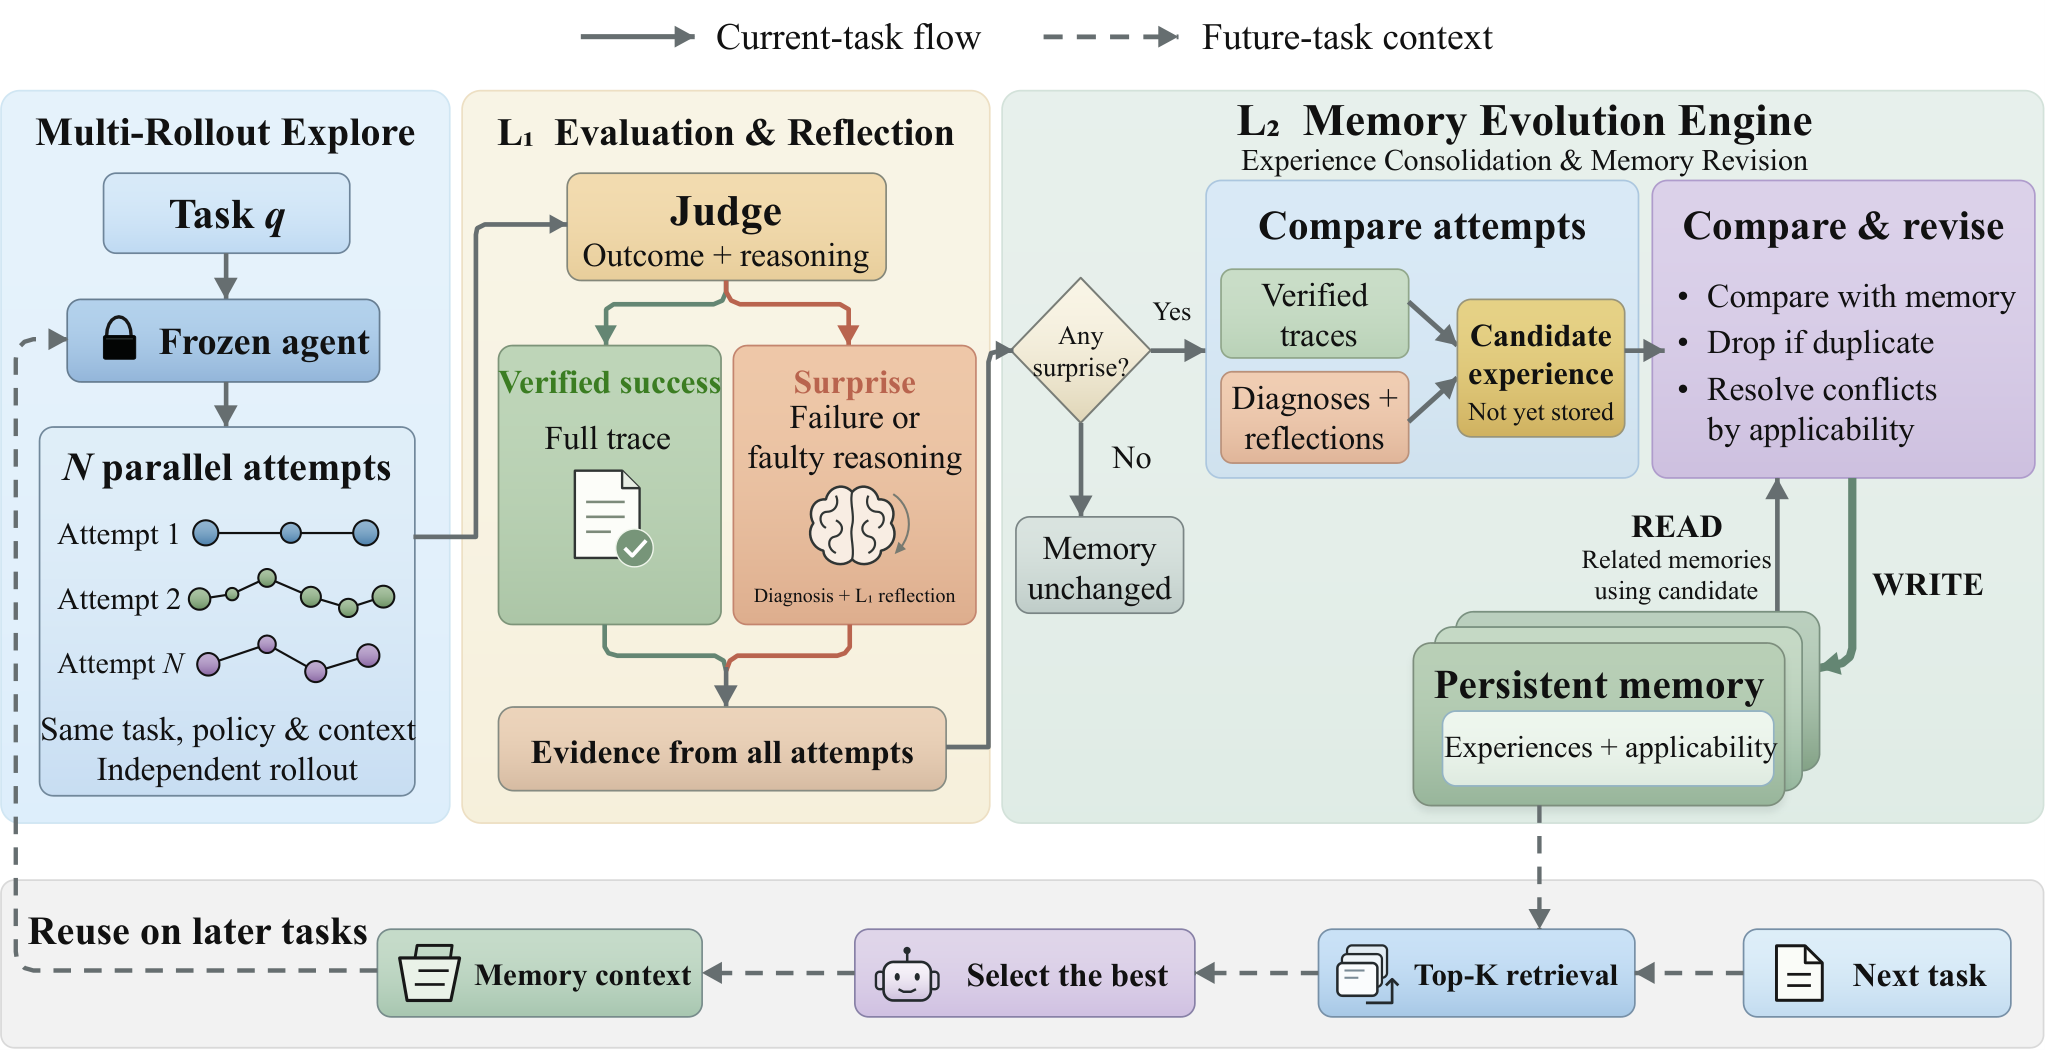
그림 2의 구조는 네 부품이다. (i) 다중 롤아웃 탐색: 고정 정책과 같은 검색 메모리로 과제를 번 돌린다. (ii) 놀라움 기반 에피소드 버퍼: 심판이 각 롤아웃을 판정하고 놀라움일 때만 반성 을 뽑는다. (iii) 메모리 진화 엔진: 롤아웃들을 대조해 후보 경험을 만들고, 기존 메모리와 비교해 병합·삭제한다. (iv) 검색·주입: 다음 과제에서 관련 메모리를 골라 컨텍스트에 넣는다. 저장되는 단위는 제목 + 적용 조건(applicability) + 절차(procedure) 세 필드의 텍스트 항목이고, 부록 F에 전문이 실려 있다. 예컨대 그림 1의 사례에서 최종적으로 남는 는 "상태 필터가 붙은 그리드를 쓰고 모든 행을 합산하라"이며, 적용 조건에 "질문이 주문 상태를 제한할 때. Order Count 보고서는 모든 상태가 해당될 때만 적합"이라고 명시된다. 논문이 강조하는 건 이 적용 조건 필드가 충돌 해소 수단이라는 점이다. 상반된 두 교훈을 하나는 지우고 하나를 남기는 대신, 각각 언제 쓰는지를 적어 공존시킨다.
📐 방법: 심판, 8번의 시도, 대조, 그리고 추가·삭제
심판과 놀라움(3.1절). 심판 는 과제 , 실행 트레이스 , 피드백 (있을 때만)을 받아 "성공이고 추론도 옳다"가 아니면 전부 놀라움으로 분류하고 진단 를 돌려준다. 반성 추출기 는 놀라움일 때만 을 쓴다.
피드백 접근은 벤치마크마다 다르다(부록 D.2). WebArena에서는 심판이 공식 채점 결과와 참조 답을 받고, · 작성자는 심판의 라벨과 진단만 받되 참조 답 필드는 못 본다. SWE-bench Verified에서는 심판이 라벨 없이 이슈·트레이스·패치만 보고 success·verified 두 비트를 낸다. Mind2Web에서는 어느 후보가 정답인지 심판에게 알려주지 않는다. 실행자(actor)는 어느 경우든 현재 과제의 보상·참조·판정 사유를 보지 못한다.
다중 롤아웃(3.2절). 같은 과제를 온도 샘플링으로 번 병렬 실행하되, 각 롤아웃이 자기 환경 복제본에서 돌아 독립 측정이 되게 한다. 본 실험은 이다. 근거는 두 가지다. 하나는 "그냥 다시 시도하는 것만으로도 성공률이 오른다"는 관찰이다. 기억 없는 GPT-5.6 Sol을 WebArena 4개 사이트에서 돌리면 시도당 평균 성공률은 64.3%인데 8번 중 한 번이라도 성공하는 비율은 73.6%로 9.3점 차이가 난다(Table 3). 저자들은 이를 자기 진화 방법의 필수 기준선으로 제안한다. 같은 피드백·같은 예산에서 단순 재시도를 못 이기면 효과를 주장할 증거가 부족하다는 것이다. 다른 하나는 8번의 결과가 갈릴 때 비교가 가능해진다는 점이다. 부록 E에서 경험이 생성된 471개 과제를 롤아웃 결과로 나누면, 성공 다수 그룹의 평균 이득 +23.0점, 실패 다수 +13.0점, 균형 +55.8점, 전부 실패 +3.3점이다. 대조할 성공이 없으면 배울 게 적다.
대조 경험 유도(3.3절). 검증된 성공 수를 , 비율을 이라 할 때, 이면 유도를 건너뛰고 메모리를 바꾸지 않는다. 그 외엔 유도 연산자 가 검증된 성공의 전체 트레이스와 나머지 시도의 진단·을 받아 네 경우로 후보 경험 를 만든다. 성공 다수면 소수의 오류를 주의사항으로, 성공 소수면 성공을 가른 결정을, 반반이면 성공 전략과 실패 함정 둘 다, 전부 실패면 진단에 기록된 실패 패턴만 요약하되 입력에 근거한 행동으로 지침을 제한한다. 부록 G의 프롬프트 발췌에는 "한 궤적으로 포괄적 금지를 쓰지 말고 그 경로에서 무엇을 검증할지 써라", "과제별 값(상품명, 검색어, 날짜, 숫자)을 절대 복사하지 마라"가 들어 있다.
메모리 통합(3.3절). 후보 와 유사도로 검색한 기존 항목 를 비교기 가 보고 추가 집합과 삭제 집합을 낸다.
중복이면 버리고, 겹치거나 충돌하면 새 항목에 적용 조건을 명시하며, 새 지침이 옛 항목을 대체하면 새것을 추가하고 옛것을 지운다. 삭제 집합 밖의 항목은 원문 그대로 유지한다. 이 마지막 조건이 뒤에서 ablation의 핵심이 된다.
검색과 주입(3.4절, 부록 B.1). 임베딩(bge-small) 코사인 유사도로 top-5를 뽑고, LLM 선택기가 그중 하나를 고르거나 (없음)을 돌려준다. 실행자는 선택된 경험을 "현재 과제에 분명히 맞을 때만 쓰라"는 선택적 힌트로 받는다. 기록된 WebArena 질의 752개(같은 템플릿의 경험이 존재하는 363개로 선택률, 나머지 389개로 올바른 기권률 측정)에서 Hippo는 **선택률 75.2%, 기권률 62.0%**다. BM25(+본문) 66.4%, dense top-1 59.8%, 메모리 전체를 LLM에 주고 고르게 하면 47.8%다.
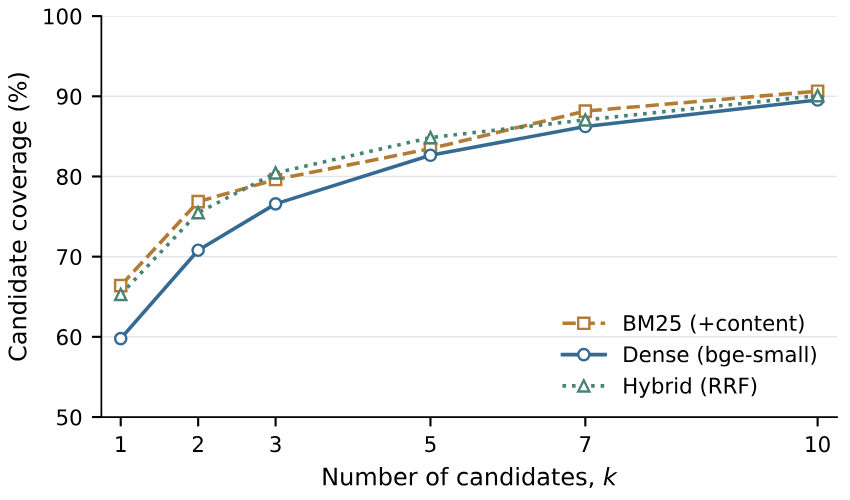
그림 6이 두 단계가 왜 필요한지 보여준다. dense top-1은 363개 중 217개에서만 매칭 경험을 잡지만 top-5 안에는 300개가 들어오고, LLM 선택기는 그 300개 중 273개(91.0%)를 골라낸다.
📊 실험: 세 벤치마크, 네 모델, 400개 과제의 장기전
설정. SWE-bench Verified 500개(공식 swebench 4.1.0 하네스, 해결률), WebArena 764개(과제 성공률, 롤아웃당 30스텝), Mind2Web(교사 강제 하의 스텝 성공률). 모델은 GPT-5.6 Sol, Claude Haiku 4.5, Gemini 3 Flash Preview, Qwen3.5-27B. 기준선은 No Memory, 스텝 예산만 50으로 늘린 Vanilla-IB, AWM, MaTTS를 켠 ReasoningBank이고 뒤의 둘은 공식 구현을 쓰되 WebArena에서 공식 결과와 참조 답을 받게 했다. 과제당 8회 시도의 평균을 다시 과제 평균하고, 시드 3개의 평균 ± 표준편차를 보고한다. 메모리는 빈 상태에서 시작해 과제 ID 순으로 진행하며, 한 과제의 8회가 끝난 뒤에야 갱신된다.
WebArena(Table 1 Overall).
| 모델 | No Memory | Vanilla-IB | AWM | ReasoningBank | Hippo |
|---|---|---|---|---|---|
| GPT-5.6 Sol | 64.2 | 65.1 | 64.0 | 64.4 | 72.9 |
| Claude Haiku 4.5 | 33.8 | 36.4 | 33.3 | 34.6 | 42.5 |
| Gemini 3 Flash Preview | 39.0 | 41.9 | 37.1 | 39.8 | 46.4 |
| Qwen3.5-27B | 35.8 | 38.4 | 35.4 | 37.3 | 43.6 |
SWE-bench Verified(Table 2).
| 모델 | No Memory | Vanilla-IB | AWM | ReasoningBank | Hippo |
|---|---|---|---|---|---|
| GPT-5.6 Sol | 81.5 ±0.4 | 82.6 ±0.6 | 79.9 ±1.5 | 82.5 ±1.9 | 88.5 ±1.2 |
| Claude Haiku 4.5 | 62.6 ±0.2 | 63.2 ±0.2 | 61.0 ±2.5 | 62.8 ±1.5 | 70.7 ±1.4 |
| Gemini 3 Flash Preview | 74.2 ±0.4 | 75.2 ±0.8 | 73.7 ±1.9 | 75.0 ±2.1 | 81.6 ±1.4 |
| Qwen3.5-27B | 68.8 ±0.6 | 69.2 ±0.5 | 67.4 ±2.4 | 70.1 ±2.4 | 76.5 ±1.8 |
눈에 띄는 점이 셋이다. 첫째, AWM과 ReasoningBank는 모델·환경에 따라 No Memory보다 낮은 칸이 여럿이고 표준편차도 24점으로 크다. 메모리를 붙이는 것 자체가 이득을 보장하지 않는다는 저자들의 말과 맞는다. 둘째, 스텝만 늘린 Vanilla-IB가 두 메모리 기준선을 대체로 이긴다. 셋째, Hippo의 이득은 WebArena에서 79점, SWE-bench에서 7~8점으로 모델 능력과 무관하게 비슷하다. 사이트별로는 Shopping과 Map에서 크고(GPT-5.6 Sol의 Map 59.3→73.4) GitLab·Reddit에서 작다.
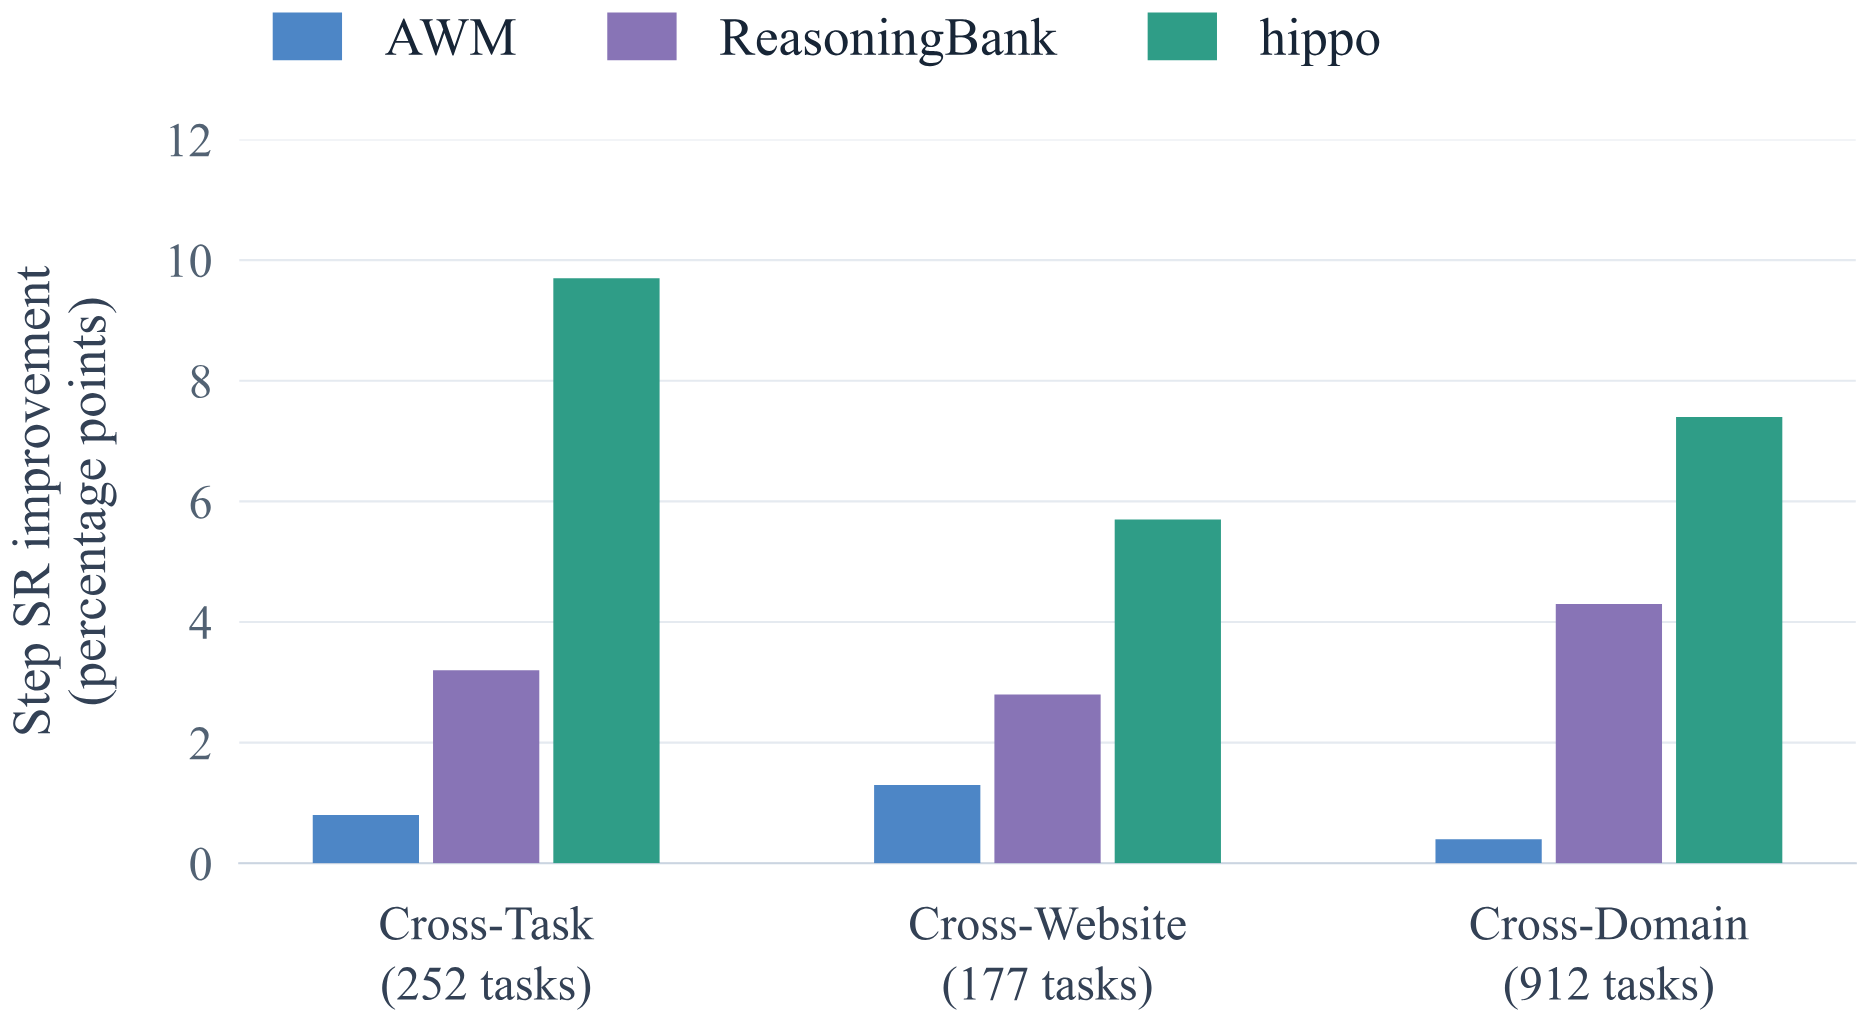
Mind2Web(그림 3)은 Gemini 3 Flash Preview로만 비교했다. GPT-5.6 Sol은 무기억 성능이 이미 90%를 넘어 제외했다고 한다.
장기 진화(4.2절). 이 논문에서 가장 중요한 그림이다. SWE-bench Verified와 SWE-bench Pro에서 뽑은 450개 코딩 과제를 같은 순서로 흘리면서, 체크포인트마다 **첫 50개 과제(기억 유지)**와 **고정된 미지의 50개 과제(전이)**를 평가한다. 평가는 메모리를 바꾸지 않는다.
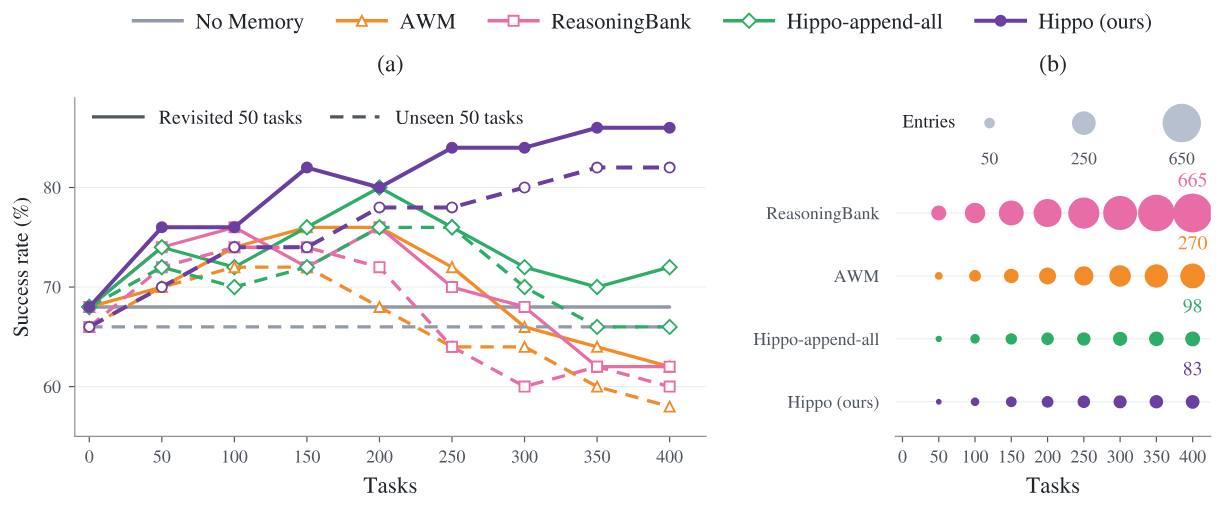
AWM과 ReasoningBank는 150개 과제 근처까지 오르다가 그 뒤로 내려와 400개 시점에 기준선 아래로 떨어지고, 그동안 메모리는 270개와 665개로 계속 자란다. 미지 과제에서 먼저 무너진다. 저자들이 드는 원인은 둘이다. 새로 덧붙인 항목이 검색과 컨텍스트 자리를 두고 옛 항목과 경쟁해 유용한 경험이 "있지만 못 쓰는" 상태가 되는 것, 그리고 자기 평가가 결함 있는 궤적을 높게 쳐서 잘못된 규칙이 반복 검색되는 것이다. Hippo는 400개 시점에 86%·82%로 가장 강한 메모리 기준선보다 24·22점 높고, 항목은 83개뿐이다. 같은 유도 과정을 쓰되 삭제만 끄면(append-all) 200개에서 80까지 올랐다가 내려와 72·66으로 끝난다(Table 11). 역U의 원인이 경험을 만드는 방식이 아니라 유지 정책에 있다는 가장 직접적인 증거다.
Ablation(4.6절, GPT-5.6 Sol). 없이 반성을 바로 검색하면 WebArena 66.50 / SWE-bench 83.80, 없이 원시 궤적과 심판 피드백에서 바로 를 만들면 68.70 / 85.63, 전체 Hippo 72.90 / 88.50이다. WebArena에서 경험 구성과 갱신 정책만 바꾸면 롤아웃별 개별 요약 + 추가만 61.30, 롤아웃 대조 + 추가만 70.10, 롤아웃 대조 + 반복 재작성 54.57, Hippo(추가·삭제) 72.90이다. 반복 재작성은 기존 항목을 고치고 합치고 지우는 자유를 전부 주는 정책인데, 무기억(64.20)보다도 10점 낮다. 메모리를 더 자유롭게 고칠수록 좋은 게 아니라, 건드리지 않은 항목은 원문을 지키는 보수적 갱신이 나았다는 뜻이다. 심판을 공식 성공/실패 라벨로 바꾸면 5개 사이트에서 1.8~8.5점 떨어지며 Map이 가장 크다. Map에는 참조 답이 N/A인 과제가 많아, 검색을 끝내지 못하고 빈 답을 낸 시도가 정답 처리되는 경우가 잦기 때문이다. 사람 둘이 200건을 감사한 결과 심판과 사람의 일치율은 94.3%(κ = 0.89), 요행 표시의 정밀도는 91.5%였다(부록 D).
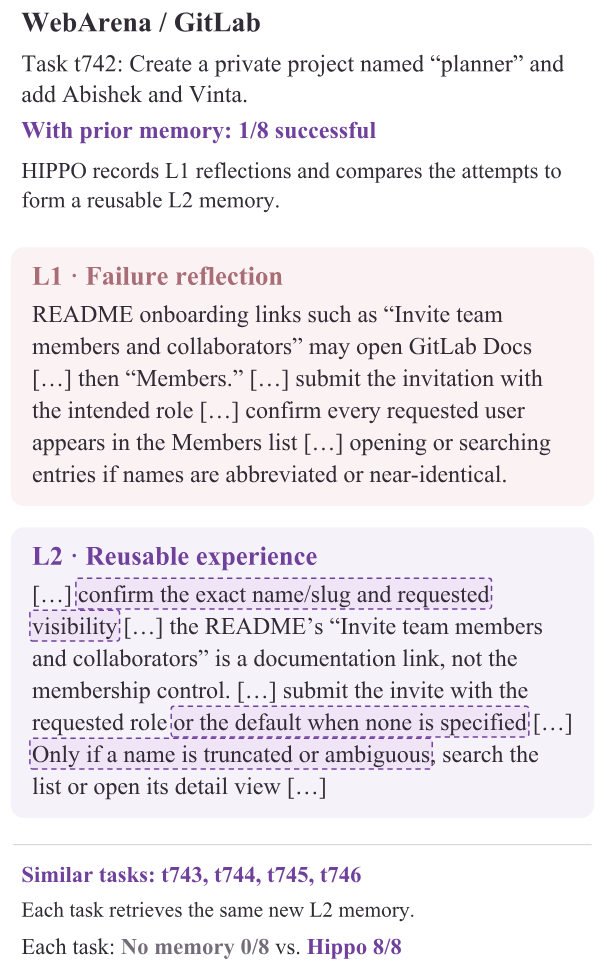
그림 5가 "무엇이 저장되는가"를 가장 구체적으로 보여준다. 8번 중 7번 실패한 배치에서, README의 초대 링크가 문서 링크일 뿐이라는 반복된 오류와 한 번의 성공이 보여준 Members 메뉴 경로가 대조되어, 적용 조건(비공개 프로젝트 생성과 멤버 추가)과 완료 기준(멤버 목록에서 확인)이 붙은 절차가 된다. 그리고 뒤이은 네 과제가 전부 0/8에서 8/8로 바뀐다. 전부 실패한 배치에서도 심판 진단만으로 경험이 만들어져 다음 과제를 0/8에서 8/8로 바꾼 사례가 부록 F에 있다.
비용(4.7절, 부록 B). WebArena·GPT-5.6 Sol 기준, 주입되는 메모리는 스텝당 240273토큰 상당, 메모리를 받은 롤아웃당 평균 2.8k(사이트별 p90 3.8k8.4k)다. 과제당 모델 호출은 69.3회에서 78.8회(+13.8%)로 늘고, 그중 메모리 작업은 4.1회다. 실행·판정·메모리 작업을 모두 포함한 달러 비용 추정치는 과제당 **$1.93 → $2.17(+12.4%)**이고, 성공률은 64.2 → 72.9(+8.7점)다. 저자들은 한계 절에서 롤아웃 간 동일 프리픽스의 KV 캐시 재사용이나 판정 전용 모델(Jev)로 비용을 줄일 수 있다고 적지만 측정하지는 않았다.
🔍 시리즈 안에서 읽기: 네 가지 자기 진화의 좌표
| RRSI | Harness² | ScholarEvolve | Hippo | |
|---|---|---|---|---|
| 편집 대상 | 하네스 코드·프롬프트 | 하네스 8개 컴포넌트 + 개선 하네스 | 하네스 5개 모듈 | 외부 메모리 뱅크(텍스트) |
| 제안 원천 | 자기 실행 트레이스 | 자기 실행 트레이스(정답 없이 Propose–Probe–Compose) | arXiv 논문 | 같은 과제 8회 롤아웃의 대조 |
| 언제 갱신 | 오프라인 진화 세트 | 배포 중 과제마다 | 라운드마다 | 과제마다(놀라움이 있을 때만) |
| 과적합·열화 대책 | 편집 예산 감쇠, 누수 비평가, 구조 가지치기 | 하네싱 수준 재귀로 교훈 축적 | 검증 세트 채택 | 적용 조건 명시, 중복 폐기, 대체 시 삭제 |
| 모델 파라미터 | 고정 | 고정 | 고정 | 고정 |
네 논문 모두 그래디언트 없이 돌아가니 넓은 의미에서는 전부 training-free다. 차이는 상태가 어디에 사는가다. 앞의 셋은 상태가 하네스 코드이고, 코드는 한번 바뀌면 모든 과제에 적용되므로 RRSI가 보여준 것처럼 과적합이 구조적으로 굳는다. Hippo의 상태는 검색을 거쳐야 활성화되는 텍스트 항목이라, 안 맞는 과제에는 (선택기가 제대로 기권하면) 아예 영향을 주지 않는다. 대신 RRSI가 걱정한 문제가 사라진 게 아니라 검색과 유지 정책으로 옮겨 간 것이다. Hippo의 역U 곡선은 하네스 편집의 과적합과 같은 병의 메모리 버전이고, 추가·삭제 정책은 RRSI의 구조 가지치기에 해당한다. Harness²가 "고친 경험을 교훈으로 쌓는" 하네싱 수준 재귀를 두었던 것과 비교하면, Hippo는 교훈만 남기고 하네스 편집층을 통째로 뺀 셈이다. 루프 엔지니어링의 어휘로는 힐클라이밍 루프의 상태 변수를 "코드"에서 "메모리"로 바꾸고, 제안 분포를 "한 궤적의 반성"에서 "여덟 궤적의 대조"로 바꾼 것이다.
💡 정리와 한계, 그리고 비판적으로 읽을 지점
논문이 스스로 적은 한계(부록 H)는 셋이다. 8회 롤아웃과 메모리 갱신의 추가 비용, 실행·판정·갱신이 같은 모델이라 공유된 맹점이 메모리에 그대로 남을 수 있다는 점, 그리고 장기 평가가 "많은 과제"에 대한 것이지 "아주 긴 한 과제"에 대한 것이 아니라는 점이다. 여기에 독자로서 몇 가지를 더 얹는다.
과제 순서가 메모리에 유리하다. 모든 실험이 과제 ID 순이다. WebArena는 같은 템플릿의 과제가 연속된 ID로 묶여 있고, 논문의 사례도 t62→t63, t742→t743~t746, t226·t228처럼 바로 앞 과제의 경험이 바로 다음 과제에 쓰이는 모양이다. 부록 B.1의 검색 평가가 "같은 템플릿"을 관련성 기준으로 삼은 것도 같은 맥락이다. 무작위 순서나 템플릿을 흩뜨린 순서에서 이득이 얼마나 남는지는 논문에 없다.
재시도 기준선을 제안했지만 Hippo 자신은 그 기준선과 직접 비교되지 않는다. Table 3의 "8회 중 1회 성공" 73.6%와 Hippo의 시도당 평균 72.9%는 다른 지표다. 모든 방법이 8회 평균으로 보고되므로 공정하긴 하지만, 저자들이 제안한 기준(같은 예산·같은 피드백에서 재시도를 이겨야 한다)을 Hippo에 적용한 표는 없다. 특히 Hippo는 현재 과제의 8회 결과를 심판이 판정한 정보를 메모리를 거쳐 다음 과제에 쓰는데, 재시도 기준선은 그 정보를 전혀 쓰지 않는다.
WebArena의 심판은 참조 답을 본다. 작성자에게 참조 필드를 숨겨도 진단문에 참조에서 나온 값이나 기준이 섞일 수 있다고 논문이 인정한다(D.2). 부록 D.6.2는 작성자가 참조 답을 보던 초기 구현에서 "N/A를 답하라"는 교훈이 생겨 세 과제가 전부 실패한 사건을 기록하는데, 이는 참조 답 접근이 메모리를 오염시키기 쉽다는 경고이자, 현재 설정도 그 경계에 있다는 뜻이다. SWE-bench는 라벨 없는 심판이라 이 문제가 없고, 거기서도 7점이 오른 것이 오히려 더 설득력 있는 결과다.
세 번의 시드로 ±1점대 표준편차는 하네스 비교 논문이 보여준 SWE-bench Verified의 재실행 분산(2.2~6.0점)보다 작다. 8회 시도 평균이 분산을 줄인 덕으로 보이며, Hippo의 +7점은 그 분산을 넉넉히 넘는다.
코드가 없다. 프롬프트 발췌(부록 G)와 수식은 있지만 검색 구현, 심판 프롬프트 전문, 과제 선정 기준은 재현하기에 부족하다. 특히 "반복 재작성"이 54.57로 무너진 결과는 프롬프트 설계에 민감할 수 있다.
그럼에도 이 논문이 시리즈에 보태는 교훈은 분명하다. 첫째, 메모리는 쌓는 것보다 지우는 것이 어렵고, 지우지 않으면 없느니만 못해진다는 것을 400개 과제의 곡선으로 보여줬다. 둘째, 한 번의 성공·실패에서 교훈을 뽑는 것은 위험하며, 같은 조건의 여러 시도를 대조해야 "결정"과 "적용 조건"이 분리된다. 셋째, 어떤 자기 진화 방법이든 그냥 여덟 번 더 돌린 것을 기준선으로 깔아야 한다. 이 세 번째는 Hippo뿐 아니라 RRSI·Harness²·ScholarEvolve를 읽을 때도 같이 들고 가야 할 질문이다.
📚 참고
- 원문: Hippo: Training-Free Agent Self-Evolution via Hippocampal Replay (Song, Wu, Ren, Qin, Wang; arXiv 2610.24453, v1 2026년 10월 17일, v2 10월 29일, cs.AI, arXiv.org perpetual non-exclusive license) · HTML
- 코드: 논문·arXiv 페이지에 저장소 링크 없음(2026년 11월 3일 확인)
- 비교 대상: Agent Workflow Memory (Wang et al., 2025), ReasoningBank / MaTTS (Ouyang et al., 2026), Vanilla-IB (Hajimiri et al., 2026), Reflexion (Shinn et al., 2023), ExpeL (Zhao et al., 2024)
- 신경과학 배경: Lisman et al. (2005) 해마–VTA 루프, Wilson et al. (1994) 수면 중 재활성화, Kumaran et al. (2016) 상보적 학습 시스템
- 벤치마크: SWE-bench Verified, WebArena, Mind2Web, SWE-bench Pro (Deng et al., 2025)
- 이 블로그의 관련 글: RRSI, Harness², ScholarEvolve, 하네스 비교 논문, 루프 엔지니어링, Jev
본 글의 그림은 원문에서 가져왔습니다.