모델은 그대로, 청구서만 줄이기: TokenEconomizer가 코딩 에이전트의 토큰 낭비를 잡는 법
"코딩 에이전트는 과제를 끝내도록 만들어졌지, 싸게 끝내도록 만들어지지 않았다." — 공식 저장소 README
2026년 10월 15일 UC Berkeley의 Aaron J. Li와 Microsoft Research의 Weijia Xu, Chandan Singh, Michel Galley, Jianfeng Gao, 그리고 Ion Stoica, Bin Yu 등이 TokenEconomizer: Experience-Driven Black-Box Cost Control for Coding Agents(arXiv 2610.22732)를 공개했다. 코드는 github.com/microsoft/TokenEconomizer에 Apache 2.0으로 올라와 있고(이 글을 쓰는 시점 스타 약 4,470개), Claude Code·Codex·GitHub Copilot CLI·Pi용 플러그인으로 설치된다. AI타임스는 "AI 코딩 비용 최대 31% 줄이는 도구"라는 제목으로 보도했다.
이 글은 시리즈 8편 하네스가 사는 것은 토큰뿐?의 후속이다. 그 논문은 모델을 고정하면 하네스 선택이 통과율은 거의 못 움직이고 청구서만 최대 3배 가른다고 했다. 그렇다면 하네스도 모델도 바꾸지 않고 그 청구서를 줄일 수 있는가? TokenEconomizer의 답은 "같은 저장소에서 반복되는 낭비를 바깥에서 걷어내면 18~31%는 줄어든다"이다.
원문: https://arxiv.org/abs/2610.22732
🤔 배경: 고정 전략은 저장소마다 반대로 움직인다
출발점은 8편과 같은 비용 해부다. 매 턴은 시스템 프롬프트와 도구 스키마라는 고정 접두사와 지금까지의 대화 기록 전체를 다시 보내고, 캐시 가격은 이를 할인할 뿐 없애지 못한다. 그리고 실제 개발자는 같은 저장소에서 과제를 이어서 푼다. 저자들은 그래서 한 저장소의 과제 스트림 에 걸친 누적 비용을 최적화 대상으로 잡는다.
먼저 기존 오픈소스 절감 플러그인이 일관되게 돈을 아끼는지 쟀다. Claude Code + Opus 4.8(높은 추론 노력)로 SWE-Bench 6개 저장소 × 10개 과제에 세 고정 전략을 붙였다. 셸 출력을 압축하는 RTK(Rust Token Killer), 언어 서버 기반 심볼 탐색을 MCP로 얹는 Serena, 심볼 지도를 2,048토큰 예산으로 프롬프트에 넣는 Aider RepoMap이다.
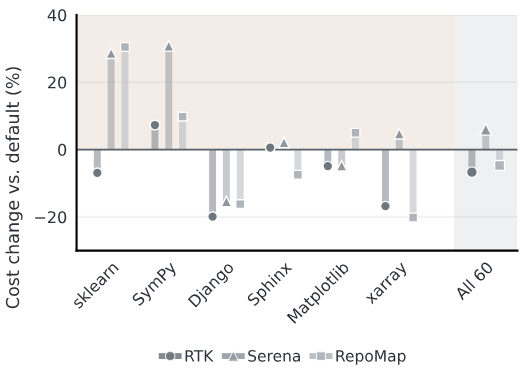
그림 1(논문 Figure 2)이 결과다. 셋 다 Django에서는 1520% 싸지고 SymPy에서는 731% 비싸진다. scikit-learn에서는 RTK만 돕고(-6.9%) Serena와 RepoMap은 +28.6%, +30.5%로 손해다. Sphinx에서는 RepoMap만 -7.5%다. 저장소별로 부호가 뒤집히니 60개를 풀링하면 효과가 거의 사라진다. 어느 전략이 맞는지는 저장소가 정하고, 그렇다면 저장소마다 완료된 trace에서 정책을 배워야 한다는 것이 저자들의 결론이다.
🔍 낭비는 어디에 있는가: trace 해부 세 가지
같은 60개 기본 실행 trace에서 저자들은 걷어낼 수 있는 비용을 세 군데서 찾는다.
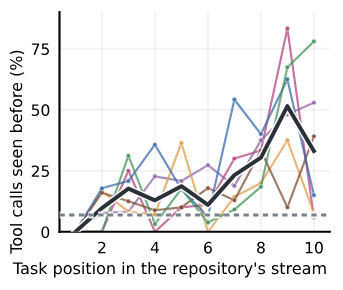
첫째, 같은 일을 다시 알아낸다. 도구 호출을 명령 앞 6토큰과 파일명으로 정규화해 "이전 과제에서 이미 한 행동"인지 세면, 2~3번째 과제에서 14%였던 반복 비율이 **앞선 과제가 5개 이상 쌓이면 30%**가 된다(그림 2). 다른 저장소의 이력과 비교하면 7%뿐이라, 반복의 대부분은 저장소 고유의 것이다. 어떤 테스트 러너가 도는지, 재설치가 필요한지 같은 운영 지식이 매번 다시 발견된다는 뜻이다.
둘째, 도구 23개 중 16개는 한 번도 안 불린다. Claude Code는 매 턴 23개 도구 스키마를 보내지만 어느 저장소도 7개를 넘겨 쓰지 않고, Bash·Read·Edit 3개가 전체 호출의 98%다. 다만 나머지는 저장소마다 조금씩 다르게 쓰인다(Matplotlib은 TaskUpdate·TaskCreate, xarray는 Write·WebFetch). 고정된 축소 인터페이스는 그 "조금씩"을 죽이니, 증거에 따라 빼고 되돌릴 수 있는 가지치기가 필요하다.
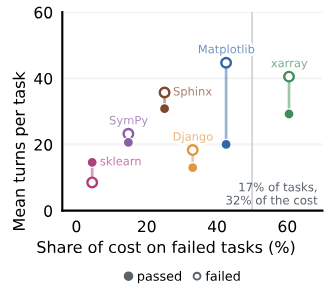
셋째, 실패가 돈을 더 먹는다. 실패한 10개 실행은 과제의 17%지만 비용의 **32%**다(그림 3). 그런데 전역 턴 한도로는 못 잡는다. Matplotlib은 실패 45턴 대 성공 20턴이지만 Sphinx는 36 대 31로 거의 같다. 실패 시그니처(실패 출력의 첫 오류 줄에서 숫자·주소·경로를 지운 것)가 반복된 trajectory가 60개 중 45개이고, 전체 비용의 51%가 첫 반복 이후에 쓰인다. 하지만 성공한 50개 중 36개도 반복을 겪었다. 반복 자체는 실패의 표지가 아니므로, 가드는 "이 저장소의 성공 실행에 비해 얼마나 긴가"로 판단하고 끊기 전에 먼저 방향을 틀어야 한다.
🧠 핵심 아이디어: 봉인된 에이전트 바깥의 컨트롤러
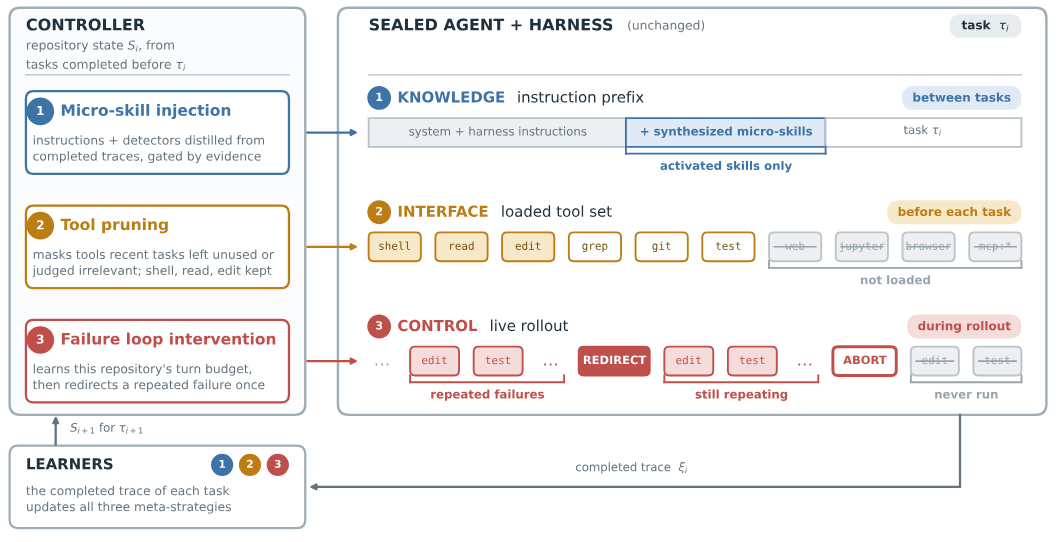
TokenEconomizer는 에이전트를 블랙박스로 둔다. 가중치도 루프 코드도 건드리지 않고, 하네스가 이미 노출하는 세 인터페이스(과제 프롬프트, 실행 시 도구 설정, 실행 중 이벤트 스트림)만 쓴다. 과제 전에 컨트롤러 는 이전 과제들에서 쌓은 저장소 상태 을 보고 세 가지를 정한다.
는 접두사에 끼울 마이크로 스킬 집합, 는 로드할 도구 집합, 는 실패 루프 가드가 참조할 턴 예산이다. 과제가 끝나면 trace 로 를 갱신한다. 세 메타 전략은 저장소에 무관하게 같고, 그것이 배우는 정책만 저장소마다 다르다. 목적은 자기 모델 호출까지 포함한 과제당 평균 비용을 줄이되 성공률은 기본 실행에서 이내로 지키는 것이다.
📐 방법: 세 메타 전략
I. 경험에 근거한 마이크로 스킬. 과제 4개가 끝난 뒤 5개마다 LLM 제안자가 최근 8개 과제의 다이제스트(명령 템플릿, 테스트 호출, 편집 파일명, 오류; 해답 텍스트나 gold patch는 없음)를 읽고 최대 4개 후보를 낸다. 후보는 한 줄짜리 사실("테스트는 python -c "import sympy; sympy.test(...)"로 돈다")과 정규식 탐지기 세트다. scope는 스킬이 관련된 상황이 일어났는지, confirm/contradict는 그때 스킬이 맞았는지, need는 스킬이 막으려는 낭비가 실제로 생겼는지를 명령과 출력에서 확인한다. 스킬 의 지지도는
로, 로 오래된 증거를 깎고 로 반박 하나가 확인 다섯을 지운다. 활성화 조건은 둘이다. 편집 파일이 겹치지 않는 과제 3개에서 확인될 것(한 모듈이 반복 등장해 생긴 착시를 거르기 위해), 그리고 need 비율이 4개 이상 과제에서 0.4 이상일 것(맞는 말이어도 아무 낭비도 안 막으면 매 턴 토큰만 먹으니까). 지지도가 음수가 되면 은퇴하고 같은 ID는 다시 켜지지 않는다. 비대칭은 의도적이다. 은퇴했어야 할 스킬은 이후 모든 접두사에 청구되지만, 너무 일찍 은퇴한 스킬은 새 ID로 다시 제안하면 되기 때문이다.
II. 도구 가지치기. 셸·읽기·쓰기·편집 핵심 도구는 항상 남긴다. 나머지는 연속 3개 과제에서 안 불리면 가리고, 아직 안 가려진 미사용 도구는 과제 설명(PR·이슈 링크는 마스킹)과 도구 설명을 보는 LLM 판정자가 "무관"으로 찍으면 추가로 가린다. 잘못 뺀 도구를 되찾기 위해 5개 과제마다 전체 카탈로그를 로드하는 재감사를 돌리고, 거기서 한 번이라도 불린 도구는 다시 가리지 않는다. 효과는 바로 나온다. Django 스트림에서 Claude Code의 첫 요청 프롬프트는 23개 도구로 42,866토큰이었는데, 2번째 과제부터 19개를 가리자 16,295토큰이 됐다.
III. 실패 루프 개입. 턴 예산은 이 저장소에서 성공한 과제들의 턴 수 90분위에 1.25를 곱한 값이다.
도구 호출마다 모델 호출 없는 규칙 트리거가 반복 실패 시그니처, 오류 밀도, 예산 초과를 본다. 트리거가 열리면 LLM 판정자가 최근 24개 행동의 다이제스트(도구명, 명령, 편집 파일명, 오류 시그니처; 파일 내용과 과제 텍스트는 안 봄)를 읽고 "막혔다"를 신뢰도 0.7 이상으로 판정해야 개입한다. 첫 개입은 리다이렉트다. 에이전트의 행동을 요약하고 "실질적으로 다른 가설을 시도하라"는 2~4문장을 프롬프트에 넣는데, 구현은 CLI를 멈추고 같은 컨테이너에서 편집 상태를 유지한 채 새 호출을 시작하는 방식이다. 그 뒤에도 판정자가 다시 막혔다고 하면 종료한다. 판정자가 거부할 수 없는 뒷받침으로, 턴을 넘고 엄격한 정체 규칙(편집 반복, 오류 출력 6개 이상, 실패 출력의 20% 이상이 시그니처 반복)이 동시에 성립하면 강제 종료한다.
📊 실험: SWE-Bench에서 18.4~30.9%
설정은 다섯 가지다. Claude Code + Sonnet 5, Claude Code + Opus 4.8, Codex + GPT-5.6 Terra, Codex + GPT-5.6 Sol, Copilot CLI + Sonnet 5. 모두 같은 277개 SWE-Bench 과제(Verified 199 + 전체 split 78; scikit-learn 60, SymPy 60, Django 40, Sphinx 44, Matplotlib 34, xarray 39)를 저장소별 시간순으로 3시드 돌렸다. scikit-learn과 SymPy에 전체 split을 섞은 이유는 Verified만으로는 거의 다 통과해 방법 간 구별이 안 되기 때문이다. 비용은 캐시 읽기·미캐시 입력·출력 토큰을 각각의 가격으로 가중한 캐시 인지 비용이고, 제안자·판정자·리다이렉트 작성 등 컨트롤러의 모델 호출은 전부 그 호출을 일으킨 과제에 청구된다. 모든 설정은 하나의 공유 설정값으로 돌았고 저장소별 튜닝은 없다.
| 방법 | CC + Sonnet 5 | CC + Opus 4.8 | Codex + Terra | Codex + Sol | Copilot + Sonnet 5 |
|---|---|---|---|---|---|
| 기본(높은 노력) | — / 74.7 | — / 74.0 | — / 73.8 | — / 80.1 | — / 75.0 |
| 기본(중간 노력) | -26.6 / 70.0 | -16.8 / 72.2 | -25.7 / 69.6 | -28.9 / 76.7 | -25.4 / 72.6 |
| 기본(낮은 노력) | -45.5 / 65.1 | -31.0 / 70.4 | -33.0 / 65.3 | -43.9 / 69.8 | -41.9 / 65.9 |
| RTK | -1.1 / 73.1 | -3.6 / 74.0 | -4.7 / 74.3 | +4.5 / 79.2 | -8.9 / 76.9 |
| RepoMap | -1.4 / 74.1 | +6.5 / 74.6 | +3.1 / 70.0 | -6.1 / 78.7 | -3.3 / 74.9 |
| TokenEconomizer | -23.6 / 76.0 | -30.9 / 73.0 | -24.7 / 74.7 | -26.1 / 81.7 | -18.4 / 77.6 |
| TE + RTK | -23.5 / 76.4 | -33.2 / 74.8 | -23.8 / 75.2 | -23.3 / 81.3 | -13.2 / 77.4 |
| TE + RepoMap | -18.3 / 76.7 | -24.9 / 75.1 | -21.9 / 73.5 | -29.2 / 79.0 | -6.3 / 76.8 |
각 칸은 "기본 대비 비용 변화(%) / Pass@1(%)"이고 논문 Table 1을 옮긴 것이다(시드 표준편차는 생략). TokenEconomizer 단독으로 비용이 18.430.9% 줄고, Pass@1은 네 설정에서 오르고 Opus 4.8에서만 1.0점 내린다. 비교 대상의 성격이 선명하다. 추론 노력을 낮추면 비슷한 돈을 아끼지만 **Pass@1을 1.810.3점** 잃고, RTK·RepoMap은 설정에 따라 부호가 바뀐다.
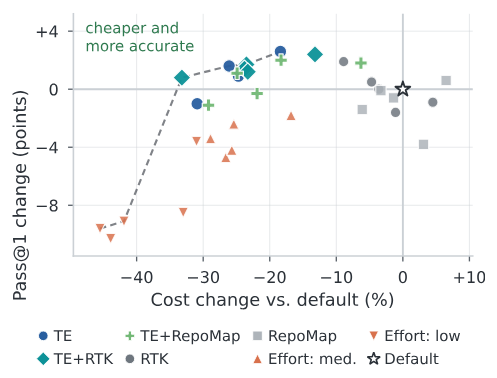
그림 5(논문 Figure 1(b))가 이를 한 장으로 보여준다. 기본 통과율을 유지하거나 넘는 Pareto 경계 위의 점은 전부 TokenEconomizer 변형이다. 일관성도 확인된다. 저장소 6개 × 설정 5개 = 30개 셀 전부에서 비용이 5.2~40.1% 줄었고, 같은 셀에서 RTK 단독은 12개, RepoMap 단독은 15개에서 오히려 비싸졌다.
절제 실험(Claude Code 두 설정)에서 가장 큰 몫은 매 턴에 작용하는 도구 가지치기(-13.2%, -17.7%)다. 마이크로 스킬이 -11.8%, -14.3%로 뒤따르고 실패 루프 가드는 -7.1%, -5.4%다. 어느 하나도 Pass@1을 3점 넘게 떨어뜨리지 않고, 혼자서 전체 절감을 재현하지도 못한다. 제안된 스킬의 약 1/5은 스트림 안에서 은퇴하고, 판정자는 스트림당 10~13번 불리지만 리다이렉트는 과제 열에 하나, 종료는 스무에 하나 꼴이다.
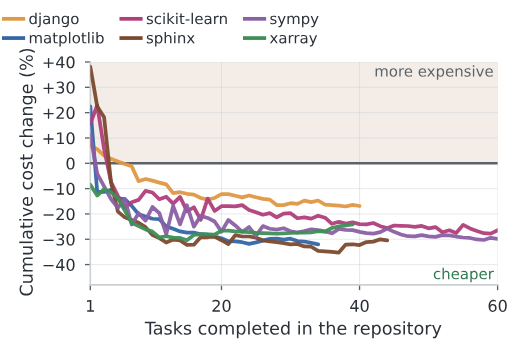
누적 비용의 교차점이 그림 6(논문 Figure 5(b))이다. 컨트롤러는 저장소마다 빈 상태에서 시작하니 처음 몇 과제는 제안자·판정자 호출 때문에 xarray를 뺀 모든 저장소에서 기본보다 비싸다. 그러나 6번째 과제 안에 전부 교차해 그 뒤로 계속 싸고, 스트림 끝에서 누적 16.9~32.0% 절감으로 마감한다. "경험 주도"라는 말이 비용 곡선에 그대로 보인다.
다른 과제 구조로의 전이. Web-Bench(5개 프로젝트, 한 작업 공간을 물려받는 102개 과제, Pass@2)에서는 Claude Code -21.2%(Pass@2 69.3→73.3), Codex -16.0%(64.0→66.5), Copilot CLI -18.7%(60.8→59.3)다. 매 과제가 다른 저장소인 보안 감사 벤치마크에서는 마이크로 스킬을 끄고 두 전략만 켰는데, CredData(자격 증명 탐지, F1)에서 -16.5~-19.6%, ReposVul(취약점 탐지)에서는 trajectory가 짧아 -6.4~-9.3%에 그쳤다.
🛠️ 플러그인: 무엇이 되고, 논문과 무엇이 다른가
저장소는 표준 라이브러리만 쓰는 Python 3.10+ 패키지다. Claude Code 설치는 README대로 세 줄이다.
git clone https://github.com/microsoft/TokenEconomizer.git
claude plugin marketplace add "$PWD/TokenEconomizer"
claude plugin install tokeneconomizer@tokeneconomizer
이후 claude를 띄워 폴더를 신뢰하고 /tokeneconomizer:status를 치면 된다. 머신당 한 번, 그리고 Claude Code 업데이트 뒤마다 /tokeneconomizer:toolprune refresh-catalog로 도구 목록을 다시 기록한다. 지원 버전은 Claude Code 2.1.3002.1.310, Codex 0.153.10.164.0, Copilot CLI 1.0.831.0.102, Pi 1.2.01.3.0이고 opencode와 Cursor Agent는 실험적이다. 플러그인은 자체 API 키가 없고, 제안자·판정자 호출은 사용자의 에이전트 로그인을 그대로 타며 그 비용도 status에 포함된다. 배운 것은 ~/.tokeneconomizer에 로컬로만 남고, 도구 가지치기는 Claude Code에서는 .claude/settings.local.json의 deny 목록, Codex에서는 capability 패키지, Copilot CLI에서는 MCP 서버 단위로 작동한다.
논문의 실험 컨트롤러와 공개 플러그인은 다르다. 설정값부터 다르고(논문은 제안자 5개 과제마다·3개 과제 미사용 시 가림, 플러그인은 3세션마다·2세션 이상 10 프롬프트 미사용), 더 중요한 차이가 둘 있다. 마이크로 스킬은 기본 꺼져 있다(제안자 호출이 비용을 더하고 절감이 저장소에 따라 달라서). 그리고 플러그인은 턴을 멈추지 않는다. 리다이렉트 한 번 뒤에도 막혀 있으면 "Esc를 눌러 중단하라"는 한 줄만 보여준다. 논문 실험에서는 두 번째 stuck 판정과 강제 종료가 실제로 실행됐고(스트림당 약 2건), 그것이 실패 과제 절감의 일부였다. 따라서 논문의 18.4~30.9%를 플러그인 기본 설정에 그대로 기대하면 안 된다. 기사도 "실제 절감 효과는 활성화한 기능에 따라 달라진다"고 적었다.
🧐 비판적으로 읽기
8편과 어떻게 이어지는가. 8편의 논문은 Claude Code의 하네스 preamble이 16,581토큰이고 매 스텝 다시 지불된다고 쟀다. 이 논문은 그 중 도구 스키마를 가지치기로 42.9k → 16.3k(첫 요청 기준)까지 줄여 보이고, 절제 실험에서 그 한 항목이 가장 큰 절감을 낸다. 하네스가 사는 토큰의 상당 부분은 안 쓰는 도구 설명서였던 셈이다. 다만 8편이 "하네스 교체 효과는 재실행 노이즈(13% flip)와 구별이 안 된다"고 한 자로 이 논문의 Pass@1 변화(-1.0~+2.6점)를 재면 역시 노이즈 안이다. 이 논문은 통과율을 올린다가 아니라 지킨다고 읽어야 하고, 저자들도 그렇게 쓴다.
자기 개선 논문들과의 관계. RRSI와 Harness²는 LLM이 하네스 자체를 편집해 점수를 올리는 재귀적 자기 개선이었고, RRSI의 핵심은 과적합(benchmark fitting, noise chasing, 복잡도 누적)을 막는 정규화였다. TokenEconomizer는 같은 "완료된 trace에서 배운다"는 루프를 돌지만 편집 대상을 접두사 한 줄, 도구 마스크, 턴 예산으로 극단적으로 좁히고 하네스 본체는 봉인한다. 선별 기준도 점수가 아니라 정규식 탐지기의 확인/반박이다. 비대칭 은퇴(), 겹치지 않는 파일 3회 확인, 재감사는 전부 "확신 없이는 영구 상태로 굳히지 말라"는 장치로, RRSI의 정규화를 다른 방식으로 구현한 셈이다. 그렇다고 과적합이 없는 건 아니다. 부록 예시 (c)는 "pytest로 테스트하라"는 스킬이 활성화된 사례인데, 그 환경에는 pytest가 없었고 실패한 시도 자체가 confirm 정규식에 매칭돼 확인으로 세어진 것이다. 한 번 주입된 뒤 반박으로 은퇴했지만, 탐지기가 "명령을 쳤다"와 "명령이 됐다"를 구별 못 하면 틀린 사실이 잠시 매뉴얼에 들어간다.
루프 엔지니어링의 관점. 루프 엔지니어링 글의 구성 요소(트리거·검증자·종료 규칙·가드레일)로 보면 실패 루프 가드는 그 자체가 에이전트를 감싸는 바깥 루프다. 규칙 트리거 → LLM 검증자 → 리다이렉트 프롬프트 → 종료 규칙이고, "CLI를 멈추고 리다이렉트를 넣어 다시 띄우는" 구현은 Ralph Wiggum식 bash 루프와 구조가 같다. 다만 공개 플러그인은 종료 규칙을 사람에게 돌려놓았고, 헤드리스 실행에서는 플래그된 턴이 에이전트 자체 한도까지 돈다고 README가 명시한다. 루프 엔지니어링이 사람을 루프에서 빼는 것이라면, 플러그인은 가장 중요한 한 결정만은 사람에게 남겨 둔 것이다.
"경험 주도"의 안전성과 익명성. 재사용되는 경험이 무엇인지는 논문이 꼼꼼히 제한했다. 마이크로 스킬은 "이 저장소에서 무엇이 참인가"라는 한 줄 사실이고, 제안자 프롬프트는 과제별 수정이나 바꿀 줄을 내지 말라고, 탐색·검색을 금지하는 문장으로 쓰지 말라고 명시한다. 제안자의 다이제스트에는 해답 텍스트와 gold patch가 없고, 판정자와 리다이렉트 작성자는 파일 내용과 과제 텍스트를 아예 못 본다. fix commit이 공개된 벤치마크 특성상 GitHub 호스트를 막는 답안 가드도 모든 방법에 똑같이 걸었다. 그럼에도 남는 질문이 있다. 스킬은 결국 프롬프트에 주입되는 자연어이고, 그 원천은 에이전트가 저장소에서 실행한 명령과 출력이다. 저장소 안의 내용(예컨대 조작된 테스트 출력)이 탐지기를 통과해 "사실"로 굳는 경로가 원리적으로는 열려 있다고 보이는데, 논문은 이를 다루지 않는다. 또 부록 A가 "관련 저장소 간 스킬 공유"를 확장 방향으로 언급하는데, 그 순간 스킬은 한 저장소의 운영 사실에서 조직의 코드베이스 정보로 성격이 바뀐다. 지금의 저장소별 격리는 한계가 아니라 안전장치로 읽는 편이 맞다.
측정 범위. 스트림은 SWE-Bench 과제를 시간순으로 이은 것이지 실제 사용자 세션이 아니다. 각 과제가 새 체크아웃에서 시작하니 오히려 경험 재사용에 보수적인 조건이라는 것이 저자들의 주장인데, 반대 방향도 있다. 실제 세션은 과제 경계가 흐리고 성공 신호()가 없어 턴 예산 를 어디서 가져올지가 불명확하다. 플러그인은 "마지막 편집 뒤 실패한 검사가 없는 턴"을 성공으로 간주하는 근사를 쓴다. 고정 전략과의 결합도 단순 합이 아니다. RepoMap은 지도를 매 턴 청구하므로 TE+RepoMap은 5개 설정 중 4개에서 TE 단독보다 덜 아끼고, RTK는 Opus 4.8에서만 절감을 더한다. 대신 결합이 5개 중 3개 설정에서 최고 Pass@1을 내니, 돈과 점수 중 무엇을 살지는 사용자 몫이다.
📝 정리
이 논문이 보탠 것은 세 가지다. 비용을 과제 하나가 아니라 저장소의 과제 스트림으로 재는 회계 프로토콜. 그 스트림에서 반복되는 낭비(다시 알아내는 운영 사실, 안 쓰는 도구 스키마, 반복되는 실패)의 정량화. 그리고 모델도 하네스도 열지 않고 접두사·도구 설정·이벤트 스트림만으로 그 낭비를 걷어내는 컨트롤러. 결과는 30개 셀 전부에서 비용 감소, 통과율은 노이즈 안이다.
8편이 "하네스가 사는 건 토큰뿐"이라고 했다면, 이 논문은 "그 토큰 중 1/4은 안 사도 된다"고 한다. 남는 질문은 플러그인의 보수적 기본값(스킬 off, 종료 없음)으로 실제 세션에서 얼마가 남는지, 그리고 저자들이 부록에서 열어 둔 다음 손잡이들(과제별 추론 노력·모델 선택, 학습된 지점의 compaction, 환경 설정 재사용)이 같은 패턴으로 얼마나 더 깎을 수 있는지다.
📚 참고
- 원문: TokenEconomizer: Experience-Driven Black-Box Cost Control for Coding Agents (Aaron J. Li, Weijia Xu, Chandan Singh, Zixiao Chen, Jeevana Priya Inala, Charlotte Siska, Acar Tamersoy, Bin Yu, Ion Stoica, Michel Galley, Jianfeng Gao; UC Berkeley · Microsoft Research · Microsoft Security, arXiv 2610.22732, 2026.10.15) · HTML
- 코드·플러그인: github.com/microsoft/TokenEconomizer (Apache 2.0; Claude Code·Codex·Copilot CLI·Pi 플러그인,
experiments/에 SWE-Bench·Web-Bench 재현 하네스) · 프로젝트 페이지 - 기사: MS, AI 코딩 비용 최대 31% 줄이는 도구 공개…작업 성공률은 유지 (AI타임스, 박찬 기자)
- 비교 대상 고정 전략: RTK, Serena, Aider RepoMap
- 벤치마크: SWE-bench, Web-Bench, ReposVul
- 이 블로그의 하네스 시리즈: 하네스가 사는 것은 토큰뿐? · RRSI · Harness² · 루프 엔지니어링
본 글의 그림은 원문에서 가져왔습니다(arXiv HTML 그림).