Agensh: 중앙 관리자 없이 1,024개 코딩 에이전트가 스스로 역할을 나누는 Microsoft의 멀티에이전트 하네스
"하네스의 핵심 추상은 루프다(The core abstraction of a harness is its loop)." — 논문 2.1절 첫 문장
2026년 10월 24일, Microsoft Research(GeneralAI 그룹)가 멀티에이전트 하네스 Agensh의 코드와 실험 재현 스크립트를 github.com/microsoft/Agensh에 MIT 라이선스로 공개했다. 논문 Agensh: Scaling Organizational Intelligence to 1,024 Agents(arXiv 2609.26781, Zhan·Song 등 7명)는 한 달 앞선 9월 22일 arXiv에 올라왔고, 국내에서는 10월 26일 AI타임스 박찬 기자의 기사로 소개됐다. 이 글은 기사가 아니라 논문 HTML, 저장소의 README·REPRODUCE.md·프롬프트 파일·서비스 README를 기준으로 쓴다.
이 블로그의 하네스/멀티에이전트 시리즈에서 Agensh의 위치는 분명하다. Raven은 Host Agent가 목표를 DAG로 분해하고 전문 에이전트에 배정하는 중앙 조율 구조였고, Autonoma도 디렉터가 작업을 쪼개 군집을 소환하는 디렉터-스웜 구조였다. Agensh는 그 정반대편에 선다. 분해하는 사람이 없다. 1,024개 워커가 식별자만 다른 완전히 같은 프롬프트를 받고, 각자 공유 저장소를 보고 할 일을 고른다. 루프 엔지니어링 글의 언어로 말하면, 사람이 바깥 루프를 설계하는 대신 워커들이 서로의 바깥 루프가 되는 설계다. 그리고 직무 분리 글에서 보안을 위해 강제로 분리했던 "만드는 역할과 검사하는 역할"이, 여기서는 아무도 지정하지 않았는데 에이전트들 사이에서 자발적으로 갈라져 나온다.
원문: https://arxiv.org/abs/2609.26781 · 코드: github.com/microsoft/Agensh · 프로젝트 페이지: aka.ms/Agensh
🤔 배경: 오케스트레이터가 병목이다
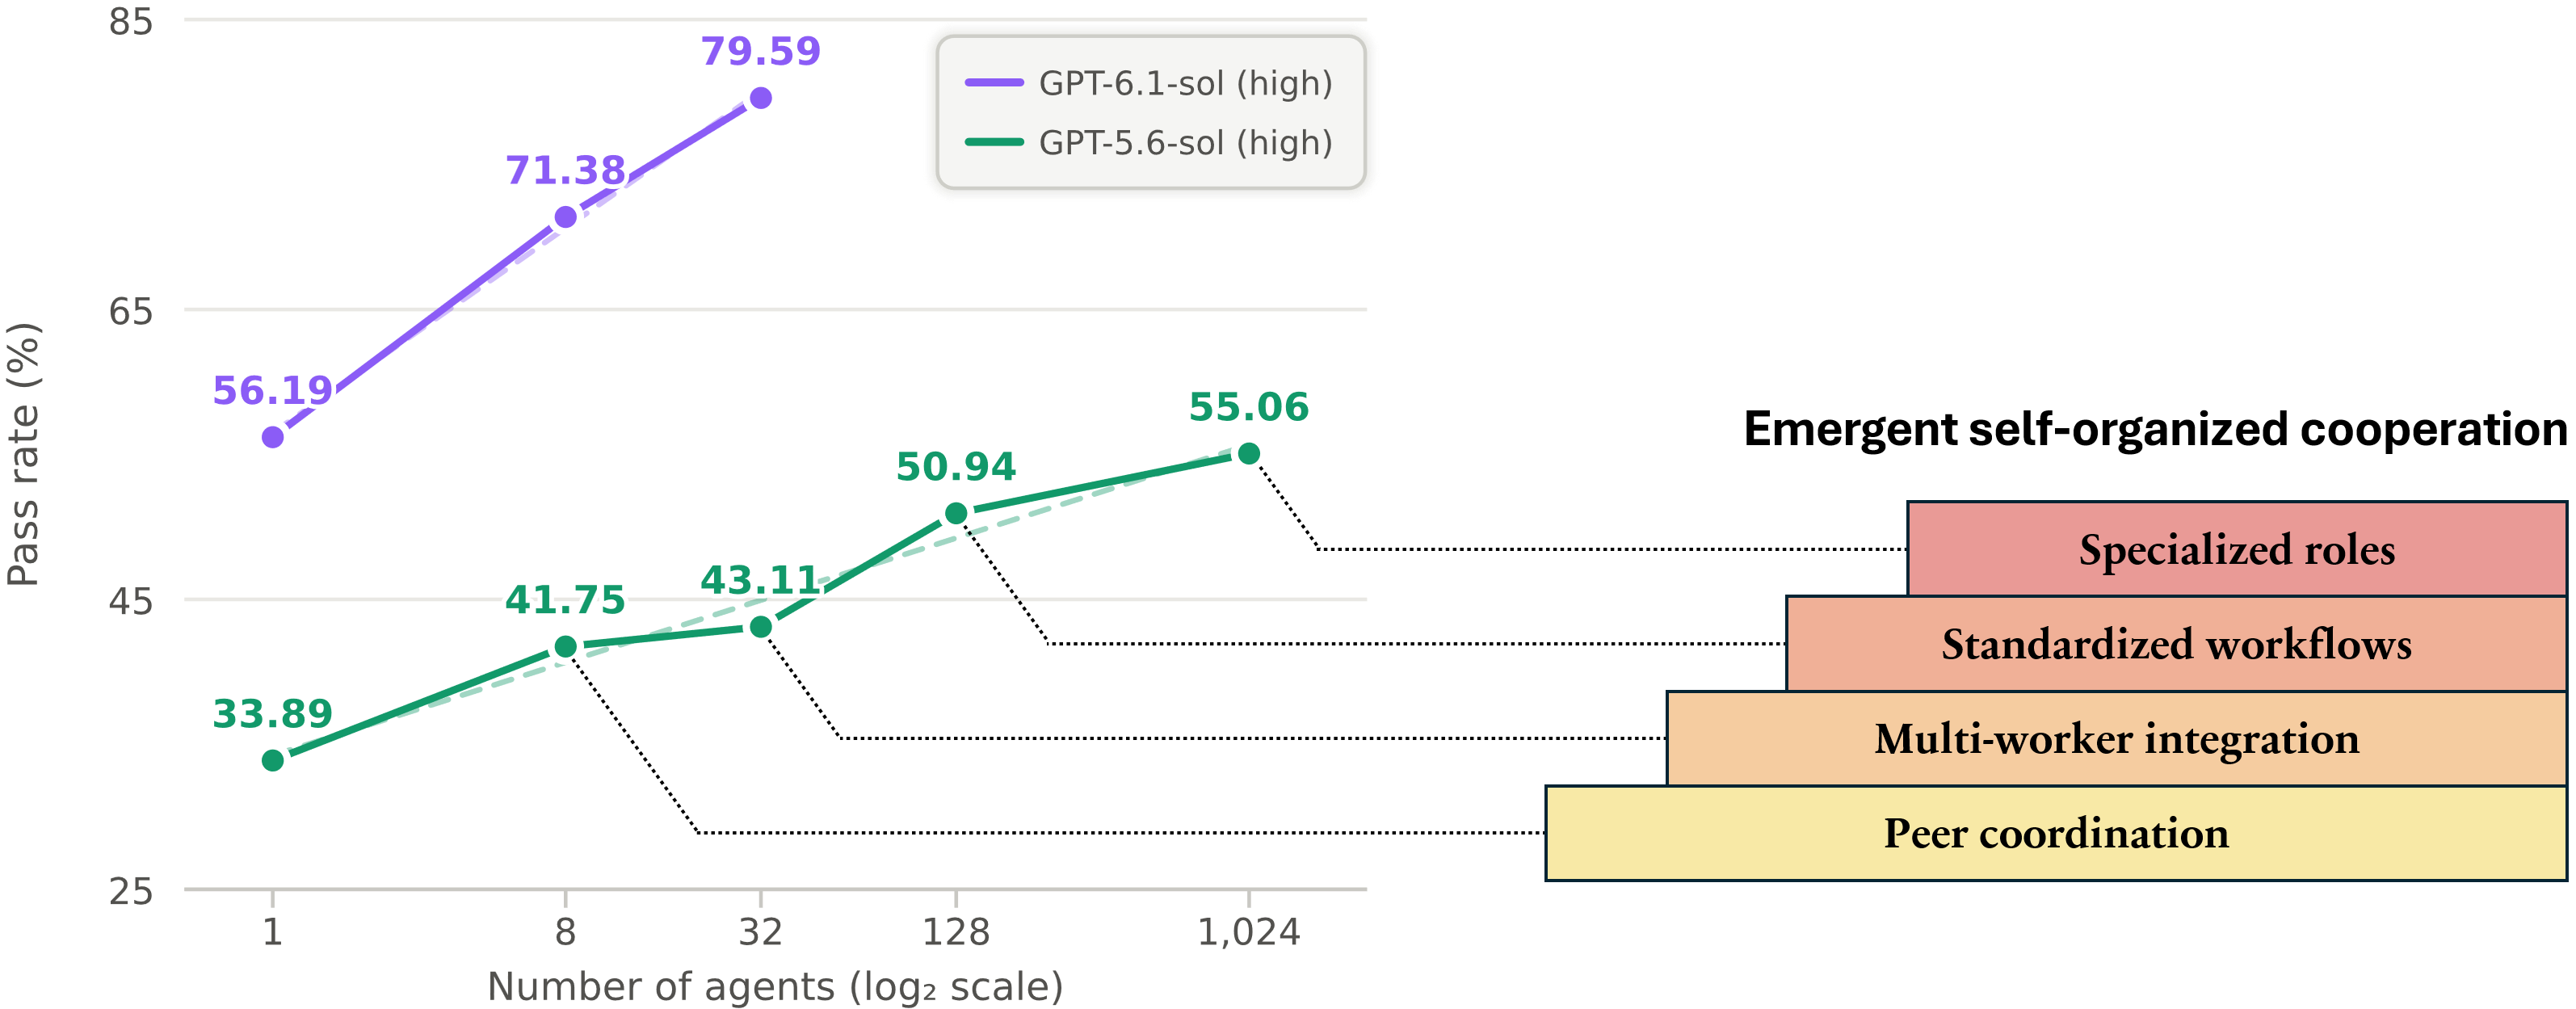
저장소 README의 대표 그림이다(논문 Figure 1에 GPT-6.1-sol 결과를 더한 버전). 녹색 선이 논문의 주 실험(GPT-5.6-sol), 보라색 선이 코드 공개와 함께 README에 추가된 GPT-6.1-sol 결과다. 점선은 추세선으로 보인다. 결과는 뒤에서 다루고, 먼저 저자들이 짚는 문제부터 보자.
논문 1장은 현재의 멀티에이전트 하네스(Codex 서브에이전트, Claude Code 서브에이전트·agent teams, Copilot /fleet, Kimi Agent Swarm)가 모두 오케스트레이터-워커 구조라고 정리한다. 메인 에이전트가 계획하고, 분해하고, 워커에 배정하고, 결과를 통합한다. 이 구조는 오케스트레이터를 따로 훈련해야 하는 경우도 있고(Kimi K2.5), 무엇보다 시스템 전체의 확장성이 오케스트레이터 하나가 관리·조율·통합할 수 있는 용량에 묶인다. 저자들은 Anthropic의 멀티에이전트 리서치 시스템 글과 "Patterns and problems in emerging multiagent systems"를 그 근거로 인용한다.
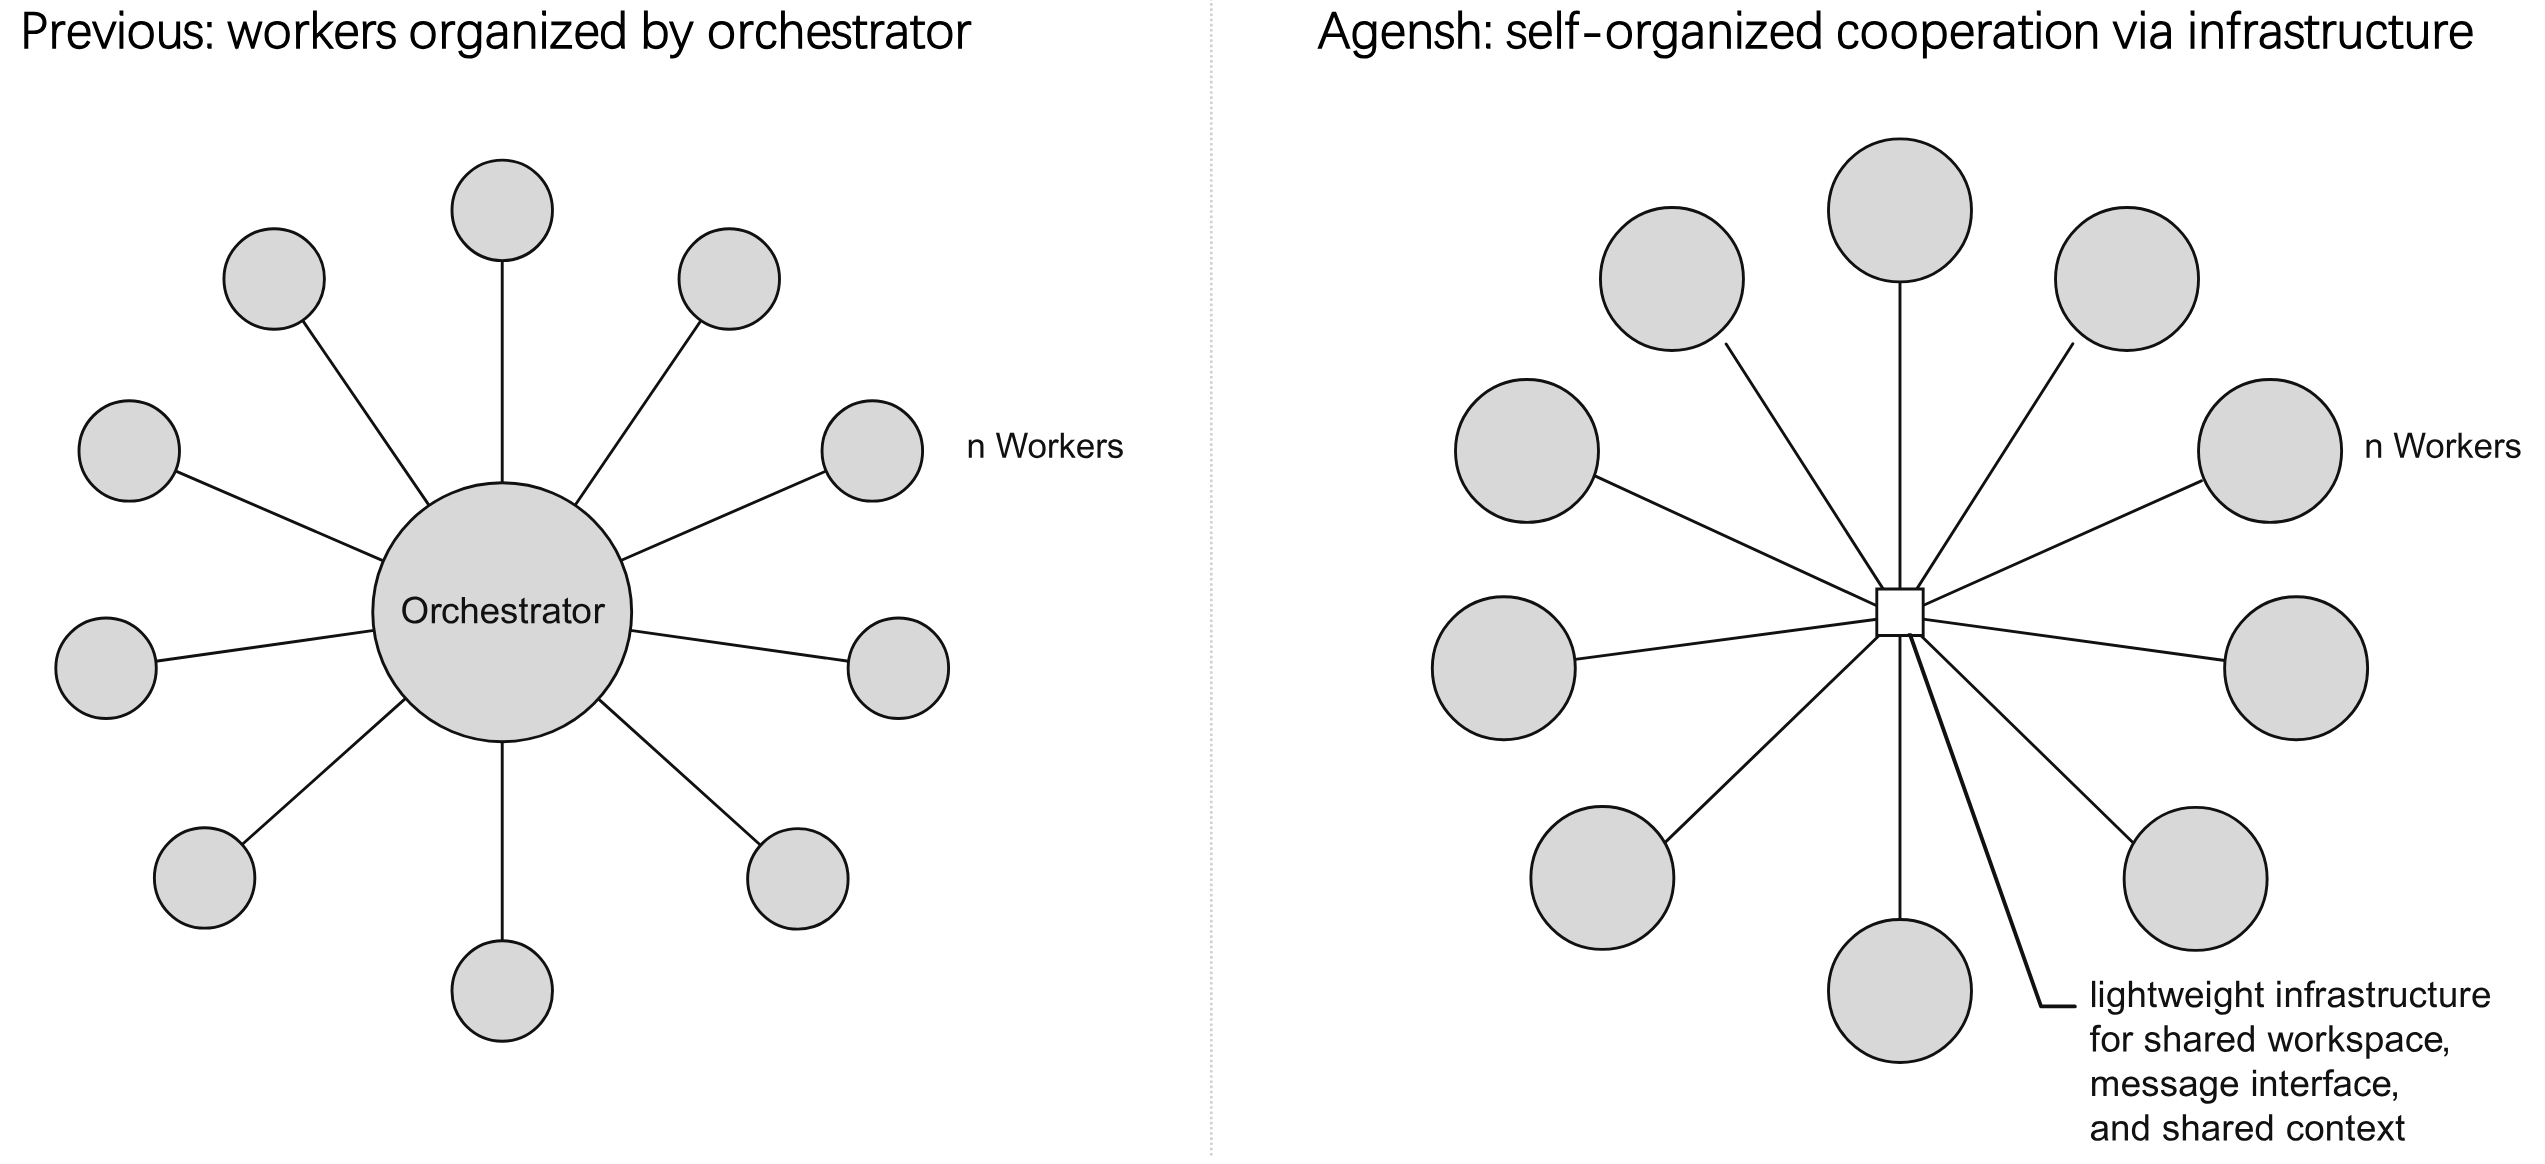
논문 Figure 2가 차이를 한 장으로 보여준다. 왼쪽은 큰 오케스트레이터가 중심이고, 오른쪽은 중심에 에이전트가 아니라 인프라(작은 사각형)가 있다. 사각형은 판단하지 않는다. 저장소, 메시지, 공유 노트를 들고 있을 뿐이고, 판단은 전부 동일한 크기의 워커들이 한다.
🧠 무엇인가: 기존 하네스 위에 얹는 "조직 층"
Agensh는 단일 에이전트 하네스를 대체하지 않는다. 논문 2.3절의 표현을 빌리면 "단일 에이전트 하네스 위에 층으로 얹는 조직 하네스(organization harness layered above a single-agent harness)" 다. 워커 하나의 대화 상태 유지, 모델 호출, 도구 실행은 기존 하네스가 맡고(실험에서는 GitHub Copilot CLI, 저장소는 Copilot 1.0.70 버전을 고정), Agensh는 그 바깥에 워커 식별자, 협업 프로토콜, 이벤트 라우팅, 공유 저장소 접근, 메시징, 공유 컨텍스트, 복구·생존 메커니즘을 공급한다. 저자들은 이 경계를 "의도적으로 최소화된 플러그앤플레이" 인터페이스라고 부르고, 협업 루프를 런타임에 하드코딩하지 않고 워커 프롬프트의 워크플로 지시문으로만 구현했기 때문에 Claude Code 같은 다른 하네스에도 가벼운 어댑터로 붙일 수 있다고 주장한다(실제 공개된 코드는 Copilot ACP 세션용이다).
5단계 협업 루프
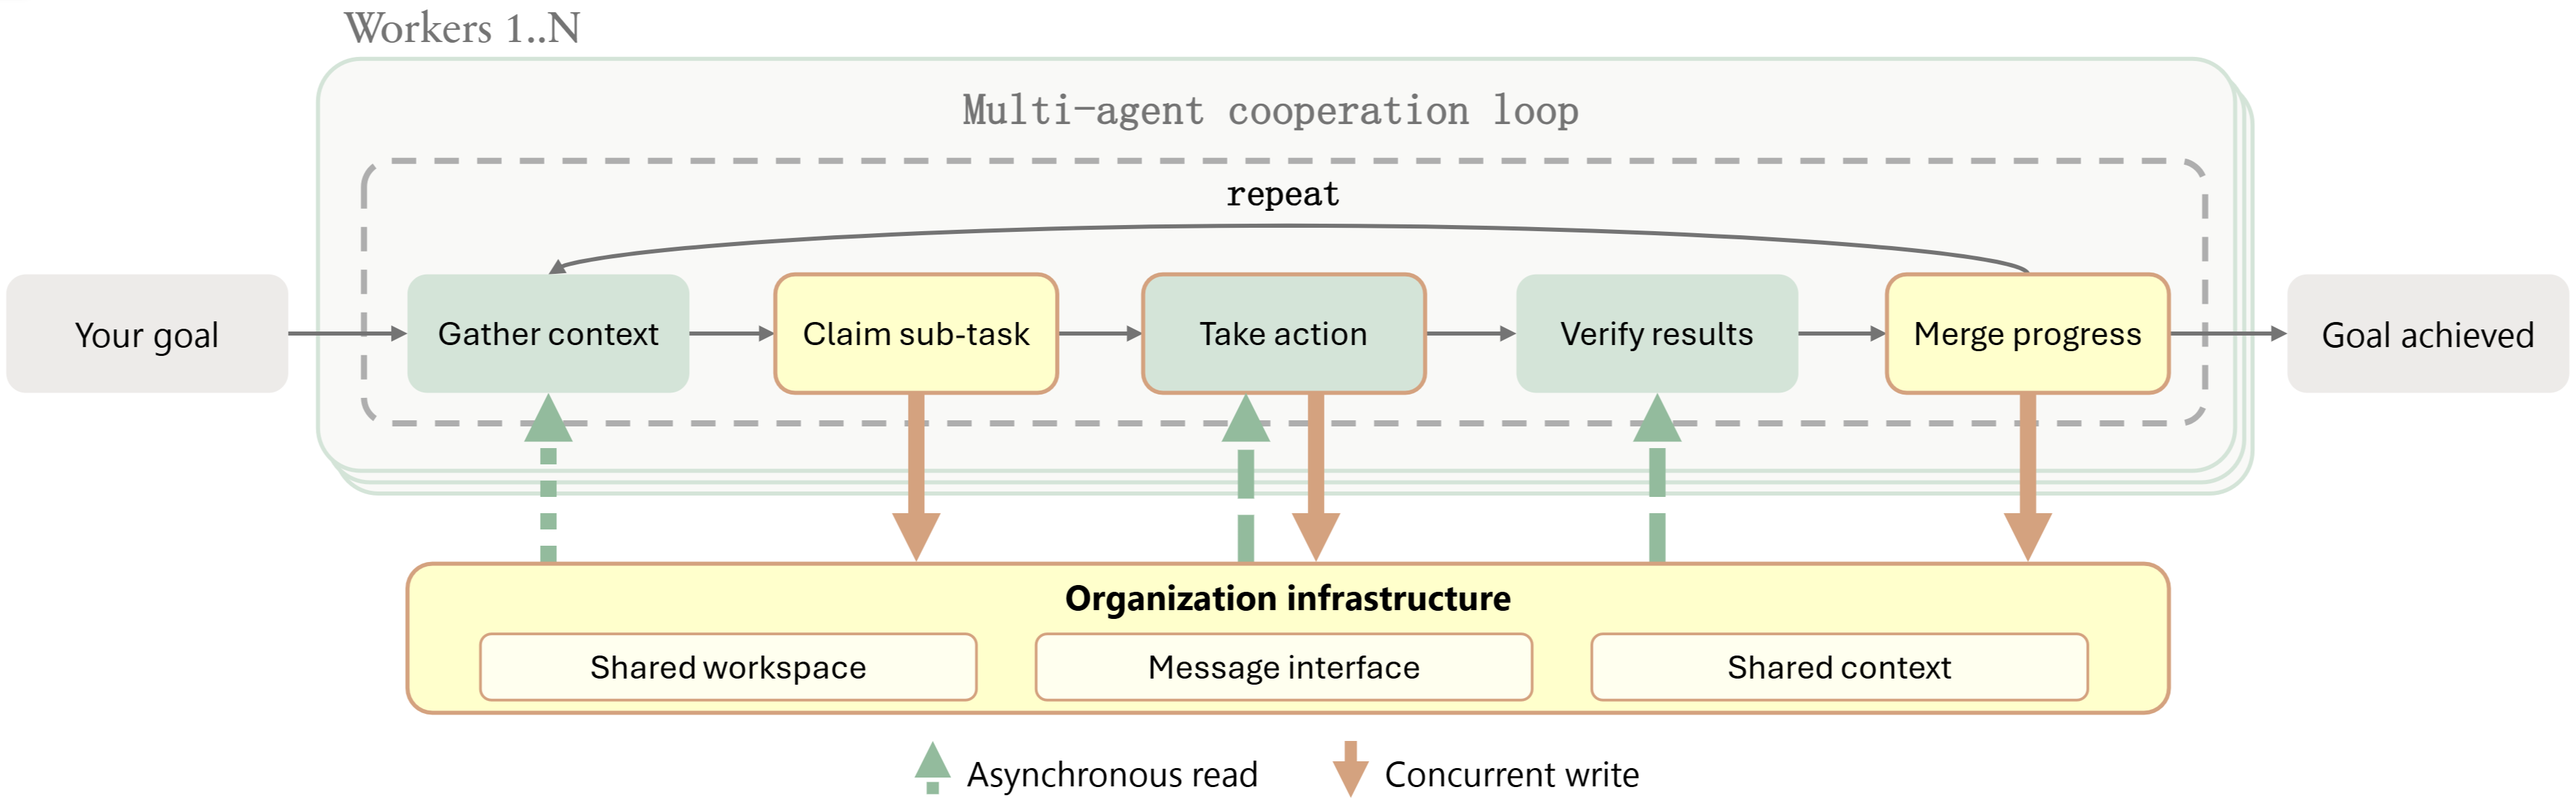
저장소 demo/loop.png(논문 Figure 3과 같은 그림)다. 각 워커는 다음 다섯 단계를 비동기로, 다른 워커가 한 바퀴 끝나기를 기다리지 않고 돈다.
- Gather context. 공유 목표, 현재 상태, 동료 진행 상황과 메시지, 누적된 발견을 읽고 환경과 상호작용해 다음 할 일을 찾는다.
- Claim sub-task. 맡을 범위를
CLAIM으로 공유 컨텍스트에 적는다. 두 워커의 claim이 겹치면 다이렉트 메시지로 조정한다. - Take action. 로컬에서 도구를 써서 구현하고, 다른 워커에게 도움이 될 발견이 생기면 그때그때 공유 컨텍스트에 올린다.
- Verify results. 서브태스크의 수용 기준과 맞춘다. 미달이면 고친다.
- Merge progress. 공유 저장소에 머지하고, 무엇을 바꿨고 왜 그랬으며 검증 근거가 무엇인지 공개한다. 머지가 충돌로 막히면 최신 동료 진행을 끌어와 해결하고 다시 머지한다.
여기서 "어떻게 작업을 고르는가"의 답은 생각보다 단순하다. 프롬프트(논문 Appendix A = 저장소 prompts/agents.txt)의 작업 사이클 1번은 "/opt/pbench/executable을 실행해서 아직 안 만든 영역을 관찰하라" 다. 즉 할 일 목록을 누가 주는 게 아니라, 각자 레퍼런스 바이너리를 돌려보고 공유 보드의 CLAIM과 비교해 빈 곳을 잡는다. 충돌 회피도 규칙이 아니라 정보 전달에 기댄다. 프롬프트는 보드 항목이 턴 중간에 도착했을 때의 행동을 이렇게 정한다.
FAIL— 그 일을 하고 있었다면 멈춰라.FACT/OBSERVED— 써라. 네가 만들고 있는 것에 대한CLAIM— 충돌이니 DM으로 해결하라. 그 밖의CLAIM— 하던 것을 계속 하라.
세 가지 인프라
| 구성 요소 | 구현 | 역할 (논문 2.2절) | 저장소에서 확인되는 세부 |
|---|---|---|---|
| 공유 워크스페이스 | Gitea | 진행 중·통합된 작업, 버전 이력, 충돌 노출, 이슈·PR | 이슈 #1이 과제. 워커는 자기 브랜치에서 PR을 열고 main에 머지. 부트스트랩이 필수 승인 0명으로 PR 머지를 허용하고 main 직접 push는 제한, CI 머지 게이트는 비활성 |
| 메시지 인터페이스 | Mattermost | 채널 공지 + 긴급 DM | 채널 메시지는 턴 시작 시, DM은 인프라 도구 호출이 끝날 때마다 전달. DM은 동료의 현재 턴을 중단시키므로 "같은 것을 고치려 할 때만" 쓰라고 지시 |
| 공유 컨텍스트 | board-service(DeLM 아이디어 차용) | 재사용 가능한 발견과 작업 claim | OBSERVED/FACT/FAIL/CLAIM은 100자, PATCH_SUMMARY는 300자 제한. 최근 뷰 2,000개, claim은 1시간 뒤 숨김, 전체 이력은 board_grep으로 검색 |
메시지 우선순위 설계가 눈에 띈다. 낮은 우선순위(채널)는 턴 경계에서, 높은 우선순위(DM, 새 보드 항목)는 MCP 도구 호출의 반환값에 끼워 넣어 턴 중간에 전달한다(Appendix B.2). 워커가 실행 중인 임의의 프로세스를 중단시키지는 않는다. 워커당 TypeScript 사이드카(mini-router)가 Gitea SSE와 Mattermost 웹소켓을 듣고 이벤트를 MySQL 큐에 넣은 뒤 Copilot ACP 세션에 프롬프트로 전달하며, 10분간 idle이면 "계속 일하라"는 프롬프트를, 턴이 끝났는데 보드에 아무것도 안 썼으면 "발견을 공유하라"는 프롬프트를 보낸다(Appendix B.1).
프롬프트의 마지막 문장이 이 시스템의 철학을 요약한다. "가진 도구가 부족하면 찾아라. 없으면 만들어라(If the tool you have is not enough, look for one; if there is none, build one)."
📐 ProgramBench: 바이너리와 문서만 보고 소프트웨어를 다시 만들기
평가에는 ProgramBench(Yang, Lieret, Press 등 12명, arXiv 2605.03546, 2026년 5월, 코드는 facebookresearch 저장소)를 썼다. 초록에 따르면 "프로그램과 그 문서만 주어졌을 때 레퍼런스 실행 파일의 동작과 일치하는 코드베이스를 설계·구현"하는 벤치마크로, 테스트는 에이전트 기반 퍼징으로 생성한 end-to-end 동작 테스트라 구현 구조를 강제하지 않는다. 200개 과제가 작은 CLI 도구부터 FFmpeg·SQLite·PHP 인터프리터까지 걸쳐 있고, 9개 모델 중 어느 것도 한 과제를 완전히 풀지 못했으며 최고 모델도 테스트 95% 이상 통과가 3% 과제에 그쳤다.
Agensh 논문은 programbench.com/extended의 최신 모델 평균 통과율 기준 가장 어려운 5개를 골랐다(Table 1).
| 과제 | 커밋 | 파일 수 | 코드 줄 수 | 코드 크기 |
|---|---|---|---|---|
| FFmpeg | 360a402 | 10,090 | 1,549,005 | 75.51 MB |
| gromacs | 665ea4c | 8,982 | 815,539 | 47.30 MB |
| pandoc | 5caad90 | 2,767 | 104,336 | 4.86 MB |
| PHP-src | c891263 | 26,266 | 2,812,757 | 119.76 MB |
| ctags | 243595e | 7,313 | 246,228 | 9.15 MB |
규칙은 프롬프트에 "철칙(Iron rules)"으로 박혀 있다. 레퍼런스 바이너리는 root:root 0111이라 실행만 되고 cat·objdump로 읽을 수 없다. 인터넷이 없으므로 원본 소스 clone이나 pip install은 실패한다. 저장소 루트에 compile.sh가 있어야 하고 그것이 ./executable을 만들어야 하며, 평가기는 HEAD를 tar로 꺼내 커밋된 ./executable을 지운 뒤 compile.sh를 돌리고 숨겨진 테스트를 실행한다. 루트에 compile.sh가 없으면 0점이다.
실험 조건(Appendix C)을 그대로 옮기면 다음과 같다.
- 모델 gpt-5.6-sol, reasoning effort high, 하네스 Copilot, 입력 272,000 / 출력 128,000 토큰 제한
- 6시간 예산, 인터넷 차단, ProgramBench 공식 평가기의 canonical-kept pass rate 보고
- 범위 경합을 줄이기 위해 에이전트를 첫 1시간은 30초에 하나, 이후 3초에 하나씩 순차 기동. 첫 에이전트 기동 시각 기준 에 전원 종료 후 제출
- 에 "새 기능 그만, 루트 빌드 확인하고 열린 PR 머지하라", 에 "준비된 것만 머지하고 멈춰라" 공지
- 1,024개 실험은 16노드 × 64 에이전트
- 단일 에이전트 베이스라인은 혼자서는 6시간을 다 쓰지 못하므로 stop hook으로 "항상 새 일이 있다"는 프롬프트를 계속 주입
📊 결과: 에이전트 수가 새로운 스케일링 축이라는 주장
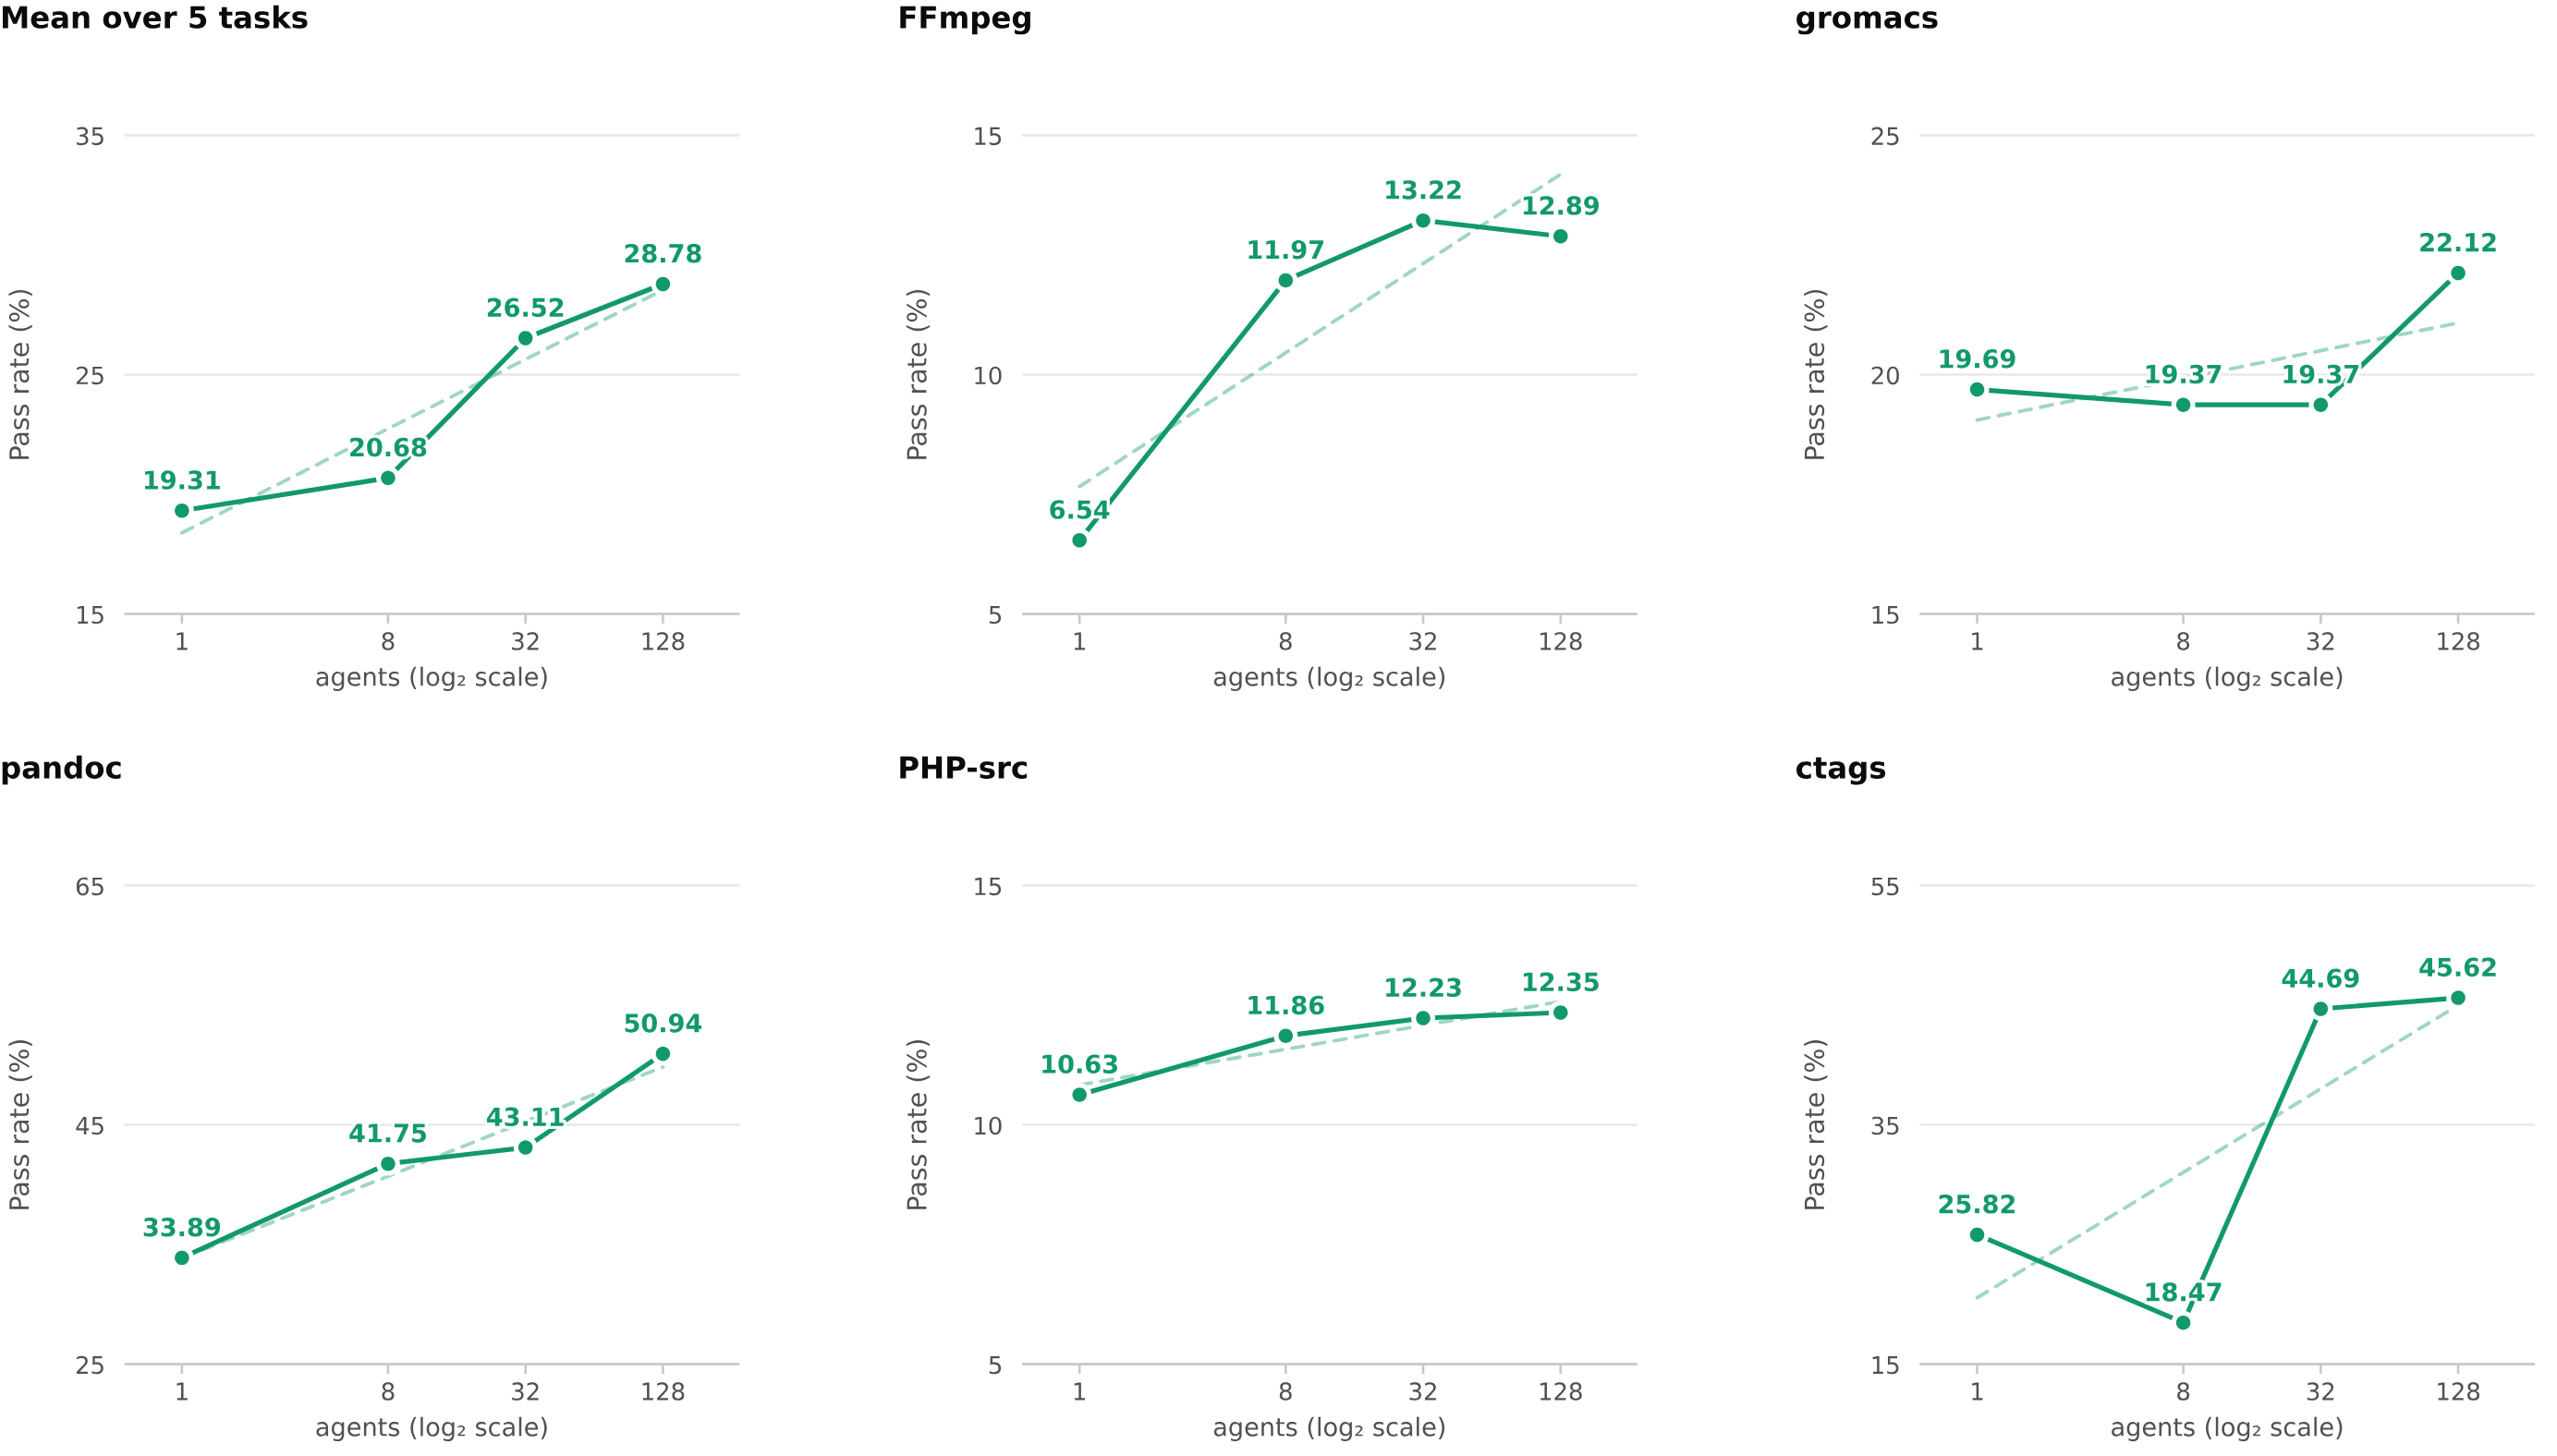
논문 Figure 5다. 그래프에 찍힌 수치를 표로 옮긴다(단위 %, 최종 테스트 통과율, 6시간, GPT-5.6-sol high).
| 과제 | 1개 | 8개 | 32개 | 128개 | 1,024개 |
|---|---|---|---|---|---|
| FFmpeg | 6.54 | 11.97 | 13.22 | 12.89 | – |
| gromacs | 19.69 | 19.37 | 19.37 | 22.12 | – |
| pandoc | 33.89 | 41.75 | 43.11 | 50.94 | 55.06 |
| PHP-src | 10.63 | 11.86 | 12.23 | 12.35 | – |
| ctags | 25.82 | 18.47 | 44.69 | 45.62 | – |
| 5개 평균 | 19.31 | 20.68 | 26.52 | 28.78 | – |
평균은 1→128개에서 9.47%p, 상대 약 49% 상승한다. 다섯 과제의 1개·128개 값을 직접 평균해 보면 19.314와 28.784로 표의 평균과 맞는다. pandoc만 1,024개까지 확장했고, 128개 대비 4.12%p, 1개 대비 21.17%p 높다. 코드 공개와 함께 README에 추가된 GPT-6.1-sol(high) 실험은 pandoc에서 1개 56.19% → 8개 71.38% → 32개 79.59%로, 상대 41.64% 개선이다(이 수치는 arXiv v1 논문에는 없고 README와 프로젝트 페이지에만 있다).
다만 과제별로 보면 그림이 균일하지 않다. ctags는 8개에서 오히려 단일 에이전트보다 7%p 넘게 떨어졌다가 32개에서 급등하고, FFmpeg는 32→128에서 소폭 하락하며, gromacs는 32개까지 사실상 제자리다. 논문은 이를 "generally increasing trend"로 서술하고 과제별 편차의 원인은 분석하지 않는다.
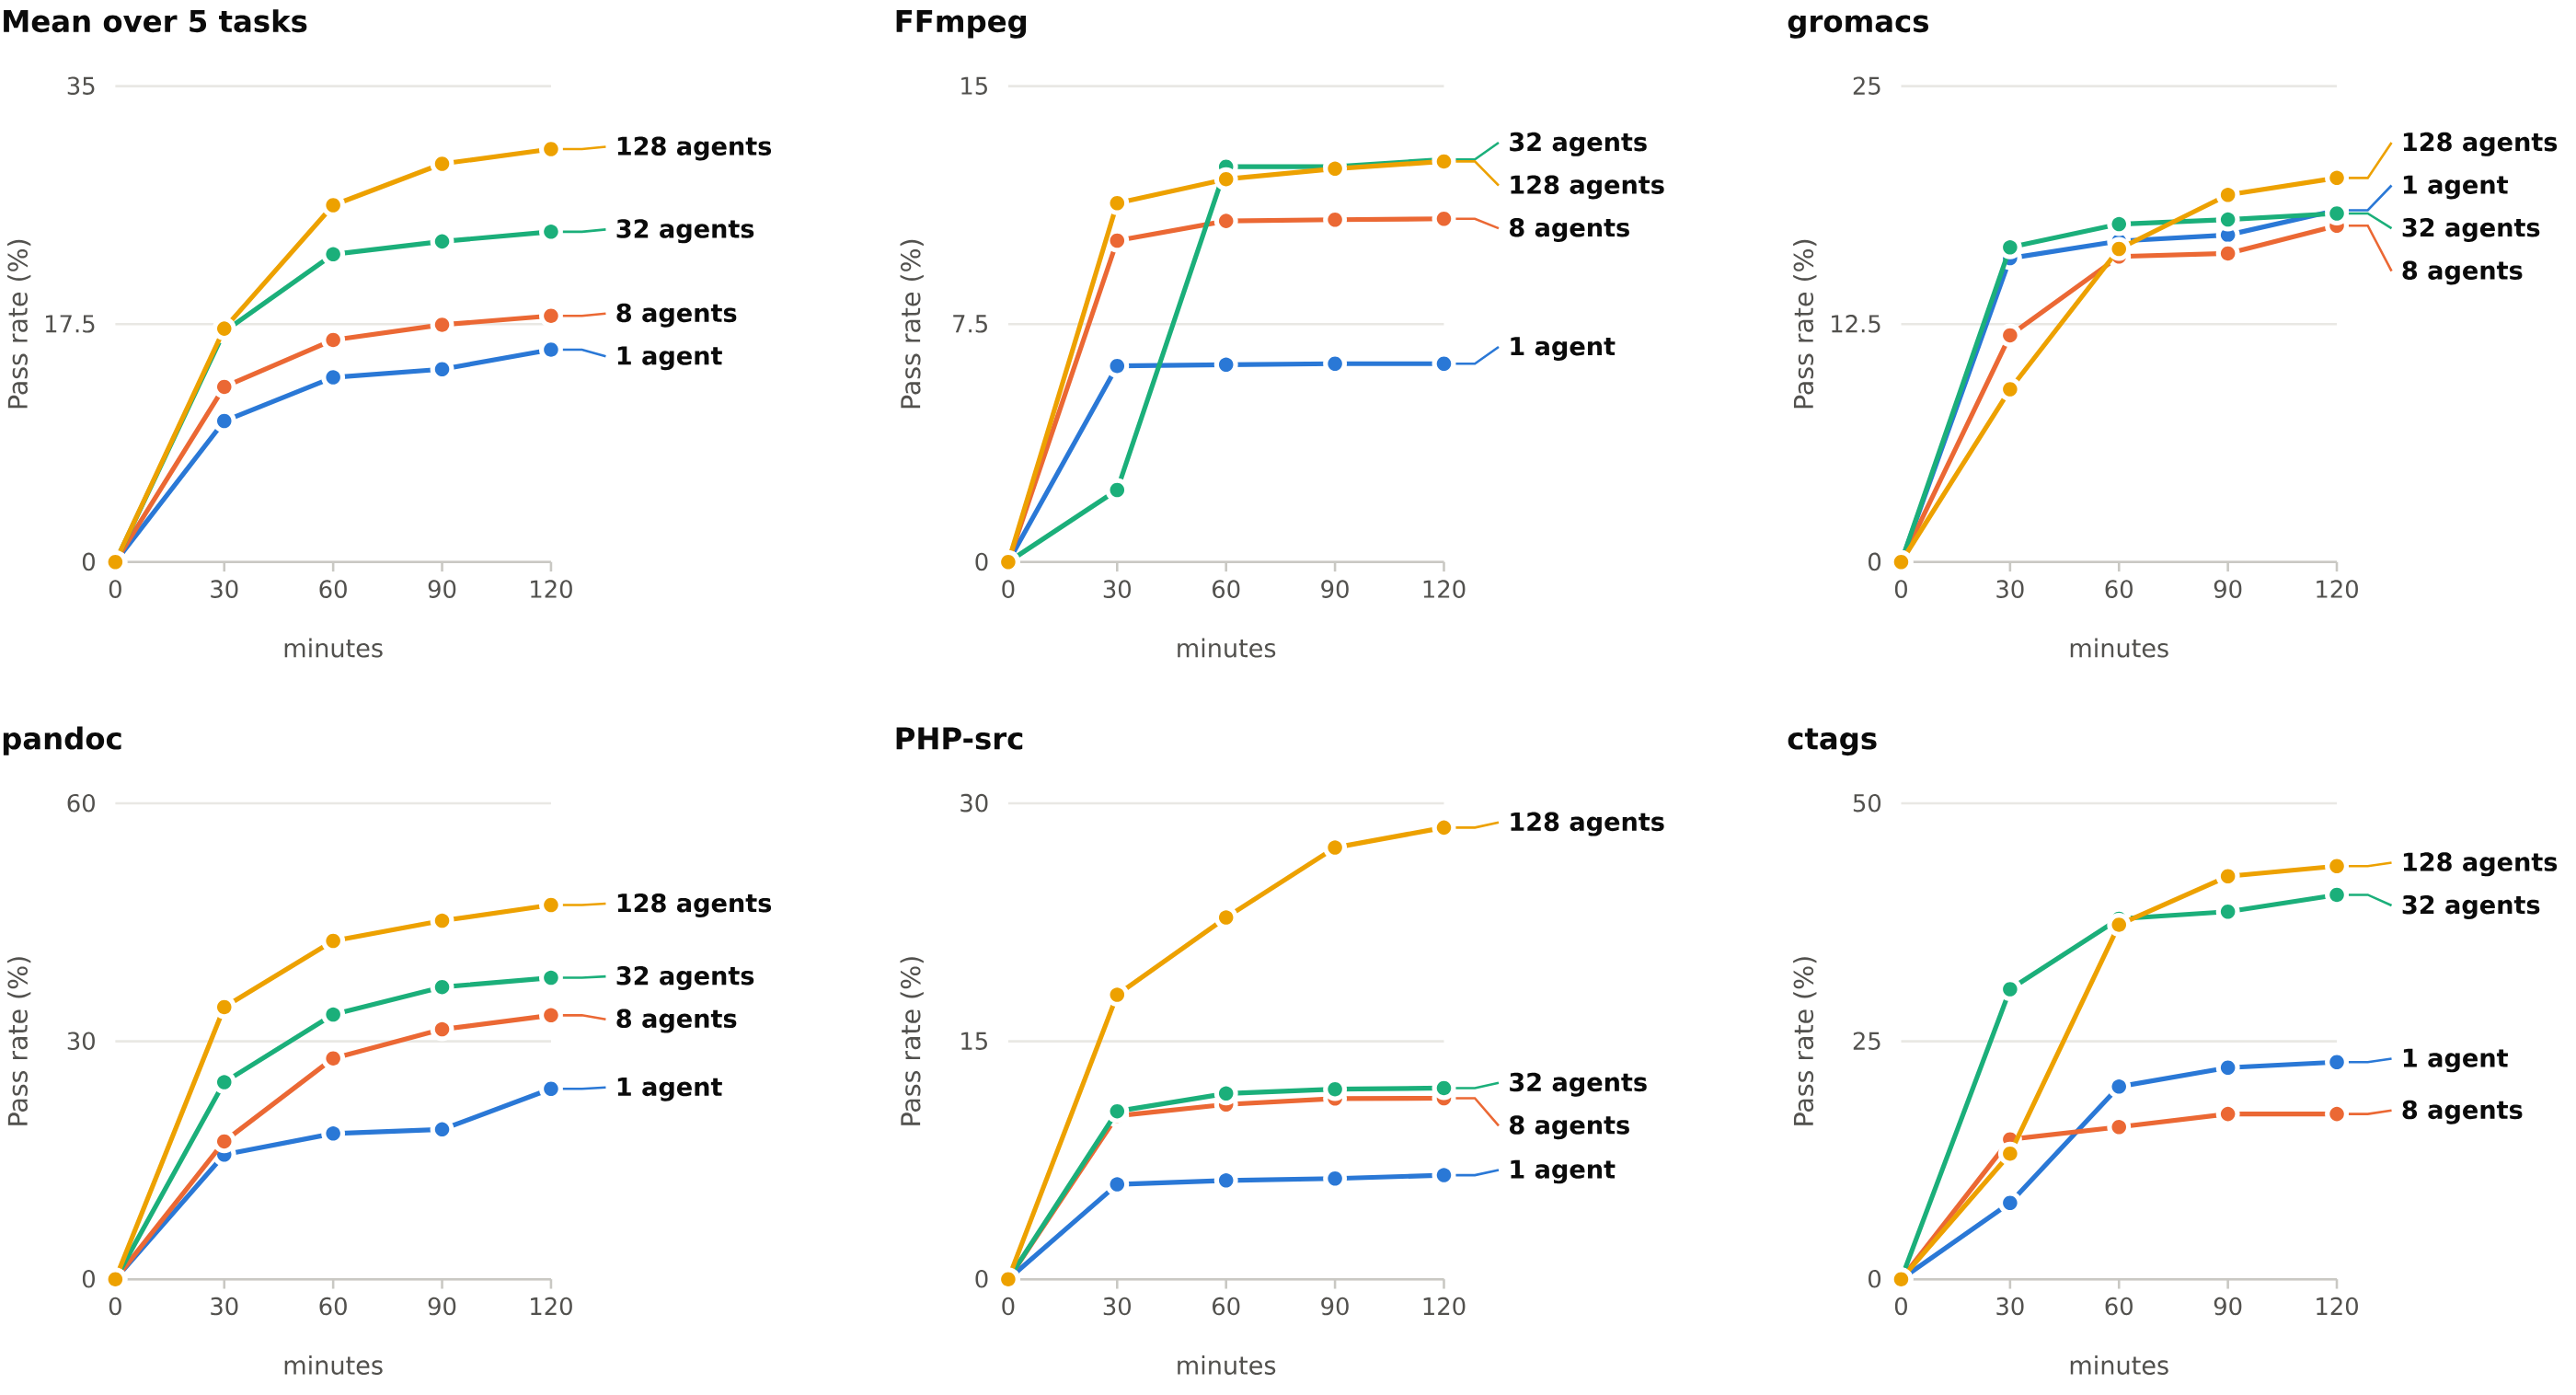
논문 Figure 6은 처음 2시간의 시간 곡선이다. 저자들이 강조하는 사례는 pandoc이다. 128개는 30분 체크포인트에서 30%를 넘고, 32개는 60분, 8개는 90분에 처음 넘으며, 단일 에이전트는 2시간 내내 30% 아래다. 그래서 논문은 에이전트 수가 최종 점수뿐 아니라 "특정 수준에 도달하는 지연 시간" 도 줄인다고 주장하고, 이를 "하드 레이턴시 제약이나 시간 예산이 있는 복잡한 과제의 실용적 해법"으로 포장한다. 반대로 gromacs는 2시간 시점에 네 곡선이 거의 겹쳐서, 병렬화가 거의 도움이 안 되는 과제도 있다는 것을 같은 그림이 보여준다.
🔍 창발 행동: 아무도 역할을 주지 않았다
논문 3.2절이 가장 흥미로운 부분이다. 모든 워커는 같은 루프를 돌고 워커 ID만 다른 같은 프롬프트를 받는데, 규모가 커질수록 새로운 협업 형태가 나타났다고 기록한다. 논문 본문에 서술된 사례만 옮긴다(원시 로그는 논문에 없고, 1,024개 실험의 Gitea·Mattermost 활동은 프로젝트 페이지의 리플레이로 공개돼 있다).
| 규모 | 관찰된 협업 (논문 3.2절) | 과제 |
|---|---|---|
| 8개 | 모듈 인터페이스를 공표하고 각자 그 인터페이스를 따르는 커맨드 모듈을 독립 구현. 범위 겹침을 논의한 뒤 한 워커가 보완적 작업으로 범위를 바꿈 | gromacs, FFmpeg |
| 32개 | 여러 동료가 한 기여를 처음에 승인 → 다른 워커가 구체적 반례 발견 → 승인 철회 → 작성자 수정 → 재리뷰 → 동료가 머지. 통합 관리에 참여하는 워커 폭이 넓어짐 | PHP-src |
| 128개 | 관련 경험이 있는 동료를 리뷰어로 고르고 그 관계를 재사용. 통합 책임을 충돌 해결·검증·머지까지 해 주는 동료에게 이관. 두 워커가 "작성자가 브랜치 갱신·테스트 → 커밋 해시 전달 → 동료가 검증·머지"라는 표준 통합 프로토콜을 세우고 다른 워커들이 재사용. 실패를 겪은 뒤 "동료에게 갱신·테스트·검사·머지 전 과정 권한을 준다"로 프로토콜 개정 | pandoc |
| 1,024개 | 같은 전문 역할을 맡는 워커가 다수 등장. integrator가 여럿 생기고, 작성자는 후보 integrator 여럿에게 연락한 뒤 먼저 유효하게 응답한 쪽을 택하고 나머지 요청은 취소한 다음 코드를 넘김. 같은 기술 영역의 워커가 다른 워커의 실패한 시도를 이어받아 복구 | pandoc |
설계 관점에서 중요한 건 이 역할들을 인프라가 강제하지 않는다는 점이다. 앞의 표에서 봤듯 Gitea는 승인 0명으로 PR 머지를 허용한다. 리뷰어도, integrator도, "커밋 해시를 보내면 네가 머지해 줘"라는 프로토콜도 전부 워커들이 Mattermost에서 합의한 관행이다. 직무 분리 글의 TDGA가 검증자를 아키텍처로 못 박은 것과 대비하면, Agensh는 검증 역할이 충분한 규모와 공유 상태만 있으면 사회적으로 생겨난다는 관찰을 내놓은 셈이다. 물론 "생겨났다"와 "믿을 만하다"는 다른 문제다. 승인 0명 설정에서 리뷰를 건너뛰고 바로 머지한 워커가 얼마나 됐는지는 논문에 없다.
💡 비판적으로 읽기
AI타임스 기사도 마지막에 짚었듯, 이 실험은 같은 모델·같은 6시간에서 에이전트 수만 늘린 것이다. 논문과 저장소에서 확인되는 범위로 한계를 정리한다.
- 동일 비용 비교가 아니다. 1,024개 실험은 16노드에서 6시간, 즉 단일 에이전트의 최대 1,024배 에이전트-시간이다. 논문은 토큰 소비량이나 비용을 어디에도 보고하지 않는다. "+21.17%p"의 가격을 알 수 없다. 기동 지연(첫 120개는 30초 간격, 이후 3초 간격)을 감안하면 1,024번째 워커는 첫 워커보다 약 1시간 45분 늦게 시작하므로 실제 에이전트-시간은 그보다 적지만, 역시 논문이 계산해 주지는 않는다.
- 중앙 조율 방식과의 직접 비교가 없다. 1장에서 오케스트레이터 병목을 동기로 삼았지만, 같은 모델·같은 예산의 오케스트레이터-워커 베이스라인(예: Copilot
/fleet)은 실험에 없다. "자기조직화가 중앙 조율보다 낫다"는 이 논문이 입증한 명제가 아니다. - 베이스라인 조건이 다르다. 단일 에이전트는 별도 프롬프트(
prompts/single-agent/)와 stop hook으로 즉시 재개하는 드라이버를 쓰고, 팀은 10분 idle 넛지를 쓴다. REPRODUCE.md 스스로 "팀 규모나 베이스라인을 비교할 때 이 차이를 기록하라"고 적어 둔다. - 반복 실험과 분산이 없다. 각 설정의 실행 횟수, 표준편차, 신뢰구간이 보고되지 않는다. ctags 8개(18.47%)처럼 단일 에이전트보다 낮은 점이 노이즈인지 실제 간섭 효과인지 구분할 수 없다.
- 1,024개의 실패 양상은 서술되지 않는다. 3.2절은 "다른 워커의 실패한 시도를 이어받아 복구"와 "실패를 겪은 뒤 프로토콜 개정"이라는 긍정적 측면만 기술하고, 중복 구현·머지 충돌 비율·버려진 PR 수 같은 실패 통계는 없다. 1,024개 확장은 pandoc 한 과제뿐이며, pandoc은 다섯 과제 중 코드가 가장 작다(104K줄).
- 공개 코드로 논문 수치를 그대로 재현하지는 못한다. REPRODUCE.md는 원 실험이 구버전
task_cleanroom레퍼런스를 썼고 공개 버전은 v6 클린룸이라 "버전 문자열이 같아도 바이너리가 다르다"며, 새 실행은 정확한 역사적 재현을 주장하지 말고 자체 리비전을 기록하라고 명시한다.
그래도 남는 것이 있다. 같은 모델에서 조직 구조만으로 평균 9.47%p, pandoc 21%p가 움직였다는 사실, 그리고 그 과정에서 리뷰·integrator 같은 역할이 지시 없이 나타났다는 관찰은, Harness²가 하네스를 고치는 재귀로 성능을 끌어올린 것과는 다른 축의 레버다. 모델도, 하네스도 그대로 두고 "몇 명이 어떤 인프라를 공유하느냐" 를 바꿨다.
🛠️ 직접 돌려보기: 요구사항과 명령
실행하지는 않았고, REPRODUCE.md에 적힌 요구사항과 명령을 그대로 옮긴다. 가볍게 돌려볼 수 있는 물건이 아니다.
요구사항
- Linux + Docker Engine + Compose v2 + systemd + cgroup v2. 호스트 도구: Bash, Make, Python 3.11+, Git, curl, jq,
envsubst,flock,uv. Docker와 컨테이너 소유 데이터에 대한 passwordless sudo - 메모리 슬라이스(
docker/pbench.slice)와 재부팅 가드 systemd 유닛 설치 - ProgramBench v1.2.5(커밋
27f0215) 별도 설치, 과제별 blob 동기화. 평가 이미지는programbench/<task>:task_cleanroom_v6 - 모델 접근:
~/.pbench-upstream.env(mode 600)에 Responses API 게이트웨이 URL과 bearer 토큰(LLM_UPSTREAM,LLM_UPSTREAM_TOKEN,REASONING_EFFORT=high). 실제 자격증명은 egress 프록시가 주입하고 워커는 로컬 프록시 자격증명만 받는다. 런처는gpt-5.6-solhigh가 아니면 거부한다. GitHub Copilot 구독 로그인에 대한 언급은 문서에 없고, Copilot CLI 바이너리(1.0.70)는 워커 이미지에 고정돼 들어간다 - 워커당 메모리 상한 64 GiB, 라우터 8 GiB. 기본값은 워커 8개, 과제당 6시간
- 베이스 이미지 첫 빌드 시 Gitea MCP 바이너리를 받기 위해
docker.gitea.com접근 필요
명령 (REPRODUCE.md 순서 그대로)
# 1. systemd 슬라이스와 재부팅 가드
sudo cp docker/pbench.slice /etc/systemd/system/
sed "s|/opt/agensh|$PWD|g" docker/pbench-reboot-guard.service \
  | sudo tee /etc/systemd/system/pbench-reboot-guard.service >/dev/null
sudo systemctl daemon-reload
sudo systemctl enable pbench-reboot-guard.service

# 2. ProgramBench 고정 버전
git clone https://github.com/facebookresearch/ProgramBench.git /path/to/programbench
git -C /path/to/programbench checkout 27f02157c785f8da3647aa6dbbe6b9137f99f10e
uv sync --project /path/to/programbench --frozen
export PROGRAMBENCH_REPO=/path/to/programbench

# 3. 실험 설정 (pandoc 단일 과제, 워커 8개, 6시간)
export TASKS='jgm__pandoc.5caad90'
export WORKERS=8 HOURS=6
export RUN_ID="$(date -u +%Y%m%dt%H%M%Sz)"
export PBENCH_EVAL_PYTEST_ADDOPTS='--rootdir=.'
bash scripts/pbench_gen_env.sh          # .env.pbench-single-node-<task-slug> 생성

# 4. 이미지 빌드 (base, mini-router, board, secret-service, bootstrap 후)
JOBS=1 bash scripts/pbench_build_pertask_images.sh

# 5. 프리플라이트 후 백그라운드 기동
PREFLIGHT_ONLY=1 bash scripts/launch_single_node.sh
mkdir -p out
setsid nohup bash scripts/launch_single_node.sh \
  > out/single-node.launch.log 2>&1 < /dev/null &

# 6. 채점 (canonical-kept score)
uv run --project "$PROGRAMBENCH_REPO" \
  python tools/pbench_score_report.py "$RUN_DIR" "$TASK_ID"

# 7. 정리
make down PROFILE="$PROFILE"   # 데이터 보존
make clean PROFILE="$PROFILE"  # 데이터 삭제
큰 팀을 돌릴 때는 Mattermost의 MM_MAX_USERS_PER_TEAM(기본 200)을 워커 수보다 크게, MySQL MYSQL_MAX_CONNECTIONS(기본 1,000, 라우터당 최대 4개)를 늘려야 한다고 문서가 경고한다. 프롬프트 템플릿은 "실험 입력"이므로 실행 간 비교를 하려면 고정해야 한다.
📝 정리와 열린 질문
Agensh가 보여준 것은 세 가지다. (1) 오케스트레이터 없이 Git 플랫폼 + 채팅 + 100자짜리 공유 노트만으로 1,024개 에이전트를 하나의 저장소에 묶을 수 있다. (2) 같은 모델·하네스에서 에이전트 수를 늘리면 ProgramBench 최난이도 5개 과제 평균이 19.31%에서 28.78%로, pandoc은 55.06%까지 오르고 도달 시간도 짧아진다. (3) 리뷰어·integrator·표준 통합 프로토콜 같은 조직 구조가 프롬프트에 없어도 규모가 커지면 생긴다.
보여주지 못한 것도 분명하다. 비용, 중앙 조율 대비 우위, 분산, 실패 통계. 그래서 남는 질문은 이런 것들이다.
- 같은 토큰 예산이라면 1개 에이전트 × 긴 시간과 128개 × 6시간 중 어느 쪽이 나은가. 이 논문은 시간을 고정했지 토큰을 고정하지 않았다.
- 창발한 리뷰 관행은 승인 0명 설정에서 얼마나 지켜졌는가. 인프라가 승인 1명을 강제하면 점수가 오르는가, 느려지는가.
- gromacs처럼 병렬화가 안 먹는 과제는 왜 그런가. 과제의 분해 가능성을 미리 예측할 수 있는가.
- Copilot 외의 하네스(Claude Code 등)에 붙였을 때 같은 창발이 나오는가. 논문은 가능하다고 말하지만 코드는 Copilot ACP용뿐이다.
Raven이 "조합이 언제 단독보다 넓은 task coverage를 주는가"를 수식으로 묻는 논문이었다면, Agensh는 그 반대편에서 "조율자를 없애고 숫자를 늘리면 무엇이 생기는가"를 로그로 보여준 논문이다. 둘 다 아직 같은 예산 위에서 맞붙은 적은 없다.
📚 참고
- 논문: Agensh: Scaling Organizational Intelligence to 1,024 Agents (Zhan, Song, Dong, Huang, Lian, Xia, Wei — Microsoft Research, 2026-09-22)
- 코드·재현 가이드: github.com/microsoft/Agensh (MIT, 2026-10-24 공개) —
README.md,REPRODUCE.md,prompts/agents.txt,board-service/README.md,mini-router/README.md - 프로젝트 페이지·1,024 에이전트 리플레이: aka.ms/Agensh
- ProgramBench: Can Language Models Rebuild Programs From Scratch? (Yang, Lieret 등, 2026-05), github.com/facebookresearch/ProgramBench
- DeLM(공유 컨텍스트의 원형): Decentralized Multi-Agent Systems with Shared Context (Mao, Mirhoseini, 2026)
- 기사: MS, 관리자 없이 AI 1024개 협업하는 '에이전시' 공개…스스로 역할도 나눠 (AI타임스 박찬, 2026-10-26)
- 이 블로그의 관련 글: Raven, Harness², 루프 엔지니어링, Autonoma, 직무 분리
본 글의 그림은 논문(arXiv 2609.26781) HTML과 microsoft/Agensh 저장소의
demo/폴더에서 가져왔습니다.