Edge0: 35B MoE를 SSD에서 3GiB 메모리로 서빙하기 — 라우팅을 한 토큰 먼저 예측한다
"메모리 벽의 절반(KV 캐시)은 업계가 열심히 깎았다. 나머지 절반(가중치)은 '데이터센터에 두자'로 끝냈다. 정말 그래야 할까?"
2026년 9월, AutoArk 팀(Yu Lin, Yiming Wang, Runyuan Cai, Hanze Liu, Xiaodong Zeng)이 The Other Half of the Memory Wall: Serving 35B MoEs from SSD with Trained Routing Prediction 이라는 기술 보고서를 arXiv에 올렸다. 요약하면 이렇다. 24GB Mac mini M4 Pro에서, 19.5GB짜리 int4 체크포인트의 35B MoE(Qwen3.6-35B-A3B 기반)를 피크 활성 메모리 2.9GiB, 20.4 tok/s 로 돌린다. 같은 기계에서 가중치를 전부 메모리에 올린 vanilla mlx-lm 서버는 18.2GiB를 먹으면서 3.9 tok/s밖에 못 낸다. 프레임워크, 체크포인트, 어댑터가 모두 Apache-2.0으로 공개돼 있다.
원문: https://arxiv.org/abs/2609.18063 · 코드: https://github.com/Edge0-AI/Edge0
🤔 문제: 희소성은 연산을 줄이지, 바이트를 줄이지 않는다
1995년 Wulf와 McKee가 이름 붙인 메모리 벽(memory wall) 은 30년이 지나 LLM 추론에 그대로 적용된다. 디코딩은 가중치 1바이트를 읽을 때마다 FLOP 몇 개만 쓰는 메모리 바운드 작업이고, 그 바이트는 메모리에 살아야 한다.
저자들은 메모리에 담긴 데이터를 두 종류로 나눈다.
- 상태(State): KV 캐시. 토큰이 생성될수록 자란다. MLA, 희소 어텐션, 선형 상태 모델, 그리고 vLLM의 PagedAttention 같은 페이징 기법까지, 업계가 집중적으로 공략한 쪽이다. (이 블로그의 KV Cache 최적화와 PagedAttention 글이 다루는 영역이다.)
- 가중치(Weights): 학습이 끝나는 날 고정되는 정적 데이터. 수십 GB의 이 비용은 사실상 "데이터센터에 두고 expert parallelism으로 흡수한다"는 한 가지 답으로만 해결돼 왔다.
로컬 환경의 두 가지 표준 답도 35B급에서는 막힌다. 양자화는 4비트에서 바닥을 친다(그 아래로는 오차가 급증한다). MoE 희소성은 35B 모델이 토큰당 약 3B만 활성화하게 해주지만, 이는 계산하는 양 을 줄이는 것이지 저장하는 양 을 줄이는 게 아니다. 19.5GB는 여전히 어딘가에 있어야 하고, 24GB 데스크톱에서 그 "어딘가"는 OS와 모든 앱을 밀어내는 기계 전체 메모리다.
그냥 SSD에 두면 안 되나?
여기서 핵심 난관이 나온다. 전문가 가중치를 SSD에 두고 필요할 때만 읽으면 되지 않을까? 문제는 의존성이다. 레이어 의 전문가를 고르려면 레이어 의 출력이 있어야 하는데, 그 출력이 나올 때쯤이면 레이어 의 읽기를 시작하기엔 이미 늦다. 순진한 스트리밍 엔진은 토큰마다, 레이어마다 디스크 지연을 직렬로 기다리게 된다.
llama.cpp의 --cpu-moe, PowerInfer, Mixtral-offloading, MoE-Infinity, FlexGen 같은 기존 오프로딩 연구들은 가중치를 CPU 메모리나 디스크로 옮기긴 하지만, 저자들 표현으로는 "발자국을 옮기는 것이지 줄이는 게 아니"고, 디스크로 간 가중치는 다음 스텝에 어떤 전문가가 필요한지 모른 채 읽힌다.
🧠 핵심 아이디어: "예측이 곧 라우팅이다"
Edge0의 답은 세 가지 부품의 조합이다.
- SSD 스트리밍 전문가 레이어 — 전문가 가중치는 int4 safetensors로 SSD에 두고 mmap으로 필요한 바이트 범위만 읽는다.
- Prerouter — 레이어별 작은 헤드가 다음 레이어의 라우팅을 한 토큰 먼저 예측하고, 그 예측을 그대로 라우팅으로 사용 한다.
- Recovery LoRA — int4 베이스는 동결하고, 학생 경로(prerouter 라우팅)에서 fp16 교사로부터 증류한 LoRA를 병합하지 않은 채 병렬 델타로 서빙한다.
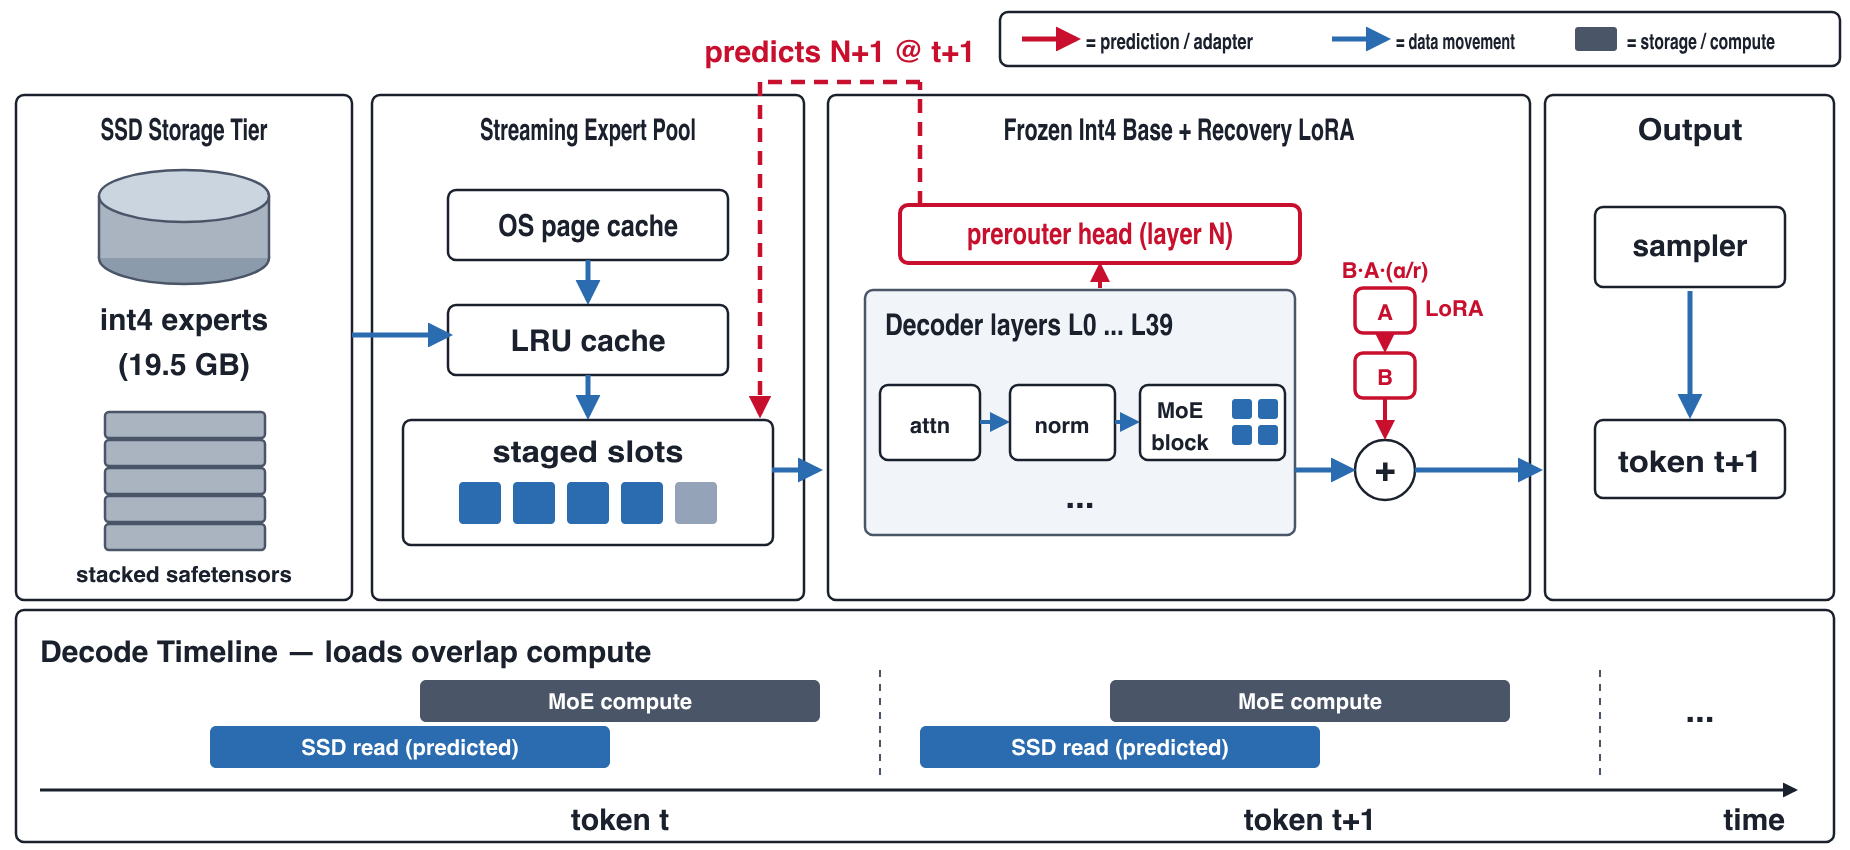
그림 1이 전체 데이터 흐름이다. 빨간 점선이 이 논문의 전부라고 해도 된다. 레이어 이 가진 prerouter 헤드가 토큰 시점에 "토큰 에서 레이어 은 어떤 전문가를 쓸까"를 예측하고, 그 예측으로 staged slot을 SSD에서 미리 채운다. 하단 타임라인처럼 SSD 읽기(predicted)가 현재 토큰의 MoE 연산과 겹쳐 돌아간다.
📐 방법 상세
1) SSD 스트리밍 전문가 레이어
40레이어, 256전문가 MoE는 레이어당 int4 전문가 가중치가 453MB(전문가 하나당 1.77MB), 합치면 18GB(16.9GiB)다. 19.5GB 체크포인트의 나머지는 어텐션, 임베딩, 공유 전문가, 양자화 스케일이다.
Edge0는 실행 경로를 네 가지로 나눈다.
| 경로 | 역할 |
|---|---|
exact |
중복 제거된 온디맨드 번들 빌드. 나머지 모든 경로의 정확성 기준선 |
staged |
고정 슬롯 더블 버퍼링. 디코드의 주력 경로. 라우팅 인덱스는 슬롯 테이블을 거쳐 GPU를 떠나지 않고, incr_stack으로 바뀐 전문가만 제자리에서 갱신 |
hot |
레이어별 LRU 상주 핫 전문가 집합. PowerInfer 식 hot/cold 분할. 미스는 exact로 폴백 |
whole-layer |
프리필용. 레이어의 전문가 전체를 9번의 직접 읽기로 한 번에 로드 |
모든 경로는 같은 양자화 gather 커널로 를 계산하고, 테스트 스위트가 각 경로를 역양자화 레퍼런스와 원소 단위로 비교한다. 이 "수학 계약" 덕분에 레이어마다, 단계마다 경로를 자유롭게 바꿔도 출력이 달라지지 않는다.
흥미로운 지적 하나. 이 하드웨어에서 "전부 메모리에 올린 엔진"은 빠른 기준선이 아니다. 모델이 안 들어가기 때문이다. 18.2GiB를 회수 불가능하게 점유하면 KV 캐시와 OS에 남는 게 거의 없어 시스템이 페이징을 시작하고, 그래서 3.9 tok/s가 나온다.
2) Prerouter: 왜 "한 레이어"가 아니라 "한 토큰" 앞인가
Prerouter는 이중 시프트(double shift) 를 쓴다. 레이어 이 소유한 헤드가 토큰 에서 레이어 의 post-attention norm 출력을 입력받아, 토큰 에서의 레이어 라우팅을 예측한다. 레이어 은 한 토큰 전에 만들어진 예측을 소비하고, 그 슬롯을 채우는 SSD 읽기는 현재 forward와 겹친다.
Pre-gated MoE(ISCA 2024)처럼 같은 토큰 안에서 바로 다음 레이어의 전문가를 고르는 방식도 있다. 저자들은 이게 스트리밍 엔진에서는 살아남지 못한다고 말한다. 레이어마다 GPU 동기화와 헤드 평가가 필요해 파이프라인이 비워지는데(그들의 엔진에서 스텝당 30~100ms), 이는 숨길 수 있는 로드 시간보다 크고, 측정한 모든 same-token 변형이 단순 LRU 기준선보다 느렸다. 한 토큰의 리드를 두면 스텝당 한 번의 flush로 모든 staged 레이어(35B 티어 32개, 8B 티어 16개)를 한꺼번에 예측 할 수 있고, 열리는 윈도우가 디코드 스텝 하나 전체가 된다.
헤드 구조는 단순하다. 레이어마다 에 선형 잔차 경로 을 더한 것인데, 이 잔차 경로를 다음 레이어의 라우터 가중치로 warm-start 한다. 즉 학습은 "다음 라우터를 이 hidden state에 그냥 적용한다"에서 시작하고 MLP는 보정만 배운다. 입력은 hidden state에 두 개의 top- one-hot(이 레이어가 이번 토큰과 이전 토큰에서 실제로 라우팅한 전문가)을 이어 붙인 것이다.
(35B 티어 기준, hidden width 512, fp16.) 35B 티어는 33개 헤드(소유 레이어 6~38), 8B 티어는 16개 헤드를 갖고, 40개 중 32개 / 24개 중 16개 레이어가 자기 게이트 대신 예측으로 스트리밍한다.
Prediction-as-routing 이 이 설계의 핵심 결정이다. 디코드 시 MoE 레이어는 원래 라우터 대신 prerouter의 로짓을 동일한 softmax-topk 또는 sigmoid-group 수학에 통과시켜 라우팅한다. 라우팅된 집합 = 예측된 집합이므로 staged slot은 정확히 매핑되고 버릴 게 없다. Pre-gated 시스템이 런타임에 처리하던 "커버리지 vs 품질" 트레이드오프(폴백 로드, 드롭된 토큰)가 구조적으로 사라지고, 그 근사의 비용은 학습 시점에 한 번만 치른다.
3) Recovery LoRA: 왜 병합하지 않는가
서빙되는 모델은 (int4 베이스) + (라우팅 교체) + (LoRA)다. LoRA는 앞 두 항의 손실을 되찾기 위해 존재하며, prerouter가 켜진 학생 경로에서 교사 데이터에 대한 cross-entropy로 학습되어 양자화와 라우팅 근사를 동시에 보상 한다.
배포 시 이 델타는 병합되지 않고 병렬로 계산된다. 이유는 구현이 아니라 산술이다. LoRA 델타의 RMS()는 4비트 그룹 스텝보다 작아서, 역양자화된 가중치에 델타를 더하고 다시 4비트로 양자화하면 대부분이 지워진다. 저자들이 측정한 생존률은 어텐션 projection에서 34%, dense projection에서 2%, 로짓 수준에서 18%다. 병합하지 않는 경로의 비용은 42MB의 어댑터 가중치와 "측정 가능하지 않은" 디코드 시간이다. 덕분에 읽기 전용 베이스 하나가 모든 어댑터 세대를 서빙하고, 티어 재학습은 파일 두 개 교체로 끝난다.
4) 학습 레시피: 순서가 협상 불가였다
세 단계 모두 4비트 배포 체크포인트의 bf16 역양자화 복원본 위에서, 베이스를 동결한 채 돌린다("서빙하는 것을 학습한다").
- Phase 1 — 헤드 증류: prerouter 헤드만 학습. 다음 레이어의 실제 라우터를 모방하는 손실.
- Phase 2 — 학생 경로 SFT: LoRA를 어텐션·선형 어텐션·공유 전문가 projection에 붙이고(스트리밍되는 라우팅 전문가에는 붙이지 않는다), prerouter 라우팅을 켠 채 교사가 생성한 약 200만 행의 텍스트로 SFT.
- Phase 3 — on-policy 증류: Phase 2 체크포인트가 생성한 텍스트를 fp16 베이스가 채점. 교사의 top- 토큰에 reverse KL을 적용하고 나머지 질량은 tail 항으로 처리. SFT 코퍼스의 1/10(약 20만 행)에서 수렴.
저자들의 경험담이 인상적이다. 증류만 한 체크포인트에 학생 라우팅을 걸면 반복적이고 붕괴된 텍스트 가 나오고, 같은 헤드에 SFT를 더하면 동일한 속도·메모리로 멀쩡한 출력이 나온다. 순서도 바꿀 수 없었다: 헤드 먼저(아니면 SFT 신호가 작은 헤드 gradient를 덮는다), SFT, 그다음 on-policy 증류. 그리고 라우터 일치도를 더 끌어올리는 건 잘못된 목표 라고 말한다. 이전 토큰의 hidden state에서 다음 토큰의 라우팅을 예측하는 건 정보적으로 한계가 있고, 중요한 건 학생 라우팅 아래에서 LM이 좋은 텍스트를 내느냐다.
이 "동결 베이스 + 파일 교체"의 부산물로, 35B 티어는 베이스의 대신 로 출시됐다. 16GB 기계에서 같은 가중치로 를 8에서 4로 줄이면 디코드가 3.3 → 6.4 tok/s로 거의 두 배가 되고 피크 메모리도 내려가는데, 재학습된 티어가 품질을 유지했기 때문이다.
📊 실험 결과
두 공개 티어
| edge0-35b | edge0-8b | |
|---|---|---|
| 베이스 | Qwen3.6-35B-A3B | Ling 3.0 tiny (MLA+MoE) |
| 레이어 × 전문가 | 40 × 256 + shared | 24 × 128 + shared |
| 활성 파라미터/토큰 | ≈3B | ≈1.2B |
| 라우팅 폭 | 4 | 8 |
| 양자화 | int4 affine g64 | int4 affine g64 |
| 디스크 체크포인트 | 19.5 GB | 4.5 GB |
| Prerouter 헤드 | 33 | 16 |
| LoRA | ||
| 디코드 (tok/s) | 20.4 | 28.0 |
| 프리필 cold / warm (tok/s) | 113 / 140 | 500 / 1102 |
| 피크 활성 메모리 | 2.9 GiB | 1.5 GiB |
(Mac mini M4 Pro 24GB, 각 arm 별도 프로세스, warm, 순서 회전, 3라운드 중앙값.) 35B 티어에서 prerouter를 끄면 19.9 tok/s가 나온다. 8B 티어는 LRU를 64 → 1024 번들로 키우면 31.8 tok/s까지 오른다.
품질: fp16 교사 대비 평균 3.9점 / 2.8점
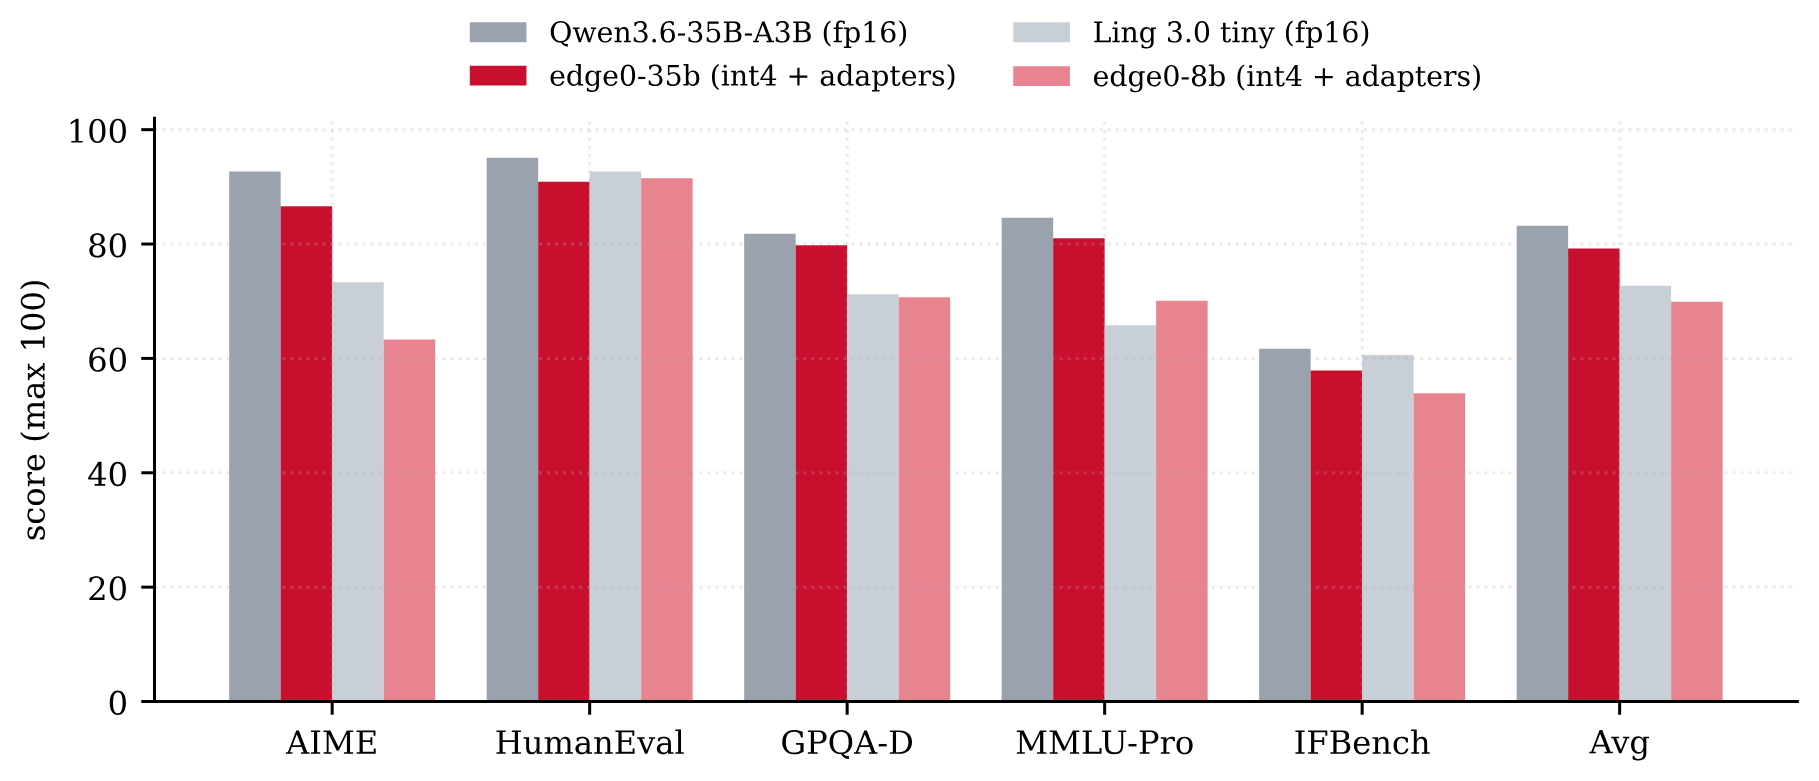
| 벤치마크 | edge0-35b (int4) | Qwen3.6 (fp16) | edge0-8b (int4) | Ling 3.0 tiny (fp16) |
|---|---|---|---|---|
| AIME 2026 | 86.6 | 92.7 | 63.3 | 73.3 |
| HumanEval | 90.9 | 95.1 | 91.5 | 92.7 |
| GPQA-Diamond | 79.8 | 81.8 | 70.7 | 71.2 |
| MMLU-Pro | 81.0 | 84.6 | 70.1 | 65.8 |
| IFBench | 57.9 | 61.7 | 53.9 | 60.6 |
| 평균 | 79.2 | 83.2 | 69.9 | 72.7 |
int4 + 라우팅 교체라는 이중 손실을 감안하면 평균 격차 3.9점(35B), 2.8점(8B)은 꽤 작다. 다만 손실이 긴 추론 체인에 집중 된다는 점은 명확하다. AIME에서 35B는 6.1점, 8B는 10.0점이 빠진다. 반대로 MMLU-Pro에서 8B는 오히려 4.3점 앞선다.
Prerouter의 이득: +80~84%, 그런데 "예측 품질" 때문이 아니다
이 실험은 일부러 가중치가 안 들어가는 기계(16GB MacBook M2, 18.4GiB 체크포인트)에서 돌렸다. 인위적 메모리 제한 없이, 물리 메모리만이 제약이라 모든 설정이 매 스텝 SSD에서 전문가를 다시 읽는다.
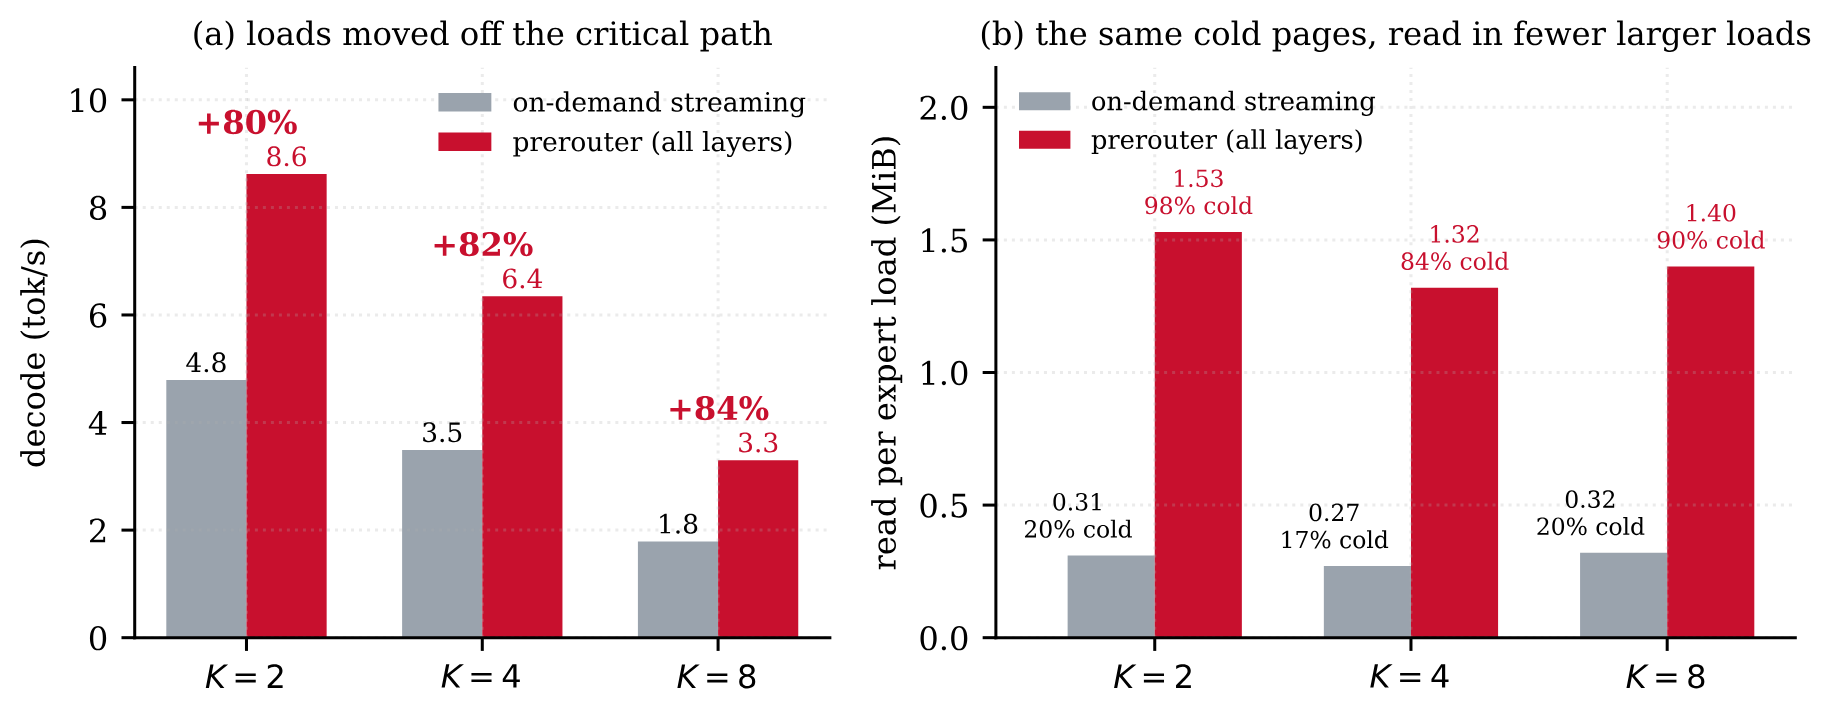
| on-demand | prerouter | 이득 | |
|---|---|---|---|
| 2 | 4.8 | 8.6 | +80% |
| 4 | 3.5 | 6.4 | +82% |
| 8 | 1.8 | 3.3 | +84% |
이 수치를 해석하는 방식이 이 논문에서 가장 배울 점이 많은 부분이다.
- 이득은 임계 경로에서 빠져나간 로드 시간이다. 메인 스레드가 전문가 로드에 블록된 시간이 에서 154.9 → 46.5ms/스텝, 에서 244.0 → 101.9ms, 에서 575.0 → 211.6ms로 줄었다. 그동안 어떤 자원도 포화되지 않았다(디스크 읽기는 스텝의 최대 12%, CPU는 8코어 중 1개, GPU 35~41%). 제거된 건 직렬화된 로드 지연 이다.
- 보존이지, 예측 품질이 아니다. 두 arm은 스텝당 거의 같은 바이트를 읽는다(: 125.1 vs 126.9MiB, : 29.5 vs 30.4MiB; 에서만 prerouter가 16% 더 읽는다). 읽기를 임계 경로에서 치우면 숨길 수는 있어도 지울 수는 없다. 얼마나 이득이 있는지는 스토리지 계층의 속성 이지 헤드의 속성이 아니다.
- 재사용이 한계다. 그들의 트레이스에서 인접 토큰은 한 레이어의 전문가 집합 중 약 1/4만 공유한다. 프리페치된 전문가 대부분은 다시 읽히지 않는다.
- 대가는 페이지 캐시다. 예측된 전문가가 상주해야 하므로 회수 불가능한 MLX 메모리가 늘어난다(에서 1.43GiB 증가, 페이지 캐시는 1.15GiB 감소). 그 대신 같은 cold 페이지를 더 적고 큰 로드로 읽는다(그림 3b: 로드당 1.40MiB·90% cold vs 0.32MiB·20% cold). 로드 비용은 로 맞아떨어진다. 프리페치는 로드당으로는 싸고, 미리 옮기는 바이트당으로는 비싸다.
저자들은 "하나의 메커니즘이지 둘이 아니다"라고 정리한다. staging만으로는 배포 가능한 구성이 아니다. 올바른 집합의 출처가 없으면 전문가를 떨어뜨려 출력이 망가지거나, 핫셋을 고정해 두고 churn이 생긴다. 예측이 고르고, staging이 싣는다.
메모리: 기계가 실제로 지불하는 것
35B 티어의 피크 활성 메모리는 19.5GB 체크포인트 대비 2.9GiB이고 나머지는 디스크다. 같은 가중치를 전부 상주시키면 18.2GiB에 3.9 tok/s. Edge0는 상주 서버의 1/6~1/7을 점유하면서 5배 빠르다. 프리필은 거울상이다. cold 첫 요청은 SSD fault-in 비용을 치르고(35B: 113/140 tok/s cold/warm), warm 프리필은 whole-layer 로딩과 페이지 캐시 덕에 compute-bound가 된다. 제약된 단계는 프리필이 아니라 디코드 이고, 여기 있는 모든 메커니즘은 디코드를 겨냥한다. PD Disaggregation 글에서 프리필과 디코드가 다른 자원을 요구한다는 이야기를 했는데, 단일 소비자 기기에서도 같은 비대칭이 그대로 나타나는 셈이다.
💡 정리, 한계, 열린 질문
정리. 가중치 쪽 메모리 벽은 "저장 위치 결정"이고, 모두가 같은 선택(메모리 또는 데이터센터)을 했다. Edge0는 다른 결정을 한다. 전문가는 SSD에 살고, 학습된 prerouter가 한 토큰 먼저 라우팅을 예측해 로드를 연산 아래 숨기고, 예측이 곧 라우팅이라 아무것도 버리지 않으며, 병합하지 않은 증류 LoRA가 4비트의 품질 청구서를 갚는다.
한계 (저자들이 직접 밝힌 것).
- 한 번에 요청 하나, FIFO 직렬화. 배칭은 전문가 워킹셋을 바꾸므로 per-request 프로파일로는 모델링되지 않는다.
- 디코드 병목은 스토리지가 아니라 CPU 쪽 이다. 40레이어 forward에서 그래프 빌딩 44ms/스텝이 바닥이고, 어떤 스토리지 최적화도 이를 못 줄인다. 부록 B에서
incr_stack(바뀐 슬롯만 제자리 갱신)이 추가로 +34% 디코드를 냈다고 보고하지만, 이건 어셈블리 비용을 가격한 것이지 프리페칭이 아니다. - Prerouter 이득은 제거하는 대기 시간에 비례 한다. 핫 캐시나 빠른 스토리지에서는 줄어들고, 재사용(인접 토큰 간 1/4 일치)에 묶여 있으며, 대가는 페이지 캐시에서 가져온 회수 불가능한 상주 메모리다. 즉 메모리가 빠듯하고 스토리지가 느린 체제, 정확히 Edge0가 만들어진 환경에서만 승리한다.
- 품질 손실은 긴 추론(AIME)에 집중된다.
- 백엔드는 MLX 하나뿐. CUDA 슬롯은 "코드가 아니라 아키텍처"다.
열린 질문. 아직 당기지 않은 레버 두 개를 저자들이 명시했다. stager가 같은 가중치의 번들 뷰와 stacked 텐서 뷰를 둘 다 유지하는데 하나를 버리면 에서 약 0.45GiB를 돌려받을 수 있고, 메인 스레드에서 동기적으로 도는 fill(스텝당 62.5ms)을 다른 스레드로 옮기면 기다릴 필요 없던 비용이 사라진다. 개인적으로는 feature drift 문제도 궁금하다. 헤드 입력에는 "이 레이어가 실제로 라우팅한 전문가"가 들어가는데, 학습 때는 베이스 라우터의 선택이고 디코드 때는 헤드 자신의 예측이다. 헤드는 이 시프트에 대해 재학습되지 않았고 LoRA가 학생 경로에서 이를 흡수한다고 하는데, 헤드 자체를 on-policy로 한 번 더 돌리면 AIME 격차가 얼마나 줄지는 보고되지 않았다. 또 GitHub 로드맵에는 Q4 2026에 "블록당 한 번의 라우팅 예측으로 latent reasoning의 전문가 로드량을 추론 루프 횟수와 분리하겠다"는 계획이 적혀 있어, prerouter의 리드 거리를 한 토큰에서 한 블록으로 늘리는 방향으로 보인다.
🔧 직접 돌려보기
GitHub README 기준으로 Python 프레임워크는 macOS Apple Silicon + MLX 전용 이다(mlx==0.30.6, mlx-lm==0.31.0, Python 3.10+). 체크포인트는 35B가 약 23GB, 8B가 약 4.2GB이며 전문가 가중치는 mmap으로 읽히므로 RAM에 미리 올라가지 않는다.
git clone https://github.com/Edge0-AI/Edge0 && cd Edge0/python
python3.12 -m venv .venv && .venv/bin/pip install -e '.[dev,fetch]'

# 체크포인트 + LoRA + prerouter 어댑터가 한 디렉터리로 내려온다
.venv/bin/python scripts/fetch_models.py --tier edge0-8b --target-dir models
export EDGE0_8B_MODEL=$PWD/models/edge0-8b

edge0 demo edge0-8b
edge0 chat edge0-8b --prompt "Explain streaming inference in one sentence."
edge0 serve edge0-8b   # OpenAI 호환 /v1/chat/completions, 127.0.0.1:8000
curl http://127.0.0.1:8000/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{"model":"edge0-8b","messages":[{"role":"user","content":"Hello!"}],"max_tokens":32}'
--no-prerouter / --no-lora 플래그로 각 부품을 끄고 베이스만 돌릴 수 있어서, 이 글에서 본 "prerouter 켜고/끄고" 비교를 직접 해볼 수 있다. 벤치마크 스크립트는 python examples/bench.py edge0-8b다. README의 측정치(Mac mini M4 Pro 24GB)는 35B가 14.917.7 tok/s, 8B가 23.925.3 tok/s로 논문 표 1보다 조금 낮게 적혀 있는데, 측정 프로토콜(3.3k 토큰 프리필 후 200토큰 디코드, 2회)이 다르기 때문으로 보인다. macOS(Rust), iOS(Swift), Android(Kotlin), Windows(C++/Vulkan) 엔진도 같은 리포에 공개돼 있다.
📚 참고
- 원문: The Other Half of the Memory Wall: Serving 35B MoEs from SSD with Trained Routing Prediction (arXiv 2609.18063) · HTML · HF Papers
- 코드: github.com/Edge0-AI/Edge0 (Apache-2.0)
- 모델: Edge0/Edge0-35B-A3B-preview · Edge0/Edge0-8B-A1B-preview
- Pre-gated MoE (Hwang et al., ISCA 2024): arXiv 2308.12066
- QLoRA (Dettmers et al., 2023): arXiv 2305.14314
- 관련 글: KV Cache 최적화 · PagedAttention · PD Disaggregation
본 글의 그림은 원문에서 가져왔습니다.