루프 엔지니어링: 프롬프트를 쓰지 말고, 에이전트를 프롬프트하는 루프를 설계하라
"You shouldn't be prompting coding agents anymore. You should be designing loops that prompt your agents." — Peter Steinberger, 2026-06-07 (arXiv 2608.21884가 인용)
"I don't prompt Claude anymore. I have loops that are running. They're the ones that are prompting Claude... My job is to write loops." — Boris Cherny, 2026-06-02 인터뷰 (같은 논문이 인용)
2026년 6월 첫 주, 위 두 발언과 Addy Osmani의 블로그 글이 며칠 간격으로 나오면서 루프 엔지니어링(loop engineering) 이라는 말이 퍼졌다. Osmani의 정의는 한 문장이다. "루프 엔지니어링은 에이전트를 프롬프트하는 사람 자리에서 당신을 빼내는 일이다. 대신 그 일을 하는 시스템을 설계한다." 석 달이 지난 지금, 이 개념을 다룬 arXiv 논문이 세 편(2607.00038, 2608.21884, 2609.00006) 나왔고 Claude Code와 Codex에는 /loop, /goal이 들어갔다. 이 글은 1차 출처(두 논문, Osmani·Huntley·LangChain·Ng의 원문, 각 도구의 공식 문서)에서 확인된 범위로 루프 엔지니어링이 무엇이고, 무엇으로 이루어지며, 어디까지 믿을 수 있는지를 정리한다.
🧠 계보: 프롬프트 → 컨텍스트 → 하네스 → 루프
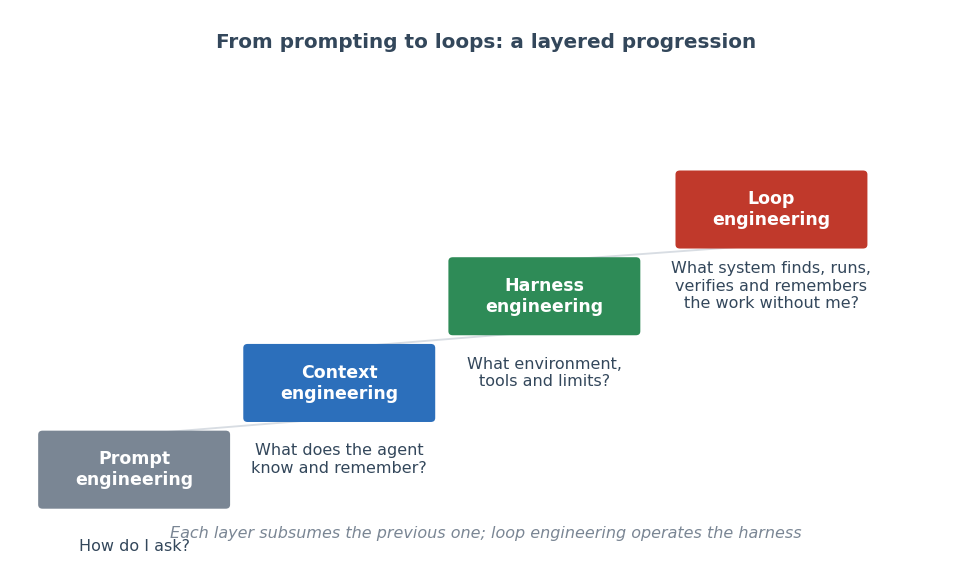
두 arXiv 논문 모두 루프 엔지니어링을 같은 자리에 놓는다. 관심 단위가 한 개의 지시(프롬프트) → 한 번의 모델 호출이 보는 것 전부(컨텍스트) → 한 번의 에이전트 실행을 감싸는 구조(하네스) → 반복되는 실행들(루프) 로 올라왔다는 것이다. Lulla 등(arXiv 2608.21884)의 Table 1을 옮기면 다음과 같다.
| 층 | 관심 단위 | 대표 산출물 |
|---|---|---|
| 프롬프트 엔지니어링 | 지시 하나 | 프롬프트, 템플릿 |
| 컨텍스트 엔지니어링 | 모델 호출 하나 | AGENTS.md, CLAUDE.md, rules |
| 하네스 엔지니어링 | 에이전트 실행 하나 | 스킬, 서브에이전트, 훅, MCP 설정 |
| 루프 엔지니어링 | 반복되는 실행들 | 스케줄, 종료 조건, 상태 파일, 실행 로그, 예산, 검증자 에이전트 |
여기서 하네스와 루프의 경계가 중요하다. Harness Engineering 논문(arXiv 2609.00006, 11개 코딩 에이전트 소스코드 연구)은 "에이전트 = 모델 + 하네스"이고 하네스는 "모델을 제외한 전부, 즉 루프·도구·컨텍스트·안전 제어·오케스트레이션·확장 표면으로 LLM을 세계에 결합하는 런타임"이라고 정의한다. 그리고 루프 엔지니어링과의 관계를 이렇게 정리한다. 하네스 엔지니어링은 안쪽의 행동-관찰 사이클을 만들고, 루프 엔지니어링은 그 사이클을 바깥에서 조합해 사람이 매 턴을 쓰지 않아도 프롬프트하고, 검증하고, 다시 실행하는 외부 루프를 만든다. 같은 논문은 두 분야의 이음매가 이미 코드에 보인다고 한다. OpenHands의 /goal 엔드포인트는 끝난 실행마다 LLM 판정자를 돌려 재프롬프트하거나 멈추고, Hermes의 verify-on-stop 가드는 내부 루프의 종료를 거부한다. 둘 다 "안쪽 루프 바깥에 바깥 루프를 닫는 것" 외에는 목적이 없는 하네스 기능이다.
Macedo(arXiv 2607.00038)는 한 단어를 더 보탠다. 루프 엔지니어링의 대상은 루프 명세(loop specification) 이고, 이는 (1) 프로그래밍 언어의 루프와도, (2) 하네스가 배관으로 이미 제공하는 내부 perceive-act-observe 사이클과도 다른, "사람이 하네스에 건네는 경계 지어진 재사용 가능한 산출물"이라는 것이다.
이 블로그에서 하네스 쪽은 여러 번 다뤘다. Effective harnesses for long-running agents는 사람이 하네스(진행 파일, git 상태, 초기화 에이전트)를 설계하는 이야기였고, Raven: 하네스의 하네스는 모델-하네스 쌍을 조합하는 이야기였다. 루프 엔지니어링은 그 하네스를 언제, 몇 번, 어떤 종료 조건으로 돌리느냐에 관한 층이다.
🔍 원조: Ralph Wiggum 루프, bash 한 줄이 왜 통했는가
두 논문이 모두 기원으로 지목하는 것은 Geoffrey Huntley가 2025년 7월 14일 올린 "Ralph Wiggum as a software engineer"다. 원문의 정의는 이렇다. "Ralph는 기법이다. 가장 순수한 형태로 Ralph는 Bash 루프다."
while :; do cat PROMPT.md | claude-code ; done
Huntley 자신이 "결정론적으로 나쁜(deterministically bad) 기법을 비결정론적 세계에서 쓴다"고 표현했는데, 원문에서 읽히는 작동 원리는 세 가지다.
- 컨텍스트 리셋이 기본값이다. 매 반복마다 새 프로세스가 뜨므로 컨텍스트 윈도우는 항상 비어 있다. Huntley는 "약 170k 컨텍스트로 작업하므로 가능한 한 적게 써야 하며, 많이 쓸수록 결과가 나빠진다"고 쓰고, 그래서 "한 루프에 한 가지 일(one item per loop)" 을 반복해서 강조한다.
- 파일시스템이 상태다. 루프는 매번 같은 것을 "스택에 올린다": 계획(
@fix_plan.md)과 명세(specs/*). 진행 상황은 대화가 아니라 파일과 git에 남는다. Macedo 논문은 이를 "대화 이력을 버전 관리되는 산출물로 맞바꾼 가장 순수한 사례"라고 평한다. - 실패해도 다시 시작한다.
while :에는 종료 조건이 없다. 테스트·빌드·정적 분석이 "백프레셔(backpressure)"로 잘못된 생성을 거부하고, 다음 반복이 다시 시도한다. Huntley는 "바퀴가 빨리 돌아야 한다"며, 동적 타입 언어라면 타입 체커를 반드시 백프레셔로 끼우라고 한다.
Lulla 등은 Ralph를 "두 번째 수준", 즉 단일 실행 내 반복(에이전트 루프)에 재실행과 실행 간 상태를 더한 첫 사례로 분류한다. 그리고 벤더가 이를 흡수한 순서를 Orosz의 조사(2026-07-14)를 인용해 적는다. Claude Code가 2026년 3월 /loop을, Codex가 4월 기계 검사 가능한 완료 조건을 가진 goal 객체를, Claude Code·Hermes 등이 5월 /goal을 추가했다. 이 타임라인은 논문이 Orosz 뉴스레터를 인용한 것이므로 "논문이 전한 바"로 읽는 것이 정확하다.
📐 구성 요소: 트리거 / 작업 단위 / 검증자 / 종료 규칙 / 가드레일
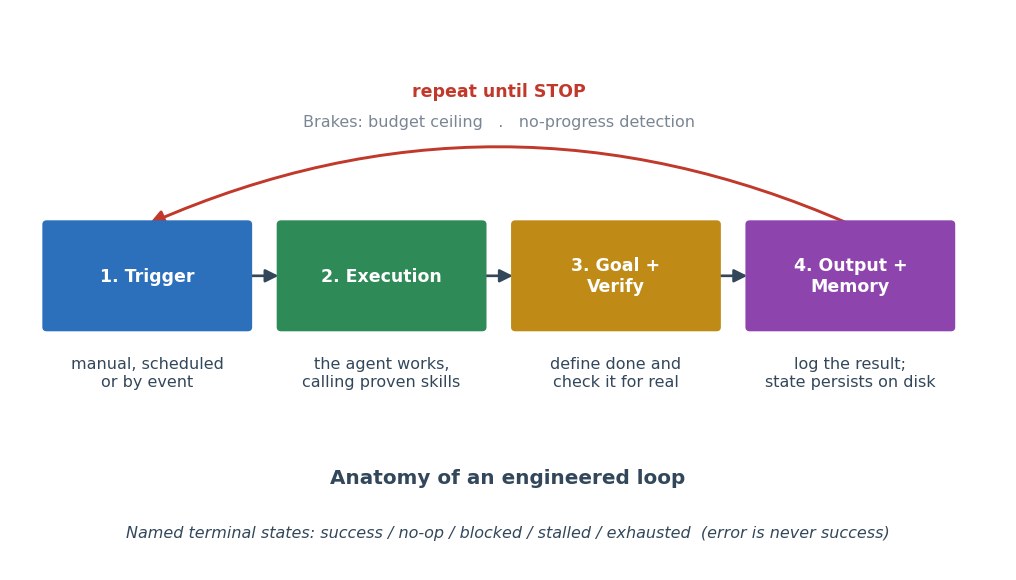
Lulla 등은 회색 문헌 11건을 검토한 뒤 "정의는 다투지만 구성 요소는 출처 간에 일치한다"(관찰 O3)고 정리하고 작업 정의를 내린다.
루프 엔지니어링은 코딩 에이전트를 반복 호출하는 자동 제어 구조를 설계하는 실천이다. 스케줄이나 이벤트로 트리거되고, 각 실행은 기계가 검사할 수 있는 종료 조건으로 경계 지어진다. 잘 설계된 루프는 실행 간 상태를 보존하고, 구현 에이전트와 독립적으로 결과를 검증하고, 추론 비용을 제한하고, 무인 실행이 승인 없이 바꿀 수 있는 범위를 제한하고, 사람이 개입할 시점을 정의한다.
이를 다섯 가지로 묶어 보면 다음과 같다.
1. 트리거. 스케줄(cron) 또는 이벤트(이슈 열림, 빌드 실패, PR 열림). Lulla 등이 Orosz 스레드에서 인용한 반론이 핵심을 찌른다. "스케줄된 에이전트 실행은 여전히 워크플로다. 한 반복의 결과가 다음 반복으로 전달되는 명시적 피드백 신호가 있을 때만 루프가 된다." Macedo의 sandeco-loop 스킬은 아예 첫 질문으로 이를 묻는다. "각 턴의 결과가 다음 행동을 바꾸는가? 아니면 루프가 아니라 예약된 프롬프트일 뿐이다."
2. 작업 단위와 상태. Huntley의 "한 루프에 한 가지", Osmani의 "에이전트는 잊지만 저장소는 잊지 않는다(the agent forgets, the repo doesn't)". 상태는 대화가 아니라 디스크(마크다운, 이슈 트래커, git)에 둔다.
3. 검증자, 그리고 "검증이 병목"이라는 주장. 모든 출처가 가장 강조하는 요소다. Osmani는 "믿을 수 있는 검증자가 자리를 뜰 수 있는 유일한 이유"라고 쓰고, Lindenberg는 "루프는 당신이 쓴 게이트를 만족시키지, 그 뒤의 목표를 만족시키지 않는다"고 경고한다(둘 다 Lulla 등이 인용). Macedo는 한 발 더 나가 "이 분야의 중심 기술은 프롬프트가 아니라 검사(the check)"라고 결론 짓는다. 이 블로그의 직무 분리(Planner / Policy Gate / Executor / Auditor) 글이 보안 관점에서 다룬 "만드는 역할과 검사하는 역할의 분리"가 여기서는 루프가 멈출 수 있는 조건 그 자체가 된다.
4. 종료 규칙. Macedo는 종료 상태에 이름을 붙이라고 한다. success / no-op / blocked / stalled / exhausted. 핵심 규칙은 "오류나 소진된 예산을 절대 성공으로 세지 않는다." 종료는 발명된 숫자가 아니라 목표 달성, 정체 감지기, 예산 상한 중 하나여야 한다.
5. 가드레일. 샌드박스, 스코프된 자격증명, 예산, 그리고 "킬 스위치". Macedo 논문은 "무인으로 루프를 돌리는 것은 무인으로 틀리는 것이기도 하다"며 문서화된 완화책으로 네트워크 없는 격리 컨테이너, 테스트/스테이징으로 범위를 좁힌 자격증명, 빡빡한 예산 상한을 든다. 격리 쪽 도구는 bubblewrap부터 gVisor까지 글에서 정리했다.
LangChain의 4층과 arXiv 논문의 building blocks 대조
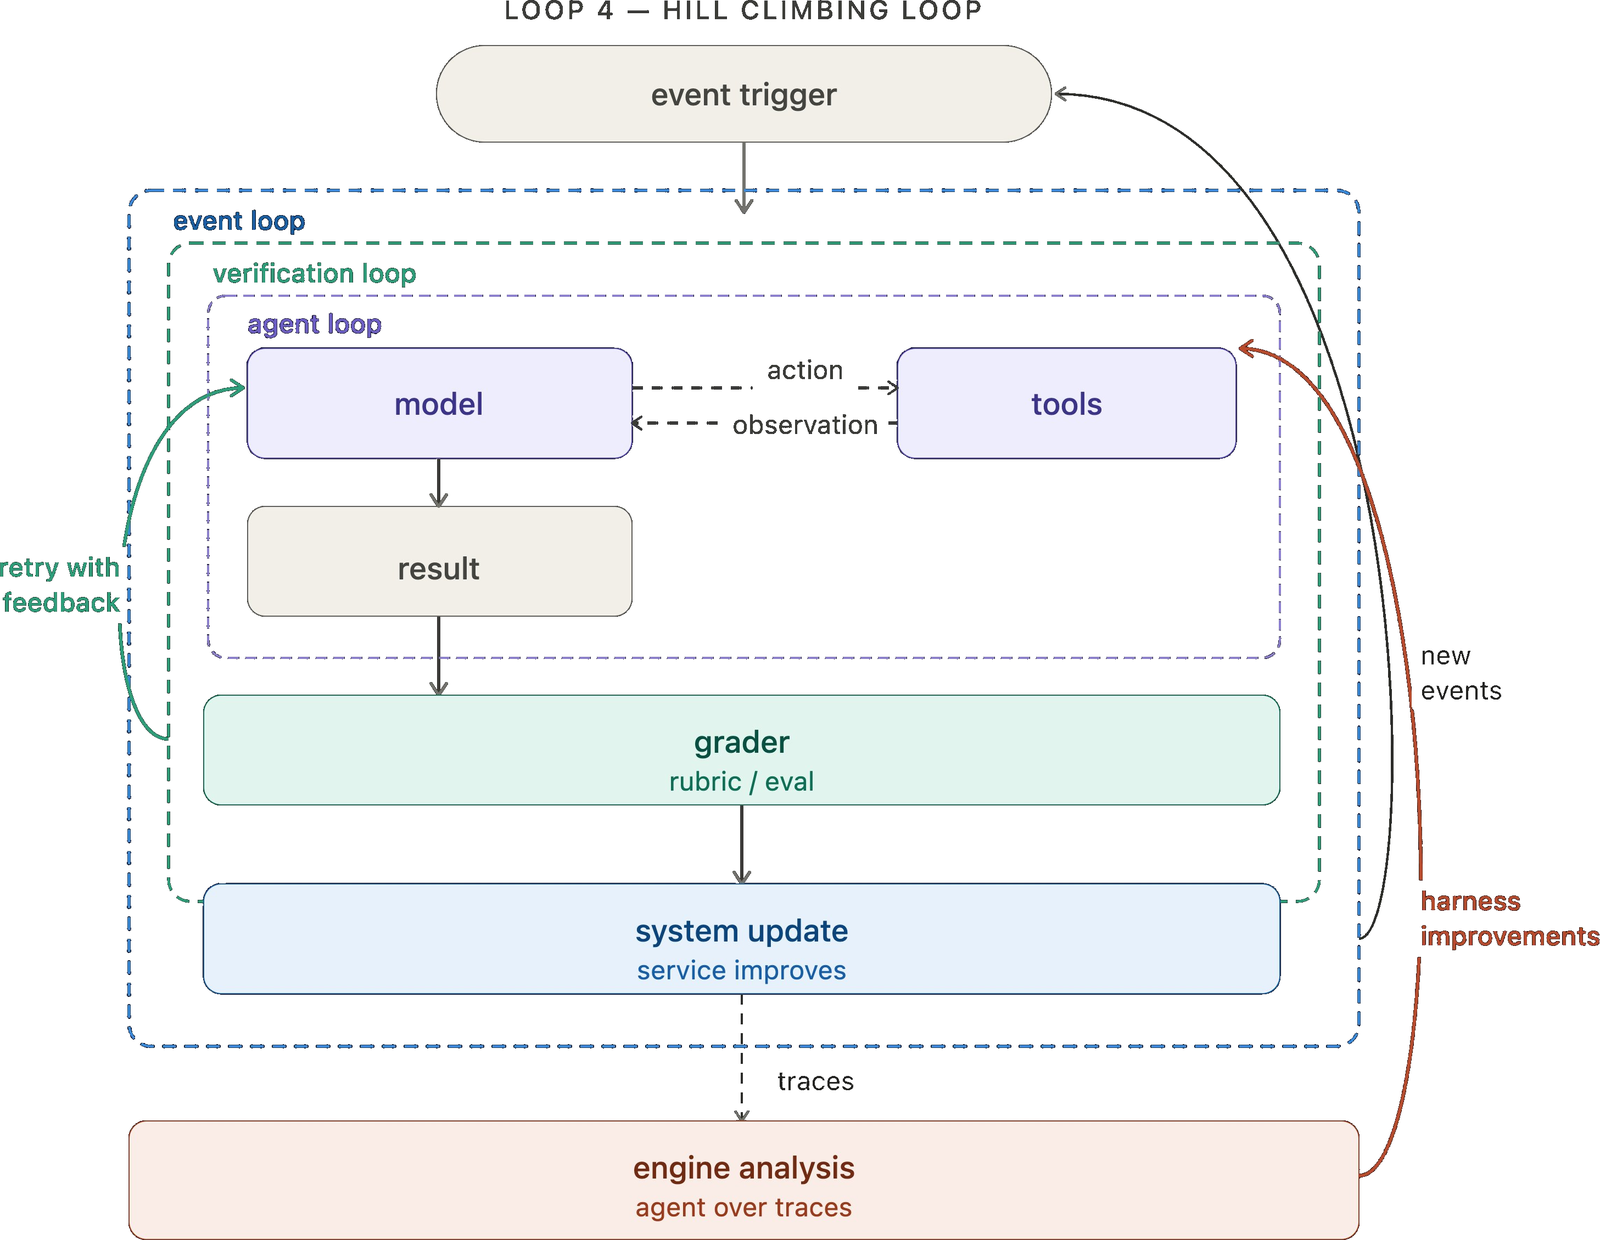
LangChain의 Sydney Runkle이 쓴 "The Art of Loop Engineering"(2026-06-16)은 같은 현상을 중첩된 네 루프로 본다. 원문 표의 이름 그대로 (1) Agent loop, (2) Verification loop, (3) Event driven loop, (4) Hill climbing loop다. 그림에서 보듯 핵심은 4번째 루프의 되돌아가는 화살표가 "맨 위로 돌아가는 것이 아니라 안쪽으로 손을 뻗어 에이전트 루프 자체를 고친다"는 점이다. 두 arXiv 논문의 구성 요소와 맞대면 다음과 같다.
| LangChain 4층 | 무엇을 하나 (원문) | Lulla 등의 building block | Macedo의 anatomy | 하네스 vs 루프 |
|---|---|---|---|---|
| 1. Agent loop | 모델이 도구를 반복 호출해 과제를 끝낸다 | (범위 밖: 하네스 층의 "agent loop") | 2. Execution | 하네스 (내부 사이클) |
| 2. Verification loop | 출력을 루브릭으로 채점, 실패 시 피드백과 함께 재시도 | Verification (maker/checker), Goal & stop conditions | 3. Goal + Verify, 종료 상태 | 경계 (OpenHands /goal, Hermes verify-on-stop) |
| 3. Event driven loop | 이벤트·스케줄·웹훅이 실행을 시작 | Triggering & scheduling, State & memory, Human oversight | 1. Trigger, 4. Output + Memory | 루프 |
| 4. Hill climbing loop | 트레이스를 분석해 하네스 설정을 개선 | (Lulla 등의 목록에는 없음) | (없음; "자기 진화 에이전트"로 향후 과제) | 루프가 하네스를 수정 |
4층은 두 논문의 정의 밖에 있다. 그리고 바로 이 층이 이 블로그의 RRSI 글이 다룬 문제와 직결된다. 하네스를 LLM이 반복 편집하는 "hill-climbing"은 진화 세트에 과적합되기 쉽고, RRSI는 그걸 막으려고 편집 예산 감소·정체 시 탐험·누수 비평가 선별 같은 정규화를 넣었다. LangChain 글은 4번째 루프를 "가장 중요한 루프"라 부르지만, 그 루프가 무엇에 과적합되는지는 다루지 않는다.
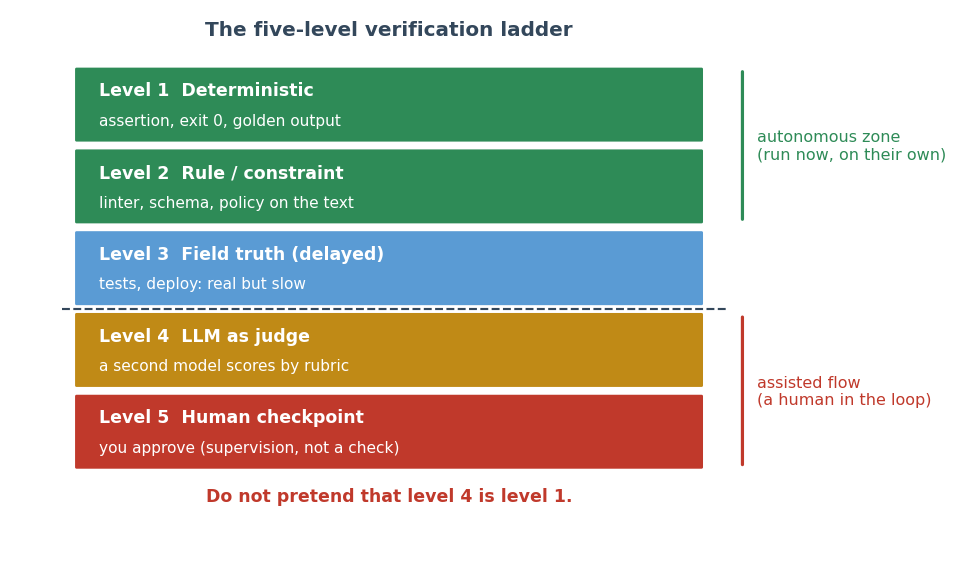
검증자에 관해 Macedo가 제안한 5단계 검증 사다리는 실무에서 바로 쓸 만하다. Level 1 결정론적(assert, exit code), Level 2 규칙(린터, 스키마), Level 3 지연된 현장 진실(테스트, 배포), Level 4 모델 판정, Level 5 사람 체크포인트. 12가 "자율 구역", 45는 "보조 흐름"이다. 논문의 메시지는 정직함의 규율이다. "Level 4를 Level 1인 척하지 마라. 루프는 검증자가 실제로 앉아 있는 단계만큼만 자율적이다. Level 4가 불가피하면 다른 모델이 판정해야지, 같은 에이전트가 자신을 승인해서는 안 된다."
🛠️ 실제 도구: Claude Code /loop·/goal, Codex /goal
아래는 각 도구의 공식 문서(code.claude.com/docs, developers.openai.com/codex)에서 확인한 범위만 적은 것이다.
Claude Code /loop: 간격 기반 재실행
/loop은 세션이 열려 있는 동안 프롬프트를 반복 실행하는 번들 스킬이다. 간격과 프롬프트가 모두 선택 사항이며 무엇을 주느냐에 따라 동작이 갈린다.
| 입력 | 예 | 동작 |
|---|---|---|
| 간격 + 프롬프트 | /loop 5m check the deploy |
cron 표현식으로 변환해 고정 간격으로 실행 |
| 프롬프트만 | /loop check the deploy |
매 반복 후 Claude가 1분~1시간 사이 간격을 스스로 고름 (self-paced) |
| 간격만 또는 없음 | /loop |
내장 유지보수 프롬프트, 또는 .claude/loop.md가 있으면 그것 |
문서가 명시한 경계도 중요하다. 세션 범위이고 Claude가 idle일 때만 발화하며, 반복 태스크는 생성 7일 후 자동 만료된다("잊힌 루프가 얼마나 오래 돌 수 있는지를 제한한다"). self-paced 모드에서는 Claude가 작업이 끝났다고 판단하면 ScheduleWakeup에 stop: true를 보내 스스로 멈출 수 있고, 반복이 재예약도 중지도 하지 않으면 약 20분 뒤 한 번 더 깨운 뒤 종료한다. 즉 /loop은 트리거(시간) 를 담당하고, 종료 조건은 사용자 또는 Claude의 판단에 맡긴다.
Claude Code /goal: 조건 기반 반복
/goal은 완료 조건을 걸어두고 매 턴이 끝날 때마다 모델이 조건 충족 여부를 판정하게 한다. 공식 문서의 비교표를 옮긴다.
| 방식 | 다음 턴이 시작되는 때 | 멈추는 때 |
|---|---|---|
/goal |
이전 턴이 끝날 때 | 모델이 조건 충족 또는 불가능으로 판정, 고쳐야 할 오류, /goal clear |
/loop |
시간 간격이 지날 때 | 사용자가 중지, 또는 Claude가 끝났다고 판단 |
| Stop hook | 이전 턴이 끝날 때 | 사용자의 스크립트/프롬프트가 결정 |
문서에 따르면 /goal은 세션 범위의 프롬프트 기반 Stop hook을 감싼 것이고, 판정은 설정된 "small fast model"이 한다. 판정 결과는 Not yet met / Met / Impossible 셋 중 하나다. 두 가지 제약이 루프 설계에 직접 영향을 준다. 첫째, 판정자는 명령을 실행하거나 파일을 읽지 않고 대화에 드러난 것만 본다. 그래서 조건은 "npm test가 0으로 종료" 같이 에이전트의 출력이 증명할 수 있는 형태여야 한다. 둘째, 도구 호출 없이 여러 턴을 보내면 루프를 멈추고 제어를 돌려준다(정체 감지). 조건은 4,000자까지이고 or stop after 20 turns 같은 절을 넣어 예산을 걸 수 있다. 헤드리스로도 돈다.
claude -p "/goal CHANGELOG.md has an entry for every PR merged this week"
Osmani가 "코드를 쓴 모델이 아니라 새 모델이 끝났는지 결정한다. maker/checker 분리를 종료 조건 자체에 적용한 것"이라고 평한 지점이 이것이다.
Codex /goal과 Scheduled tasks
Codex 문서의 /goal은 "Codex가 추적할 지속적인 목표"를 세우는 명령이다. /goal <objective>로 설정하고 /goal edit, /goal pause, /goal resume, /goal clear가 있으며, 목표 텍스트는 4,000자 이내로 "첫 프롬프트이자 완료 기준" 이 된다. 앱 서버 프로토콜에는 thread/goal/set|get|clear가 있다. 문서는 목표에 결과(outcome)·제약(constraints)·검증(verification) 세 요소를 넣으라고 안내한다. 반복 트리거 쪽은 ChatGPT/Codex의 Scheduled tasks가 담당하며, "무인으로 실행되고 기본 샌드박스 설정을 쓴다"고 명시되어 있고 실행 위치로 프로젝트 디렉터리 또는 격리된 worktree를 고를 수 있다. Lulla 등이 "기계 검사 가능한 완료 조건을 가진 goal 객체"라고 쓴 부분의 판정 메커니즘은 Codex 공식 문서에서 Claude Code만큼 구체적으로 확인하지 못했으므로 여기서는 범위를 그 정도로 둔다.
직접 짜는 경우: Ralph 루프에 종료 조건 달기
도구가 없어도 Ralph 루프에 종료 규칙·예산·상태 파일을 달면 위 정의의 최소 형태가 된다. 아래는 이 글에서 직접 쓴 예시(공식 도구의 기능이 아님)다.
#!/usr/bin/env bash
# 종료 상태: success(검증 통과) / exhausted(예산 소진) / stalled(정체)
MAX=20; STALL=3; n=0; same=0; last=""
while :; do
  n=$((n+1)); [ "$n" -gt "$MAX" ] && { echo exhausted; exit 2; }
  cat PROMPT.md | claude -p --dangerously-skip-permissions   # 매번 새 컨텍스트
  if npm test >/dev/null 2>&1 && npm run lint >/dev/null 2>&1; then
    echo success; exit 0                                      # Level 1 검증자
  fi
  cur=$(git rev-parse HEAD)                                   # 상태는 git에
  [ "$cur" = "$last" ] && same=$((same+1)) || same=0
  [ "$same" -ge "$STALL" ] && { echo stalled; exit 3; }
  last="$cur"
done
검증자는 테스트·린트(Level 1), 종료 상태는 세 개에 이름이 붙어 있고, 오류가 성공으로 집계되지 않는다. 여기에 샌드박스(네트워크 차단, 스테이징 자격증명)를 두르는 것이 가드레일이다. 자격증명이 넓다면 이 루프를 무인으로 돌리면 안 된다.
📊 반론과 한계
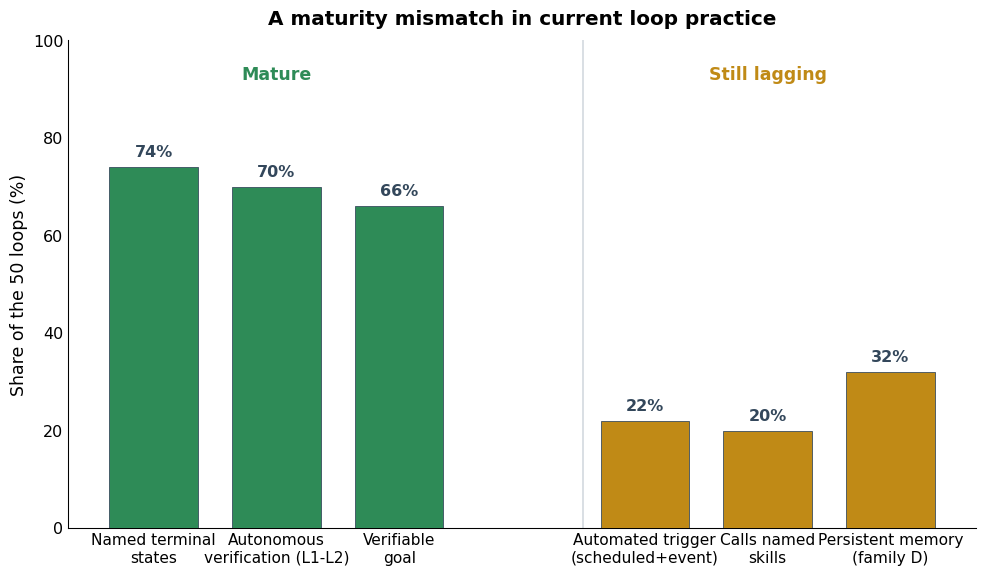
"리뷰 가능한 근거 없이 퍼진 개념." Lulla 등의 결론은 직설적이다. "회색 문헌 검토는 안정된 어휘와, 그 실천의 가치 주장에 대한 거의 완전한 증거 부재를 함께 발견했다." 큰 숫자들은 전부 자기 보고다. Stripe 엔지니어가 팟캐스트에서 말한 내부 "Minions" 시스템의 주당 약 1,300개 PR, Osmani가 전한 Firefox 대상 루프의 한 달 423건 보안 수정. 논문은 "이 숫자를 뒷받침하는 공개 연구나 데이터셋을 알지 못한다"고 적는다. 게다가 구성 요소에 대한 "합의"조차 독립적이지 않다. Greyling의 저장소와 HuaShu의 종합 노트는 Osmani 글을 명시적으로 기반으로 하고 Lindenberg도 같은 시드 포스트를 인용하므로 "합의의 상당 부분은 하나의 기원으로 거슬러 올라간다."
실제 채택은 얼마나 될까. 같은 논문의 마이닝 연구가 첫 데이터다. 2026년 8월 19일 36,710개 저장소를 스캔해 256개 후보를 전수 검사한 결과 217개(0.59%)에서 자율 에이전트 루프 운영을 확인했다. 그런데 그 내용은 담론과 다르다. 180개는 이벤트 트리거만(대부분 자동 PR 리뷰), 21개는 스케줄만(대부분 이슈 트리아지), 15개는 둘 다. 도구별로는 Claude Code가 189개로 압도적이다. 그리고 담론이 처방하는 상태 파일(STATE.md, LOOP.md), 예산 파일, 루프가 참조하는 검증자 서브에이전트, 측정값이 있는 비용 로그는 사실상 0건이었다. 저자들의 해석은 이렇다. PR 리뷰 루프는 보존할 상태가 없고, 트리아지 루프는 이슈 트래커가 이미 상태를 들고 있다. 즉 "실행 간 상태"라는 처방은 현장의 루프 대부분에 해당하지 않았다. Macedo의 50개 루프 카탈로그 분석(위 그림)도 반대 방향 표본에서 비슷한 결론에 닿는다. 종료 상태 명명(74%)과 자율 검증(70%)은 성숙했지만 자동 트리거는 22%, 영속 메모리는 32% 에 그친다. "끝났는지 어떻게 아는가"는 풀었고 "나 없이 어떻게 도는가"는 못 풀었다는 것이다.
"이름만 바꾼 cron job." Lulla 등의 관찰 O2는 신규성 논쟁을 요약한다. Orosz가 약 210개 실무자 답변을 모아 내린 결론은 구체적 사례 대부분이 cron job과 이벤트 트리거 두 가지로 떨어진다는 것이었고, 한 댓글은 "퍼지한 워커(fuzzy worker)를 단 이벤트 기반 아키텍처"라고 했다. 다만 그 댓글의 요지는 기각이 아니다. 새로운 것은 비결정론적 워커이고, 그래서 엔지니어링은 트리거가 아니라 그 주변의 가드레일로 옮겨간다. Andrew Ng은 2026년 6월 26일 The Batch에서 "루프 엔지니어링은 뜨거운 유행어(a hot buzzphrase)"라고 쓰면서도, 자신은 분 단위의 에이전틱 코딩 루프, 시간 단위의 개발자 피드백 루프, 일 단위의 외부 피드백 루프 세 개로 본다고 했다. 그가 강조한 것은 두 번째 루프는 자동화할 수 없다는 점이다. 사람이 AI보다 "컨텍스트 우위(context advantage)"를 가지는 한 그 지식을 주입할 human-in-the-loop가 필요하다.
무인 루프 = 무인 실수. Osmani 자신이 가장 길게 쓴 부분이 한계다. "무인으로 돌아가는 루프는 무인으로 실수하는 루프이기도 하다... '끝났다'는 주장이지 증명이 아니다." 그는 두 위험에 이름을 붙였다. comprehension debt(루프가 빨라질수록 저장소에 있는 것과 내가 이해하는 것의 간극이 커진다), cognitive surrender(루프를 더 빨리 가기 위해서가 아니라 생각을 피하기 위해 쓰는 것). Lulla 등은 Orosz 스레드에서 실무의 병목을 하나 더 꺼낸다. 야간 루프가 팀이 리뷰할 수 있는 것보다 많은 PR을 열면 "리뷰됨"이라는 가드레일 자체가 물량에 무너지고, 사람 게이트는 "고무 도장"이 되는데 "파이프라인은 여전히 녹색을 보고한다." 비용 쪽 사례로는 CI 고치기 루프가 48시간에 약 800만 토큰을 쓴 경험담이 Greyling의 저장소에 기록되어 있다.
같은 모델이 자기 결과를 채점하는 문제. Macedo 논문의 안티패턴 "Verifier theater"가 이것이다. "결정론적 검사의 확신으로 보고하지만 실제로는 모델의 의견에 의존하는 루프." 논문은 생성자와 판정자가 같은 모델일 때 보상 해킹이 자발적으로 일어나 점수는 오르고 실제 품질은 정체하거나 떨어진다는 문헌을 들고, 해법은 maker와 checker의 공유 컨텍스트를 끊는 것이라고 한다. 이 블로그의 Jev 글에서 다룬 Penn 논문의 결론, LLM 판정자는 "더 싸고 빠르지만 같은 곳에서 틀린다"는 결과를 떠올리면 Level 4 판정자를 둘 두는 것만으로 충분한지도 의문이다. 다른 모델, 다른 컨텍스트, 그리고 가능하면 Level 1~3의 객관적 검사가 먼저다.
💡 정리: 언제 루프를 쓰고, 언제 쓰지 말아야 하는가
Macedo의 "요소당 한 질문" 체크리스트와 Osmani의 자율성 원칙("에이전트에 허용하는 자율성은 당신이 싸게 검증할 수 있는 수준이다", 2026-07-25 LinkedIn)을 합치면 다음과 같다.
| 질문 | 예라면 | 아니오라면 |
|---|---|---|
| 각 턴의 결과가 다음 행동을 바꾸는가? | 루프 | 예약된 일회성 프롬프트(/loop 5m이나 cron)면 충분 |
| 검증자가 Level 1~3(exit code, 린터, 테스트)에 실제로 앉아 있는가? | 무인 실행 가능 | Level 4(모델 판정)면 다른 모델·다른 컨텍스트로 하드닝, Level 5면 사람이 봐야 하므로 "자율 루프"가 아니다 |
| 만드는 쪽과 검사하는 쪽이 분리되어 있는가? | 계속 | 같은 에이전트의 자기 승인은 verifier theater |
| 종료 상태에 이름(success / no-op / blocked / stalled / exhausted)이 있고, 오류가 성공으로 집계되지 않는가? | 계속 | while :는 예산 소진까지 돈다 |
| 예산 상한과 정체 감지가 있는가? | 계속 | 48시간 800만 토큰 사례를 기억할 것 |
| 상태가 디스크/트래커에 큐레이션되어 보존되는가? | 긴 작업에 적합 | PR 리뷰처럼 상태가 없는 작업이면 굳이 상태 파일을 만들 필요 없음(마이닝 결과) |
| 루프가 만드는 출력량을 누군가 읽을 수 있는가? | 계속 | "이미 출력을 읽는 데 돈을 받는 사람이 있는 루프만 살아남는다" |
| 샌드박스·스코프된 자격증명·킬 스위치가 있는가? | 무인 가능 | 무인 금지 |
Lulla 등의 마지막 관찰이 이 글의 결론으로도 적당하다. 명시적 루프 설계는 도구가 /loop, /goal로 흡수하면서 과도기적일 수 있지만, "비결정론적 워커를 검증·예산·에스컬레이션으로 경계 짓는다"는 설계 문제는 도구가 흡수한다고 사라지지 않는다. 그리고 그 논문이 제안한 RQ3 통제 실험(대화형 vs 목표 기반 vs 스케줄 루프, 같은 과제, 같은 에이전트)이 끝나기 전까지 "루프가 더 생산적이다"는 주장은 일화다. 그 사이 Steinberger는 7월 17일 "아직 루프 얘기인가, 그래프로 넘어갔나"를 물었고, 논문은 "용어가 정착되기를 기다리면 실천이 형성되는 동안 연구하지 못한다"고 답했다. 용어가 무엇이 되든, 스케줄되고 검증되고 상태를 나르는 에이전트 실행은 이미 돌고 있다. 0.59%에서.
📚 참고
- Jai Lal Lulla, Vahram Nersesyan, Seyedmoein Mohsenimofidi, Christoph Treude, Sebastian Baltes, Loop Engineering: Building Blocks, Adoption, and Impact (arXiv 2608.21884v2, 2026-08-26; JAWs@ASE 2026 under review)
- Sandeco Macedo, Stop Hand-Holding Your Coding Agent: Engineering the Loops that Replace Step-by-Step Prompting (arXiv 2607.00038, 2026-06-28)
- Harness Engineering: Anatomy, Architecture, and Evolution of Coding Agents — A Source-Code Study of Eleven Systems (arXiv 2609.00006, 2026)
- Addy Osmani, Loop Engineering (2026-06-07)
- Peter Steinberger, X post (2026-06-07) — 원문은 arXiv 2608.21884의 인용으로 확인
- Geoffrey Huntley, Ralph Wiggum as a "software engineer" (2025-07-14)
- Sydney Runkle, The Art of Loop Engineering (LangChain Blog, 2026-06-16)
- Andrew Ng, Loop Engineering: Three Key Loops for Building Great Software (The Batch, 2026-06-26)
- Claude Code 공식 문서: Run prompts on a schedule (/loop), Keep Claude working toward a goal (/goal)
- Codex 공식 문서: Long-running work / Goal mode, Scheduled tasks
- Gergely Orosz, What is "loop engineering?" (The Pragmatic Engineer, 2026-07-14; 이 글에서는 arXiv 2608.21884의 인용을 통해 참조)
본 글의 그림 1, 2, 4, 5는 arXiv 2607.00038 원문에서, 그림 3은 LangChain 블로그 원문에서 가져왔습니다.