ScholarEvolve: 실패 로그 대신 논문을 읽고 하네스를 진화시키는 에이전트
"실패 트레이스는 빠진 역량을 드러내 줄 수는 있지만, 그 역량을 만드는 데 필요한 기술까지 알려주지는 못한다." — 논문 1장
2026년 9월 30일, UCSB의 Jingbo Yang(Microsoft 인턴 기간 수행)과 Microsoft의 Kwei-Herng Lai, Xiaowen Wang, Yaar Harari, 그리고 Evgeniy Gabrilovich, Shiyu Chang이 Learning from Research: Toward Lifelong Agent Harness Evolution(arXiv 2609.40169)을 공개했다. 논문 안에서 프레임워크 이름은 ScholarEvolve다. 10월 22일 AI타임스가 "학술 논문 읽고 코드 수정하는 자가 진화 에이전트"로 소개하면서 국내에도 알려졌다.
이 블로그의 하네스 자기 개선 시리즈로 치면 다섯 번째쯤 된다. RRSI는 하네스가 스스로를 진화시킬 때 벤치마크 과적합을 막는 정규화였고, Harness²는 과제 수준과 하네싱 수준의 두 층 재귀였으며, Raven은 Skill Forge로 경험을 스킬로 굳히는 상위 하네스였다. 이들은 전부 에이전트 자신의 실행 트레이스에서 개선 제안을 뽑는다. ScholarEvolve는 제안의 원천을 바꾼다. 실패를 분석해 "무엇이 부족한가"까지만 뽑고, "어떻게 고칠 것인가"는 arXiv에서 논문을 검색해 읽고 가져온다. 루프 엔지니어링 글의 어휘로 말하면, 힐클라이밍 루프의 제안 분포에 "문헌 검색"을 끼워 넣은 것이다. Paper2Agent가 논문을 에이전트(MCP 서버)로 바꿨다면, 이 논문은 반대로 논문을 읽어 에이전트를 고친다. 저자들도 related work에서 Paper2Agent를 "출판된 방법을 바로 재사용 가능하게 만든" 선행 연구로 언급한다.
원문: https://arxiv.org/abs/2609.40169
🤔 문제: 실패 로그만 보는 메타 에이전트는 좁게 탐색한다
저자들은 최근의 하네스 진화 방법, 즉 코딩 에이전트가 실행 트레이스를 보고 하네스 코드를 고치고 평가하는 방식의 한계를 세 가지로 정리한다.
- 탐색의 제한(Limited exploration). 코드를 마음대로 고칠 권한을 줘도 실제 수정은 좁은 범위의 국소 편집에 머문다. 검증 라운드나 다중 제안 같은 워크플로 변경만 반복하면서 다른 메커니즘은 손대지 않는다. Figure 1 왼쪽이 그 예로, 도구 호출 오류를 막으려 검증자를 추가했더니 필요한 호출까지 막아버린다.
- 설계 지식의 제한(Limited design knowledge). 메타 에이전트가 제안하는 메커니즘은 백본 모델의 지식과 추론 능력에 묶인다.
- 지연된 적응(Delayed adaptation). 트레이스 기반 진화는 이미 겪은 상황에서만 증거를 얻는다. 배포 환경에서는 약점이 사용자에게 먼저 노출된 뒤에야 고칠 근거가 쌓인다.
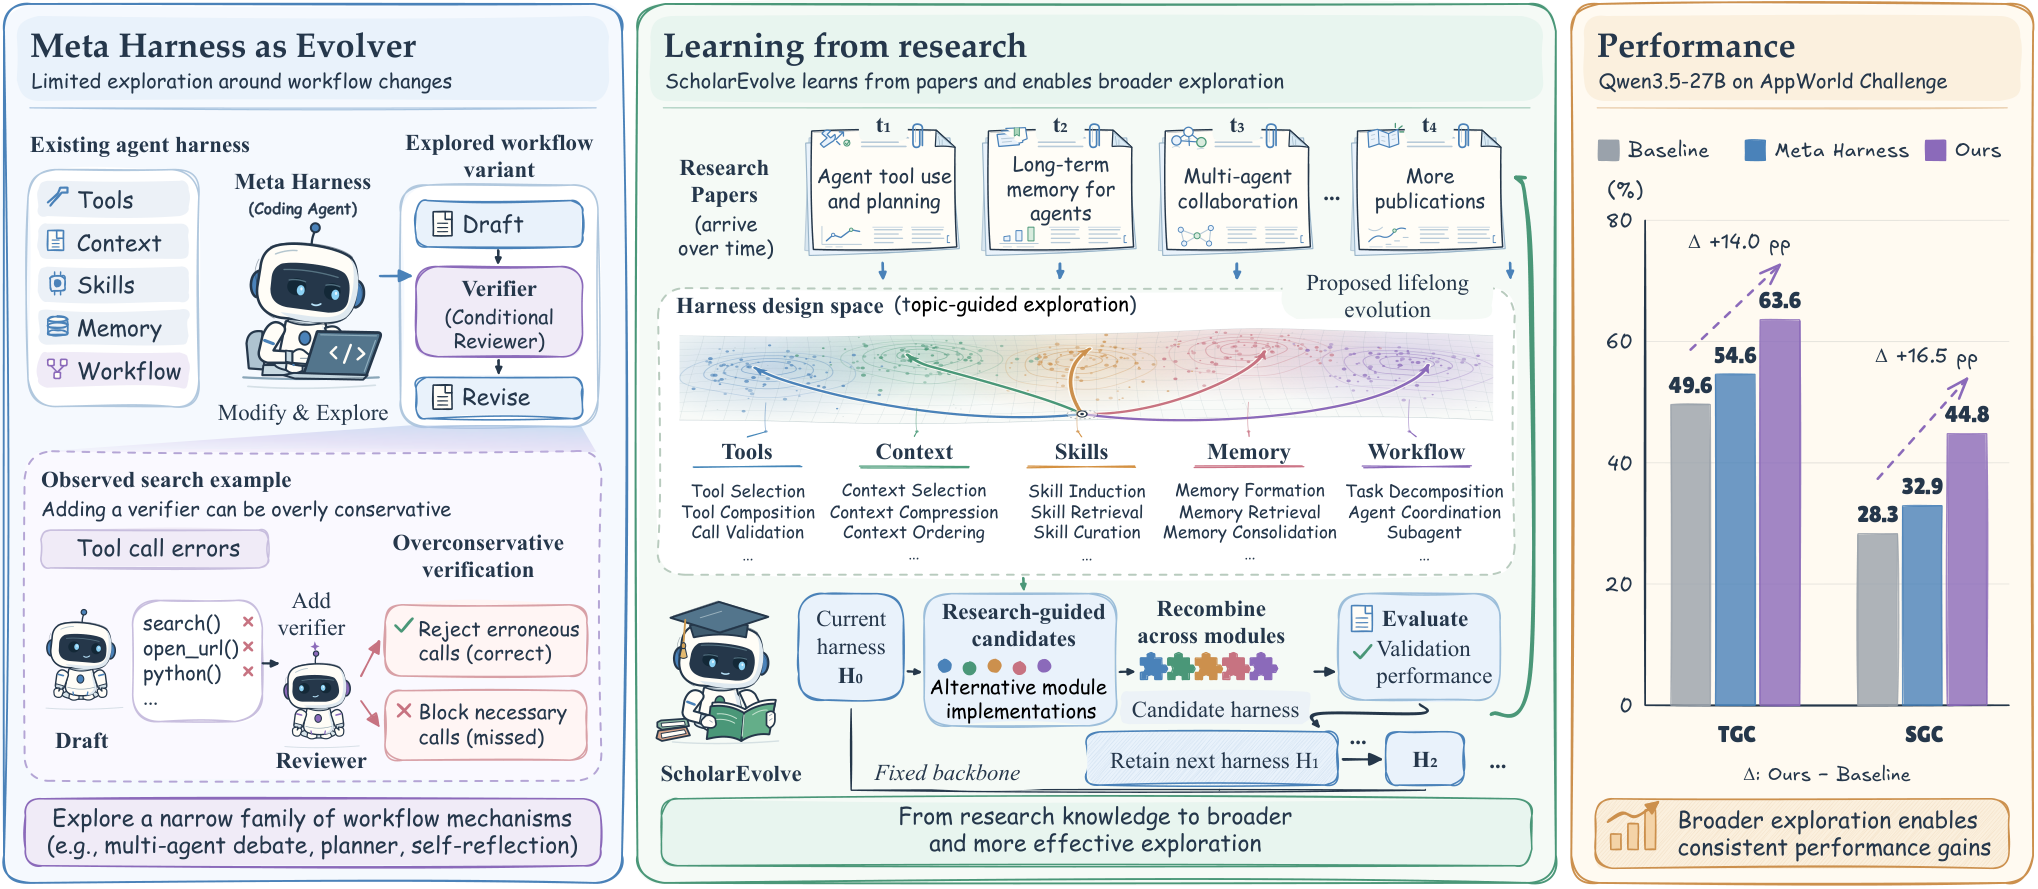
이에 대한 답이 "경험 많은 연구자라면 어떻게 하겠는가"다. 연구자는 비슷한 문제를 남들이 어떻게 풀었는지 문헌에서 찾아 자기 설정에 맞게 옮긴다. ScholarEvolve는 그 관행을 자동화해 세 가지를 노린다. 모듈과 토픽으로 구조화된 탐색, 논문에 근거를 둔 제안, 그리고 새 논문이 나올 때마다 실패가 쌓이기 전에 먼저 후보를 평가하는 선제적 평생 진화다.
🧠 핵심 아이디어: 모듈 × 토픽으로 탐색 공간을 펼친다
논문은 에이전트를 고정된 백본 와 하네스 의 쌍으로 보고, 하네스를 다섯 모듈의 튜플 로 표현한다. 각 모듈은 정해진 인터페이스를 구현하며, 이 경계가 돌연변이의 개입 지점이자 교차(crossover)의 교환 지점이 된다.
| 모듈 | 책임 | 돌연변이 방향(논문 예시) |
|---|---|---|
| Tool interface | 가능한 행동을 노출하고 모델 제안을 실행 가능한 호출로 변환 | 도구 선택, 도구 조합, 호출 검증 |
| Context management | 지시·히스토리·메모리·스킬로 모델 입력을 조립 | 컨텍스트 선택, 압축, 순서 |
| Skills | 재사용 절차의 유도·검색·정리 | 성공 궤적에서 절차 추출, 적용 가능성으로 검색, 중복 통합 |
| Memories | 경험의 형성·검색·통합 | 에피소드 결과 기록, 유사 상황 회상, 관련 기록 병합 |
| Agentic workflows | 계획과 행동 생성의 조직 | 과제 분해, 에이전트 조정, 서브에이전트 위임 |
돌연변이는 한 번에 한 모듈만 바꾸고 나머지는 고정한다. 모듈끼리의 상호작용은 교차 단계에서 완성된 하네스를 통째로 평가해 처리한다.
두 번째 축이 토픽이다. 검색된 논문 풀에는 비슷한 메커니즘이 잔뜩 들어 있어서, 그대로 예산을 쓰면 탐색이 좁아지고 교차 때 충돌도 난다. 그래서 TopicGPT 방식의 프롬프트 기반 토픽 모델링으로 논문들을 "의미적으로 직교하는" 메커니즘 패밀리로 묶는다. 생성 단계에서 토픽을 만들고, 정제 단계에서 동의어·중복을 병합하고 지나치게 구체적인 것은 상위 메커니즘에 흡수시킨다(예: 데모 검색과 지식 검색은 "External Context Retrieval"로 통합). 이미 베이스 하네스나 백본이 갖고 있는 메커니즘은 걸러낸 뒤, 남은 클러스터를 크기순으로 정렬해 라운드 로빈으로 논문을 뽑는다. 예산 편이면 개 토픽을 커버하게 된다.
📐 파이프라인: 실패 감사에서 챔피언 채택까지
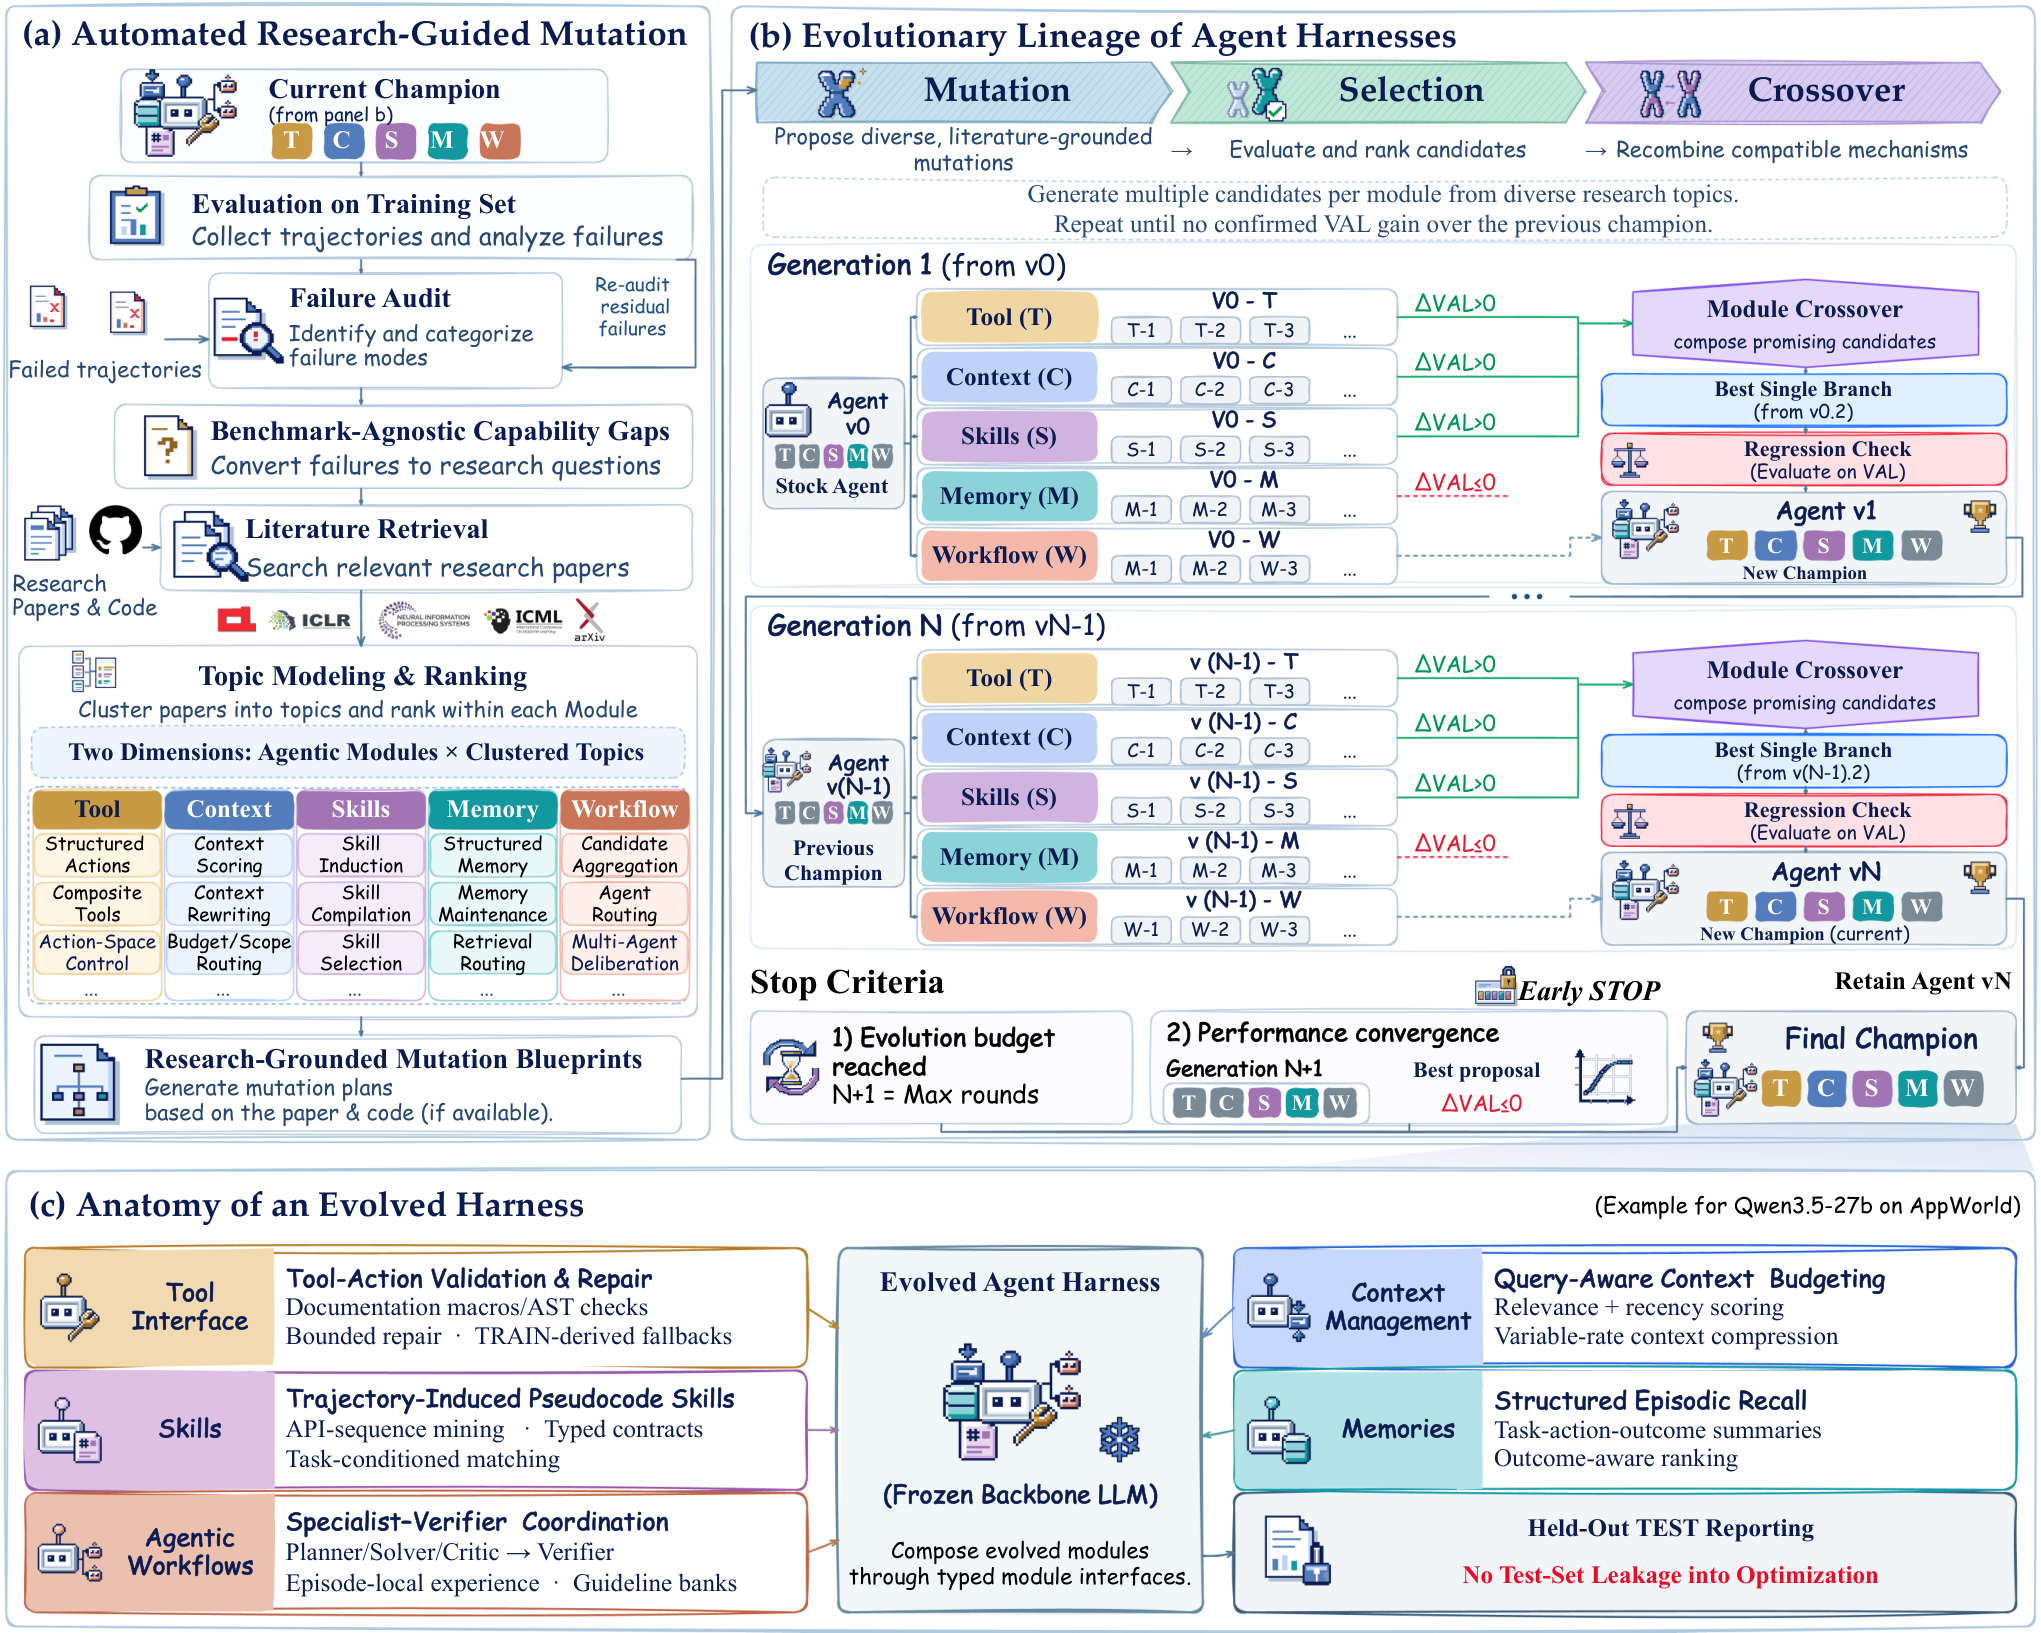
Figure 2(a)와 3.2~3.3절, 부록 C를 따라 한 세대의 흐름을 정리하면 이렇다.
1. 궤적 수집과 실패 감사(Failure audit). 현재 챔피언 하네스를 진화 세트 에서 돌린다. 감사자(auditor)가 실패 궤적을 에이전트 원인과 환경 원인으로 귀속하고, 반복되는 에이전트 귀속 실패를 근거 관찰·행동과 함께 남긴다.
2. 역량 격차 추상화(Capability gaps). 연구 모델이 벤치마크 특정 증거를 "추론 시점에 빠진 능력"으로 일반화한다. 이때 벤치마크 이름, 도메인 개체, 특정 도구·필드명은 연구 질문에서 제거한다. 예컨대 앞선 관찰을 놓치는 실패는 컨텍스트 선택, 상태 추적, 메모리 검색 연구로 이어진다.
3. 모듈별 쿼리와 검색(Retrieval). 다섯 모듈 각각에 대해 같은 브리프를 주고, 넓은 역량 쿼리와 좁은 메커니즘 쿼리 두 그룹을 만든다(예: context compression, trajectory retrieval, skill discovery). arXiv에서 제목·초록·소스 링크를 모으고 정규화된 제목으로 중복을 제거한다. 한 논문이 여러 모듈 풀에 들어갈 수 있다.
4. 토픽 모델링과 후보 할당. 위에서 설명한 대로 토픽을 만들고, 기존 메커니즘과 겹치는 토픽을 걸러낸 뒤 라운드 로빈으로 구현 예산을 배분한다. 토픽 설명, 병합 기록, 근거 발췌, 선별 결정이 모두 보존되어 출처 추적이 가능하다.
5. 논문 읽기와 청사진(Mutation blueprint). 연구 에이전트가 선택된 논문을 방법·부록까지 전문 읽고, 공식 코드가 있으면 함께 본다. 출력은 원 메커니즘과 가정, 대상 모듈과 인터페이스, 필요한 상태·아티팩트, 런타임 동작, 보조 모델 호출, 종료 조건을 명시한 청사진이다. 원 메커니즘과 호스트 하네스에 맞춘 적응을 분리해 적고 논문·토픽 출처를 남긴다.
6. 코딩 에이전트의 구현과 건강 검사(Health probes). 코딩 에이전트는 청사진, 현재 모듈 구현, 인터페이스, 환경의 행동 포맷을 받아 모듈 하나를 교체한 돌연변이를 만든다. 문헌에서 온 메커니즘은 인터페이스나 아티팩트 경계에서 깨지기 쉬우므로, 임포트 가능성·인터페이스 호환성·아티팩트 구축과 재적재·유효한 행동 생성을 가벼운 프로브로 검사하고, 통과할 때까지(혹은 수리 예산이 다할 때까지) 고친다. 스킬 라이브러리와 메모리 같은 영속 아티팩트는 궤적으로만 만들고 평가 중에는 동결한다.
7. 선택과 교차(Selection, crossover). 각 돌연변이를 검증 세트 에서 평가해 과제별 이득 를 구한다. 교차는 모듈당 하나의 구현을 고르는 것이며, 베이스 모듈을 유지하는 선택지도 포함된다. 조합은 가산적 예측 이득으로 순위를 매겨 후보를 줄이고, 후보 조합은 완성된 하네스로 실제 평가한다. 이것이 Figure 2(b)의 "regression check"다. 개별 모듈 점수는 상한과 상호작용 때문에 조합 성능을 예측하지 못하므로 실측이 필요하다.
8. 채택 규칙. 평가된 돌연변이와 교차 후보 중 검증 평균 보상이 최고인 것을 현재 챔피언과 과제 쌍 비교한다. 쌍 부트스트랩 이득 구간의 하한이 0보다 클 때만 새 챔피언으로 채택하고, 아니면 유지한다. 연속 세대 동안 확인된 개선이 없으면 수렴으로 보고 사이클을 끝낸다(본 실험에서는 ).
3.4절의 **평생 진화(Lifelong harness evolution)**는 여기에 "주기적 문헌 갱신"을 얹은 것이다. 이전 사이클이 수렴했어도 새 논문이 들어오면 챔피언에서 새 사이클을 시작하고, 토픽을 현재 메커니즘과 다시 대조한다. 논문은 "배포된 에이전트가 매달 최신 연구를 검토하고 유망한 업데이트를 검증 과제로 평가"하는 그림을 제시한다.
실제로 어떤 논문이 구현됐나
부록 D의 Table 7이 Qwen3.5-27B·AppWorld 탐색의 후보 20편(모듈당 4편, 각기 다른 토픽)을 전부 보여준다. 17편이 개발 세트 TGC를 올렸고 8편은 90% 구간이 0 위였으며, 3편은 급격히 떨어뜨려 최종 하네스에서 제외됐다. 최종 하네스에 들어간 다섯 편과 단독 이득(57개 개발 과제, 3회 실행)은 이렇다.
| 모듈 | 토픽 | 출처 논문 | 단독 TGC 이득 |
|---|---|---|---|
| Tool interface | Structured API Actions | ToolACE-R | +4.7 |
| Context | Budget and Scope Routing | Prompt compression limits (Nagle et al., 2024) | +7.0 |
| Skills | Skill Compilation | Skill-as-Pseudocode | +7.6 |
| Memories | Structured Memory Architecture | Oracle Agent Memory | +13.5 |
| Workflow | Multi-Agent Deliberation | TMAS | +9.4 |
반대편 극단도 흥미롭다. 컨텍스트 모듈의 Compression without MLPs(−45.6)와 ICPC(−43.3), 메모리 모듈의 CoEvo-Mem(−67.8, 50개 과제 중 승리 0)은 단독으로 하네스를 거의 망가뜨렸다. 논문을 읽고 구현한다고 다 좋아지는 게 아니라, 검증 세트의 실측 선택이 걸러낸다는 뜻이다. 같은 CoEvo-Mem이 GPT-5.4-mini의 AppWorld 하네스에서는 메모리 모듈로 채택됐다는 점(Table 8)도, 메커니즘의 가치가 백본에 따라 다름을 보여준다.
부록 C.1의 구현 설명을 보면 기사에 나온 사례들이 확인된다. 도구 인터페이스 돌연변이는 문서 조회 매크로를 실행 가능한 API 검사 호출로 확장하고, Python 행동을 추출해 구문과 문장 구조를 검사한 뒤 제한된 정규화와 문서 조회를 통한 복구를 지원한다(Figure 2(c)의 "AST checks"). 컨텍스트 돌연변이는 세그먼트를 과제 관련성과 최근성으로 점수 매겨 글자 예산을 분배하고, 쿼리 중심 발췌를 뽑은 뒤 시간순으로 복원한다. 스킬 돌연변이는 성공 궤적에서 반복되는 API 호출 부분열을 캐내어 입출력 필드·적용 단서·호출 순서·지지 횟수를 가진 의사코드 절차로 컴파일한다.
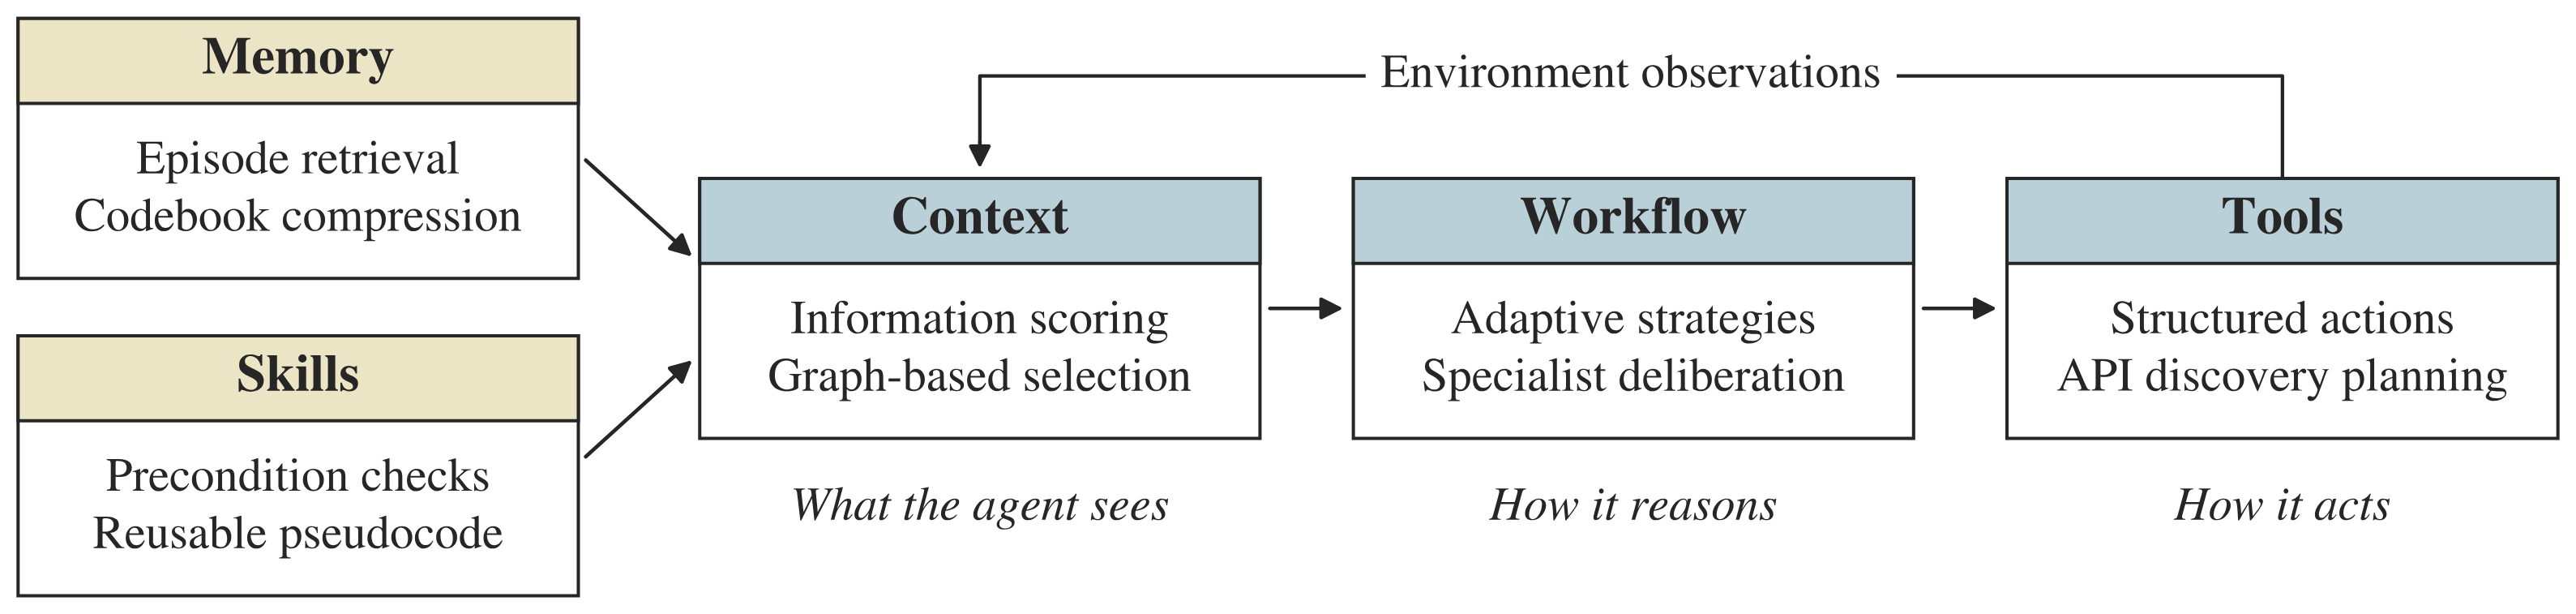
Figure 9는 Qwen 후보 풀의 대안들을 에이전트의 결정 사이클 위에 놓은 것이다. 컨텍스트 후보 둘은 하나는 정보량으로, 하나는 세그먼트 간 관계 그래프로 선택하고, 메모리 후보는 해결된 에피소드 요약을 검색하거나 경험을 유한 코드북으로 압축한다. 같은 모듈 안에서도 토픽이 다르면 메커니즘이 다르다는 것이 저자들이 강조하는 "직교 탐색"이다.
📊 실험: AppWorld와 τ²-Bench Telecom
세팅. AppWorld는 여러 앱의 API를 실행해 과제를 푸는 벤치마크로, 90개 학습 과제가 , 57개 개발 과제가 이며, 공식 Normal(168개)과 Challenge(417개) 테스트를 따로 보고한다. Challenge는 진화·검증 세트에 없는 Amazon과 Gmail API를 요구한다. 지표는 과제 목표 완료(TGC)와 한 시나리오의 세 변형을 모두 성공해야 하는 시나리오 목표 완료(SGC)다. τ²-Bench Telecom은 도구와 시뮬레이션 사용자로 통신 서비스 문제를 해결하는 환경으로, 250개 층화 샘플이 진화 세트, 공식 74개 학습 분할이 검증 세트, 공식 40개 테스트가 테스트 세트이며 pass^k()를 보고한다. 백본은 Qwen3.5-27B(vLLM, 온도 0, thinking 활성)와 GPT-5.4-mini(낮은 추론 노력)이고, 연구 선택은 GPT-5.4, 코드 생성은 Codex + GPT-5.4다. AppWorld는 모듈당 4편(총 20편), Telecom은 모듈당 3편(총 15편)의 후보를 요청했다. 비교 대상 Meta Harness(Lee et al., 2026)는 실행 피드백으로 하네스를 고치는 코딩 에이전트이며, 같은 GPT-5.4/Codex와 같은 탐색 롤아웃 예산을 받았다. 모든 수치는 독립 평가 3회의 평균 ± 표준편차다.
Table 1 주요 결과.
| 설정 | 초기 하네스 | Meta Harness | ScholarEvolve |
|---|---|---|---|
| AppWorld Normal TGC, Qwen3.5-27B | 69.0 ± 2.35 | 76.8 (+7.8) | 81.4 ± 1.19 (+12.4) |
| AppWorld Normal SGC, Qwen3.5-27B | 48.8 | 62.5 (+13.7) | 69.0 (+20.2) |
| AppWorld Challenge TGC, Qwen3.5-27B | 49.6 ± 2.89 | 54.6 (+5.0) | 63.6 ± 0.36 (+14.0) |
| AppWorld Challenge SGC, Qwen3.5-27B | 28.3 | 32.9 (+4.6) | 44.8 (+16.5) |
| AppWorld Normal TGC, GPT-5.4-mini | 67.1 | 67.5 (+0.4) | 72.4 (+5.3) |
| AppWorld Challenge TGC, GPT-5.4-mini | 46.1 | 45.6 (−0.5) | 55.6 (+9.5) |
| Telecom pass^1, GPT-5.4-mini | 72.7 ± 2.53 | 66.5 (−6.2) | 81.9 ± 1.65 (+9.2) |
| Telecom pass^4, GPT-5.4-mini | 49.2 | 39.2 (−10.0) | 58.3 (+9.1) |
| Telecom pass^1, Qwen3.5-27B | 96.7 | 96.7 (0.0) | 98.1 (+1.4) |
몇 가지를 짚어 두자. 첫째, Challenge의 이득(Qwen +14.0, Mini +9.5)이 Normal(+12.4, +5.3)보다 크다. 같은 하네스와 아티팩트를 그대로 옮겼는데 미지의 앱에서 더 올랐다는 뜻이고, Meta Harness 대비 격차는 Challenge TGC에서 각각 9.0점과 10.0점이다. 둘째, Normal에서 진화된 Qwen3.5-27B의 81.4%는 초기 하네스의 Kimi-K2.6(81.3%)과 같은 수준이며, GPT-5.4(85.7%)와의 격차가 16.7점에서 4.3점으로 줄었다. 논문이 "가중치를 고정한 채 격차의 약 74%를 닫았다"고 쓴 계산이다. 셋째, Meta Harness는 GPT-5.4-mini에서 Telecom 성능을 오히려 떨어뜨렸다(pass^1 −6.2, pass^4 −10.0). 저자들은 이를 두고 길게 논하지 않지만, 트레이스만 보고 고치는 방식의 변동성을 보여주는 수치다. 넷째, Telecom에서 Qwen은 초기 하네스가 이미 96.7%라 올릴 여지가 거의 없었다.
Table 4, API 폭에 따른 일반화. Challenge 과제를 참조 해답이 요구하는 API 수로 나누면(학습 분포의 3사분위 9개, 최대 12개 기준), 학습 최대치를 넘는 13개 이상 구간에서도 Qwen +9.5, Mini +7.2점의 이득이 남는다. Challenge 과제의 24.5%가 이 구간이다.
실행 오류 뒤 복구. 부록 A.4가 기사에서 인용된 수치의 출처다. AppWorld의 명시적 Execution failed. Traceback: 센티널을 만난 에피소드만 모아 최종 성공률을 보면, Qwen Normal에서 진화 하네스는 249개 오류 노출 에피소드 중 180개를 성공시켜 72.3%(초기 64.5%, 273개 중 176개), Challenge에서는 865개 중 518개로 59.9%(초기 44.9%, 903개 중 405개)다. 저자들은 "성공한 과제의 상당수는 반환된 오류를 이용해 이후 행동을 수정해야 한다"며, 중간 도구 오류 하나로 에이전트 능력을 판단하면 불완전하다고 쓴다. 다만 두 하네스가 오류를 만나는 과제가 다르므로 이 조건부 비율은 실제 궤적에 대한 서술이지 통제된 비교는 아니라는 단서도 붙어 있다.
3라운드 평생 진화
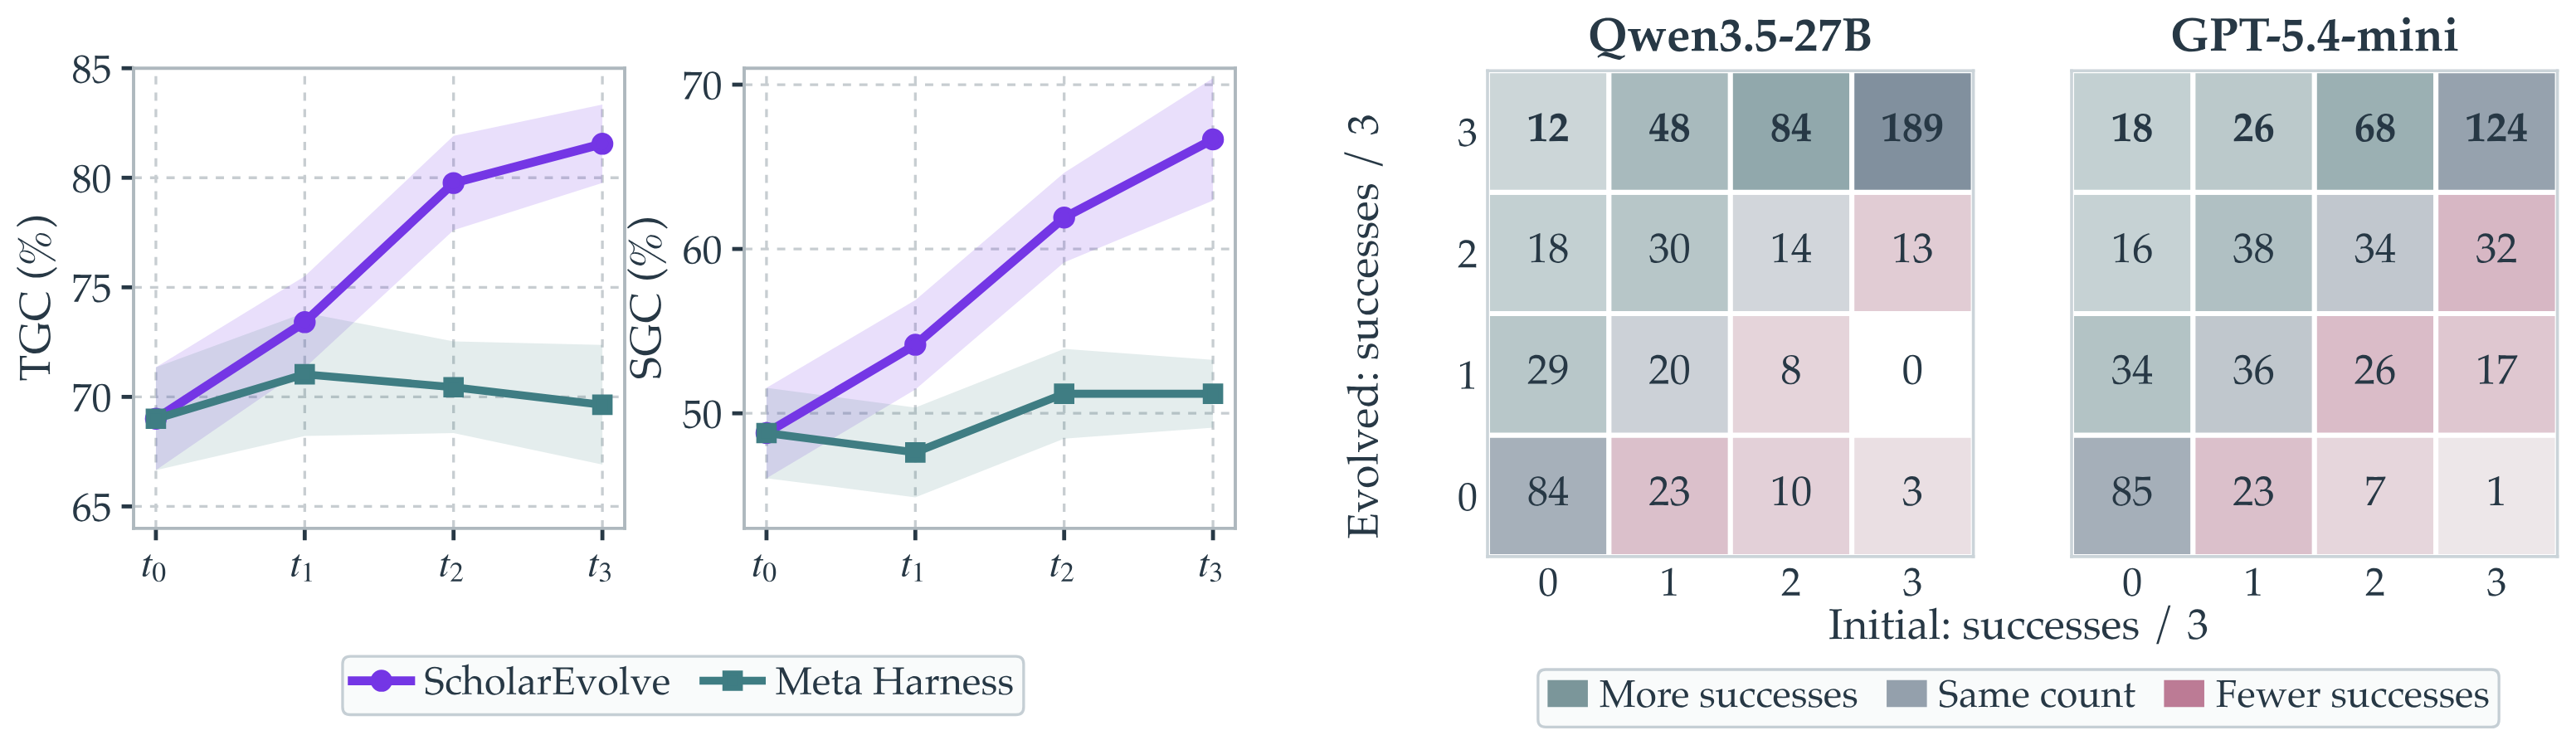
4.3절과 부록 A.2는 Qwen3.5-27B의 가중치, 진화 세트 궤적, 파생 아티팩트를 고정한 채 세 개의 겹치지 않는 출판 기간(2025년 12월까지, 2026년 14월, 2026년 58월; arXiv 최초 제출일 기준으로 현재 인덱스에서 재구성)의 논문을 차례로 투입했다. 라운드마다 모듈당 최대 1편, 최대 5개 돌연변이, 최대 4개 조합을 57개 개발 과제에서 평가하고, 세 세대의 탐색 결정을 전부 동결한 뒤 Normal 168개 과제에서 측정했다(이 설정의 코드 생성은 Codex GPT-5.5).
| Normal (Qwen3.5-27B) | ||||
|---|---|---|---|---|
| TGC, ScholarEvolve | 69.00 | 73.41 | 79.76 | 81.55 |
| TGC, Meta Harness | 69.00 | 71.03 | 70.44 | 69.64 |
| SGC, ScholarEvolve | 48.80 | 54.17 | 61.91 | 66.67 |
| SGC, Meta Harness | 48.80 | 47.62 | 51.19 | 51.19 |
세 번의 갱신마다 TGC와 SGC가 모두 올랐고, 최종 Meta Harness 대비 격차는 11.9점과 15.5점이다. Meta Harness는 같은 세 라운드를 받고도 1라운드 이후 제자리걸음이었다. 논문 1장이 인용한 "반복된 국소 편집 주변에서 정체하는 탐색"이 그대로 재현된 셈이다.
Figure 3 오른쪽의 전이 행렬은 Normal과 Challenge를 합친 585개 과제에서 Qwen이 221개 과제에서 성공 횟수를 늘리고 57개에서 줄였음을, Mini는 200개 대 106개임을 보여준다. 이득의 73.3%(Qwen)와 66.0%(Mini)는 초기 하네스에서 간헐적으로 성공하던 과제에서 나왔고, Qwen이 3회 모두 성공하는 과제는 205개에서 333개로 늘었다. 진화가 "새로 푸는 과제"보다 "흔들리던 과제를 안정시키는" 쪽에서 더 큰 몫을 했다는 뜻이다.
🔍 Ablation: 문헌, 토픽, 모듈 분리는 각각 얼마나 기여하나
Table 2, 누적 ablation(AppWorld Normal). 세 구성 요소를 순서대로 제거한다. 토픽 기반 선택을 같은 풀·같은 예산의 관련도 랭킹으로 바꾸고, 모듈별 돌연변이를 하네스 전체 공동 편집으로 바꾸고, 마지막으로 연구 지침을 빼면 Meta Harness가 된다.
| 변형 | Qwen TGC | Qwen SGC | Mini TGC | Mini SGC |
|---|---|---|---|---|
| ScholarEvolve | 81.4 ± 1.19 | 69.0 ± 4.10 | 72.4 ± 1.83 | 55.4 ± 3.55 |
| − 토픽 기반 선택 | 80.0 ± 0.91 | 66.7 ± 4.12 | 69.8 ± 0.91 | 50.0 ± 4.72 |
| − 모듈별 돌연변이 | 78.6 ± 1.79 | 64.9 ± 4.49 | 69.3 ± 1.24 | 48.8 ± 3.72 |
| − 연구 지침 (= Meta Harness) | 76.8 ± 1.19 | 62.5 ± 3.57 | 67.5 ± 2.44 | 45.8 ± 2.70 |
모든 단계에서 두 백본 모두 떨어진다. 토픽 지침 단독 기여는 Qwen에서 1.4 TGC / 2.3 SGC, Mini에서 2.6 / 5.4점이다. 연구 지침 자체(마지막 행과 그 위 행의 차이)는 Qwen 1.8점, Mini 1.8점이다. 솔직히 말하면 Qwen의 토픽 기여 1.4점은 표준편차(±1.19, ±0.91)와 비슷한 크기라, 세 요소를 합친 4.6점은 분명하지만 개별 요소의 기여는 약하다. Qwen의 선별 풀이 1,956개 모듈–논문 레코드였다는 점을 감안하면, 그 풀에서 "어떻게 고르느냐"의 효과는 "풀이 있느냐 없느냐"보다 작아 보인다.
Table 3, 모듈 조합(개발 세트 57개 과제). Qwen은 다섯 모듈 전부, Mini는 스킬·메모리·워크플로 셋만 조합했다. Qwen 단독 최강은 메모리(81.3)인데 조합은 84.8로 3.5 TGC / 12.3 SGC점 더 높고, Mini도 4.7 / 7.0점 높다. 더 중요한 관찰은 단독 점수가 조합을 예측하지 못한다는 것이다. Qwen의 스킬 모듈을 단독 75.4%짜리 후보에서 73.7%짜리로 바꿨더니 조합이 80.7%에서 84.8%로 올랐다. 가산적 예측으로 후보를 줄인 뒤 실측으로 고르는 설계가 왜 필요한지 보여주는 사례다. 단, 부록 A.1에 따르면 Table 3의 Qwen 조합은 본 실험 테스트 하네스와 스킬 구현이 다르다.
라운드 수에 따른 변화는 위 평생 진화 표가 전부다. 본 실험의 수렴 기준은 , 즉 한 세대만 개선이 없어도 멈추므로, 본 실험 자체가 몇 세대를 돌았는지는 논문에 명시되어 있지 않다.
남은 실패
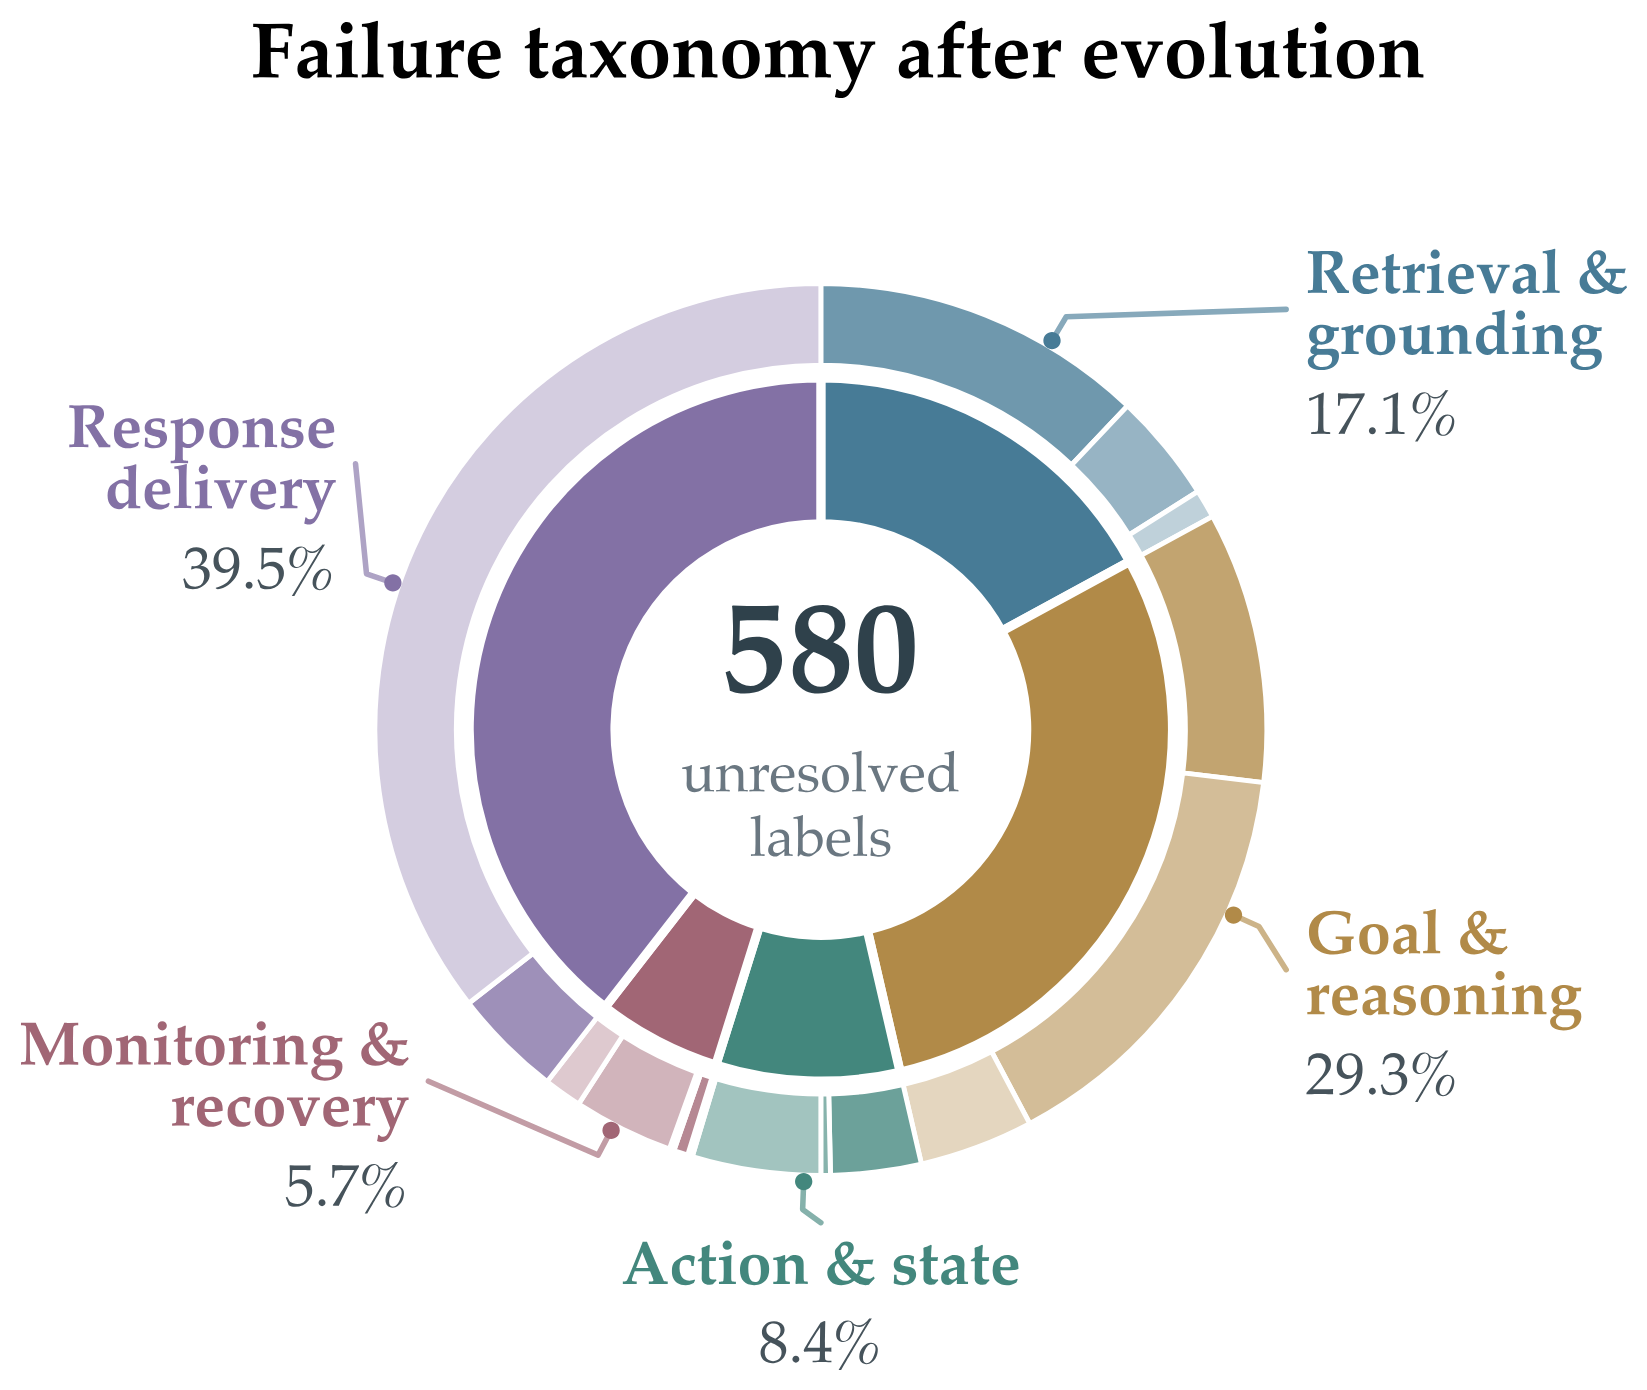
실패한 Qwen 에피소드 1,336개를 전부 감사해 5개 패밀리, 16개 하위 유형을 만들었다. 진화 하네스의 실패 549개에 붙은 580개 레이블 중 응답 전달(response delivery)이 39.5%로 가장 크지만, 그 안의 "잘못된 응답 형식"은 492개에서 206개 에피소드로 크게 줄었다. 반면 제약 위반(91→89)과 불완전한 검색(77→70)은 거의 그대로다. 저자들의 정리는 "진화는 답을 전달하는 능력을 가장 크게 개선했고, 요구사항 추적과 근거 커버리지는 여전히 반복되는 과제"다. 부록 B에는 두 하네스 모두 3회 전부 실패한 Challenge 과제 71개 중 35개가 여전히 진화 하네스의 한 번 이상 실행에서 잘못된 최종 응답을 냈다는 기록도 있다.
💡 비판적으로 읽기
보안 검토는 논문에 없다. 기사가 지적한 대로다. 논문 전문을 검색해 보면 security, malicious, injection, sandbox라는 단어가 한 번도 나오지 않는다. 건강 검사는 임포트 가능성, 인터페이스 호환성, 아티팩트 구축·재적재, 유효한 행동 생성만 본다. 논문을 읽고 공식 GitHub 코드까지 참고해 코딩 에이전트가 하네스 코드를 고치는 구조에서, 악성 의존성이나 위험한 실행 패턴, 논문 본문에 심어진 프롬프트 인젝션은 걸러지지 않는다. 검색 대상이 arXiv 전체라는 점을 생각하면 이것은 작은 구멍이 아니다. 기사는 "연구진이 별도의 보안 검토 절차를 마련할 필요가 있다고 지적했다"고 썼지만, 논문 본문에서는 그런 문장을 찾지 못했다. 기사의 해석으로 보인다.
벤치마크 과적합 문제는 설계로 상당 부분 대응했지만 남는다. 이 논문의 분할 설계는 RRSI 글에서 다룬 우려를 의식한 것이 분명하다. 진화·검증·테스트 세트를 서로 소거하고, Challenge는 진화 때 본 적 없는 앱을 요구하며, related work에서는 Meta Harness의 TerminalBench-2 실험과 AHE의 주 실험이 "같은 89개 과제에서 최적화하고 보고한다"고 직접 짚는다. 그래서 Challenge에서 Normal보다 큰 이득이 난 것은 의미 있는 신호다. 그러나 Challenge도 AppWorld라는 같은 환경, 같은 Python 실행 인터페이스, 같은 채점 방식 안에 있다. RRSI 글에서 Meta-Harness가 채점 방식을 재진술하는 시스템 프롬프트를 만들어낸 사례를 떠올리면, "잘못된 응답 형식이 492→206으로 줄었다"는 가장 큰 개선 항목이 AppWorld의 응답 규약에 특화된 것인지, 다른 환경으로도 옮겨 가는 것인지는 이 논문으로는 알 수 없다. 역량 격차에서 벤치마크 이름과 도구명을 지운다는 장치는 좋지만, 그것이 코딩 에이전트의 구현까지 벤치마크 무관하게 만드는지는 별개다.
비용은 보고되지 않았다. 토큰, 시간, 금액 어느 것도 없다. 알 수 있는 것은 예산의 모양뿐이다. AppWorld는 후보 20편을 각각 57개 과제 × 3회 실행으로 재고, 조합을 추가 평가하고, Mini 결승 후보는 9회까지 돌렸다. 연구 모델(GPT-5.4)의 토픽 모델링 호출과 Codex의 구현·수리 루프도 더해진다. 그리고 부록 C.1의 AppWorld 워크플로 돌연변이는 planner/solver/critic 역할의 제안을 각각 받고 verifier로 고르는 구조라, 진화된 하네스의 추론 시점 비용도 초기 하네스보다 클 가능성이 높다. RRSI 논문이 trial당 토큰을 명시했던 것과 대비된다.
"문헌이 기여했다"는 증거의 수준. 가장 직접적인 증거는 Table 2에서 연구 지침을 뺀 단계(1.8점)와 전체 격차(4.6점), 그리고 평생 진화에서 Meta Harness가 정체한 것이다. 그런데 이 Meta Harness는 저자들이 자기 파이프라인에서 구성 요소를 빼서 얻은 것이지 원저자 구현이 아니고, GPT-5.4-mini + Telecom에서는 베이스라인보다 10점 떨어지는 등 변동이 크다. 비교 대상이 약했을 가능성을 배제하기 어렵다. 또 평생 진화의 출판 기간은 사후에 재구성됐고, 백본으로 쓴 GPT-5.4의 학습 데이터가 2025년 12월 이전 논문을 이미 알고 있을 가능성도 있다. "백본이 학습된 뒤 나온 메커니즘을 가중치 갱신 없이 가져온다"는 주장은 매력적이지만, 그 자체를 분리해 검증한 실험은 없다.
작은 검증 세트. 챔피언 선택은 57개 개발 과제에서 이뤄지고, Table 3의 단독 모듈 표준편차는 ±5~13점에 달한다. 부트스트랩 하한 규칙이 이를 어느 정도 걸러 주지만, 57개로 20개 후보와 조합을 고르는 것은 노이즈에 취약하다.
코드. 초록은 github.com/UCSB-NLP-Chang/ScholarEvolve를 가리키지만, 이 글을 쓰는 2026년 10월 28일 기준 저장소는 2026년 9월 30일에 만들어진 뒤 커밋이 하나도 없는 빈 상태다. 부록 D.2에 선택된 구성의 코드 일부가 실려 있을 뿐이다.
🧩 정리와 열린 질문
ScholarEvolve의 기여를 한 줄씩 요약하면 이렇다.
- 제안 분포의 교체. 자기 개선 루프의 제안을 실패 로그가 아니라 학술 문헌에서 가져온다. 실패 분석은 "무엇이 부족한가"까지만 담당한다.
- 모듈 × 토픽의 구조화된 탐색. 5개 모듈 인터페이스가 교차를 가능하게 하고, 토픽 모델링이 같은 메커니즘에 예산을 중복 지출하는 것을 막는다.
- 실측 기반 교차와 보수적 채택. 단독 점수가 조합을 예측하지 못하므로 완성 하네스를 평가하고, 부트스트랩 하한이 0을 넘을 때만 챔피언을 바꾼다.
- 문헌 갱신으로 구동되는 평생 진화. 세 출판 기간을 차례로 넣어 Normal TGC 69.0→81.5, SGC 48.8→66.7을 얻었고, 같은 예산의 Meta Harness는 정체했다.
열린 질문도 분명하다. 하네스 진화가 실행 오류의 복구 같은 "전달" 능력은 크게 올리지만 요구사항 추적과 근거 커버리지는 거의 못 건드리는데, 이것이 하네스의 한계인지 백본의 한계인지. 문헌 검색의 이득이 AppWorld 밖에서도 유지되는지, 그리고 매달 arXiv를 읽고 자기 코드를 고치는 에이전트를 운영 환경에 두려면 어떤 격리와 검토가 필요한지. 마지막 질문은 논문이 아니라 이것을 쓰려는 쪽이 답해야 할 것이다.
📚 참고
- 원문: Learning from Research: Toward Lifelong Agent Harness Evolution (Yang, Lai, Wang, Harari, Gabrilovich, Chang; arXiv 2609.40169 v1, 2026년 9월 30일, CC BY 4.0) · HTML
- 코드(초록 명시, 현재 빈 저장소): github.com/UCSB-NLP-Chang/ScholarEvolve
- 기사: 학술 논문 읽고 코드 수정하는 자가 진화 에이전트 '스칼라이볼브' 등장 (AI타임스, 박찬 기자, 2026년 10월 22일)
- 비교 대상: Meta-harness: End-to-end optimization of model harnesses (Lee et al., 2026)
- 토픽 모델링: TopicGPT (Pham et al., 2024)
- 벤치마크: AppWorld (Trivedi et al., 2024), τ²-Bench (Barres et al., 2025)
- 이 블로그의 관련 글: RRSI, Harness², Raven, Paper2Agent, 루프 엔지니어링
본 글의 그림은 원문에서 가져왔습니다.