DeepInfer: DeepSeek이 공개한 프로덕션 추론 프레임워크 해부
"모델은 가능한 것의 경계를 정한다. 그 능력을 합리적인 비용으로 수많은 사용자에게 서빙하는 것이 추론 프레임워크가 풀어야 할 핵심 문제다." — DeepInfer 저장소
doc/inference_deployment_qa.md첫 문장
2026년 10월 20일, DeepSeek이 자사 프로덕션 서비스를 돌리는 추론 프레임워크 DeepInfer를 GitHub에 Apache-2.0으로 공개했다. AI타임스(박찬 기자)가 다음 날 이를 보도했는데, 기사는 계기일 뿐이고 이 글의 1차 출처는 저장소 자체다. README, doc/inference_deployment_qa.md, examples/README.md, 벤치마크 스윕 스크립트, 그리고 컴포넌트 저장소(FlashMLA, DeepGEMM, DeepEP)의 README를 기준으로 썼고, 저장소에서 확인하지 못한 내용은 "기사에 따르면"으로 구분했다.
- 저장소: github.com/deepseek-ai/DeepInfer (이 글은 2026-10-21 커밋
9bd9cf2기준) - 기사: 딥시크, AI 운영 비용 낮출 핵심 추론 기술 '딥인퍼' 오픈소스 공개
🤔 왜 중요한가: 모델 경쟁에서 서빙 효율 경쟁으로
DeepSeek은 R1로 "학습 비용"의 상식을 흔들었고, 그 뒤로는 FlashMLA, DeepGEMM, DeepEP, 3FS 같은 인프라 조각을 하나씩 공개해 왔다. 이번 공개는 그 조각들을 실제로 엮어 돌리는 엔진 본체다. README의 첫 줄이 이를 그대로 말한다. "DeepInfer is the high-performance inference framework that powers DeepSeek's large-scale production services."
같은 모델이라도 어떤 엔진과 하드웨어로 돌리느냐에 따라 토큰당 비용이 몇 배씩 달라진다. Q&A 문서에는 DeepSeek 자체 주장으로 "단일 클러스터가 현재 하루 155조 토큰을 서빙하고, (밸리 가격 기준) GPU-시간당 38달러의 매출"이라는 문장이 있다. 숫자 자체보다, 이 규모를 받쳐 주는 스택을 통째로 공개했다는 점이 핵심이다. 흥미로운 대목 하나. README 감사의 글에 "DeepInfer는 원래 주로 vLLM 위에서 만들어졌고, SGLang과 TensorRT-LLM에서도 영감을 받았다"고 적혀 있다. 오픈소스 엔진을 가져다 프로덕션 규모로 다듬은 결과를 다시 오픈소스로 돌려보낸 셈이다.
🧠 DeepInfer가 무엇인가
README 기준으로 정리하면 범위가 꽤 명확하다.
| 항목 | 내용 (README) |
|---|---|
| 지원 모델 | DeepSeek-V4.1-Flash (기본 체크포인트 deepseek-ai/DeepSeek-V4.1-Flash-1017) |
| 지원 하드웨어 | NVIDIA SM100 GPU, Huawei Ascend 950 NPU |
| 빌드 요구사항 | Linux, GCC ≥ 13, Python 3.12, CUDA 13(NVIDIA) 또는 CANN 9.2(Ascend) |
| 제공 기능 | 최적화 커널·모델·샘플러 런타임, Attention DP / balanced CP, MoE EP + EPLB, DSpark와 confidence-scheduled verification, SWA bounded replay, 비동기 스케줄링, batch-invariant 추론, deterministic sampling, structured outputs |
| 이번 공개의 범위 | 오프라인 추론 ("provides offline inference with the core features needed for serving at scale") |
| 미포함 (완전한 서비스에 필요) | KV cache 시스템, VE/Prefill/Decode 분리 ("most required engine functionality is already implemented"), prefill·decode DP 복제본 간 로드밸런싱 |
즉 "엔진"은 나왔지만 "서비스"를 만들려면 세 가지를 직접 채워야 한다. Q&A 문서는 그 이유도 적어 놓았다. KV cache 관리와 로드밸런싱 컴포넌트는 내부 인프라에 강하게 결합돼 있어 아직 완전히 공개하지 못했고, 대신 설계는 Zhihu 블로그와 Q&A 문서로 설명하겠다는 것이다.
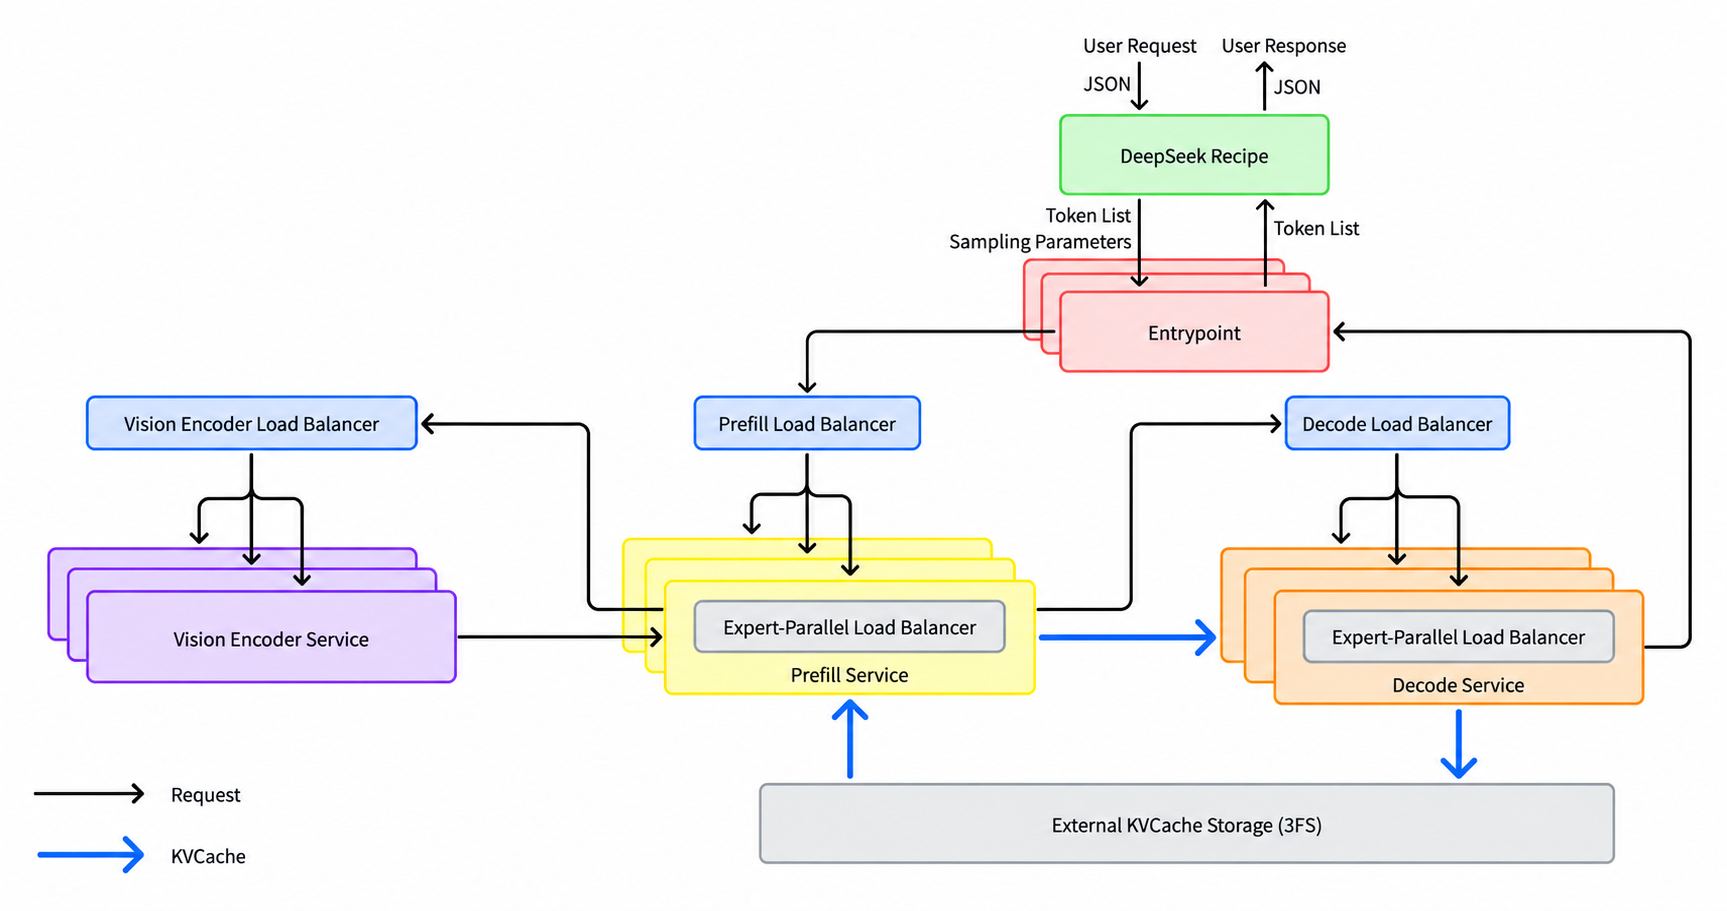
그림 1이 Q&A 문서가 말하는 전체 시스템이다. 이번에 공개된 DeepInfer는 이 그림에서 노란 Prefill Service와 주황 Decode Service 상자 안쪽(엔진과 EP 로드밸런서)에 해당한다. 세 종류의 Load Balancer, Entrypoint, 3FS 기반 KVCache Storage는 공개 범위 밖이다. 녹색 DeepSeek Recipe(API 프로토콜 ↔ 토큰 변환, Rust 구현)는 별도 저장소 deepseek-recipe로 함께 공개됐다.
프로덕션 배치 형태도 Q&A에 구체적으로 적혀 있다. Prefill은 EP2–8 / DP2–8(일반 8-GPU 머신), Decode는 EP64–128 / DP64–128(64–128 GPU 슈퍼노드)의 Wide-EP, TP와 CP는 현재 쓰지 않는다. "1P + 1D도 배포 가능하지만, 권장 decode 구성이 EP64 이상이라 가장 작은 효율적 배포 단위는 prefill 64 GPU + decode 64 GPU"라는 문장은 이 스택이 어떤 규모를 전제하는지 잘 보여 준다.
🔧 구성 요소: FlashMLA, DeepGEMM, DeepEP는 안에서 무엇을 하나
세 라이브러리는 vendor/ 아래 git submodule로 들어 있고, build.sh가 DEEPINFER_ACCELERATOR에 따라 NVIDIA용(DeepSelect FlashMLA DeepEP DeepGEMM) 또는 Ascend용(DeepSelect FlashMLA DeepEP-Ascend DeepGEMM-Ascend) 조합을 빌드한다. 각 저장소 README 기준 역할은 다음과 같다.
| 컴포넌트 | 역할 (각 저장소 README) | DeepInfer 안에서의 위치 |
|---|---|---|
| FlashMLA | DeepSeek-V4.1 추론용 attention 커널 라이브러리. prefill과 FP8/FP4 KV cache decoding용 토큰 수준 sparse attention 커널(DSA), Q-RoPE·attention·O-RoPE·FP8 캐스트를 한 커널로 합친 fused 커널. 벤더 주장 수치: B200(CUDA 13.3)에서 fused 커널 prefill 최대 1460 TFlops, decoding 950 TFlops; Ascend 950에서 prefill 410 TFlops(이론 피크의 95%), decoding 360 TFlops(83%) | attention 계산. Q&A에 따르면 공개판 FlashMLA는 내부판 대비 "수작업 SASS 최적화 하나가 빠져 decoding 커널이 5–10% 느리고, 엔드투엔드로는 최대 5% 차이" |
| DeepGEMM | FP8/FP4/BF16 GEMM, 통신을 겹친 fused MoE(Mega MoE), lightning indexer용 MQA scoring, HyperConnection 등을 한 CUDA 코드베이스에 모은 텐서코어 커널 라이브러리. DeepJIT로 런타임 컴파일 | MoE 전문가 GEMM과 indexer. Q&A: "Mega MoE는 EP 크기·배치와 무관하게 unfused MoE보다 상당히 빠르며 scale-up 도메인 안의 범용 해법" |
| DeepEP | EP all-to-all dispatch/combine 커널(FP8 dispatch 포함), 중복 전문가(redundant experts)를 위한 NVLink 가중치 교환(lb_prefetch_weights), NCCL Gin 백엔드. Ascend 버전은 같은 API |
MoE 토큰 라우팅 통신과 EPLB 재배치 시 전문가 가중치 셔플 |
이 밖에 TileKernels, DeepSelect, 그리고 저장소 안의 TileLang 커스텀 커널(deepinfer/model_executor/layers/tilelang_ops)이 쓰인다. 저정밀 포맷도 Q&A에 명시돼 있다. 메인 KV는 per-16 e4m3 FP4(NVFP4와 비슷하되 글로벌 스케일 없음), indexer KV와 MoE 라우팅 전문가 가중치는 per-32 ue8m0 MXFP4다. KV cache 글에서 MLA를 "저랭크 압축"으로 소개했는데, V4.1에서는 거기에 sparse attention과 FP4 KV가 얹혀 있다.
💡 핵심 기법 네 가지
(a) DSpark: 드래프트 5개를 뽑되, 검증은 "확신 있는 만큼만"
Speculative Decoding 글에서 다룬 기본 구조(드래프트 → 타겟 검증 → 거절 샘플링)는 같다. 다른 점은 검증 길이를 요청·위치마다 바꾼다는 것이다. Q&A 문서의 설명을 옮기면 이렇다.
- 드래프트 토큰의 수용 확률은 요청과 위치에 따라 달라서, 고정 길이 검증은 수용 가능성이 낮은 토큰에 검증 연산을 낭비한다.
- DSpark는 Confidence Head로 각 드래프트 토큰의 수용률을 예측하고, 프로파일된 하드웨어 처리량 곡선과 함께 "한계 수익이 가장 큰 토큰"에 검증 연산을 배분한다.
- 프로덕션에서는 드래프트 모델이 한 번에 5 토큰을 생성하고, 기대 수용률 순으로 정렬해 유효 처리량을 최대화하는 접두 부분집합만 검증한다.
드래프트 모델의 정체는 코드에서 확인할 수 있다. deepinfer/model_executor/models/mtp/dflash.py에 DFlash 클래스와 ConfidenceHead("Predict the acceptance probability of each draft token.")가 있고, 샘플러 주석에는 "DFlash의 main KV cache는 주 모델 forward가 이미 갱신하므로 별도 draft prefill이 없다"고 적혀 있다. 즉 외부의 작은 모델이 아니라 주 모델에 붙은 DFlash 계열 블록 병렬 드래프터다. (vLLM speculators 문서는 DSpark를 "DFlash 백본 + 저랭크 Markov head + confidence head"로 설명하는데, 이는 저장소 밖 자료다.) 활성화는 DEEPINFER_ENABLE_MTP_VARLEN=1, 최대 드래프트 길이는 DEEPINFER_USE_NEXTN_DECODE(기본 5)다.
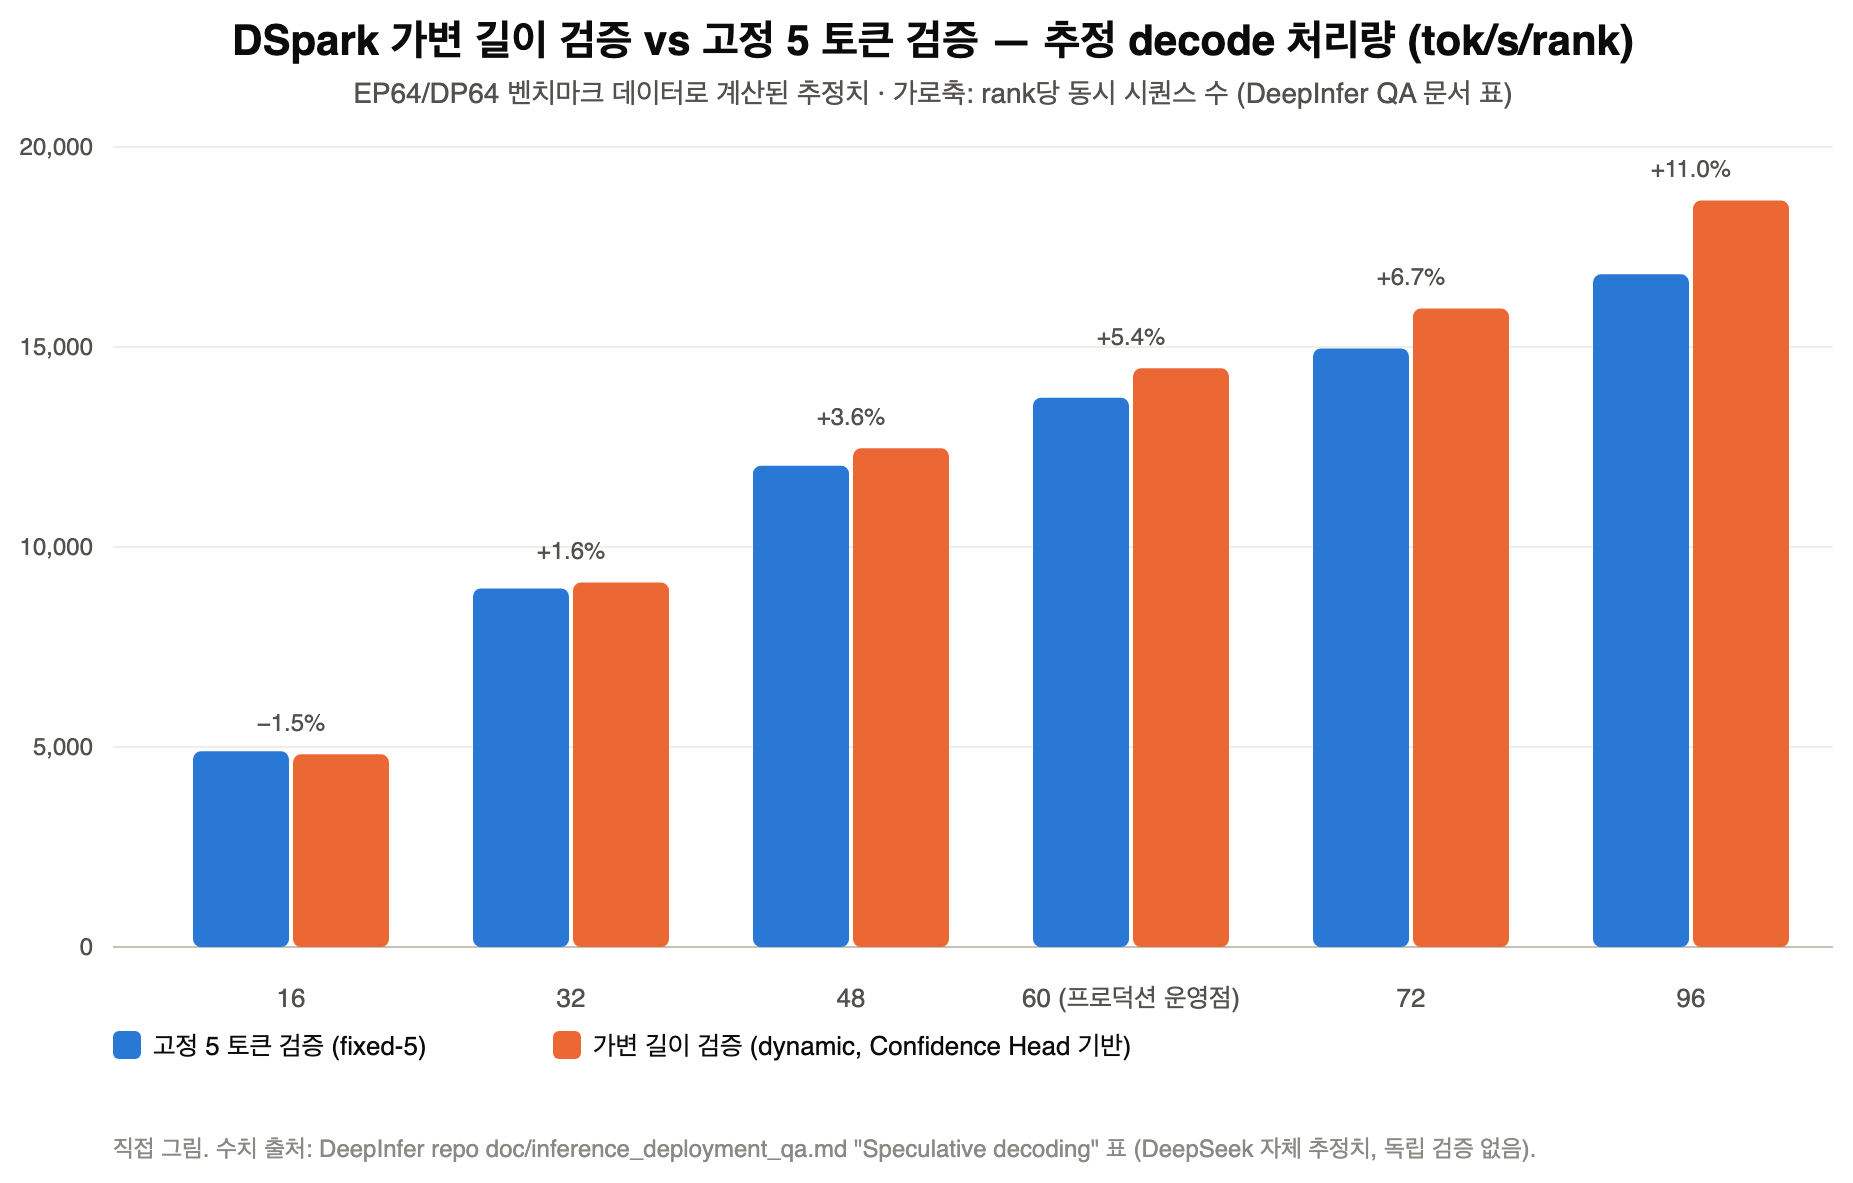
그림 2는 Q&A 문서의 표를 그대로 옮긴 것이다. 가변 길이 검증은 스텝당 검증하는 드래프트 토큰 수를 약 30% 줄이면서(5.00 → 3.2–4.4) 평균 수용 길이는 거의 유지한다(3.29 vs 3.20). 그 결과 프로덕션 운영점(rank당 약 60 동시 시퀀스)에서 +4–7% 처리량이라는 계산이다. 동시성이 낮으면 GPU가 놀기 때문에 검증을 줄여 봐야 이득이 없고(16에서 −1.5%), 동시성이 높을수록 검증 연산이 병목이라 이득이 커진다. 비동기 스케줄링과의 결합도 재미있다. schedule(N+1) 시점엔 스텝 N의 confidence가 아직 안 돌아왔으므로 CPU는 총 예산만 정하고, 요청별 길이는 GPU 위의 TileLang 커널(누적곱 → 전역 정렬 top-k → fused remap scatter)이 다시 계산한다.
(b) SWA bounded replay: 긴 컨텍스트 prefill을 상수 비용으로
V4.1-Flash는 sliding window attention(SWA) 레이어를 가진 구조이고, Q&A에 따르면 디코더 레이어의 block KV cache는 마지막 인코더 레이어의 hidden state에서 투영된다(CED 구조). 그래서 prefill에서 실제로 계산해야 하는 건 디코더 레이어의 SWA KV cache뿐인데, 이것을 정확히 복원하려면 "마지막 2,560 토큰을 디코더 20 레이어에 통과"시켜야 한다.
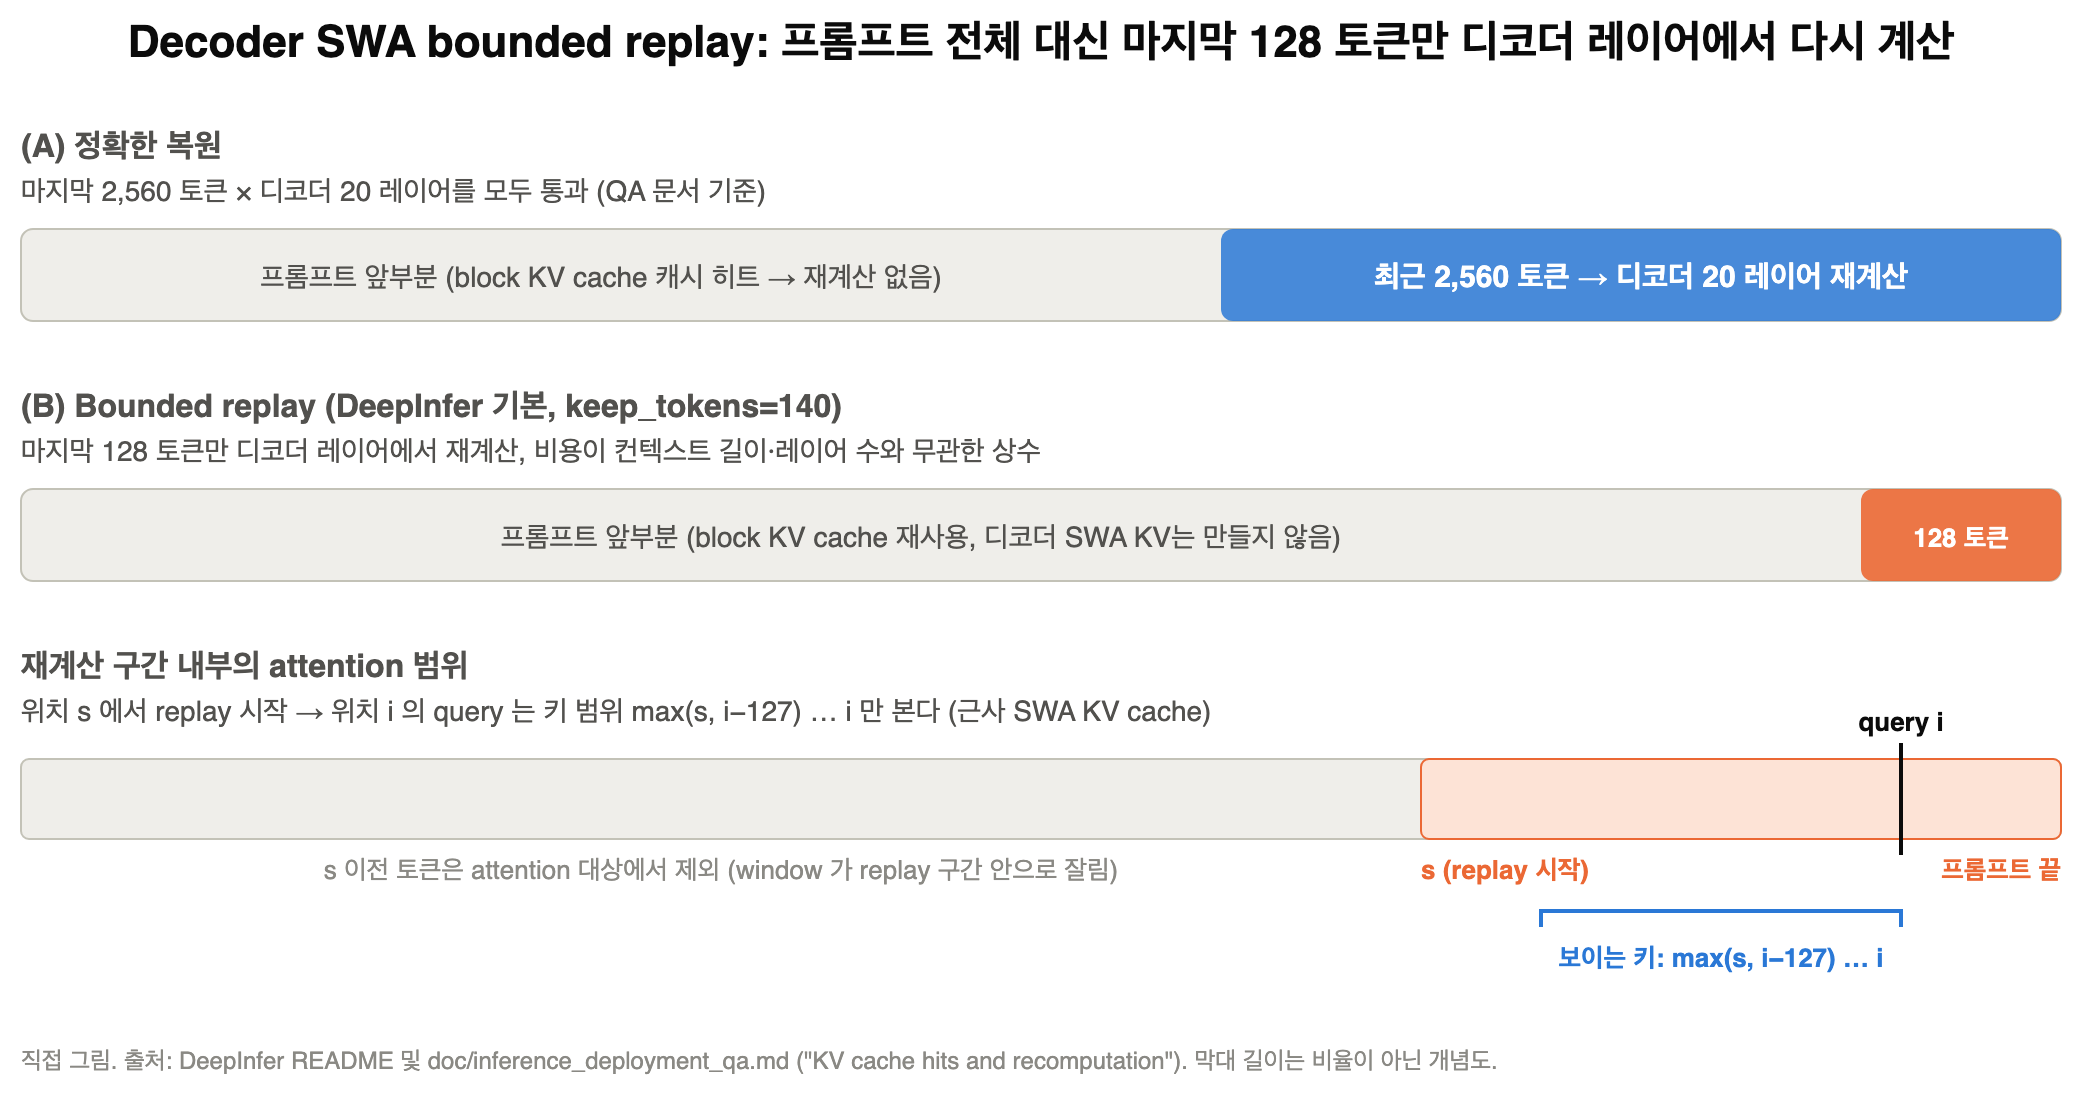
bounded replay는 그 대신 마지막 128 토큰만 다시 계산한다(그림 3). 위치 s부터 replay하면 위치 i의 query는 키 범위 max(s, i−127)…i만 보므로 결과는 "근사 SWA KV cache"지만, 재계산 비용이 컨텍스트 길이와 레이어 수에 무관한 상수가 된다. 이 결과는 decode에만 쓰이고 prefix cache에는 들어가지 않는다. Q&A는 이 기법이 "총 prefill 연산을 거의 절반으로" 줄인다고 쓴다. 같은 메커니즘이 인코더 쪽에도 쓰인다. SWA KV cache가 캐시 미스일 때 히트된 프리픽스의 마지막 128 토큰만 재계산하고 block KV cache는 그대로 둔다.
README의 설정값은 DEEPINFER_YOCO_PREFILL_TRUNCATION_MODE=compact, DEEPINFER_YOCO_PREFILL_KEEP_TOKENS=140이다. 140인 이유는 "유지하는 접미가 SWA 윈도(128)와 최대 backtracking 길이를 덮어야" 하기 때문인데, Q&A의 히트 정책에도 같은 산수가 나온다. 길이 L 입력의 최대 히트 길이는 L − 134(128 윈도 + 추측 디코딩 backtracking 6 토큰)이다. examples/yoco/에는 mask 모드와 compact 모드가 같은 출력을 내는지 검증하는 스크립트(L1: 메타데이터 비교, L2: 8 디바이스에서 logprob 비교)가 들어 있다.
(c) 구조화 출력: regex / JSON schema / EBNF
SamplingParams에 so_args={"schema_type": "regex"|"json"|"ebnf", "schema": ...}를 넘기면 된다. 구현은 deepinfer/structure_output/compiler.py가 xgrammar(requirements.txt의 xgrammar==0.2.2)의 GrammarCompiler를 감싸는 형태이고, Q&A는 흐름을 "컴파일과 추론을 분리해 문법 자동자를 비동기로 컴파일하고, 매 decode 스텝에 자동자를 전진시켜 합법 토큰 마스크를 샘플링에 적용"으로 설명한다. examples/_structured_output.py의 예시는 세 종류를 모두 보여 준다.
# examples/_structured_output.py 에서 발췌
cases = [
    ("...", {"schema_type": "regex", "schema": r"[A-Z]{2}-[0-9]{3}"}),
    ("...", {"schema_type": "json",  "schema": json.dumps(json_schema)}),
    ("...", {"schema_type": "ebnf",  "schema": 'root ::= "answer=" ("yes" | "no") ";level=" [1-3]'}),
]
outputs = llm.generate(
    prompts=[prompt for prompt, _ in cases],
    sampling_params=[SamplingParams(temperature=0, max_tokens=128, so_args=so_args) for _, so_args in cases],
)
(d) Wide-EP MoE + EPLB, 그리고 CPU 스케줄링을 GPU 뒤에 숨기기
MoE는 EP로 노드(또는 슈퍼노드) 안에 펼치고, attention은 DP(#DP = #EP)로 돈다. 전문가 부하 불균형은 EPLB가 잡는다. 각 GPU가 담당 전문가 외에 핫 전문가의 복제본(redundant experts)을 몇 개 더 들고, 최근 N 스텝의 부하 통계를 모아 M 스텝마다 전문가를 재배치하며, 가중치는 NVLink symm_mem으로 셔플한다. Q&A의 설정값은 prefill이 GPU당 4개 여분·100 스텝 창·1,000 스텝마다 재배치(측정 moe_lb = 1.074 @ EP4DP4), decode가 GPU당 1개 여분(EP64에서 반올림 후 7개)·1,000 스텝 창·10,000 스텝마다 재배치(moe_lb = 1.090)다. 벤치마크 스크립트의 여분 전문가 수는 DEEPINFER_OVERRIDE_NUM_EXTRA_EXPERTS(기본 32, ep_size로 나누어떨어지게 올림)로 준다.
비동기 스케줄링은 README에서 "zero-overhead batch scheduler"라고 부르는 것으로 기본 활성화다. decode 스텝 N은 schedule(N) → forward(N) → sample(N) → post-process(N)인데 schedule과 post-process는 순수 CPU 로직이고, sample(N) 결과를 받으려면 GPU-CPU 동기화가 필요하다. 그래서 GPU가 forward(N) → sample(N)을 도는 동안 CPU가 schedule(N+1) → launch_forward(N+1) → post-process(N−1) → launch_sample(N+1)을 돌려 GPU 공백을 없앤다. Q&A는 이를 "SGLang, NanoFlow 등 기존 구현을 따랐다"고 솔직하게 적는다.
📊 벤치마크: 수치와 측정 조건
README의 두 Pareto 곡선과 Q&A의 EP8 vs EP64 비교가 전부다. 측정 환경은 prefill 4 SM100 GPU, decode 64 SM100 GPU, 각각 하나의 scale-up 도메인 안이고, 재현 스크립트는 examples/sweep/run_sweep.sh다. 아래 표의 수치는 차트에서 읽은 근사치다(저장소에 원시 jsonl은 없다).
Prefill — EP4DP4, 384+32 experts, context 131,072, decoder bounded replay 140 tokens. x축은 prefill 스텝당 지연, 점 라벨은 DP rank당 prefill_batch_size.
| prefill_batch_size (tokens/rank) | 비캐시 입력 처리량 (tok/s/GPU) | 지연 (ms/step) |
|---|---|---|
| 4,096 | ≈ 60,000 | ≈ 68 |
| 8,192 | ≈ 71,500 | ≈ 115 |
| 16,384 | ≈ 81,500 | ≈ 200 |
| 32,768 | ≈ 87,000 | ≈ 375 |
| 65,536 | ≈ 89,500 | ≈ 730 |
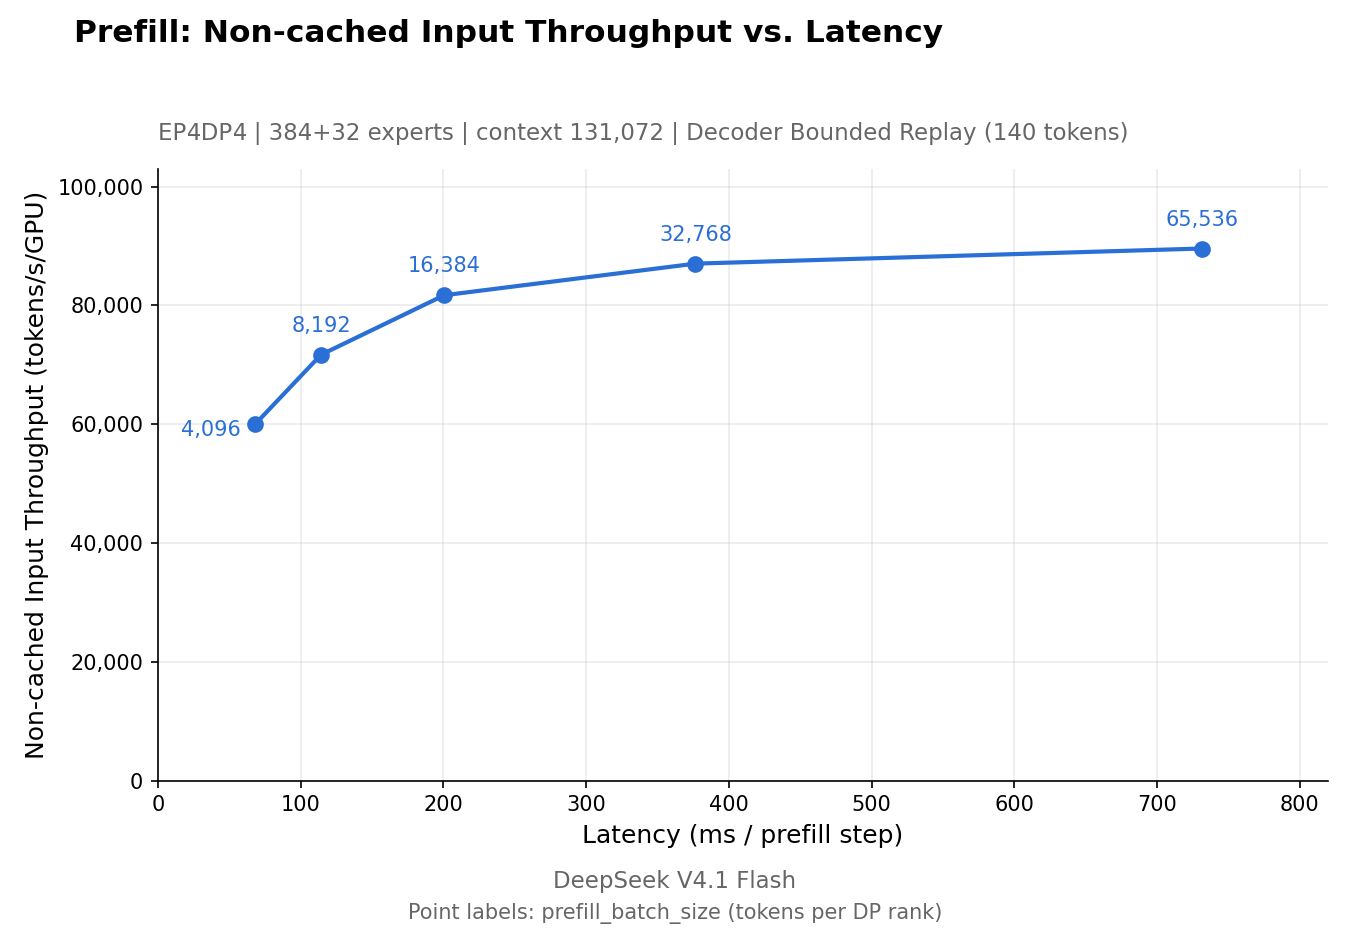
기사가 요약한 "4,096 → 65,536에서 처리량 6만 → 8만9천, 지연 70ms → 730ms"가 바로 이 곡선이다(그림 4). 16,384를 넘기면 처리량은 10% 남짓 더 오르는데 지연은 3.6배가 되니, 운영 지점은 보통 그 사이 어딘가일 것이다. 여기서 "처리량"은 examples/README.md가 정의하는 steady-state prefill throughput이다. 5개 워밍업 청크를 버리고 마지막 11개 샘플로 10개 구간을 잡아 토큰 수를 시간과 디바이스 수로 나눈 값이며, LB 통계 flush와 겹친 구간은 버린다.
Decode — context 131,072, nextn=3 고정, 점 라벨은 DP rank당 decode_num_requests.
| decode_num_requests (req/rank) | EP64DP64 (384+64 experts) 출력 처리량 (tok/s/GPU) | 사용자당 속도 (tok/s/user) | EP8DP8 (384+32 experts) 출력 처리량 | 사용자당 속도 |
|---|---|---|---|---|
| 8 | ≈ 2,600 | ≈ 325 | ≈ 1,900 | ≈ 238 |
| 16 | ≈ 5,000 | ≈ 314 | ≈ 3,600 | ≈ 230 |
| 32 | ≈ 9,500 | ≈ 297 | ≈ 7,000 | ≈ 220 |
| 64 | ≈ 15,700 | ≈ 246 | ≈ 12,600 | ≈ 198 |
| 128 | ≈ 22,800 | ≈ 178 | ≈ 19,100 | ≈ 150 |
| 256 | ≈ 26,200 | ≈ 103 | ≈ 24,900 | ≈ 98 |
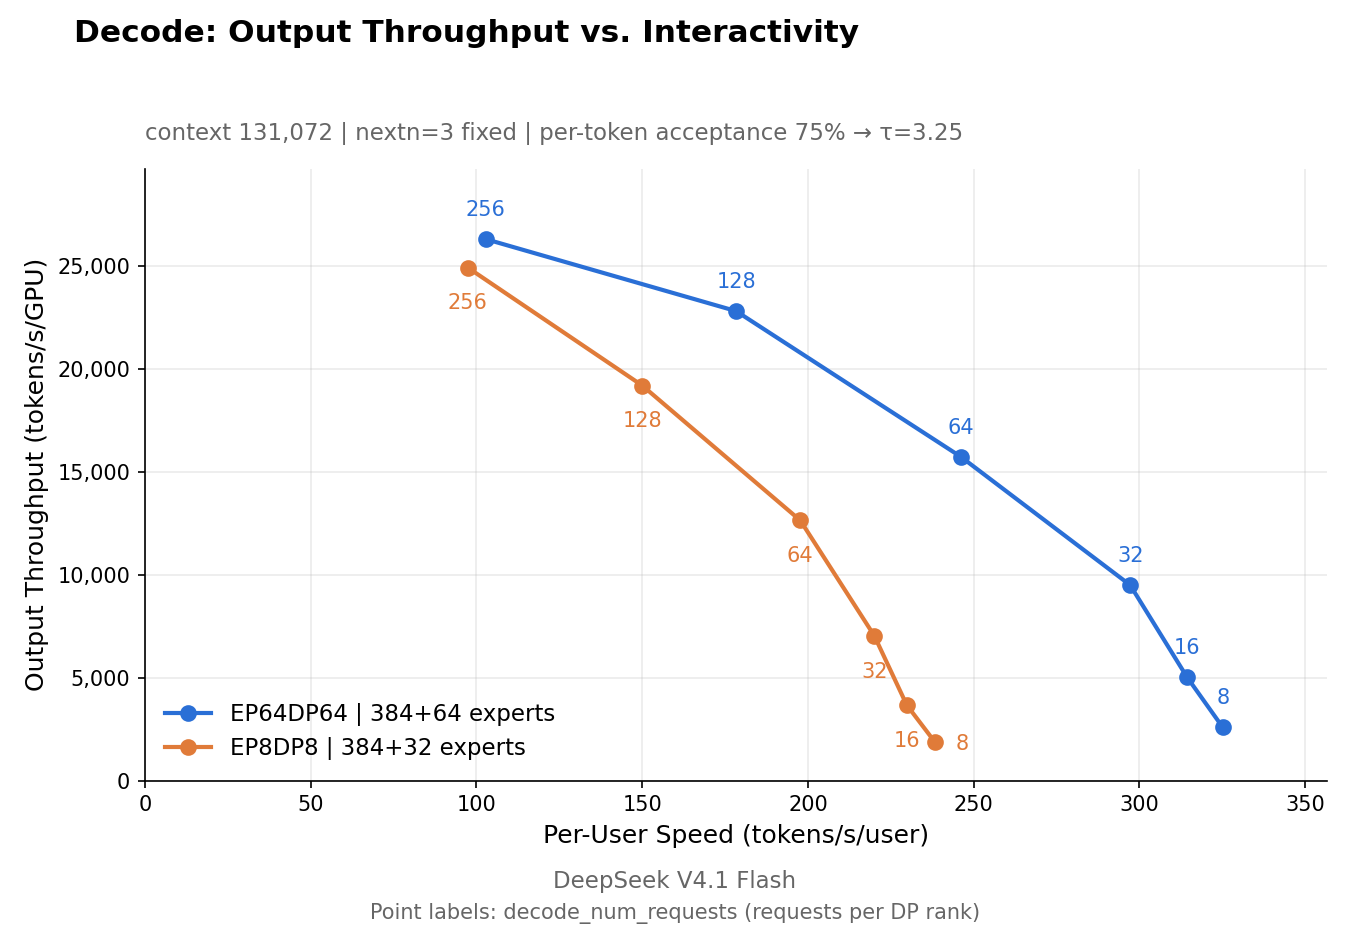
기사의 "rank당 256 동시 요청에서 GPU당 25,000 토큰/초 이상"은 그림 5의 EP64 곡선 맨 왼쪽 점이다. 같은 그림에서 Wide-EP의 효과도 읽힌다. 같은 GPU당 처리량이라면 EP64가 사용자당 속도를 더 높게 유지하고(64 요청에서 246 vs 198 tok/s/user), Q&A는 이를 "Wide-EP가 MoE 전문가 부분의 스텝당 메모리 트래픽을 크게 줄이기 때문"이라고 설명한다.
읽을 때 반드시 붙여야 할 조건이 몇 가지 있다.
- decode 처리량은 수용률을 가정해서 환산한 값이다.
plot_pareto.py는 측정된 스텝/초(decode_avg_sps)에 τ = 1 + nextn × draft_acceptance를 곱해 토큰 처리량을 만든다. 차트 부제의 "per-token acceptance 75% → τ=3.25"가 그 가정이고,benchmark.py자체는 "full-acceptance accounting"(실제 수용률과 무관하게 요청당 스텝당 1+nextn 토큰)으로 집계한다. 실제 수용률이 75%와 다르면 숫자도 달라진다. - 오프라인 벤치마크의 단일 단계 수치다. prefill 곡선은 비캐시 입력 처리량만, decode 곡선은 생성 단계만 본다. 요청 접수, 토크나이즈, 큐 대기, 캐시 조회, 네트워크 전송은 포함되지 않는다. Q&A도 "로드밸런싱을 포함한 실제 시스템은 완벽히 균형 잡힌 오프라인 벤치마크의 약 80%에 도달"한다고 쓴다.
- 독립 검증이 없다. 모두 DeepSeek이 자체 측정·공개한 수치이고, 같은 조건에서 다른 엔진과 비교한 결과는 저장소에 없다. "하루 155조 토큰"과 "GPU-시간당 38달러"는 Q&A 문서의 벤더 주장이며 측정 방법이 공개돼 있지 않다.
- SM100 외 하드웨어(Hopper 등)에서 어떻게 나오는지는 알 수 없다. 지원 자체가 SM100과 Ascend 950뿐이다.
🔍 기존 글과 연결: 무엇이 같고 무엇이 다른가
- PD 분리. PD 분리 글에서 "소규모 단일 노드에서는 오히려 손해"라고 썼는데, DeepSeek의 답은 반대 극단이다. Q&A의 프로덕션 구성은 VE/Prefill/Decode를 모두 분리하고, prefill은 8-GPU 머신, decode는 64–128 GPU 슈퍼노드로 자원 형태 자체를 다르게 가져간다. 다만 이번 공개판에는 분리 "엔진 기능 대부분"은 있지만 P→D KV 전송·라우팅 컴포넌트가 빠져 있어, 오픈소스 그대로는 PD 분리를 돌릴 수 없다.
- vLLM의 접근과 대비. vLLM 분해하기 글에서 vLLM은 NIXL·LMCache·Mooncake 같은 교체 가능한 KV connector와
/render·/derender프론트엔드 분리를 업스트림에 넣어 놓았다. DeepInfer는 그 자리에 자사 3FS 기반 kvcache-store와 Entrypoint 디렉터리가 들어가는데, 그 부분이 공개되지 않았다. vLLM이 "조립 키트"라면 DeepInfer는 "완성차에서 엔진만 떼어낸 것"에 가깝다. 또 그 글의 "P/D의 세일즈 포인트는 최대 처리량이 아니라 goodput"이라는 지적은 DeepInfer 벤치마크에도 그대로 적용된다. 공개된 곡선은 단계별 처리량-지연 곡선이지 SLO 기반 goodput이 아니다. - KV cache와 PagedAttention. PagedAttention 글의 블록 단위 관리가 여기서도 기본이다. Q&A에 따르면 prefill도 paged KV cache를 쓰고, block KV cache(메인 KV + indexer K)는 로컬 메모리가 아니라 전용 3FS 저장 클러스터(약 100 PiB SSD, 에이전트 트래픽 TTL 3일 / 챗봇 7일)에 둔다. 모든 prefill 머신이 어떤 프리픽스든 히트할 수 있게 해서 프리픽스 친화 라우팅과 로드밸런싱의 충돌을 없애려는 설계다. SWA KV cache는 별도 state 슬롯(20 레이어 × 134 토큰 × 528 B = 1,415,040 B/시퀀스)에 두고 128 토큰 단위 위치에서만 저장한다.
- 추측 디코딩. Speculative Decoding 글의 "드래프트 모델 선택이 성능을 좌우한다"에서 한 걸음 더 나가, DSpark는 "얼마나 검증할지"를 런타임에 결정한다. 그 결정이 비동기 스케줄링 때문에 GPU 커널로 내려간 점이 프로덕션 엔진다운 디테일이다.
- DeepSeek 계보. R1 글의 V3가 671B MoE였다면, 이번 대상은 V4.1-Flash다. HF 모델 카드 기준 safetensors 총 763B 파라미터, 컨텍스트 1M, 모델 라이선스는 MIT다(프레임워크는 Apache-2.0).
vLLM/SGLang과의 위치 차이를 한 단락으로 정리하면 이렇다. vLLM과 SGLang은 수백 개 모델과 여러 세대 하드웨어를 지원하는 범용 서빙 엔진이고, 서빙에 필요한 프론트엔드·라우터·KV 커넥터까지 업스트림에 갖고 있다. DeepInfer는 **모델 하나(V4.1-Flash), 하드웨어 두 종류(SM100, Ascend 950)**에 맞춰 커널부터 스케줄러까지 수직으로 최적화한 엔진이며, 범용성 대신 "DeepSeek이 실제로 쓰는 설정"을 그대로 내놓는 쪽을 택했다. README가 vLLM에서 출발했다고 밝힌 만큼, 이 저장소의 가치는 vLLM을 대체하는 것보다 "vLLM 계열 엔진을 특정 모델·하드웨어에 끝까지 밀어붙이면 어디까지 가는가"를 보여 주는 레퍼런스에 가깝다.
🛠️ 직접 돌려보기 (명령은 README 그대로, 실행은 하지 않음)
필요 하드웨어가 NVIDIA SM100 GPU 또는 Huawei Ascend 950 NPU이고, 기본 예제조차 --ep 8(8 디바이스)이 기본값이라 일반 환경에서는 돌릴 수 없다. 아래는 README와 examples/README.md의 명령을 그대로 옮긴 것이다.
요구사항: Linux, GCC ≥ 13.0, Python 3.12, CUDA 13(NVIDIA) 또는 CANN 9.2(Ascend). 빌드 전에 빈 Python 3.12 환경을 만들어 활성화해야 한다.
# Use `ascend` instead for the Ascend platform
# Keep it exported in the environment where you run DeepInfer
export DEEPINFER_ACCELERATOR=nvidia
./build.sh
build.sh는 requirements-nvidia.txt(torch 2.13.0+cu132 등)를 설치하고, NVIDIA에서는 NCCL을 2.32.3으로 고정한 뒤 scripts/build_vendor.sh로 vendored 커널 라이브러리를 빌드하고 DeepInfer 확장을 빌드한다.
# 기본 체크포인트 deepseek-ai/DeepSeek-V4.1-Flash-1017 을 첫 실행 시 HF 캐시로 내려받음
# 로컬 복사본을 쓰려면: DEEPINFER_HF_MODEL_DIR=/path/to/DeepSeek-V4.1-Flash-1017
python examples/offline_inference.py

# 병렬 구성 예시 (examples/README.md)
python examples/offline_inference.py --ep 8
python examples/offline_inference.py --ep 2 --dp 8
python examples/offline_inference.py --ep 2 --cp 8
벤치마크와 Pareto 스윕은 다음과 같다. 병렬 규모는 명령이 아니라 환경(ep_size = WORLD_SIZE × len(CUDA_VISIBLE_DEVICES))으로 정해진다.
export WORLD_SIZE=1 RANK=0
export CUDA_VISIBLE_DEVICES=0,1,2,3,4,5,6,7

python examples/benchmark.py
# 128k context + YoCo truncation (nightly profile configuration)
python examples/benchmark.py --decode_num_requests 64 --context_length 131072 --yoco_clip

# decode: sweep decode_num_requests (8…256), nextn=3, plot scaled by a draft acceptance rate of 0.75
bash examples/sweep/run_sweep.sh decode ce-128k 131072 3 0.75
# prefill: sweep prefill_batch_size (4096…65536)
bash examples/sweep/run_sweep.sh prefill pe-128k 131072
README가 언급하는 주요 환경 변수를 모아 두면 다음과 같다.
| 환경 변수 | 의미 (README) |
|---|---|
DEEPINFER_ENABLE_MTP_VARLEN=1 |
DSpark 가변 길이 검증 활성화 |
DEEPINFER_USE_NEXTN_DECODE |
최대 드래프트 길이 (기본 5, 0이면 추측 디코딩 끔) |
DEEPINFER_YOCO_PREFILL_TRUNCATION_MODE=compact, DEEPINFER_YOCO_PREFILL_KEEP_TOKENS=140 |
Decoder SWA bounded replay (V4.1 기본값) |
DEEPINFER_BATCH_INVARIANT=1 |
배치 구성과 무관하게 동일 결과 (NVIDIA 전용) |
DEEPINFER_BATCH_INVARIANT=1 DEEPINFER_ENABLE_MTP_VARLEN=0 + 고정 seq_seed |
deterministic sampling (NVIDIA 전용) |
📝 정리, 한계, 열린 질문
정리. DeepInfer는 DeepSeek V4.1-Flash를 SM100과 Ascend 950에서 돌리기 위한 프로덕션 엔진이다. FlashMLA(sparse attention, FP4 KV), DeepGEMM(FP8/FP4 GEMM, Mega MoE), DeepEP(EP 통신, 전문가 가중치 셔플)를 submodule로 품고, 그 위에 DSpark 가변 길이 검증, SWA bounded replay, Wide-EP + EPLB, 비동기 스케줄링, xgrammar 기반 구조화 출력을 얹었다. 공개된 수치는 prefill 4 GPU에서 최대 약 89k tok/s/GPU, decode 64 GPU에서 rank당 256 요청 시 약 26k tok/s/GPU다.
한계. (1) 범위가 오프라인 추론이고 KV cache 시스템·PD 분리·로드밸런서가 빠져 있어, 이것만으로 서비스를 띄울 수는 없다. (2) 지원 모델이 하나, 하드웨어가 두 종류다. 다른 모델을 올리려면 모델 코드를 직접 써야 한다. (3) 벤치마크는 자체 측정이고, decode 수치는 수용률 75% 가정으로 환산한 값이며, 타 엔진과의 동일 조건 비교는 없다. (4) 기사에 따르면 DeepSeek은 X에 "커뮤니티가 연산 비용과 에너지를 줄이도록 실제 프로덕션 스택을 공유한다"는 취지의 글을 올렸다고 하는데, 해당 게시물 원문은 이 글을 쓰는 시점에 직접 확인하지 못했다.
열린 질문. 빠진 세 컴포넌트가 언제, 어떤 형태로 공개될까. Q&A는 "향후 DeepSeek 모델의 추론 코드와 후속 성능 작업은 계속 DeepInfer에 공개하겠다"고 하지만, KV cache 스토어와 로드밸런서는 "내부 인프라에 결합돼 있다"는 이유로 미뤄져 있다. 또 하나, 이 엔진이 vLLM에서 갈라져 나왔다면 DSpark의 confidence-scheduled verification이나 bounded replay 같은 아이디어가 역으로 vLLM/SGLang 업스트림에 들어갈지도 지켜볼 만하다. 벤더가 모델 하나에 맞춰 끝까지 조인 엔진과, 범용 엔진 사이의 성능 격차가 실제로 얼마나 되는지는 제3자 벤치마크가 나와야 답할 수 있다.
📚 참고
- DeepInfer 저장소: github.com/deepseek-ai/DeepInfer — README,
doc/inference_deployment_qa.md,examples/README.md,examples/sweep/run_sweep.sh,examples/sweep/plot_pareto.py,examples/yoco/README.md - 컴포넌트 저장소: FlashMLA, DeepGEMM, DeepEP, deepseek-recipe
- 모델: deepseek-ai/DeepSeek-V4.1-Flash-1017
- 기사: 박찬, 딥시크, AI 운영 비용 낮출 핵심 추론 기술 '딥인퍼' 오픈소스 공개, AI타임스, 2026-10-21
- 블로그 관련 글: Speculative Decoding · KV Cache 완전 정복 · PD 분리 · vLLM 분해하기 · PagedAttention · DeepSeek R1
본 글의 그림 1, 4, 5는 DeepInfer 저장소(
doc/images/)에서 가져왔고, 그림 2, 3은 저장소 문서의 수치와 설명을 바탕으로 직접 그렸습니다. 벤치마크 수치는 모두 DeepSeek 자체 측정값입니다.