텍스트 대신 KV 캐시를 주고받는 에이전트: SwaT(Swarm Telepathy) 논문 리뷰
"요약은 그 저자가 쓰기로 한 것과 독자가 복원할 수 있는 것에 묶여 있다. 그런데 송신 모델 안에는 이미 훨씬 풍부한 표현, 즉 KV 캐시가 계산돼 있다." — 논문 1절
2026년 10월 10일 MIT CSAIL과 MIT-IBM 연구소의 Abdulrahman Alabdulkareem 등 6명이 Swarm Telepathy: Prefill-Free KV-Cache Transfer Across Families(arXiv 2610.15095)를 공개했고, 11월 1일 AI타임스가 "AI 모델끼리 글 없이 소통하는 스웜 텔레파시"라는 제목으로 보도했다. 코드는 github.com/Ar-Kareem/SwaT에 올라와 있다(2026년 10월 10일 생성, 학습·평가 스크립트와 walkthrough 노트북 포함, 라이선스 파일은 아직 없다). 멀티 에이전트 시스템이 스스로 조직을 짜고 논문을 에이전트로 바꾸는 단계까지 왔지만, 에이전트 사이의 통신은 여전히 "한 모델이 텍스트를 쓰고 다른 모델이 읽는" 방식이다. 이 논문은 그 통로 자체를 바꾸자고 제안한다.
원문: https://arxiv.org/abs/2610.15095
🤔 배경: 텍스트 핸드오프는 왜 병목인가
에이전트 A가 긴 문서를 읽고 결과를 요약해 에이전트 B에 넘기는 흐름을 생각해 보자. 논문은 이 텍스트 간 통신(T2T) 의 비용을 두 가지로 나눈다. 첫째, 송신 모델이 요약을 디코딩해야 한다. 토큰을 하나씩 생성하는 자기회귀 과정이라 느리다. 둘째, 수신 모델이 그 요약을 prefill해야 한다. 처음부터 다시 읽는 것이다. 여기에 정보 손실이 겹친다. 수신 모델이 아는 것은 송신 모델이 요약에 적기로 한 것뿐이다.
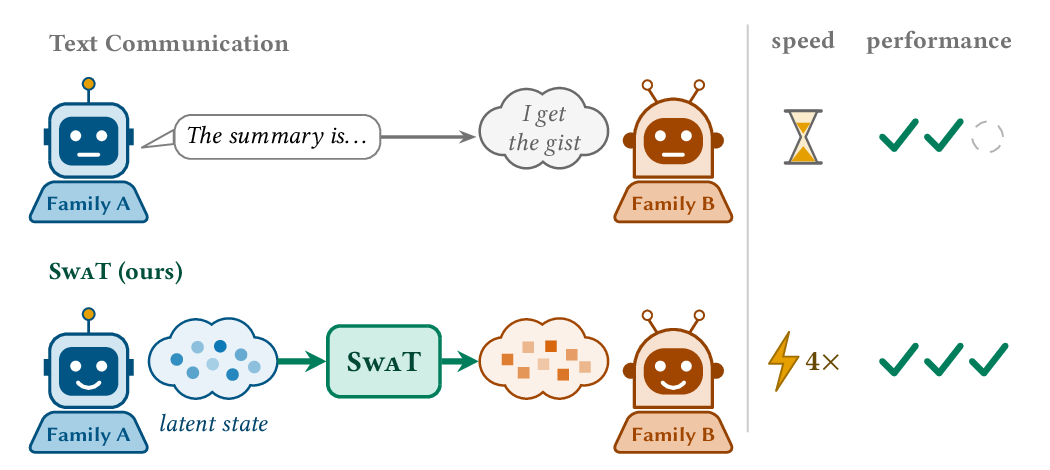
KV 캐시 1분 설명. 트랜스포머는 입력 토큰을 처리하면서 각 층의 attention에 쓰일 key와 value 벡터를 계산해 저장한다. 이것이 KV 캐시이고, 디코딩 단계에서 모델은 앞서 읽은 문맥을 오직 이 캐시를 통해서만 본다. 즉 캐시는 "지금까지 읽은 것의 모든 층, 모든 토큰에 대한 내부 상태"이며, 다음 토큰을 만드는 데 필요한 전부다. 서빙 쪽에서는 이 캐시를 어떻게 줄이고 재사용할지가 오랜 주제였고, prefill과 decode를 다른 GPU로 분리하는 구조에서는 이미 캐시가 머신 사이를 오간다. 다만 그 캐시는 항상 같은 모델의 것이었다.
캐시를 다른 모델에 넘기는 연구도 이미 있다. 논문의 표 1에 따르면 Closed Form, CacheBridge, KV Alignment, Dense Latent 같은 방법은 수신 모델의 prefill을 생략하지만 같은 계열(예: Qwen 3의 4B와 14B) 안에서만 작동하고, Cache-to-Cache나 XKV는 계열을 넘지만 수신 모델이 텍스트를 prefill한 뒤 캐시를 보태는 방식이다. 같은 계열은 같은 팀이 비슷한 데이터로 학습하고 작은 모델은 증류된 경우가 많아 내부 상태가 닮아 있다. 서로 다른 회사가 다른 토크나이저, 다른 층 수, 다른 head 구성으로 만든 모델 사이에서, 그것도 텍스트 없이 캐시만으로 통신할 수 있는가. 논문이 "계열 간 + prefill-free"를 동시에 만족하는 첫 방법이라고 주장하는 지점이 여기다. 근거로 드는 것은 Platonic Representation Hypothesis다. 같은 세계를 학습한 모델은 무엇을 표현하는지는 수렴하고 어떻게 표현하는지만 다르다면, 계열 간 통신은 결국 매핑 함수를 배우는 문제로 줄어든다.
🧠 핵심 아이디어: 번역기 하나, 두 모델은 고정
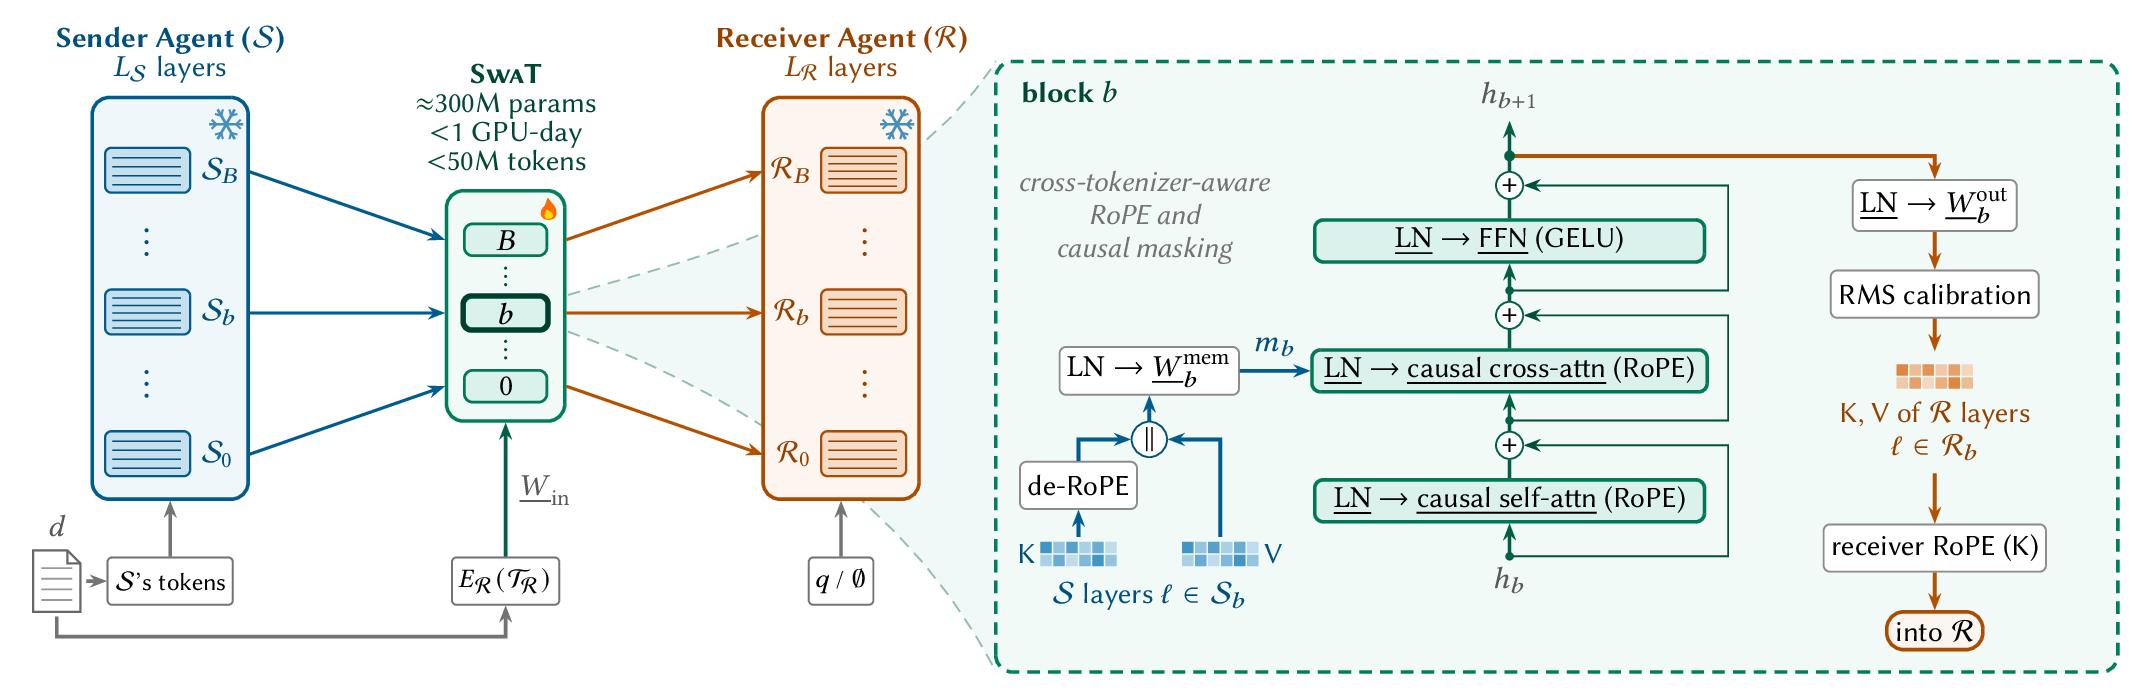
SwaT는 송신 모델 와 수신 모델 사이에 놓이는 학습된 매퍼 다. 송신 모델이 문서 를 한 번 prefill해 캐시 를 만들면, 매퍼가 이를 수신 모델의 캐시 공간으로 옮기고, 수신 모델은 그 위에서 자기 질문 만 읽고 바로 디코딩한다.
수신 모델은 원문 를 한 번도 보지 않는다. 이것이 "prefill-free"의 뜻이다. 두 LLM은 모두 동결되고 매퍼만 학습된다. 구조는 다음과 같다.
- 층 그룹화. 송신·수신 모델의 KV 층을 각각 개의 연속 그룹으로 나눈다(). 블록 는 송신 그룹 의 캐시를 읽고 수신 그룹 의 캐시를 내놓는다. 그래서 층 수가 달라도 되고, 수신 층 하나가 여러 송신 층을 참고할 수 있다.
- 입력. 매퍼의 초기 은닉 상태는 문서를 수신 모델 토크나이저로 자른 뒤 수신 모델의 동결된 임베딩 테이블을 조회한 것이다(FLOP 0). 송신 캐시는 RoPE를 제거한 key와 value를 head·층 방향으로 이어 붙여 선형 투영한 메모리 가 된다.
- 블록. causal self-attention → 에 대한 causal cross-attention → GELU FFN. 폭 , head 16, FFN 4096으로 약 3억 파라미터다.
- 출력. 블록 출력을 선형 투영해 그룹 내 모든 수신 층의 K·V를 예측하고, 학습 문맥에서 측정한 수신 캐시의 RMS 통계로 층·head별 스케일을 맞춘 뒤 수신 모델의 RoPE를 key에 적용한다. Gemma처럼 슬라이딩 윈도우 층이 있는 모델은 송신 쪽이면 윈도우 밖 캐시도 강제로 기록해 입력으로 쓰고, 수신 쪽이면 전체를 예측한 뒤 평소대로 오래된 캐시를 버리게 한다.
계열 간 전송의 실제 난관은 토크나이저다. 같은 문장을 Qwen과 Llama는 다른 수의 토큰으로 자르고 경계도 다르다. SwaT는 두 모델의 토큰화를 그대로 두고, cross-attention에서만 문자 구간(character span) 으로 둘을 맞춘다. 송신 토큰의 문자 중점이 수신 토큰 의 구간 어디쯤에 떨어지는지로 실수 위치를 계산해 RoPE를 걸고(두 토크나이저가 같으면 로 환원된다), 수신 토큰 는 문자 끝이 의 끝보다 앞서는 송신 토큰만 볼 수 있게 causal mask를 건다. 저자들은 Cache-to-Cache의 토큰 정렬 방식이 불일치 토큰을 버려 정보를 잃는 것과 대비시키는데, 그 정렬을 SwaT에 끼우면 13개 벤치마크 평균이 3.2점 떨어진다(표 18).
📐 학습 방법과 비용
학습 목표는 둘이다. 첫째, 수신 모델이 같은 문서를 직접 prefill했을 때의 캐시 를 재구성하는 RMS 정규화 MSE(key는 RoPE 적용 전 비교). 둘째, 전송된 캐시 위에서 과제 프롬프트 다음에 정답 또는 추론 흔적 가 나올 다음 토큰 NLL이다.
기울기는 동결된 수신 모델을 통과해 매퍼에만 닿는다. 순서는 MSE 5,000스텝(PG-19, WikiText-103, QASPER·QuALITY·HotpotQA·MuSiQue 학습 분할, 피크 LR 코사인) 뒤 NLL 24,000스텝(ARC-C, HellaSwag, WinoGrande, MMLU auxiliary, GSM8K와 수신 모델이 생성한 추론 흔적 추가, 상수 LR )이다. AdamW, bf16. 학습 데이터는 전부 영어 텍스트이고 고유 토큰 44M이다. 표 18의 절제 실험이 이 두 단계가 모두 필요하다는 것을 보여준다. MSE만 쓰면 −37.0점, NLL만 써도 −37.0점, dense loss만 쓰면 −55.1점, 블록 대신 head별 MLP를 쓰면 −14.7점이다.
비용은 논문 표현으로 < 1 GPU-day, 그림 2 설명에는 "6 GPU-hours 미만"이라고 적혀 있다. 다만 저장소 README는 학습 시 송신 모델과 수신 모델을 각각 다른 GPU에 올려 GPU 2장을 쓴다고 안내한다. 기사가 쓴 "단일 GPU 기준 하루 미만"은 GPU-day라는 단위를 풀어 쓴 것이지 GPU 한 장으로 돌렸다는 뜻은 아니다.
계산량 자체도 작다(표 6). Qwen 3 4B → Llama 3 8B 쌍에서 수신 모델이 직접 재-prefill하는 것과 비교하면 FLOP는 64토큰에서 24.7배, 64K 토큰에서 8.2배 적고, 지연은 1K 미만에서 약 10배, 64K에서 6.1배 빠르다. 수신 모델을 14B로 키우면 재-prefill 비용은 크게 늘지만 SwaT 비용은 거의 그대로다. 매퍼 크기가 수신 모델 크기와 무관하기 때문이다.
📊 실험
모델. Qwen 3, Llama 3, Gemma 2/3, Ministral 3, Granite 3, SmolLM3의 6개 계열, 3B~32B의 12개 모델. 쌍은 모두 계열을 넘도록 10개를 골랐고, 7개는 작은 송신 → 큰 수신, 3개는 큰 송신 → 작은 수신이다. 벤치마크는 17개로, 학습 분할을 본 in-domain 9개와 전혀 보지 않은 OOD 8개(MedQA, OpenBookQA, MATH-500, BoolQ, RACE, LongHealth, SQuAD, NarrativeQA)다. 짧은 과제는 문제 전체를 송신 모델이 읽고 수신 모델은 빈 입력, 긴 문맥 과제는 문맥을 송신 모델이, 질문을 수신 모델이 읽는다. 모두 greedy decoding.
유지율: 남의 캐시로 풀어도 자기 점수의 90% 이상
표 2의 retention은 "수신 모델이 직접 텍스트를 읽고 푼 점수" 대비 "송신 모델 캐시를 SwaT로 받아 푼 점수"의 비율이다. 10쌍 평균을 옮기면 다음과 같다.
| 방향 | 송신 → 수신 | 평균 유지율 |
|---|---|---|
| 작은 → 큰 | Qwen 3 4B → Llama 3 8B | 98.5% |
| Llama 3 8B → Qwen 3 14B | 97.5% | |
| Ministral 3 8B → Llama 3.2 11B | 99.4% | |
| Gemma 3 4B → Granite 3.3 8B | 108.5% | |
| Qwen 3 4B → Gemma 2 9B | 94.2% | |
| Gemma 2 9B → Ministral 3 14B | 102.8% | |
| Gemma 3 4B → Llama 3 8B | 92.2% | |
| 큰 → 작은 | Gemma 3 12B → Qwen 3 4B | 104.6% |
| Qwen 3 32B → Llama 3 8B | 103.0% | |
| Granite 3.3 8B → SmolLM3 3B | 143.2% |
작은 모델의 캐시로 큰 모델이 풀어도 최저 평균 유지율이 90%를 넘고, 큰 모델의 캐시를 받는 작은 모델은 모두 100%를 넘는다. 특히 긴 문맥 F1 과제에서 유지율이 100%를 크게 넘는 칸이 많은데(Granite → SmolLM3의 in-domain F1 253.6%), 작은 수신 모델이 큰 송신 모델의 문맥 이해를 빌려 쓰는 셈이다. 반대로 OOD 짧은 과제의 정확도는 73~113%로 흔들리고, 저자들은 MATH-500처럼 LaTeX 형식 답을 요구하는 과제가 GSM8K 숫자 답으로 학습한 매퍼에 특히 어렵다고 적었다.
같은 조건에서 다른 전송 방법과 비교한 표 7이 "계열 간"의 어려움을 보여준다. 세 쌍 모두 토크나이저 정렬을 붙여 주고 3개 시드로 학습한 17개 벤치마크 평균이다.
| 송신 → 수신 | 관계 | Closed Form | Dense Latent | SwaT |
|---|---|---|---|---|
| Qwen 3 4B → Qwen 3 8B | 같은 계열 | 59.9 | 73.5 | 72.3 |
| Qwen 3 4B → Qwen 2 7B | 세대 교차 | 41.0 | 47.3 | 68.1 |
| Qwen 3 4B → Llama 3 8B | 계열 교차 | 30.5 | 43.5 | 63.5 |
같은 계열 안에서는 Dense Latent가 SwaT보다 1.2점 높다. 그러나 세대를 넘으면 20점, 계열을 넘으면 20점 이상 SwaT가 앞선다. 기존 방법들이 "캐시 기하가 비슷하다"는 전제에 기대고 있었다는 뜻이다.
텍스트 요약 대 캐시 전송: 같은 예산에서 +15~19점, 4배 속도
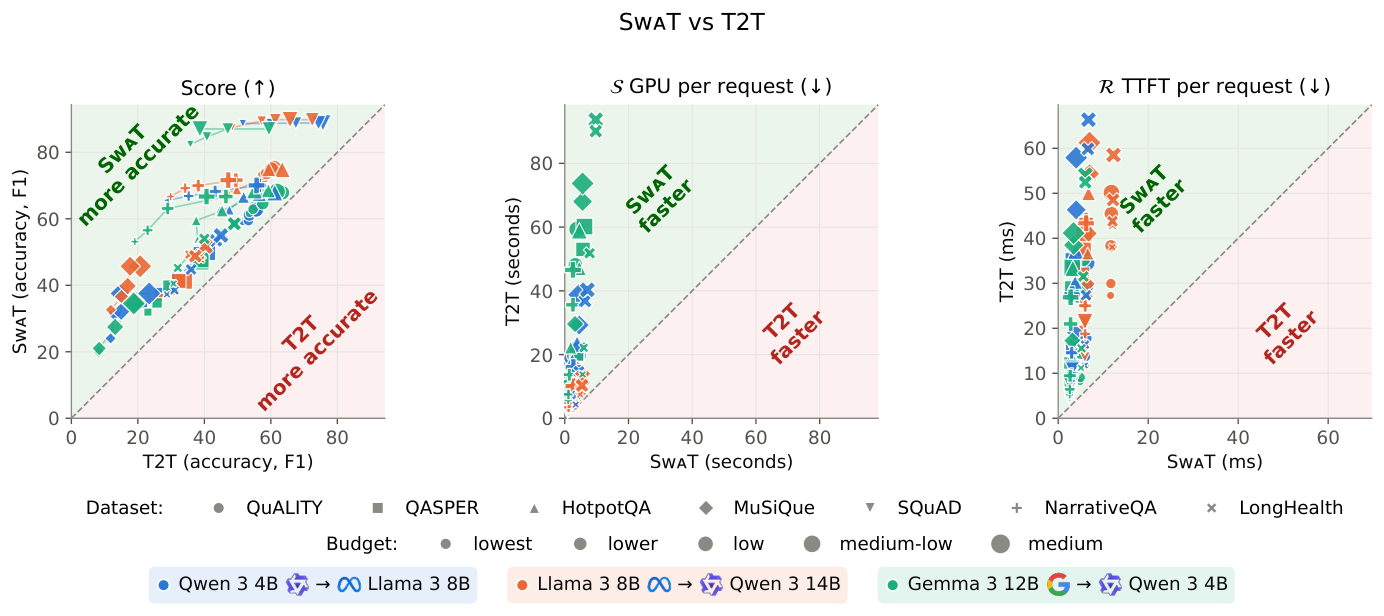
실제 에이전트 핸드오프를 흉내 낸 실험이다. 송신 모델이 문서 를 읽고, 수신 모델이 질문 에 답한다. T2T는 송신 모델이 다섯 가지 길이의 프롬프트로 요약을 쓰고 수신 모델이 요약과 질문을 prefill한다. SwaT+AM은 송신 캐시를 SwaT로 옮긴 뒤 Attention Matching으로 요약과 같은 토큰 수까지 압축하고, 수신 모델은 질문만 prefill한다. 7개 QA 데이터셋(QuALITY, QASPER, HotpotQA, MuSiQue, SQuAD, NarrativeQA, LongHealth) × 3쌍 × 5예산이다. 표 3의 전체 평균을 옮긴다.
| 쌍 | 점수 T2T → SwaT | 토큰 | 송신 GPU 시간 | 수신 TTFT |
|---|---|---|---|---|
| Qwen3 4B → Llama3 8B | 42.9 → 57.8 (+14.9) | 293 → 254 | 8,752 → 2,150 ms (×4.1) | 18.0 → 4.0 ms (×4.5) |
| Llama3 8B → Qwen3 14B | 42.9 → 61.9 (+19.0) | 269 → 243 | 6,198 → 2,360 ms (×2.6) | 31.8 → 7.5 ms (×4.3) |
| Gemma3 12B → Qwen3 4B | 38.0 → 56.2 (+18.2) | 309 → 269 | 19,761 → 2,888 ms (×6.8) | 14.1 → 3.4 ms (×4.2) |
"정확도 40% 향상"은 상대값이다. 약 40점에서 약 58점으로 오르니 비율로 1.4배이고, 절대 점수로는 1519점이다. 예산이 가장 빡빡한 "lowest"(12.717.2배 압축)에서 격차가 가장 커서 Llama → Qwen 쌍은 37.2 → 58.6이다. 요약이 짧을수록 텍스트는 버리는 것이 많아지지만 캐시 압축은 attention의 영향력을 보존하기 때문이다. "4배"는 송신 GPU 시간과 수신 TTFT를 각각 잰 것으로, 송신 쪽은 ×2.6~×6.8, 수신 쪽은 ×4.2~×4.5다. 송신 쪽 절약이 큰 이유는 요약을 디코딩하지 않아도 되기 때문이고, 큰 송신 모델(Gemma 3 12B)일수록 그 절약이 커진다.
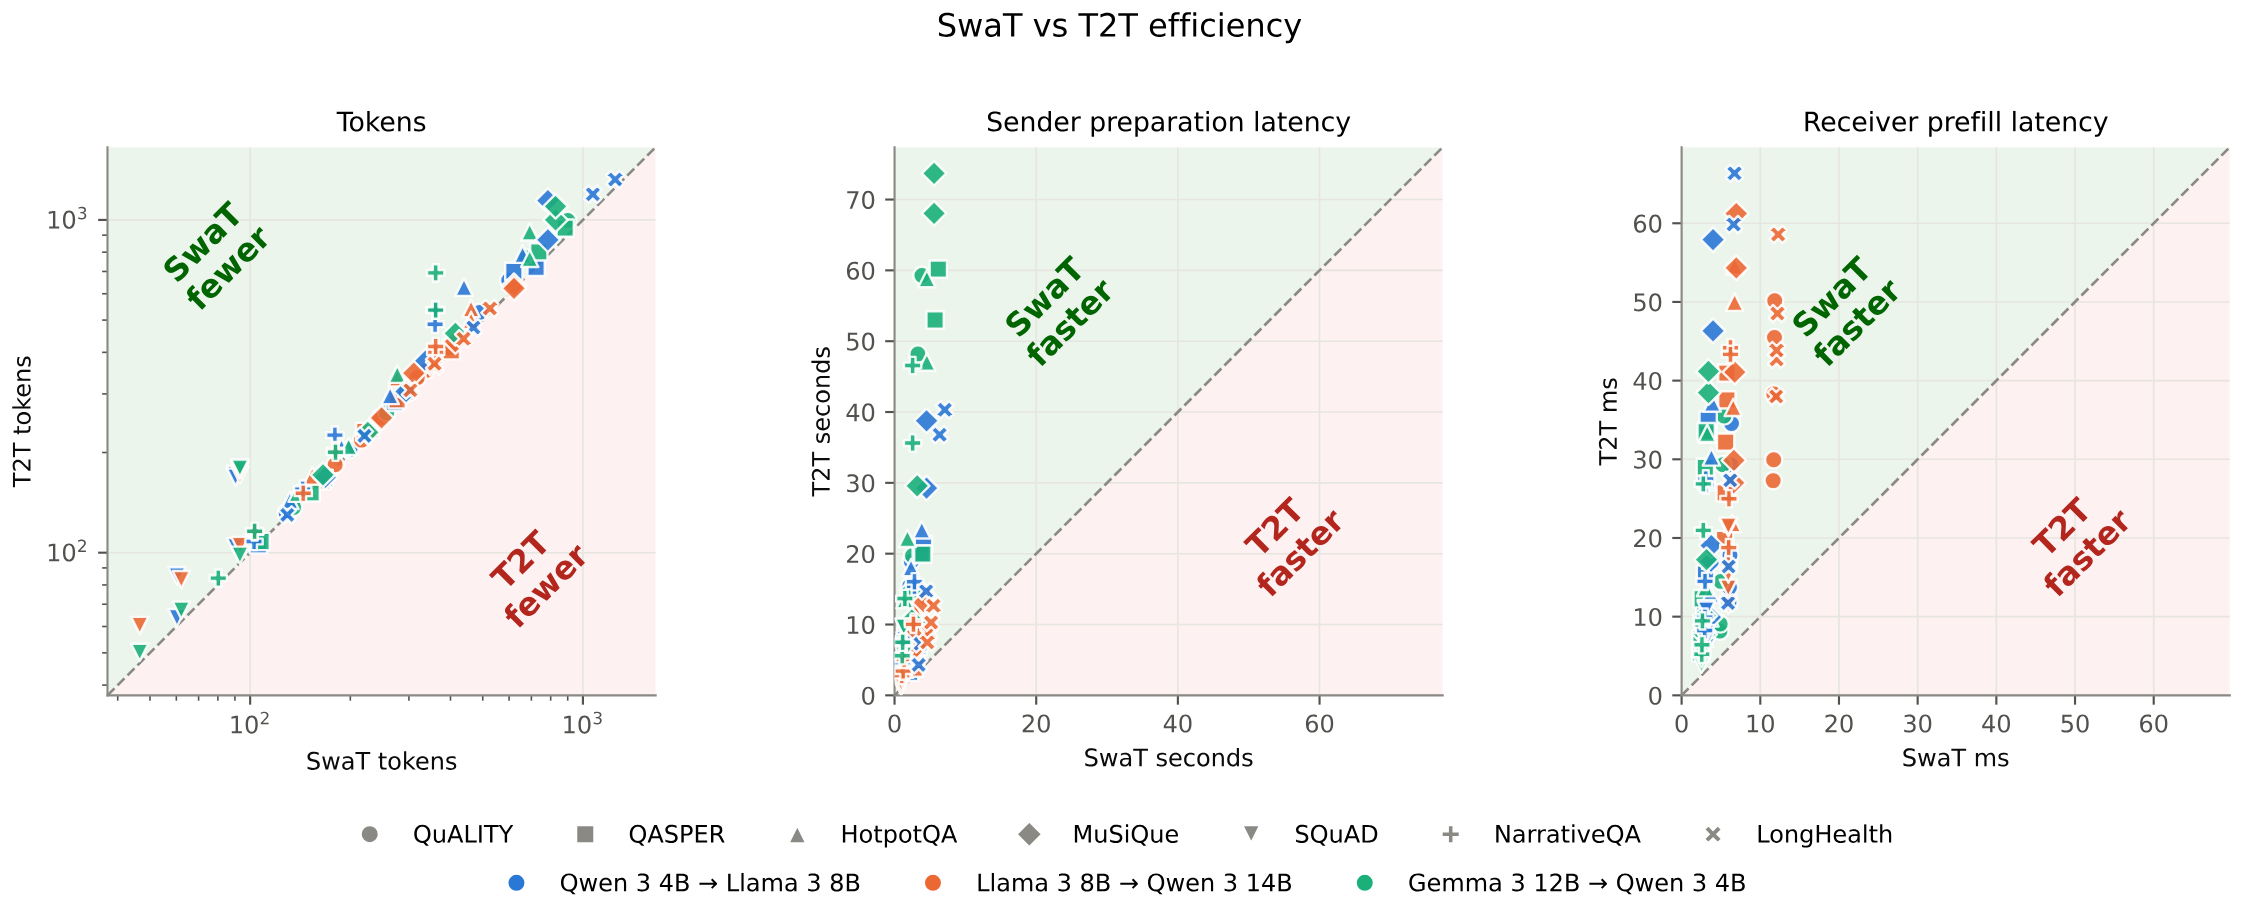
그림 4(논문 부록 Figure 4)는 셀 단위 전부를 찍은 것이다. 토큰 축에서 점이 대각선에 붙어 있는 것은 설계상 예산을 맞췄기 때문이며, 실제로는 SwaT 쪽이 10~26% 적은 토큰을 쓴다. 지연 축에서는 예외가 없다.
영어 텍스트만 배운 번역기가 시각과 중국어를 옮긴다
이미지 → 텍스트 전용 모델. 송신은 Gemma 3 VLM, 수신은 텍스트 전용 LLM이다. VLM이 이미지를 보고 짧은 캡션 를 쓴다. T2T는 수신 모델이 캡션만 읽고 답하고, SwaT는 VLM이 이미지와 캡션을 함께 prefill한 뒤 캡션 부분의 캐시(이미지 정보가 attention으로 스며든 상태)만 옮긴다. 5개 VQA 벤치마크 평균(표 4)에서 Gemma 3 4B → Granite 3.3 8B는 T2T 21.1 대 SwaT 41.6이고, 송신 VLM이 직접 답한 34.2보다도 높다. Gemma 3 4B → Llama 3 8B도 13.3 → 39.6이다. SwaT는 VLM 데이터를 본 적이 없다. 다만 저자들이 부록 G에서 덧붙이듯, 글자가 빽빽한 DocVQA·InfoVQA에서는 송신 VLM 57.4 대 SwaT 37.5로 크게 뒤지고, Gemma 3 12B → Qwen 3 4B 쌍에서는 T2T(38.7)보다도 낮다(29.0). 시각 능력이 통째로 옮겨지는 것은 아니다.
중국어 지식. Qwen 3 4B는 CMMLU 67개 과목 전체 평균에서 Llama 3 8B보다 약 20점 높다(69.7 대 51.2). Qwen이 문제를 읽고 캐시를 Llama에 넘기면 Llama는 65.1로 올라 격차의 약 4분의 3을 메운다. 예시로 든 과목에서는 Arts 55.6 → 88.8, 개념물리 45.6 → 73.5다. 기사는 "67개 과목 전체에서 성능을 높였다"고 썼는데, 논문의 표 5는 67과목 합산 점수와 4개 과목 예시만 싣고 있어 과목 하나하나가 모두 올랐는지는 확인할 수 없다.
문맥 창 넘기(부록 F). 32K 문맥의 Qwen 3가 28K 토큰 문서를 prefill한 뒤 캐시를 8K 조각으로 잘라 각각 SwaT+AM으로 옮기고 합치면, 8K 문맥의 Llama 3 8B가 F1 41.9를 낸다. Llama가 8K로 잘라 읽으면 13.3, Qwen이 직접 풀면 36.8이다. 조각을 나누는 것이 송신 모델의 prefill 이후라 조각 사이의 의존 관계가 캐시에 남아 있다는 것이 저자들의 설명이다.
🔍 한계와 비판적 읽기
저자가 밝힌 한계. 첫째, 송신·수신 쌍마다 매퍼가 필요하다. 개 계열이면 개이고, 공유 잠재 공간을 두어 개로 줄이는 것을 후속 과제로 꼽는다. 둘째, 실험은 전부 1회 핸드오프다. 반복 전송이나 여러 메시지를 하나로 합치는 것은 캐시가 텍스트처럼 합성 가능하지 않아 열려 있다. 셋째, 전송된 캐시에는 원문에 명시되지 않은 정보가 담길 수 있어 감사 가능성과 안전성 연구가 필요하다고 적었다.
버전이 바뀌면 다시 학습해야 한다. 매퍼는 특정 체크포인트 두 개의 캐시 기하에 맞춰져 있다. 표 7에서 Qwen 3 → Qwen 2처럼 같은 회사의 한 세대 차이조차 기존 방법에는 계열 간 전송만큼 어려웠다. 실제 서비스에서 모델은 분기마다 바뀌고, 그때마다 쌍의 수만큼 재학습이 따라온다. 학습이 싸다는 것(< 1 GPU-day)이 이 한계의 완충재인데, 그 비용이 수신 모델 크기에 따라 어떻게 커지는지는 32B 송신까지만 보여 준다.
감사 가능성은 텍스트가 남아 있을 때만 성립한다. 저자들은 "현재 구현은 송신 측 텍스트가 있으므로 텍스트 기반 모니터링이 가능하다"고 썼다. 하지만 이 방법의 매력은 바로 수신 모델이 텍스트를 읽지 않는다는 데 있고, 압축된 캐시가 한 번 더 전달되면 원문과의 대응은 끊긴다. 시각 실험이 보여 주듯 캐시는 캡션에 적히지 않은 이미지 정보를 실어 나른다. 그 장점은 그대로 "로그에 없는 정보가 에이전트 사이를 오간다"는 뜻이기도 하다.
측정 범위. T2T 비교는 7개 독해 QA 데이터셋이고, 기사가 쓴 "대화 벤치마크"는 없다. 에이전트가 실제로 주고받는 것은 도구 호출 결과, 코드, 중간 추론이고, 수신 모델이 송신 모델의 결론이 아니라 문맥 전체를 넘겨받는 설정이다. 또 T2T의 요약 품질은 3B~12B 송신 모델이 쓴 것이라, 요약을 잘 쓰는 큰 모델을 송신으로 두면 격차가 줄 수 있다. 속도 수치는 배치 16의 TTFT와 요청당 송신 GPU 시간이고, 네트워크로 캐시를 옮기는 비용은 포함되지 않았다. 3억 파라미터 매퍼의 출력은 수신 모델 전 층의 K·V이므로 전송량은 요약 텍스트보다 훨씬 크다.
서빙 쪽과의 관계. PD disaggregation은 같은 모델의 캐시를 prefill 노드에서 decode 노드로 옮기고, prefix caching은 같은 모델이 같은 접두어를 다시 읽지 않게 한다. SwaT는 여기에 "다른 모델이 이어받는다"는 축을 더한다. 논문이 든 용례가 바로 그것이다. 라우터가 읽은 질의 캐시를 선택된 모델에 넘기기, 대화 도중 모델을 바꿀 때 재-prefill 건너뛰기. 다만 지금의 SwaT는 송신 모델의 전체 prefill 캐시를 입력으로 받으므로 송신 쪽 비용은 그대로이고, 이득은 송신 디코딩과 수신 prefill을 없애는 데서 온다. 캐시 압축(AM) 없이는 토큰 수가 줄지 않는다는 점도 기억해 둘 만하다.
📝 정리
SwaT가 보여 준 것은 세 가지다. 서로 다른 회사의 모델 사이에서도 약 3억 파라미터의 번역기 하나로 캐시를 옮길 수 있고(17개 벤치마크에서 수신 모델 자체 점수의 92143%), 그 캐시를 압축해 넘기면 같은 토큰 예산의 텍스트 요약보다 1519점 높으면서 송신·수신 양쪽이 수 배 빠르며, 영어 텍스트로만 학습한 번역기가 이미지와 중국어처럼 수신 모델에 없던 능력까지 일부 옮긴다는 것이다. Platonic Representation Hypothesis의 실용적 검증으로 읽어도 흥미롭다.
남는 질문은 이 통로를 시스템으로 만들 수 있느냐다. 쌍마다 번역기, 버전마다 재학습, 1회 핸드오프, 그리고 텍스트 로그 바깥을 흐르는 정보. 에이전트 하네스 시리즈에서 보았듯 멀티 에이전트의 비용 대부분은 같은 문맥을 반복해서 읽는 데서 나오고, 이 논문은 그 반복을 없앨 수 있다는 첫 증거다. 공유 잠재 공간이 실제로 만들어진다면 "에이전트 간 프로토콜"의 단위가 토큰에서 캐시로 바뀔 수도 있다.
📚 참고
- 원문: Swarm Telepathy: Prefill-Free KV-Cache Transfer Across Families (Abdulrahman Alabdulkareem, Irene Tenison, Yang Zhang, Yada Zhu, Boris Katz, Dan Gutfreund; MIT CSAIL·MIT-IBM, arXiv 2610.15095, 2026.10.10) · HTML
- 코드: github.com/Ar-Kareem/SwaT (학습·평가 스크립트
scripts/exp1, T2T 비교scripts/exp2, 절제·시각·보안 해석 실험 폴더,basic_swat_walkthrough.ipynb) - 기사: MIT, AI 모델끼리 글 없이 소통하는 '스웜 텔레파시' 개발 (AI타임스, 박찬 기자, 2026.11.01)
- 결합한 캐시 압축: Zweiger et al., Attention Matching (2026)
- 비교 대상: Heo et al., Closed-form cross-model KV transfer; Chen et al., Dense latent communication; Fu et al., Cache-to-Cache (ICLR 2026)
- 이 블로그의 관련 글: KV 캐시 최적화 가이드 · PD disaggregation · AgenSH · Paper2Agent
본 글의 그림은 원문과 공식 저장소(
assets/teaser.png,assets/architecture.png)에서 가져왔습니다.