Jev: 텍스트 대신 '확률 붙은 답 하나'를 돌려주는 System One 결정 모델
"대부분의 소프트웨어가 AI에게 원하는 건 글이 아니라
if문에 넣을 값 하나다."
2026년 9월 15일, 샌프란시스코의 TypeSafe AI가 Jev 라는 모델을 공개했다. 이름부터 낯선 이 모델의 특징은 하나다. 문장을 생성하지 않는다. 호출자가 상태(state)와 함께 "답은 이 중 하나"라는 집합을 넘기면, Jev는 그중 하나를 확률 분포와 함께 돌려준다. TypeSafe는 이것을 System One 모델이라는 새 범주로 부른다.
출시 일주일 만에 GitHub에 1,865개의 신규 저장소가 생겼다는 분석 논문(Sun Yat-sen Univ. 등, Jev in the Wild)과, LLM 판정자(LLM-as-a-Judge)와 정면 비교한 펜실베이니아대 논문(Jev vs. LLMs as Rubric Judges)이 9월 말에 연달아 나왔다. 이 글은 공식 문서와 두 arXiv 논문을 중심으로 Jev가 무엇이고, 어디에 쓰고, 어디에 쓰면 안 되는지를 정리한다.
원문:
- Jev in the Wild (arXiv 2609.30216)
- Jev vs. LLMs as Rubric Judges (arXiv 2609.29769)
- TypeSafe AI 공식 문서
🤔 왜 "결정 모델"인가: System One vs System Two
이름은 카너먼의 Thinking, Fast and Slow에서 왔다. System 1은 빠르고 직관적인 판단, System 2는 느리고 숙고하는 추론이다. 공식 문서는 Jev를 "fast, focused judgments", 즉 아는 사람이 적절한 맥락을 보고 몇 초 만에 내릴 수 있는 종류의 판단에 맞춘 모델이라고 설명한다. 여러 단계 추론이 필요한 질문은 System Two 과제이며 Jev의 영역이 아니다.
문서가 지적하는 문제는 이렇다. LLM은 사람이 읽을 텍스트를 만들도록 설계됐는데, 우리는 이걸 억지로 "코드가 소비할 판단"을 내리게 만들고, 그 결과를 다시 파싱해 쓴다. 분류 하나 시키려고 자기회귀 생성을 돌리니 느리고 비싸고, JSON이 깨지면 재시도한다. Jev in the Wild 논문도 같은 간극을 짚는다. 전통적 지도 학습 분류기는 라벨 공간이 바뀔 때마다 데이터를 다시 모아야 하고, LLM은 zero-shot은 되지만 "작은 출력 공간의 단순한 결정"에조차 생성 비용을 치른다. Jev는 zero-shot 일반화 + 분류기 수준의 비용을 노린다.
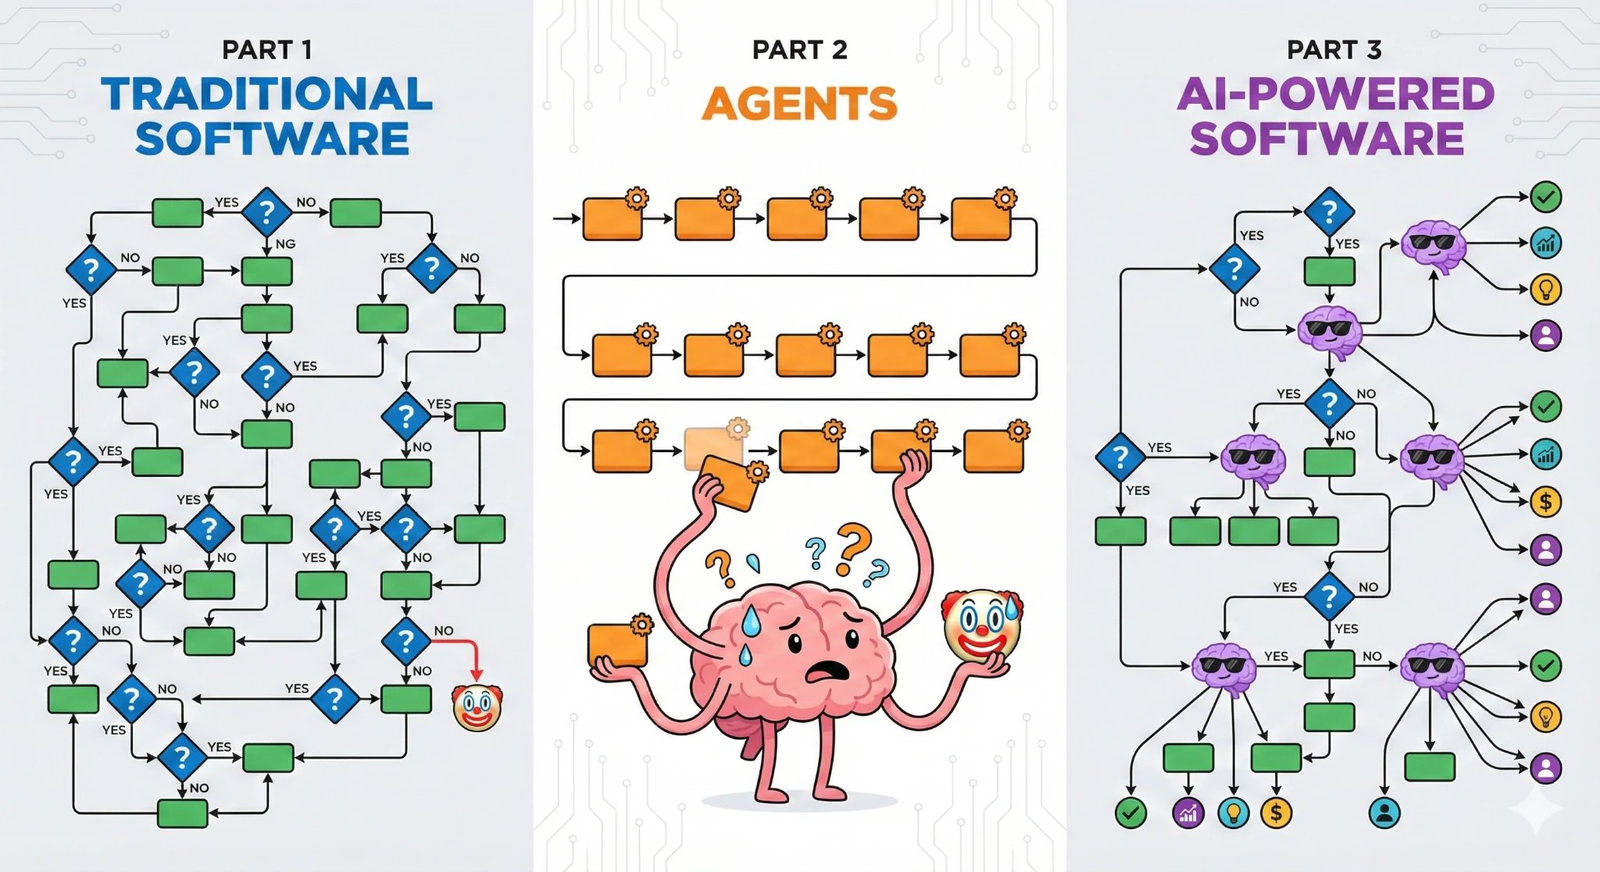
공식 문서 How to build with TypeSafe의 이 그림이 TypeSafe의 입장을 잘 요약한다. 왼쪽은 전통 소프트웨어, 가운데는 매 루프마다 다음 행동을 스스로 고르는 LLM 에이전트("사람이 지켜볼 때는 잘 되지만 루프마다 탈선 기회가 하나씩 늘어난다"), 오른쪽이 TypeSafe가 미는 AI-powered software 다. 제어 흐름, 결정론적 규칙, 부수 효과는 코드가 갖고, 모델은 분기점에서 "비정형 데이터에 대한 상식적 판단"만 담당한다. 문서는 이걸 한 줄로 요약한다. "System One은 에이전트가 아니라 소프트웨어를 만들기 위한 모델이다."
🧠 인터페이스: 상태 + 질문 집합 → 답 하나 + 확률
API는 단일 엔드포인트 POST /v1/systemone 이다. 요청은 두 부분이다.
- state: 문자열, JSON 객체, 또는 텍스트 배열. 모델이 판단할 대상. 현재 텍스트만 받는다(이미지·오디오 미지원).
- questions: 이름 붙은 질문들의 맵. 각 질문은 세 가지 primitive 중 하나다.
| Primitive | 질문 형태 | 답 공간 예시 | 반환값 |
|---|---|---|---|
| Choice | 이 중 어느 것? | billing / technical / account |
choice, 옵션별 probabilities, confidence |
| Score | 순서 있는 척도의 어디? | 0=차분 / 1=불만 / 2=매우 불만 | score(기댓값, 예: 1.4), 레벨별 probabilities, confidence |
| Noul | 이 진술은 참인가? | 참 / 거짓 | noul = P(yes), 0~1 |
핵심은 답 집합을 호출자가 정의한다는 점이다. 모델은 그 집합 바깥의 값을 만들 수 없고, 문서 표현을 빌리면 "스키마 밖의 값을 지어내는 대신 주어진 옵션 전체에 대한 확률 분포를 돌려준다". 파싱할 문자열이 없으니 타입 오류도 구조적으로 생기지 않는다.
from typesafe_sdk import TypeSafeClient, Choice, Noul, Score

client = TypeSafeClient(model="jev-latest")   # 현재 jev-1.13.0

result = client.system_one(
    state={"ticket": "제 항공편이 취소됐는데 환불 되나요?",
           "policy": "취소된 항공편은 전액 환불 대상입니다."},
    questions={
        "team": Choice(instructions="어느 팀이 처리해야 하나?",
                       criteria={"billing": "결제·환불", "technical": "앱 오류", "account": "계정"}),
        "refund_requested": Noul(instructions="`ticket`이 환불을 요청하는가?"),
        "policy_supports": Noul(instructions="`policy`가 `ticket`의 환불 요청을 지지하는가?"),
        "frustration": Score(instructions="고객이 얼마나 불만인가?",
                             criteria=["차분", "불만", "매우 불만"]),
    },
)
위 코드는 공식 문서의 예시들을 합쳐 재구성한 것이다. 눈여겨볼 설계 포인트가 두 가지 있다.
- 모든 질문은 같은 state에 대해 병렬로, 서로 격리되어 평가된다. 질문을 더 넣어도 응답 시간이 거의 늘지 않고, 한 질문의 답이 다른 질문의 숨은 컨텍스트가 되지 않는다. 문서는 이걸 "context-rot이 생기지 않는다"고 표현한다.
- 원자적 질문을 코드에서 합성한다. "이 스타트업 피치를 평가하라" 대신 시장 크기, 기술 타당성, 차별성을 따로 묻고 가중치는 코드에서 준다. 우선순위가 바뀌면 프롬프트가 아니라 계수를 고친다. 문서는 이 항목을 "이 가이드에서 가장 중요한 개념"이라고 못 박는다.
모델 스펙(공식 Models 페이지, jev-1.13.0 기준): 컨텍스트 64k 토큰/요청(state + 가장 긴 질문은 32k), 입력 $0.042/MTok에 출력 토큰 무료, 레이트 리밋 100K tok/s · 80 req/s(동적으로 조정 중). 고객 데이터로 파인튜닝하지 않으며, 도메인 지식은 가중치가 아니라 state·instructions·criteria에 넣으라고 안내한다. 영어가 주 학습 언어이고 CJK는 "처리는 되지만 동등하지 않다"고 명시한다.
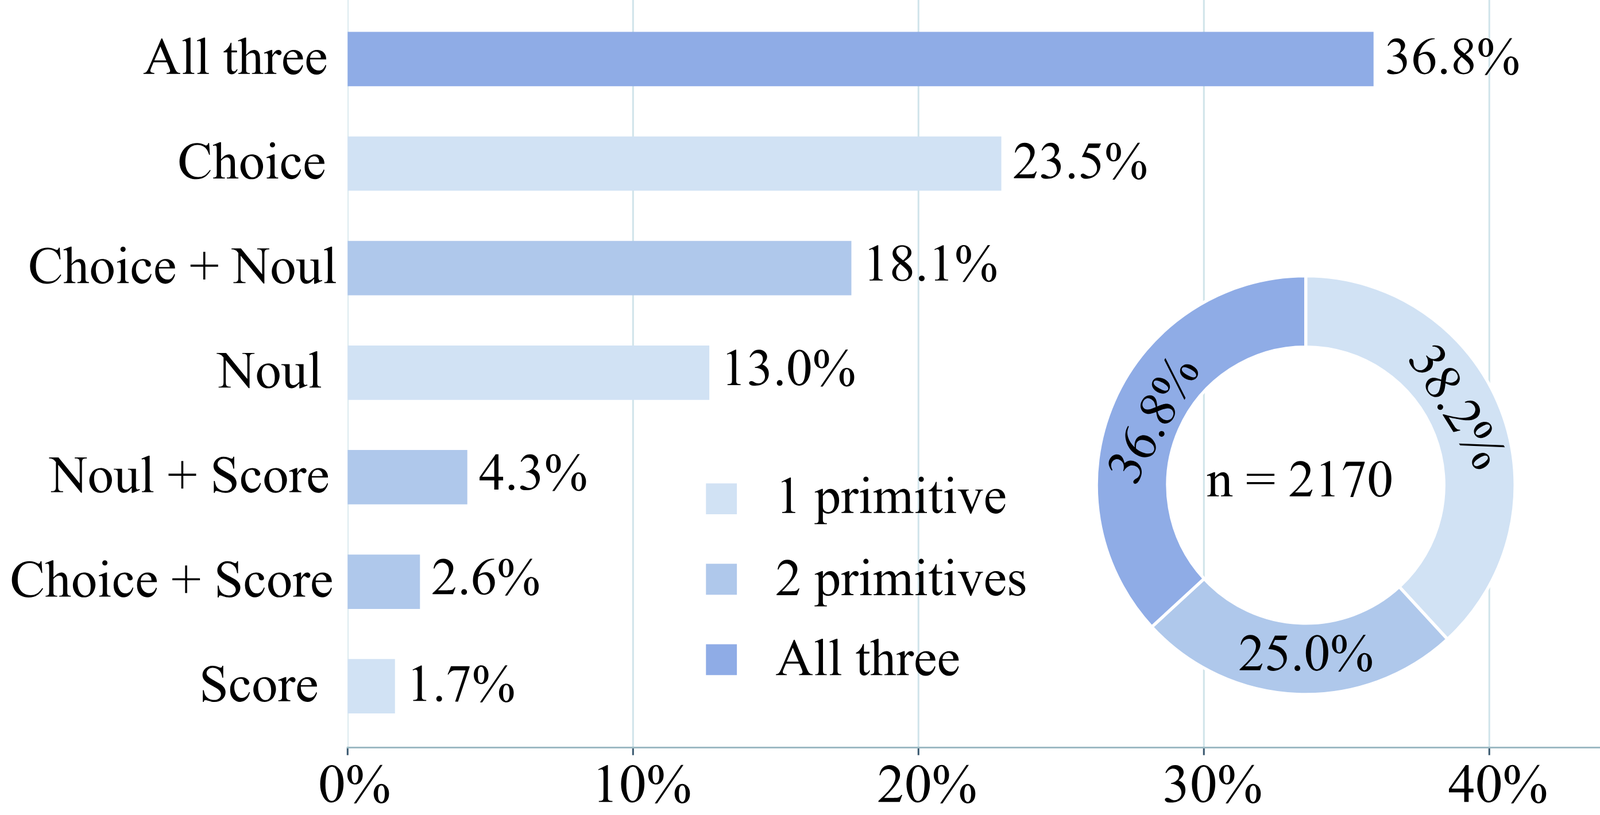
실제 사용 패턴은 Jev in the Wild 가 2026년 9월 22일 기준 GitHub 공개 프로젝트 2,170개를 분석해 보여준다. Choice는 81.0%, Noul은 72.2%, Score는 45.4%의 프로젝트에 등장하고, 36.8%는 셋을 다 쓴다. 결정 목적으로 보면 속성 판단(attribute judgment)이 77%, 점수화·순위가 52%, 행동 선택이 31%이며, 목적이 식별된 프로젝트의 69.7%가 두 가지 이상의 목적으로 Jev를 쓴다. 저자들은 이로부터 "유사한 결정 모델은 범주 선택·이진 판단·점수화를 모두 지원해야 한다"는 설계 시사점을 끌어낸다.
📐 캘리브레이션: 확률이 숫자로서 의미를 갖는가
TypeSafe는 Jev를 RLHF가 아니라 RLCD(Reinforcement Learning for Calibrated Decisions) 로 후훈련했다고 밝힌다. 공식 AI primer의 설명은 단순하다. RLHF는 사람이 선호하는 답을 만들게 하므로 아첨과 "자신감 있는 환각"을 보상할 수 있고, 특정 스타일로 분포가 좁아지는 mode dropping이 생긴다. RLCD는 출력 계약 자체를 바꾼다. 텍스트를 생성하지 않고, "높은 확률이 더 높은 정답 가능성에 대응하도록" 확률을 결과에 맞춰 최적화한다.
캘리브레이션의 정의도 문서에 명시돼 있다. 잘 캘리브레이션된 모델이 0.2를 매긴 사건은 약 20%, 0.8을 매긴 사건은 약 80% 비율로 실제 발생해야 한다. 단, 이건 예측 집단에 대한 성질이지 개별 답이 맞다는 보장이 아니다.
confidence 는 확률 분포에서 유도된 요약 통계다. Choice의 경우 개 옵션 중 선택된 옵션의 확률 에 대해
로, 균등 분할이면 0, 확신이면 1이다. Score는 레벨에 순서가 있으므로 "가장 가능성 높은 레벨에서 얼마나 멀리 확률이 흩어져 있는가"를 균등 분포의 평균 거리로 나눠 쓴다. 세 레벨에서 는 인접 레벨 사이에서 갈린 것이라 0.25지만 는 양 끝으로 갈린 것이라 0이 된다. Noul은 별도 confidence가 없고 을 쓰면 같은 척도가 된다.
문서가 제안하는 운용 패턴은 세 구간 임계값이다. 높은 confidence는 자동 실행, 중간은 확인 후 진행, 낮으면 사람이나 추론 모델로 에스컬레이션. 그리고 임계값은 하나가 아니라 행동의 위험도에 따라 다르게 둔다. 잔액 조회(되돌릴 수 있음)는 낮은 기준으로 바로 실행하고, 송금 승인(되돌릴 수 없음)은 0.9 이상에서만 실행하는 식이다. 코드가 위험 허용도를 인코딩한다.
이 "캘리브레이션 주장"을 독립적으로 검증한 수치는 뒤에서 다룰 Penn 논문에 있다. 이진 패널에서 Jev Noul의 P(MET)는 AUROC 0.800.86, **expected calibration error 0.0560.096** 이었다. 벤더 주장과 대체로 부합하지만, 서열형(ordinal) 기준에서는 confidence가 오류를 거의 구분하지 못한 패널(ELLIPSE, AUROC 0.49)도 있었다.
🔍 패턴: LLM이 쓰고, Jev가 결정하고, 코드가 실행한다
Jev in the Wild 부록은 공개 프로젝트 7개의 코드 경로를 다이어그램으로 정리했는데, 거의 전부가 같은 분업 구조다.
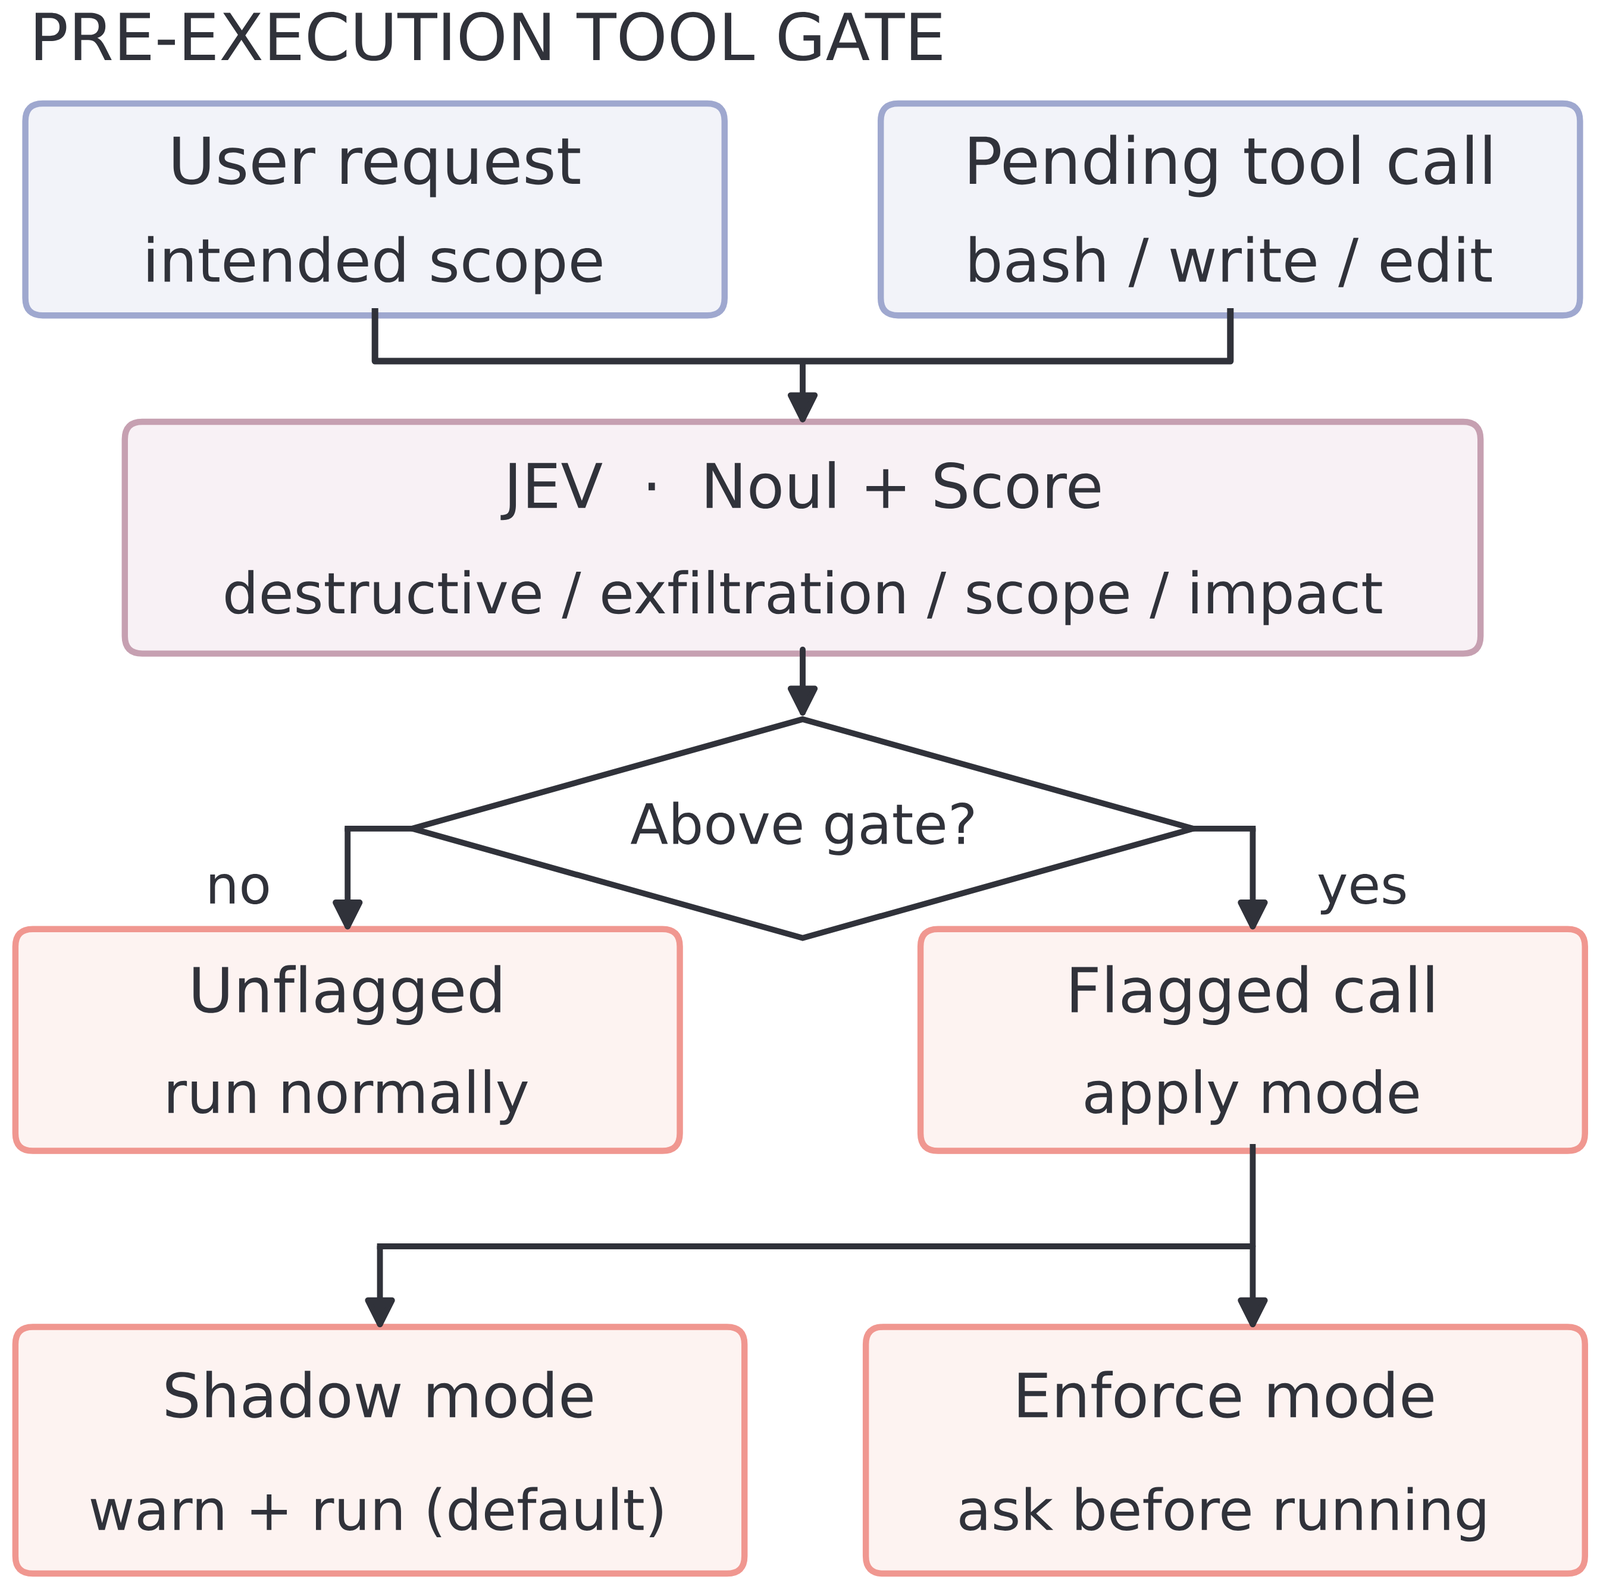
pi-jev(그림)는 코딩 에이전트의 도구 호출 앞에 Jev를 세운다. 사용자 요청과 셸 명령·파일 편집 인자를 state로 넘기고, Noul 세 개(파괴적인가, 데이터 유출인가, 요청 범위를 넘는가)와 Score 하나(영향도)를 묻는다. Jev는 위험 신호만 주고, 경고로 끝낼지 사용자 확인을 받을지는 확장 모드와 정책 코드가 정한다.
다른 예도 구조가 같다.
- Jev Ultrafast(브라우저 에이전트): 페이지의 상호작용 가능한 컨트롤 목록을 state로 주고 Choice로 다음 동작(클릭/입력/스크롤/종료)과 대상을 고른다. 입력창에 쓸 텍스트는 별도의 작은 언어 모델이 생성한다. Jev는 행동 선택자, 브라우저 실행기는 실행, 텍스트 모델은 생성.
- Fast Jev Compaction(컨텍스트 압축): 오래된 도구 호출마다 Noul 두 개("호출 기억이 유용한가", "결과 전문이 필요한가")를 물어 보존/축약/삭제를 결정한다. 요약을 생성하지 않고, 살아남은 내용은 원문 그대로다.
- jev-router(모델 라우팅): 새 턴마다 Choice로 모델 티어를 추천하고, 코드가 지원 티어인지 검증한 뒤 적용한다. 사용자가 명시한 티어가 우선하고, 답이 없거나 무효면 현재 티어를 유지한다.
분석 논문은 이 패턴을 "주변 시스템이 state를 준비하고 결정을 정의하며, Jev는 결정 자체를 담당하고, 시스템이 그 결과로 다음 동작을 제어한다"고 요약한다. 흥미로운 건 관심의 쏠림이다. Routing & Automation과 Interface Agents는 전체 프로젝트의 19.6%에 불과하지만 스타의 63.0% 를 가져갔고, Model & Tool Routing 하위 범주 하나가 32.6%다. 이 블로그에서 다룬 MCP나 에이전트 글의 맥락에서 보면, "에이전트 루프의 분기점"이 이 모델이 가장 먼저 침투한 자리라는 뜻이다.
어디에 쓰면 안 되는가
공식 문서의 Jev 1.13 jaggedness 페이지는 벤더가 직접 쓴 실패 모드 목록이라 그대로 옮길 가치가 있다.
| 실패 모드 | 대신 이렇게 |
|---|---|
| 문자 그대로 읽음(범위 한정어, 부정, 암묵 조건) | 조건을 정확히 적고 경계 사례를 criteria에 넣기 |
| 수와 계산(세기, 16진 색상 비교, 숫자 보간) | 산술은 코드에서 |
| 날짜·시간 비교 | 구성요소를 Choice로 추출하고 비교는 코드에서 |
| 간접 참조, 이중 부정, 다중 홉 | 홉 줄이기, 관련 state를 이름으로 가리키기 |
| 무관한 내용이 많은 큰 state | 코드로 먼저 필터링 |
| 적대적 입력 | state를 적대적으로 취급하지 않음. criteria를 명시하고 배포 전 테스트 |
| Choice 옵션 순서 | 첫 옵션으로 기우는 경향. 순서를 바꿔 일관성 확인 |
| 생성 | 다른 모델을 쓸 것 |
마지막 항목이 핵심이다. "Choice를 체이닝해서 억지로 텍스트를 만들 수는 있지만 잘 되지 않고 매우 느리다. 추출이 필요하면 정규식이나 생성 모델로 후보를 뽑고 Jev가 고르게 하라."
📊 LLM 판정자와 비교: 더 싸고 빠르지만, 같은 곳에서 틀린다
펜실베이니아대 Delip Rao와 Chris Callison-Burch의 논문은 LLM-as-a-Judge를 Jev로 대체할 수 있는지를 묻는다. 설정은 꼼꼼하다. 7개 벤치마크에서 사람 판정이 있는 9개 패널, 5,003개 (제출물, 기준) 쌍. 비교 대상은 flash급 LLM 판정자 셋(GPT-5.6 Luna, Gemini 3.8 Flash, DeepSeek V4.1 Flash). 모든 판정자에게 똑같은 기준 텍스트를 주고, 예시·리라이팅·튜닝은 없다. Jev는 Choice(argmax), Noul(0.5 임계), Score(기댓값 반올림) 세 framing으로 돌렸다.
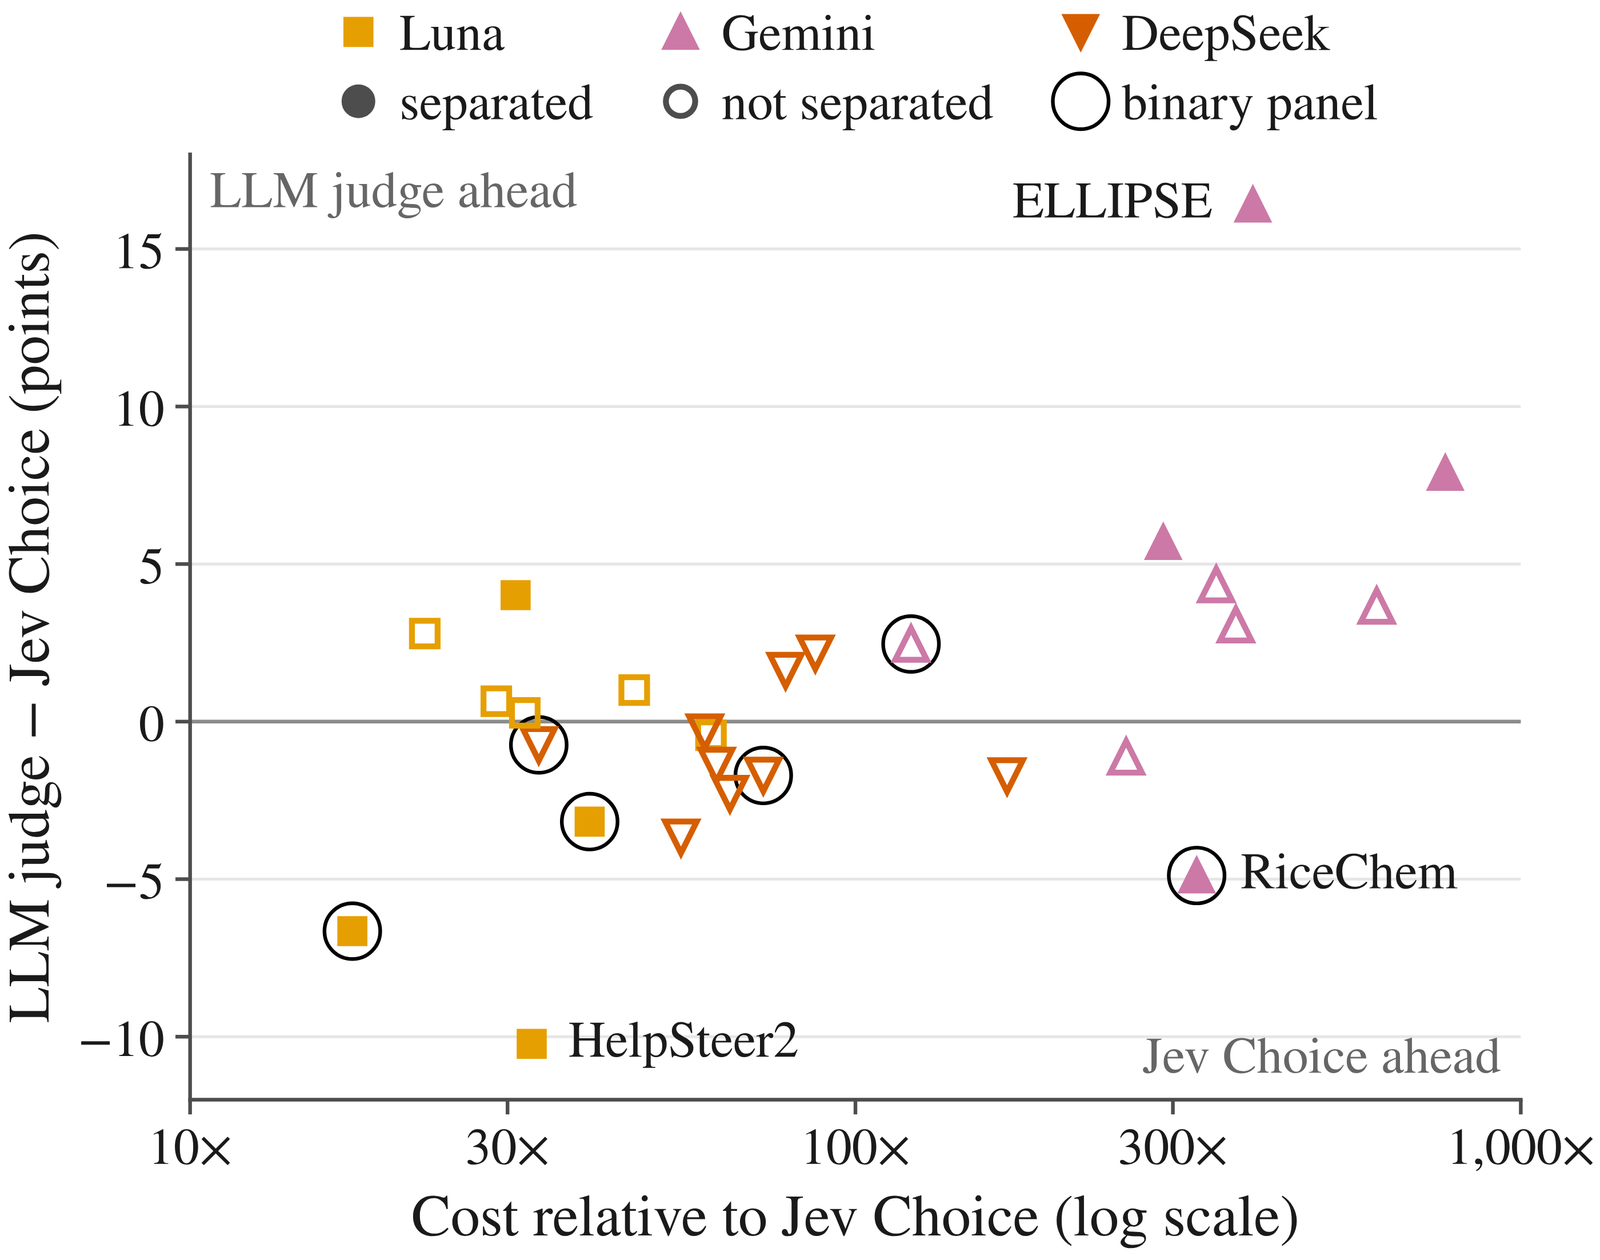
RQ1 — 대체 가능한가? 대체로 그렇다. 27개 쌍별 비교 중 통계적으로 구분된 것은 8개뿐이고, 그중 Jev가 앞선 4개는 대부분 이진 체크리스트 패널(RiceChem, HealthBench), 뒤진 4개는 전부 서열형 패널이다. 비용은 9개 패널 전체에서 Jev Choice가 $0.063 인 데 비해 Luna 29배, DeepSeek 66배, Gemini 325배였고, 벽시계 시간은 Jev 29초 대 8596,298초(30220배)였다. 논문은 LLM이 Jev보다 높은 동시성으로 돌았으므로 이 비율이 Jev의 이점을 과소평가한다고 덧붙인다.
다만 서열형 기준에서 Jev Choice가 가장 정확한 패널은 하나도 없었다. ELLIPSE 에세이 채점에서는 Gemini가 16.4포인트 앞섰다. Jev Score는 Jev Choice보다 네 패널에서 유의하게 나았고 뒤진 적은 없었다(단, 기권 옵션이 없다).
RQ2 — 얼마나 다르게 판단하는가? 여기가 이 논문의 제목이 나온 곳이다. 설계는 정반대다. LLM은 추론한 뒤 답하고, Jev는 확률만 돌려준다. 그러니 다른 곳에서 틀릴 거라 기대할 수 있다. 결과는 반대였다. 7개 서열형 패널 모두에서 판정자들끼리의 일치(QWK)가 사람 라벨과의 일치보다 높았고, 7개 중 6개에서 모든 판정자가 사람보다 낮은 레벨을 매겼다. ELLIPSE에서는 라벨의 36.3%가 4~5레벨인데 어떤 판정자도 4.2% 이상을 그 레벨에 두지 않았다.
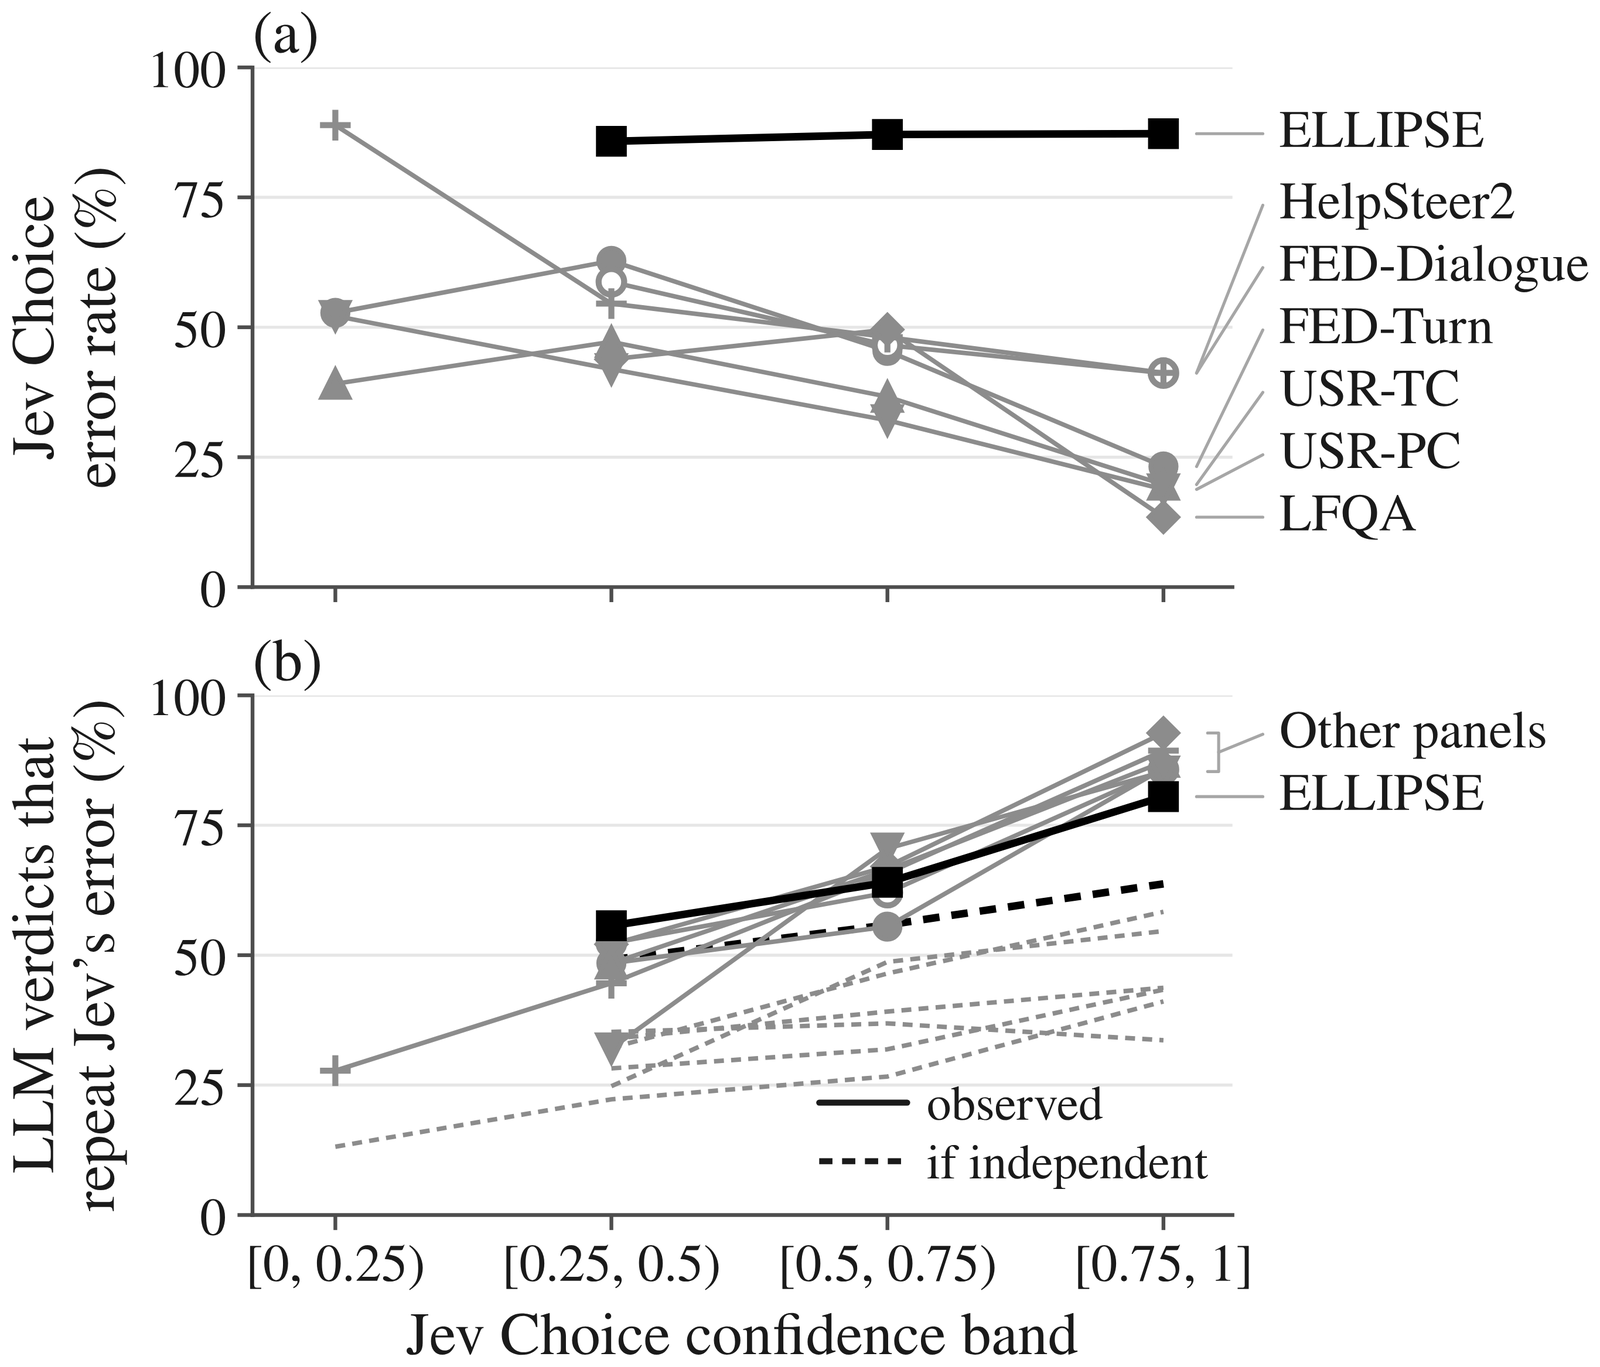
그림 (a)는 좋은 소식이다. ELLIPSE를 빼면 Jev의 confidence는 자기 오류를 꽤 잘 가려낸다(AUROC 0.57~0.70). 그림 (b)가 나쁜 소식이다. Jev가 가장 확신하며 틀린 쌍에서, LLM 판정자의 96.0%가 같은 오답을 냈다. 오류가 독립이라면 50.3%여야 할 값이다. 판정자가 추론을 하든 안 하든, 추론 노력을 high로 올려도(97.2%) 이 수치는 바뀌지 않았다.
RQ3 — 캐스케이드는 되는가? 직관적으로는 Jev가 자신 있는 것만 답하고 나머지를 LLM에 넘기면 싸고 정확해야 한다. 하지만 논문의 식 하나가 왜 안 되는지 설명한다.
캐스케이드와 폴백은 넘긴 쌍에서는 똑같은 답을 내므로, 캐스케이드가 폴백을 이기려면 Jev가 직접 답한 쌍에서 Jev 혼자 맞은 경우가 있어야 한다. 그런데 오류가 상관돼 있으니 그런 쌍이 거의 없다. 결과적으로 오라클 임계값을 써도 최고 단일 판정자 대비 이득은 최대 2.7포인트였고, 교차 검증 임계값으로는 1.5포인트였다. 비용은 확실히 줄어든다(여섯 패널에서 최고 LLM 판정자의 1648% 비용으로 정확도 0.21.8포인트 손실). 저자들의 결론은 명료하다.
"Jev는 flash급 LLM 판정자의 저렴한 대체재인 경우가 많지만, 그 보완재로는 부적합하다. 다르게 만들어진 판정자가 반드시 다르게 틀리는 것은 아니다."
참고로 CMU 쪽의 다른 논문(JEV-as-a-Judge: Accept When Confident, Escalate When Unsure)은 캐스케이드가 GPT-6 대비 0.9포인트 높은 정확도를 41% 비용으로 냈다고 보고해 결론이 갈린다. Penn 논문은 자기들 설정이 "기준 텍스트를 고정한 관측 연구"이며 few-shot이나 더 큰 폴백 모델은 시도하지 않았다고 한계를 명시하고 있으므로, 워크로드에 따라 결과가 다를 수 있다고 보는 게 안전하다.
💡 정리, 한계, 열린 질문
Jev가 바꾸는 것은 모델의 능력이 아니라 출력 계약이다. "텍스트를 생성하고 파싱한다"에서 "정의된 집합 위의 확률 분포를 받는다"로 바뀌면, 타입 안전성, 병렬 질문, 임계값 기반 제어가 공짜로 따라온다. 공개 프로젝트 2,170개가 일주일 안에 생긴 건 이 계약이 에이전트 루프의 분기점에 바로 꽂히기 때문으로 보인다.
벤더 수치는 걸러 읽어야 한다. TypeSafe 공식 사이트는 "193.6배 빠름(0.114s vs 8.566s)", "444.6배 저렴($0.000081 vs $0.013880/task)", "Zero Hallucinations" 같은 숫자를 내세운다. 비교 대상 작업과 설정이 공개된 벤치마크가 아니므로 마케팅 주장으로 봐야 한다. 독립 측정치는 Penn 논문의 16325배(비용), 28350배(시간)가 더 신뢰할 만하고, 이것도 flash급 모델 대비라는 점을 기억해야 한다. 공식 문서 자체도 "대부분의 쿼리가 약 100ms"라고만 쓴다.
한계와 열린 질문은 이렇다.
- 서열형 판단에서는 LLM이 아직 낫다. 에세이 채점처럼 레벨 사이의 미묘한 차이를 가르는 과제에서 Jev Choice는 최고 판정자가 된 적이 없다. Score framing이 조금 낫지만 기권을 못 한다.
- "같은 곳에서 틀린다"의 원인은 미확인이다. 논문은 암묵적 채점 관례, 공유된 학습 사전 분포, 최고 레벨을 주기 꺼리는 성향, 문자 그대로 읽기 등을 후보로 들지만 데이터로는 구분하지 못했다. 네 벤더 중 누구도 학습 데이터를 공개하지 않는다.
- 다음 결정 모델은 어떻게 설계해야 하는가. Penn 논문의 마지막 문장은 사실상 과제 제시다. "LLM 판정자가 틀리는 것을 맞히도록 처음부터 설계하라." 캐스케이드가 작동하려면 싼 판정자가 자기 오류를 알고(이건 됨), 폴백이 다른 곳에서 틀려야 한다(이건 안 됨).
- 적대적 입력. 벤더 스스로 "state를 적대적으로 취급하지 않는다"고 쓴다. 가드레일 용도로 Jev 하나만 세우는 건 단일 실패점이다.
- 비공개 가중치, 영어 중심. 호스팅 전용이고, CJK 정확도는 직접 테스트하라고 안내한다. 한국어 워크로드라면 라벨 데이터 몇십 건으로 자기 분포에서 캘리브레이션을 먼저 재는 게 순서다.
Dust 글에서 "컴퓨트가 넘치면 탐색이 이긴다"는 질문을 다뤘다면, Jev는 반대 방향의 질문이다. 대부분의 결정에는 생성이 필요 없는데, 왜 생성 비용을 치르고 있는가. 이 질문에 대한 답이 "작은 분류기 하나"가 아니라 "새 학습 목표(RLCD)와 새 출력 계약을 가진 범용 모델"이라는 점이 Jev를 지켜볼 이유다.
📚 참고
- Ling, Xue, Ye. Jev in the Wild: A Data-Driven Analysis of the Jev Model's Functionality, Applications and Ecosystem (arXiv 2609.30216, 2026.09) — HTML
- Rao, Callison-Burch. Jev vs. LLMs as Rubric Judges: Cheaper, Faster, and Wrong in the Same Places (arXiv 2609.29769, 2026.09) — HTML
- Li, Miao, Krishnan, Padman. JEV-as-a-Judge: Accept When Confident, Escalate When Unsure (arXiv 2609.26550, 2026.09)
- TypeSafe AI 공식 문서: System One, Confidence, How to build with TypeSafe, AI primer (RLCD), Jev 1.13 jaggedness, Models
- TypeSafe AI 홈페이지: https://www.typesafe.ai/ (벤더 성능 주장 출처)
- 참고한 서드파티 정리: LLM Reference — Jev, AI Builder Club — Jev Engineering Guide
- Daniel Kahneman, Thinking, Fast and Slow (2011) — System 1/System 2 구분의 출처
본 글의 그림은 원문(arXiv 논문 HTML 및 TypeSafe 공식 문서)에서 가져왔습니다.