bubblewrap부터 gVisor까지: AI 에이전트 시대의 샌드박싱 도구 지도
"System call filtering isn't a sandbox." — Linux 커널 seccomp 문서
커널 문서가 seccomp 자체는 샌드박스가 아니라고 못 박는 데는 이유가 있다. 격리는 한 가지 기술이 아니라 여러 층의 조합이고, 어떤 층을 어디까지 쌓느냐에 따라 "가둔다"의 의미가 완전히 달라진다. 이 글은 그 층을 아래부터 위까지 한 장의 지도로 그려 보려는 시도다.
🤔 왜 지금 샌드박싱인가
AI 코딩 에이전트는 pip install을 돌리고, 테스트를 실행하고, 셸 스크립트를 짜서 바로 실행한다. MCP 서버는 LLM이 고른 인자로 로컬 프로세스를 띄운다. 프롬프트 인젝션 한 줄이면 이 실행 경로가 통째로 공격자 손에 들어간다.
이 블로그에서 다룬 Anthropic Sandbox Runtime(srt)은 바로 이 문제를 겨냥한 도구인데, README를 다시 확인하면 srt 자체가 새 격리 기술을 만든 것이 아니라 Linux에서는 bubblewrap, macOS에서는 sandbox-exec(Seatbelt 프로필) 이라는 기존 OS 기본 요소를 감싼 것이다(Linux 의존성 목록에 bubblewrap, socat, ripgrep가 명시되어 있고, Unix 소켓 차단과 중첩 네임스페이스 방지는 seccomp 필터로 한다). 그리고 직무 분리 아키텍처 글에서 Executor가 최종적으로 행동을 실행하는 곳이 "OS 샌드박스"였다. 즉 에이전트 보안 논의의 맨 아래층에는 항상 이 글의 도구들이 있다.
🧠 격리의 층위
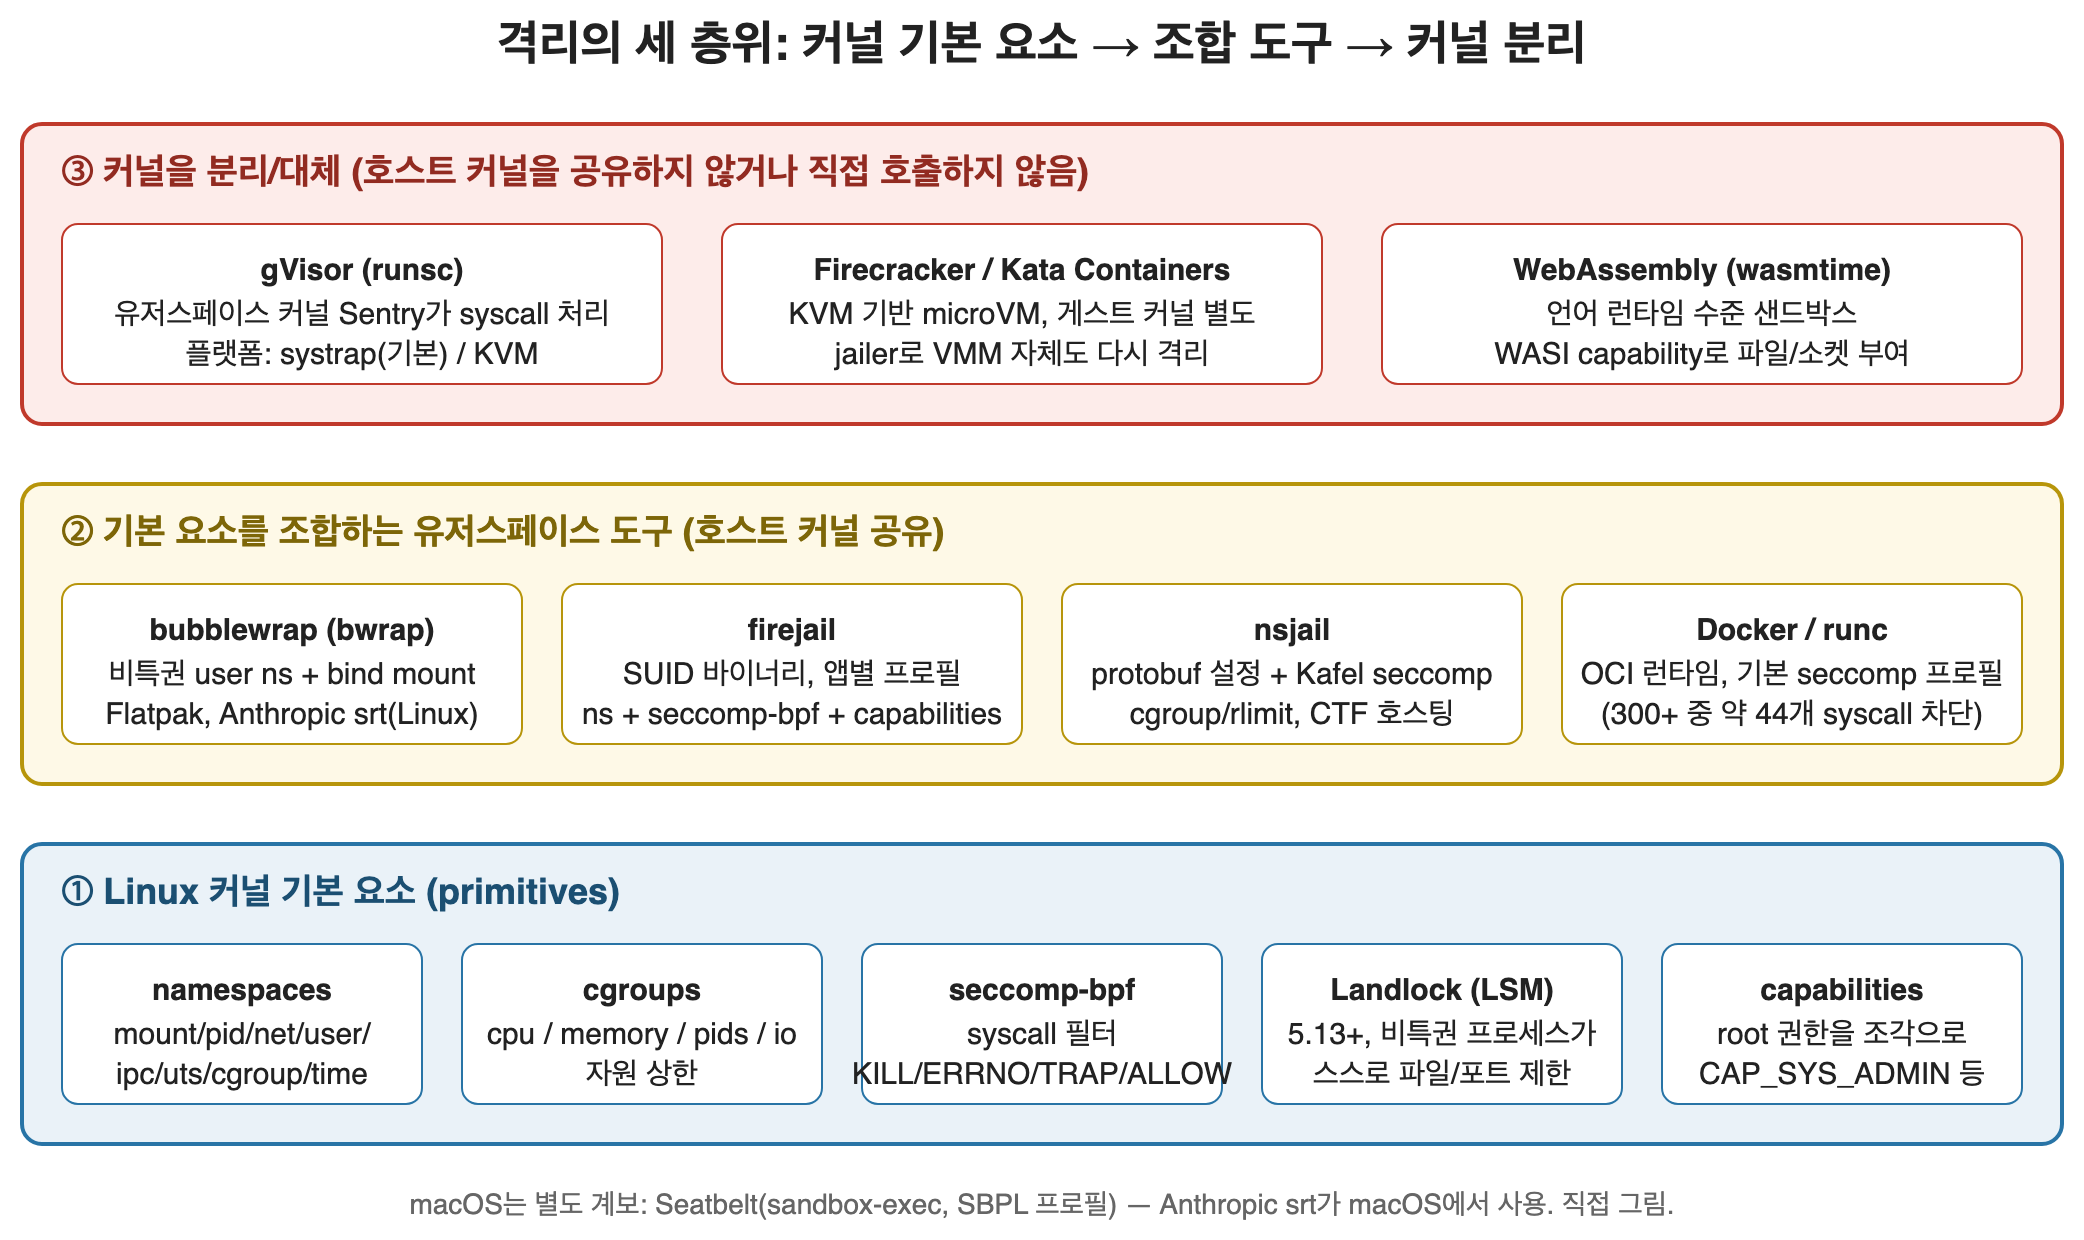
① 커널 기본 요소. Linux 커널이 제공하는 벽돌들이다.
- namespaces — mount, pid, net, user, ipc, uts, cgroup, time. 프로세스가 보는 "세계"를 분리한다. 특히 user namespace가 있어야 root 없이 다른 네임스페이스를 만들 수 있다.
- cgroups — 커널 문서의 정의대로 "프로세스를 계층적으로 조직하고 그 계층을 따라 시스템 자원을 분배하는 메커니즘"이다. cpu, memory, pids, io 컨트롤러로 상한을 건다.
- seccomp-bpf — 시스템콜 필터. BPF 프로그램으로 호출을 검사해
KILL_PROCESS,ERRNO,TRAP,TRACE,USER_NOTIF,ALLOW중 하나를 돌려준다. 비특권 프로세스가 쓰려면 먼저prctl(PR_SET_NO_NEW_PRIVS, 1)을 호출해야 한다. 커널 문서는 "아키텍처 값을 확인하지 않고 syscall 번호만으로 필터링하는 것"을 가장 큰 함정으로 꼽고, seccomp 샌드박스는 ptrace를 허용하면 안 된다고 경고한다. - Landlock — Linux 5.13에서 들어온 stackable LSM. "비특권 프로세스를 포함한 어떤 프로세스든 스스로를 안전하게 제한할 수 있게" 하는 것이 목표다.
- capabilities — root 권한을
CAP_SYS_ADMIN,CAP_NET_RAW같은 조각으로 쪼개 필요한 것만 남긴다.
② 조합 도구. bubblewrap, firejail, nsjail, 그리고 Docker/runc가 여기 속한다. 호스트 커널을 그대로 공유하므로 커널 취약점 하나면 모든 벽이 동시에 무너진다는 공통 한계가 있다.
③ 커널 분리. gVisor는 syscall을 유저스페이스 커널이 처리해 호스트 커널에 닿는 표면을 줄이고, Firecracker/Kata는 아예 별도 게스트 커널을 KVM 위에 띄운다. WebAssembly는 언어 런타임 수준에서 같은 효과를 노린다.
🛠️ 도구별 설명
bubblewrap (bwrap)
README의 첫 문장은 "bubblewrap is a tool for constructing sandbox environments"이고, 보호 수준은 "전적으로 bubblewrap에 넘긴 인자로 결정된다"고 밝힌다. 즉 정책이 없는 저수준 도구다. user namespace로 "어떤 사용자든" 쓸 수 있고, 과거의 setuid 모드는 제거됐다. Flatpak, rpm-ostree, bwrap-oci가 이 도구를 공유한다.
man page에서 확인한 핵심 플래그:
| 플래그 | 설명 (man page) |
|---|---|
--unshare-all |
가능한 모든 네임스페이스 분리. 현재 --unshare-user-try --unshare-ipc --unshare-pid --unshare-net --unshare-uts --unshare-cgroup-try와 동일 |
--ro-bind SRC DEST / --bind |
호스트 경로를 읽기 전용 / 읽기쓰기로 bind mount |
--tmpfs DEST, --proc, --dev |
새 tmpfs / procfs / devtmpfs 마운트 |
--die-with-parent |
bwrap의 부모가 죽으면 자식도 죽음 |
--new-session |
setsid()로 제어 터미널에서 분리. 터미널 입력 주입(TIOCSTI, CVE-2017-5226) 방지 목적 — man page는 seccomp로 TIOCSTI ioctl도 막으라고 권고 |
--clearenv, --setenv |
환경변수 초기화 / 설정 |
--seccomp FD |
컴파일된 cBPF 프로그램 로드 |
"에이전트용 임시 작업 디렉터리만 쓰기 허용" 예제는 아래 실전 섹션에서 다룬다.
firejail
README는 firejail을 "Linux namespaces, seccomp-bpf, Linux capabilities를 이용해 보안 침해 위험을 줄이는 SUID 샌드박스 프로그램"으로 소개한다. 앱별 프로필(etc/ 디렉터리)이 자동 적용되고, 모르는 앱에는 "매우 제한적인 기본 프로필"을 쓴다. firejail /usr/bin/firefox처럼 명령 앞에 붙이면 된다.
문제는 SUID 설계다. root 권한 바이너리에 로직 결함이 있으면 그대로 로컬 권한 상승이 된다. NVD에 등록된 CVE-2022-31214(CVSS 3.1 7.8 HIGH)는 firejail 0.9.68의 --join 로직에서, 공격자가 만든 가짜 컨테이너를 setuid-root 프로그램이 join 대상으로 받아들여 "user namespace가 초기 네임스페이스 그대로이고 NO_NEW_PRIVS가 꺼진 채 공격자가 제어하는 mount namespace"에 들어가게 되어 su/sudo로 root를 얻는 취약점이다. 릴리스 노트상 0.9.70에서 수정됐다. 또 0.9.64.4 릴리스 노트에는 CVE-2021-26910 때문에 overlayfs 기능을 비활성화했다는 기록이 있다. README 자체도 배포판 패키지가 보안 패치에 뒤처진 사례(Ubuntu 20.04)를 지적한다.
nsjail
Google 조직 아래 있지만 "공식 Google 제품이 아니"라고 명시된 도구다. README는 "namespaces, resource limits, seccomp-bpf syscall filters를 쓰는 Linux 프로세스 격리 도구"로 정의한다. 특징은 protobuf 설정 파일(config.proto 스키마)과 Kafel 언어로 쓰는 seccomp 정책이다. 예를 들어 ALLOW { read, write, exit, exit_group } DEFAULT KILL 한 줄이 허용 목록 필터가 된다. rlimit(cpu, as, fsize, nofile), cgroup(memory, pids, cpu), 그리고 inetd 스타일 TCP 리스너 모드가 있어 README는 "CTF Challenge Hosting"을 대표 사용처로 든다(60초 제한, 128MB 주소공간 제한 예제). LLM이 만든 코드를 채점하는 용도와 거의 같은 요구사항이다.
./nsjail -Mo --chroot / --user 99999 --group 99999 -- /bin/bash   # README 기본 예제
./nsjail --config myconfig.cfg -- /usr/bin/id                     # 설정 파일 + 명령 덮어쓰기
Landlock
커널 문서의 샘플 samples/landlock/sandboxer.c는 환경변수로 정책을 받는 작은 래퍼다. 도움말에 나오는 사용 예:
LL_FS_RO="${PATH}:/lib:/usr:/proc:/etc:/dev/urandom" \
LL_FS_RW="/dev/null:/dev/full:/dev/zero:/dev/pts:/tmp" \
LL_TCP_BIND="9418" LL_TCP_CONNECT="80:443" \
./sandboxer bash -i
내부적으로는 landlock_create_ruleset → landlock_add_rule(LANDLOCK_RULE_PATH_BENEATH, LANDLOCK_RULE_NET_PORT) → landlock_restrict_self 세 syscall이 전부다. 한 번 걸면 자식에게 상속되고 해제할 수 없다. 비특권 프로세스는 반드시 no_new_privs를 먼저 켜야 한다. ABI는 계속 자라서 v4에서 TCP bind/connect, v10에서 UDP, v6에서 abstract UNIX 소켓과 시그널 scope가 추가됐다. 제약도 명확하다. "샌드박싱 전에 열어 둔 파일/디렉터리는 제한 대상이 아니"고, 스택 가능한 ruleset은 16층까지다. 흥미로운 건 Q&A의 입장이다. 네임스페이스는 "접근 제어용으로 설계되지 않았고" 신뢰할 수 없는 프로세스가 조작하면 보안 문제가 될 수 있다는 것. 즉 Landlock은 bwrap 류와 경쟁이 아니라 그 위에 한 층 더 쌓는 용도다.
seccomp-bpf와 Docker 기본 프로필
Docker 공식 문서에 따르면 기본 seccomp 프로필은 "300개 이상 중 약 44개의 시스템콜을 비활성화"한다. 차단 목록에는 reboot("컨테이너가 호스트를 재부팅하지 못하게"), keyctl 계열("커널 keyring은 네임스페이스화되지 않음"), mount("이미 CAP_SYS_ADMIN으로 막혀 있음") 등이 있다. --security-opt seccomp=unconfined로 끌 수 있고, 커널에 CONFIG_SECCOMP이 있어야 한다. 컨테이너를 쓰고 있다면 이미 seccomp를 쓰고 있는 셈이다.
gVisor (runsc)
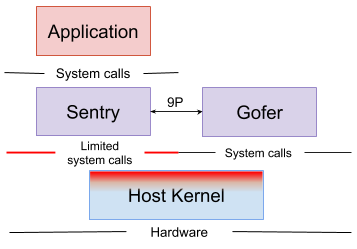
gVisor는 Go로 쓴 유저스페이스 애플리케이션 커널이다. 공식 문서의 구성은 셋이다. runsc는 OCI 런타임이라 Docker/Kubernetes에 그대로 꽂히고, Sentry는 syscall·시그널·메모리·스레딩을 직접 구현한 "샌드박스의 커널"이며 "시스템콜을 호스트 커널로 통과시키지 않는다". Gofer는 9P로 Sentry와 통신하며 파일 접근을 중개한다. 문서는 이를 "seccomp on steroids"라고 부르면서도, syscall 필터도 전통적 VM도 아니라고 선을 긋는다.
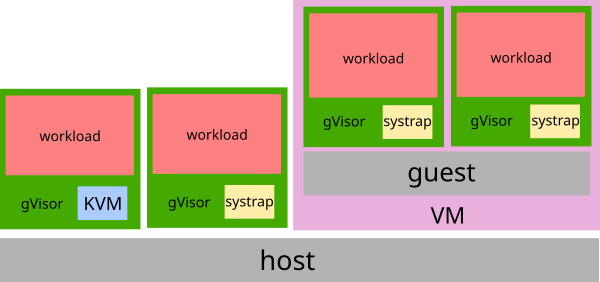
syscall을 가로채는 방식이 플랫폼이다. 기본값 systrap은 seccomp의 SECCOMP_RET_TRAP을 이용하며 "2023년 중반에 ptrace를 대체해 기본 플랫폼이 됐다". KVM 플랫폼은 "베어메탈에서 가장 잘 돌고" 중첩 VM에서는 systrap이 더 낫다. ptrace 플랫폼은 더 이상 지원되지 않으며 제거될 예정이다. 성능 문서는 구체 수치를 본문이 아니라 차트/CSV로만 제공하는데, 텍스트상 입장은 "작은 연산은 큰 오버헤드, 큰 연산은 상대적으로 작은 오버헤드", "raw disk I/O에는 근본적 오버헤드가 크지 않음", "시작 시간 오버헤드 대부분은 Docker 자체"다. 보안 문서는 하드웨어 사이드채널은 "일반적으로 보호하지 않는다"고 명시한다.
Firecracker
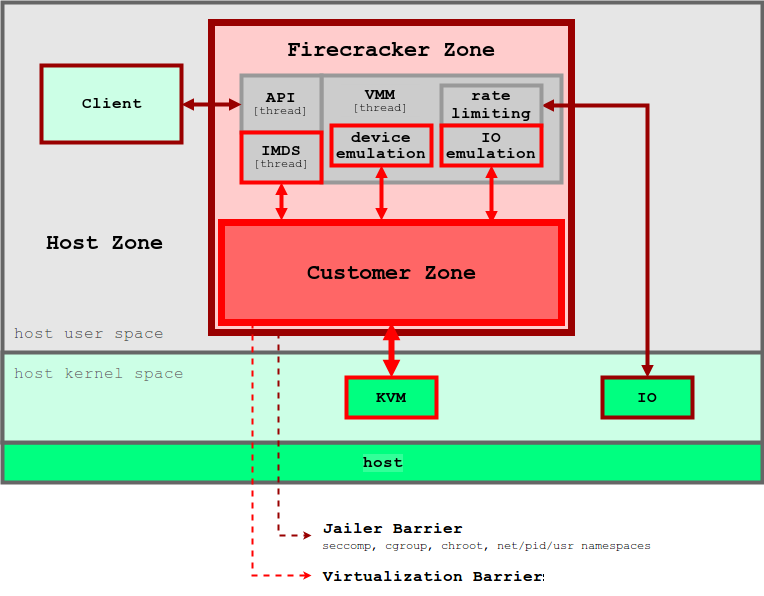
AWS가 Lambda와 Fargate를 위해 만든 VMM으로, "KVM을 써서 microVM을 만들고 실행"한다. 프로세스 하나가 microVM 하나이고(API, VMM, vCPU 스레드), 디바이스는 virtio net/block/vsock으로 최소화했다. 설계 문서가 말하는 격리 1층은 "KVM과 Firecracker 가상화 경계"이고, 그 바깥을 jailer가 seccomp·cgroup·chroot·네임스페이스로 한 번 더 감싼다. 공식 SPECIFICATION.md의 수치는 다음과 같다. InstanceStart API 호출부터 게스트 부팅까지 125ms 이하, VMM 스레드의 메모리 오버헤드 5MiB 이하, 게스트 CPU 성능은 베어메탈의 95% 초과. NSDI 2020 논문(Agache et al.)도 같은 설계를 다루지만 이 글의 수치는 저장소 문서 기준이다. 사실상 "VM을 컨테이너 속도로"가 목표라, Kata Containers의 백엔드로도 쓰인다.
macOS sandbox-exec / Seatbelt
macOS의 man sandbox-exec는 첫 줄부터 DEPRECATED라고 적혀 있다(2017년 3월 날짜의 man page). 개발자는 App Sandbox를 쓰라는 안내지만, 바이너리는 macOS 27에서도 그대로 동작한다. 프로필 언어(SBPL, Scheme 문법)에 대한 Apple 공식 문서는 사실상 없고, /System/Library/Sandbox/Profiles/*.sb의 시스템 프로필과 man page가 전부다. 시스템 프로필 파일 헤더에는 "Apple System Private Interface이며 예고 없이 바뀔 수 있다"는 경고가 있다. srt가 macOS에서 이 경로를 택한 것은, 대안이 없기 때문으로 보인다.
이 글을 쓰면서 아래 프로필을 실제로 실행해 봤다. 작업 디렉터리만 쓰기 허용, ~/.ssh 읽기 금지, 네트워크 전체 금지다.
(version 1)
(deny default)
(allow process-exec)
(allow process-fork)
(allow sysctl-read)
(allow mach-lookup)
(allow file-read*)
(allow file-write-data (literal "/dev/null"))
(allow file-write* (subpath (param "WORK")))
(deny file-read* (subpath (param "HOME_SSH")))
(deny network*)
sandbox-exec -f agent.sb -D WORK=$PWD/work -D HOME_SSH=$HOME/.ssh /bin/sh run.sh
결과: 작업 디렉터리 안의 Python 스크립트는 정상 실행되어 out.txt를 썼고, touch /tmp/x는 Operation not permitted, ls ~/.ssh도 Operation not permitted, curl https://example.com은 DNS부터 실패했다. 참고로 (deny default)가 너무 강해 /usr/bin/python3(xcrun 경유 shim)는 캐시 디렉터리 쓰기에 실패하므로 Homebrew Python을 직접 지정했다.
(선택) Kata Containers와 WebAssembly
Kata Containers는 "컨테이너처럼 가볍고 빠르면서 VM의 워크로드 격리를 제공"하는 것을 표방하는 OCI 호환 런타임으로, 공식 사이트는 QEMU와 Firecracker 백엔드를 보여준다. wasmtime은 "신뢰할 수 없는 코드를 샌드박스 안에서 안전하게 실행"하는 것이 목표이며, WASI의 capability 모델로 "명시적으로 부여된 파일과 디렉터리만" 접근 가능하다. 단, Spectre 완화는 "기본적인 몇 가지"만 구현되어 있다고 스스로 밝힌다.
📊 비교표
| 도구 | 격리 단위 | 필요한 권한 | 호스트 커널 공유 | 시작 지연 | 주요 사용처 | 플랫폼 |
|---|---|---|---|---|---|---|
| bubblewrap | 프로세스 (ns + bind mount) | 비특권 (user ns 필요) | 공유 | 매우 짧음 | Flatpak, srt(Linux) | Linux |
| firejail | 프로세스 (프로필) | SUID root 바이너리 | 공유 | 매우 짧음 | 데스크톱 앱 | Linux |
| nsjail | 프로세스 (ns + cgroup + Kafel seccomp) | 비특권 가능(user ns), cgroup은 권한 필요 | 공유 | 매우 짧음 | CTF, 코드 채점 | Linux |
| Landlock | 스레드/프로세스 자기 제한 | 비특권 (no_new_privs) | 공유 | 없음 (syscall 3개) | 앱이 스스로 가둠 | Linux 5.13+ |
| seccomp-bpf | syscall 표면 | 비특권 (no_new_privs) | 공유 | 없음 | Docker 기본, 모든 도구의 바닥 | Linux |
| gVisor | 컨테이너 (유저스페이스 커널) | root로 runsc 설치; KVM 플랫폼은 /dev/kvm |
제한적 (Sentry만 호출) | 컨테이너 수준 (대부분 Docker 몫) | 멀티테넌트 컨테이너 | Linux |
| Firecracker | microVM (게스트 커널) | KVM (/dev/kvm), jailer |
비공유 | ≤125ms (벤더 수치) | Lambda/Fargate, Kata | Linux/KVM |
| sandbox-exec | 프로세스 (SBPL 프로필) | 비특권 | 공유 (XNU) | 매우 짧음 | srt(macOS) | macOS (deprecated) |
시작 지연은 공식 문서에 수치가 있는 Firecracker만 숫자로 적었고 나머지는 정성적 표현이다.
💡 실전: 에이전트가 만든 Python 스크립트 실행하기
시나리오는 하나다. LLM이 agent.py를 만들었고, /work에만 쓰고, 네트워크 없이, 제한 시간 안에 돌려야 한다. 이 글은 macOS에서 쓰고 있어 bwrap과 nsjail은 실행하지 못했고, Docker가 있지만 --runtime=runsc는 호스트에 runsc가 없어 문법만 제시한다. 플래그와 필드명은 각 man page/스키마에서 확인한 것이다.
1) bubblewrap 한 줄
bwrap --unshare-all --die-with-parent --new-session \
  --ro-bind /usr /usr --symlink usr/lib64 /lib64 \
  --proc /proc --dev /dev --tmpfs /tmp \
  --bind "$PWD/work" /work --chdir /work \
  --clearenv --setenv PATH /usr/bin \
  /usr/bin/python3 /work/agent.py
--unshare-all이 net 네임스페이스까지 떼므로 네트워크가 없고, 쓰기 가능한 곳은 /work와 /tmp(tmpfs) 뿐이다. 홈 디렉터리는 아예 마운트되지 않아 ~/.ssh는 존재하지 않는다. /lib64 심볼릭 링크는 README 예제 그대로이며, 배포판에 따라 /lib, /etc/ld.so.cache 등을 추가로 --ro-bind 해야 할 수 있다. 시간 제한은 bwrap에 없으니 timeout 60 bwrap ...으로 바깥에서 건다.
2) nsjail 설정 파일
name: "agent-python"
mode: ONCE
hostname: "agent"
cwd: "/work"
time_limit: 60
rlimit_as: 512
rlimit_fsize: 16
rlimit_nofile: 32
clone_newnet: true
keep_env: false
envar: "PATH=/usr/bin"
mount { src: "/usr" dst: "/usr" is_bind: true rw: false }
mount { src: "/lib" dst: "/lib" is_bind: true rw: false }
mount { dst: "/tmp" fstype: "tmpfs" rw: true noexec: true nosuid: true }
mount { src: "/host/work" dst: "/work" is_bind: true rw: true }
seccomp_string: "ERRNO(1) { ptrace, process_vm_readv, process_vm_writev }"
seccomp_string: "DEFAULT ALLOW"
exec_bin { path: "/usr/bin/python3" arg: "/work/agent.py" }
nsjail --config agent.cfg
rlimit_as와 rlimit_fsize는 MiB 단위다(스키마 기본값 4096, 1). Kafel 정책은 저장소 예제와 같은 형식으로, 여기서는 ptrace 계열만 ERRNO로 막고 나머지를 허용하는 느슨한 버전이다. 채점기처럼 빡빡하게 가려면 DEFAULT KILL에 허용 목록을 쓰는 README 예제 쪽이 맞다.
3) gVisor
sudo runsc install            # "runsc" 이름의 Docker 런타임 등록
sudo systemctl restart docker
docker run --runtime=runsc --rm --network none \
  -v "$PWD/work:/work" -w /work python:3.12-slim python agent.py
KVM 플랫폼을 쓰려면 /etc/docker/daemon.json의 런타임 항목에 "runtimeArgs": ["--platform=kvm"]을 추가하고 Docker를 재시작한다. 공식 퀵스타트는 dmesg 출력에 "Starting gVisor..."가 보이는지로 확인하라고 하면서도, 공격자가 이 출력을 쉽게 흉내 낼 수 있으니 보안 목적의 검증에는 쓰지 말라고 덧붙인다.
세 방식의 차이는 신뢰 경계의 위치다. bwrap과 nsjail은 호스트 커널을 믿고, gVisor는 Sentry를 믿고 호스트 커널 노출을 줄인다. 에이전트 코드가 "실수"만 한다면 1)로 충분하고, "적대적"이라고 가정하면 3) 이상으로 올라가야 한다.
🔍 한계와 주의
커널 공유 격리는 커널 버그 하나로 무너진다. CVE-2017-5123은 커널 waitid의 데이터 검증 부족으로 "사용자가 Linux 샌드박스를 탈출"할 수 있었던 사례이고(NVD, CVSS 8.8), 이 경우 bwrap이든 nsjail이든 Docker든 같은 커널 위라면 같은 운명이다. 런타임 자체의 결함도 있다. runc의 CVE-2019-5736(CVSS 8.6)은 /proc/self/exe 처리 문제로 컨테이너 안에서 호스트 runc 바이너리를 덮어써 root를 얻었고, CVE-2024-21626(CVSS 8.6)은 파일 디스크립터 누수로 컨테이너 프로세스의 작업 디렉터리가 호스트 파일시스템에 걸리게 했다. 샌드박스 도구 자신이 공격면이 되는 사례가 앞서 본 firejail의 CVE-2022-31214다.
네트워크 격리는 별도 문제다. 네임스페이스를 떼면 통신이 전부 끊기는데, 에이전트는 보통 패키지 설치나 API 호출이 필요하다. srt가 네트워크 네임스페이스를 제거한 뒤 Unix 소켓과 프록시로 허용 도메인만 다시 열어 주는 구조를 택한 이유다. 어떤 도구도 이 부분을 공짜로 주지 않는다.
샌드박스는 권한 축소이지 신뢰 경계의 전부가 아니다. 샌드박스 안에서도 에이전트는 /work의 코드를 망가뜨릴 수 있고, 허용된 도메인으로 데이터를 보낼 수 있다. Landlock 문서가 "샌드박싱 전에 열어 둔 파일 디스크립터는 제한되지 않는다"고 못 박듯, 경계는 무엇을 넘겨주고 시작하느냐로 결정된다. 따라서 샌드박스는 정책 게이트, 1회용 자격증명, 감사 로그 같은 상위 통제와 함께 가야 하고, 그 조합이 직무 분리 글에서 다룬 아키텍처다.
마지막으로, 이 글의 가장 쉬운 결론 하나. 이미 Docker를 쓰고 있다면 --runtime=runsc 한 줄로 에이전트 컨테이너의 커널 노출 표면을 크게 줄일 수 있다. 그 다음이 Firecracker이고, 그 전에 할 일이 --network none과 읽기 전용 마운트다.
📚 참고
- bubblewrap: GitHub README · bwrap(1) man page 원본
- Flatpak: Sandbox Permissions
- firejail: GitHub README · RELNOTES · NVD CVE-2022-31214
- nsjail: GitHub README · config.proto
- Landlock: Kernel userspace API 문서 · samples/landlock/sandboxer.c
- seccomp: Kernel seccomp filter 문서 · Docker seccomp security profiles
- cgroups: Control Group v2
- gVisor: What is gVisor? · Platform Guide · Performance Guide · Security Model · Docker Quick Start
- Firecracker: GitHub · design.md · SPECIFICATION.md · Agache et al., "Firecracker: Lightweight Virtualization for Serverless Applications", NSDI 2020
- Kata Containers: katacontainers.io/learn · Wasmtime: Security
- macOS:
man sandbox-exec(macOS 27, DEPRECATED 표기) · Anthropic sandbox-runtime - NVD: CVE-2017-5123 · CVE-2019-5736 · CVE-2024-21626
본 글의 그림 1은 직접 그렸고, 그림 2·3은 gvisor.dev 공식 문서, 그림 4는 Firecracker 저장소 docs/design.md에서 가져왔습니다.