Scaling Git at OpenAI: Codex 시대의 커밋 폭증을 받아낸 Git 호환 백엔드 Pando
"On handling a push, Pando validates the incoming packfile while streaming it to blob storage, without unpacking it into a local repository." — OpenAI, "Scaling Git at OpenAI" (HN 댓글에 인용된 문장)
push된 팩을 풀지 않는다. 이 한 문장에 Pando 설계의 절반이 들어 있다. Git 서버가 느려지는 이유는 대개 "저장소"라는 단일 지점에 모든 것이 모이기 때문인데, OpenAI는 저장소를 아예 두지 않고도 Git 클라이언트와 대화하는 백엔드를 만들었다.
🤔 왜 Git 서버가 병목이 되었나
2026년 11월 2일 OpenAI 엔지니어링 블로그에 "Scaling Git at OpenAI"(Aaron Friel, Taylor Blau, Ted Nyman)가 올라왔다. RSS 설명문은 "How OpenAI built Pando, a Git-compatible backend designed for the scale of development that Codex makes possible"이다.
먼저 고지할 것이 있다. 원문은 직접 열람하지 못했다. 글을 쓰는 시점에 openai.com이 자동 열람을 차단해(403) 본문을 그대로 읽지 못했다. 그래서 이 글은 RSS 메타데이터, Hacker News 스레드에 인용된 원문 문장, 공개 저장소 github.com/openai/git의 문서 diff, Anthropic 원문, Git 공식 문서, 그리고 2차 정리글 여럿을 교차 확인해 썼다. Git 저장소·Git 문서·Anthropic 글에서 확인한 것은 단정형으로, OpenAI 글 내용 중 둘 이상의 출처가 일치하는 것은 "OpenAI는 ~라고 밝혔다"로, 한 곳에서만 본 것은 "~로 전해진다"로 쓴다. 성능 수치는 전부 OpenAI 주장(벤더 수치)이다.
배경은 단순하다. Codex가 들어오면서 엔지니어 한 명이 동시에 굴리는 작업 수가 늘었고, 그만큼 브랜치·push·merge가 늘었으며, 개발 환경·연구 잡·CI가 만드는 fetch와 clone도 함께 늘었다. OpenAI는 모노레포 master 커밋 수가 2024년 1분기 대비 2026년 3분기에 1,378% 증가했고 4분기 추정치는 2,442%라고 밝혔다. 2025년 말부터 기존 시스템이 밀리기 시작해 fetch·push 지연과 merge 실패가 잦아졌고, 신뢰성이 "때때로 90% 아래"로 떨어졌다고 한다.
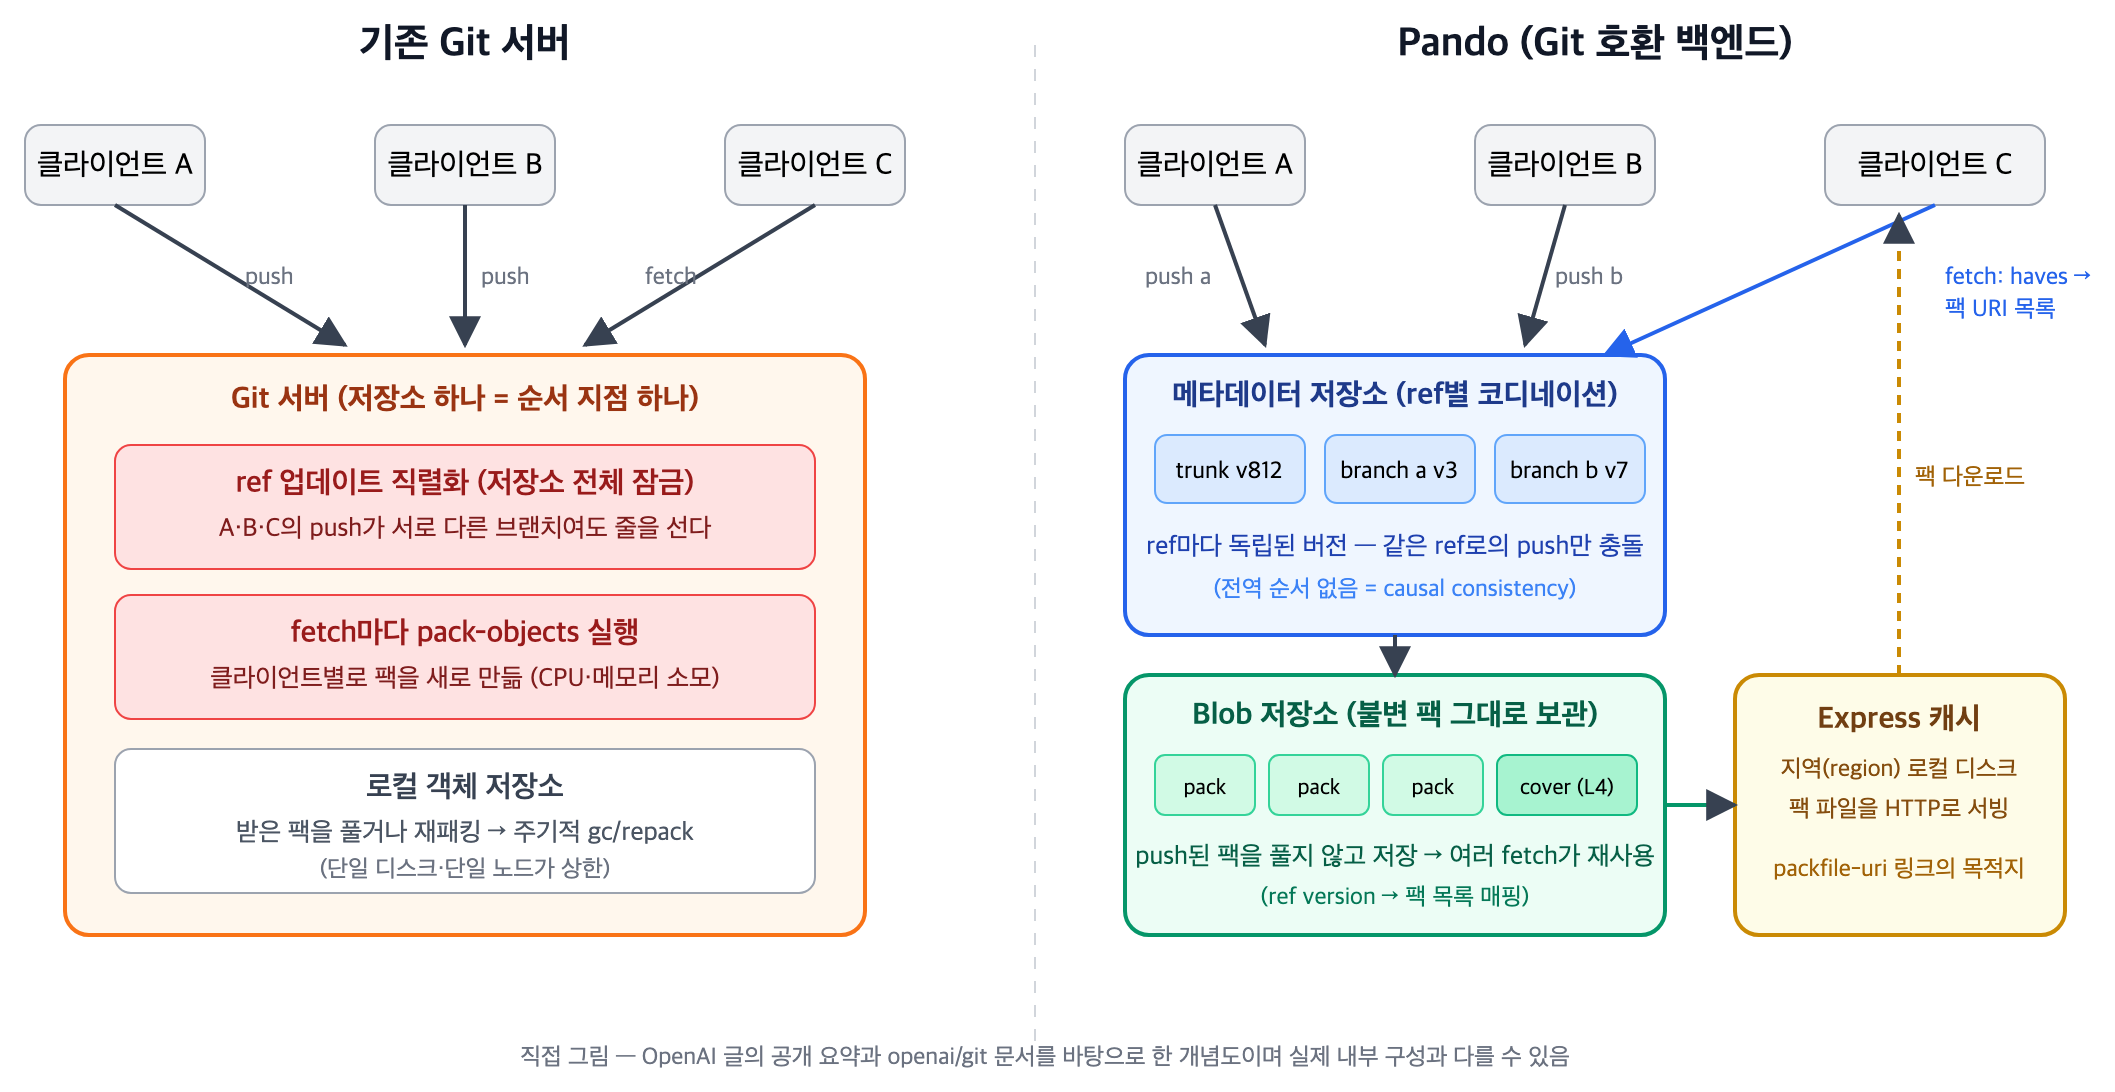
왜 Git 서버는 이런 부하에 약할까. Git 프로토콜 문서(gitprotocol-pack)를 보면 구조가 보인다. push는 서버가 ref 목록을 광고(advertise)하고, 클라이언트가 그 광고를 보고 "서버가 이미 가진 객체"를 추려 thin pack을 만들어 보내며, 서버는 각 ref에 대해 old-id new-id refname 형태의 업데이트 명령을 받아 처리한다. fetch는 반대로 클라이언트가 want/have를 보내면 서버가 pack-objects를 돌려 그 클라이언트에 맞는 팩을 새로 만든다. 즉 (1) ref 업데이트는 저장소 단위로 직렬화되고, (2) 팩은 요청마다 생성되며, (3) 광고는 저장소의 모든 ref를 담는다. 브랜치가 수백만 개로 늘고 수천 개의 에이전트가 동시에 push·fetch를 하면 이 세 가지가 전부 비용이 된다.
🧠 Pando의 설계 원칙 3가지
OpenAI가 밝힌 설계는 세 축으로 요약된다.
1) ref별 코디네이션과 causal consistency. 브랜치(ref)마다 독립적으로 조정하고, 같은 ref로 향하는 push만 서로 충돌한다. 대신 여러 브랜치를 한꺼번에 읽을 때 "한 시점의 스냅샷"은 보장하지 않는다. OpenAI는 "사용자와 에이전트는 ref 업데이트의 전역 순서에 무관하다"는 관찰을 근거로 들었다. 2차 정리글 중 한 곳은 이를 ref 단위 직렬화 + read-your-own-write로 설명하는데, 단일 출처라 그대로 옮기지는 않는다. 기각된 대안으로 three-phase commit(브랜치 업데이트마다 복제본 과반 합의)과 blob storage의 공유 manifest를 push마다 갱신하는 write-ahead log가 검토됐다고 전해지며, 둘 다 공유 순서 지점이 남는 것이 문제였다고 한다. 글에는 writer 1,000개가 동시에 push하는 인터랙티브 시뮬레이션이 있고, OpenAI는 이를 "Synthetic teaching models, not production benchmarks"라고 표기했다.
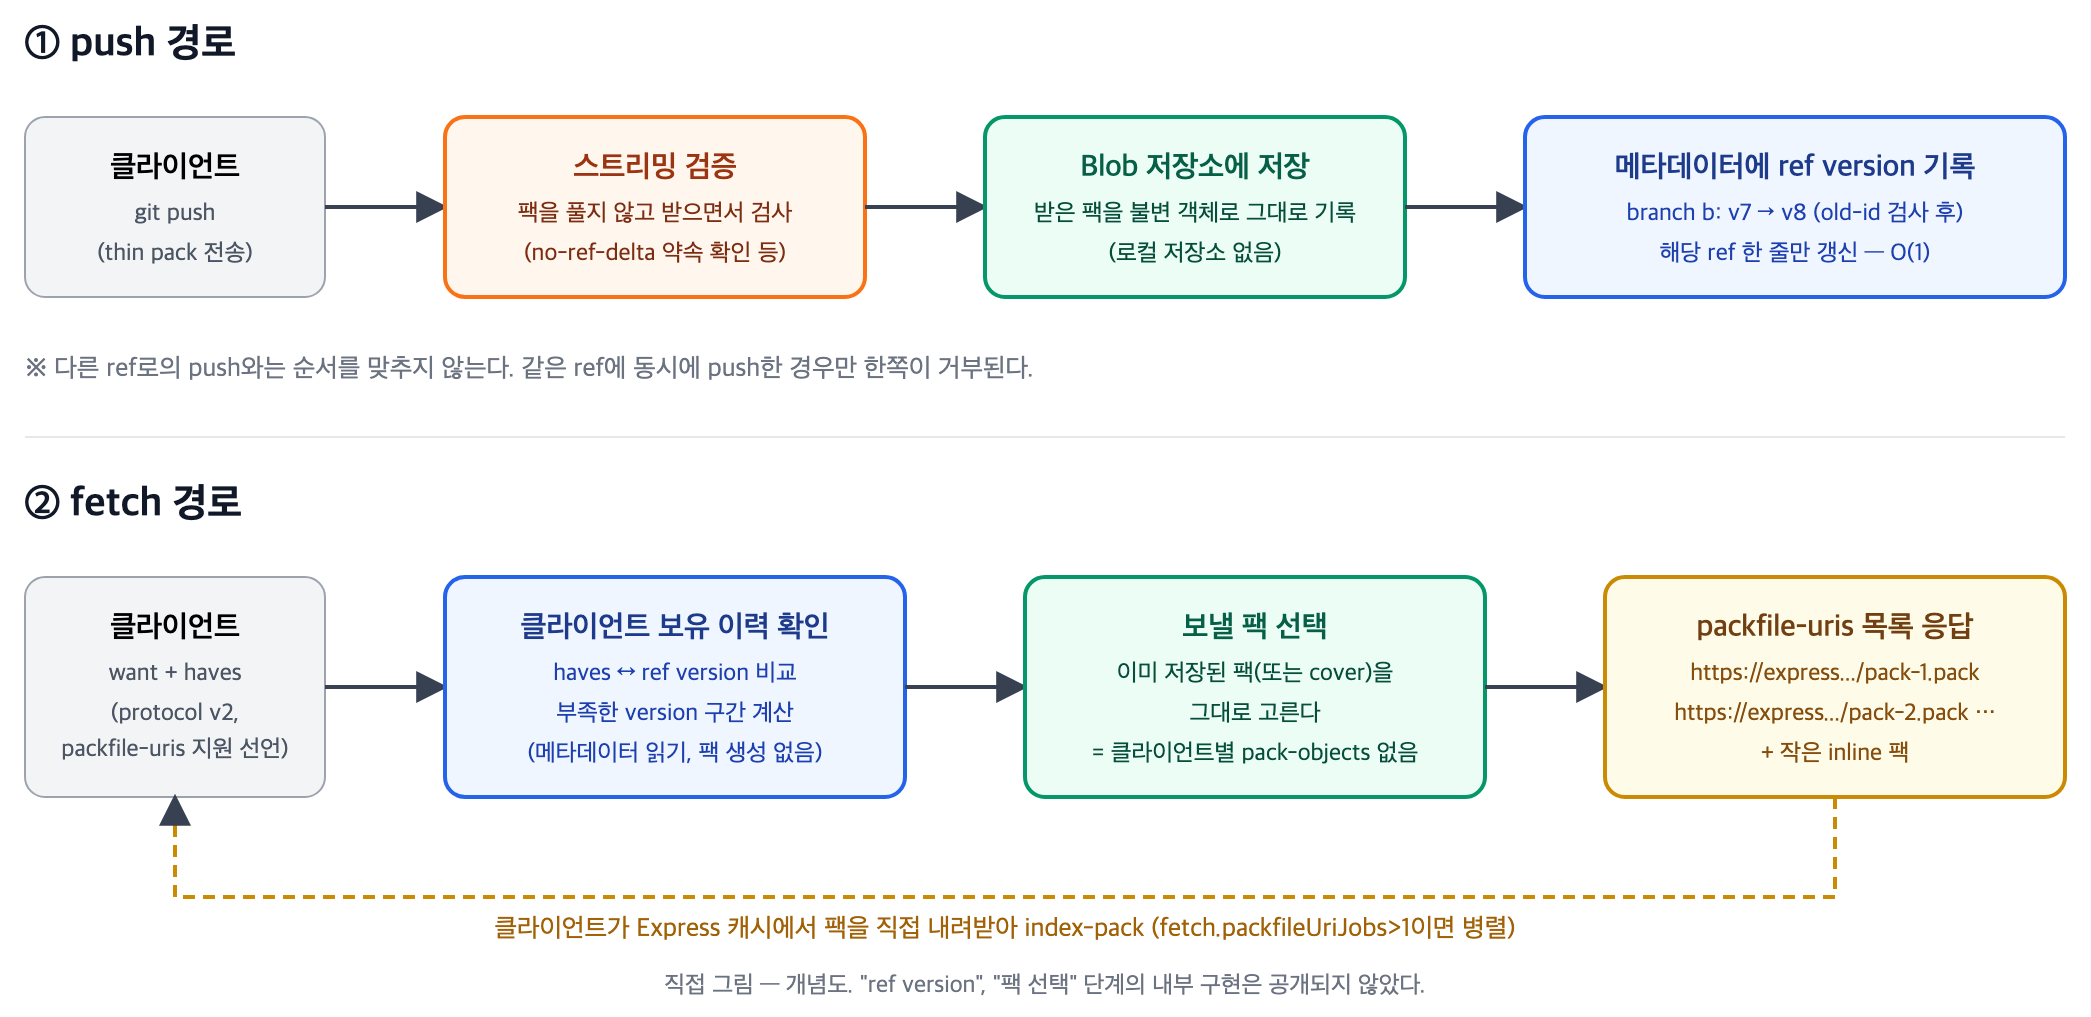
2) push된 팩을 그대로 저장하고 재사용한다. 서두의 인용처럼 Pando는 들어오는 packfile을 스트리밍으로 검증하면서 blob storage에 그대로 쓴다. 로컬 저장소가 없으니 풀거나(unpack) 재패킹할 것도 없다. 브랜치의 이동은 메타데이터 저장소에 "ref version"으로 기록된다. push의 메타데이터 갱신은 O(1), fetch의 메타데이터 읽기는 O(log Δ)로 전해진다(단일 출처). 메타데이터 서비스 이름은 "Turtle"로 전해진다.
fetch는 이 구조의 반대편이다. 서버는 클라이언트가 보낸 haves로 보유 이력을 확인하고, 필요한 version 구간에 해당하는 이미 저장된 팩을 골라 Git protocol v2의 packfile-uri로 다운로드 링크를 돌려준다. 링크의 목적지는 지역별 캐시 서비스 "Express"다. 클라이언트별로 팩을 만들지 않고, 같은 팩을 여러 클라이언트가 받는다.
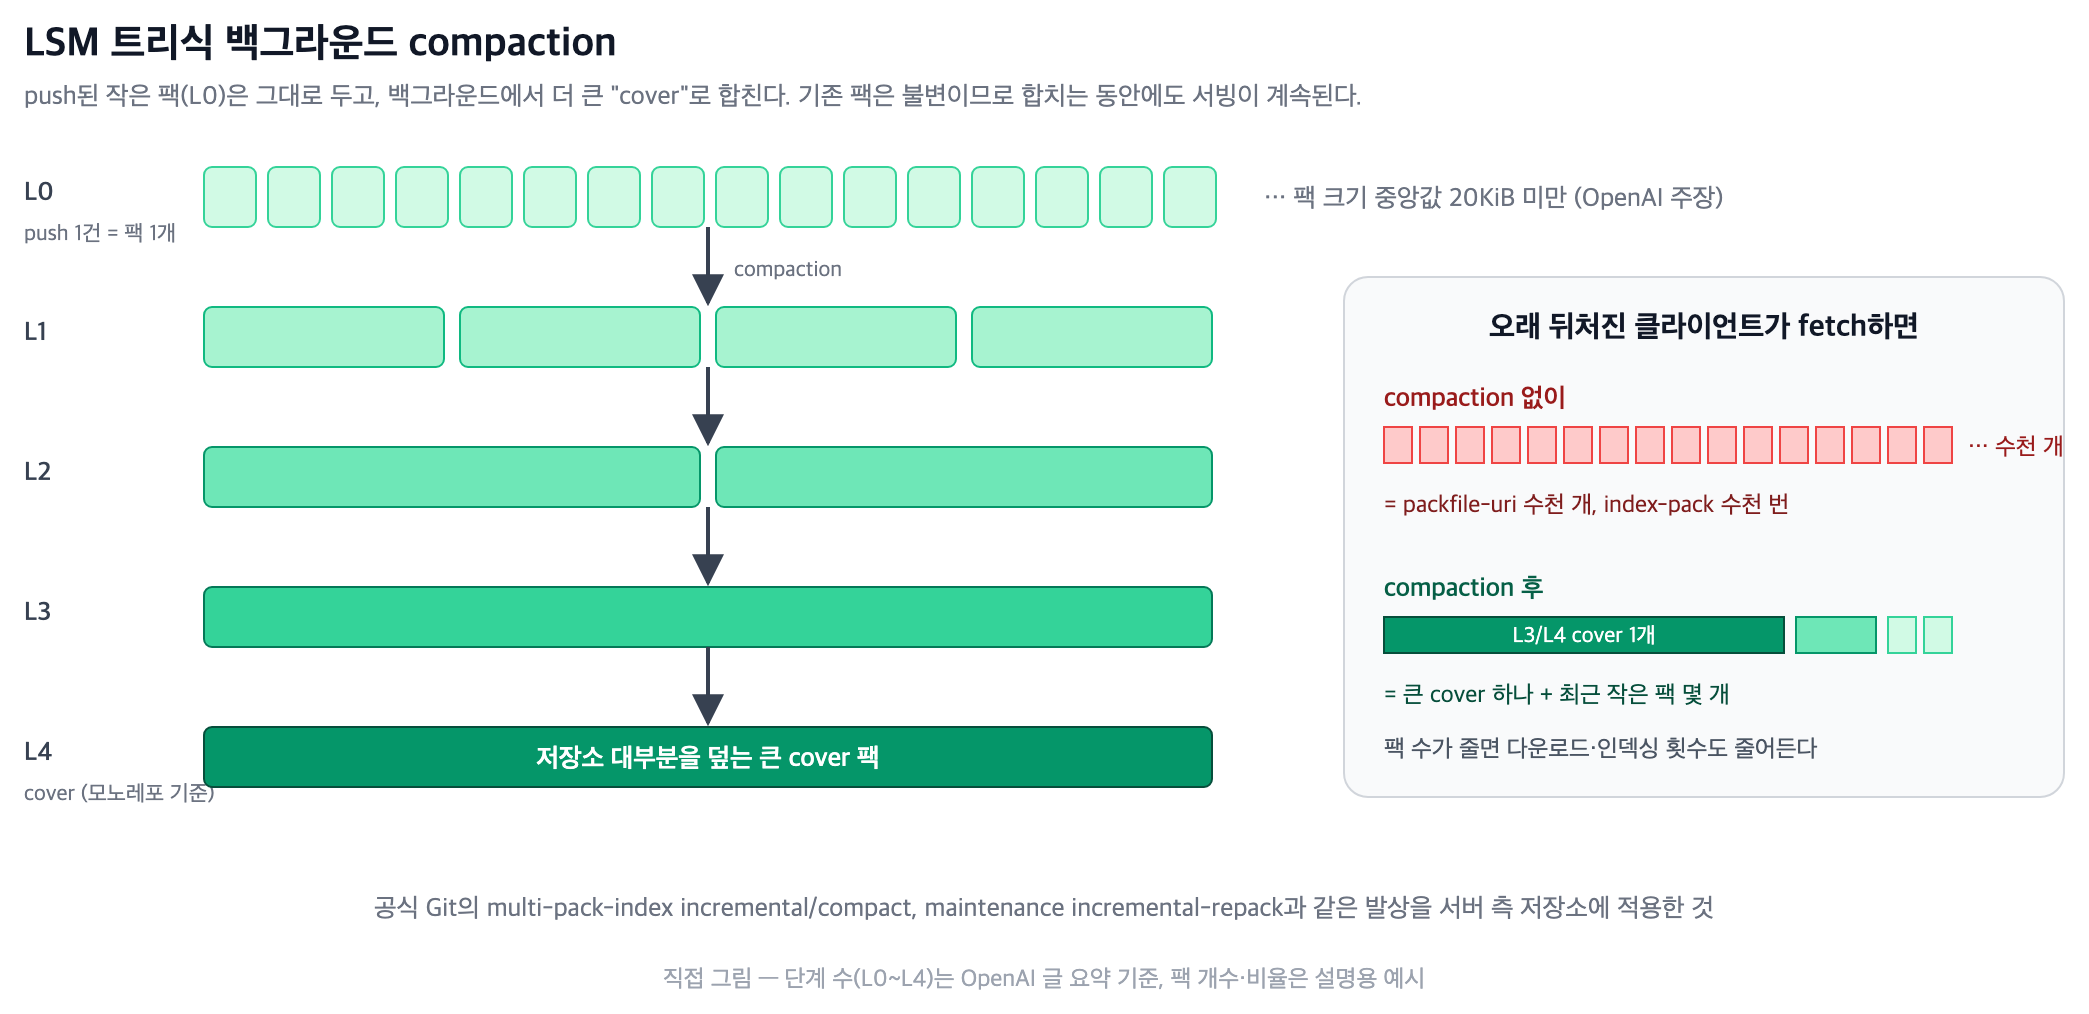
3) LSM 트리식 compaction과 cover. push마다 팩이 하나씩 생기면 오래 뒤처진 클라이언트는 수천 개의 팩을 받아야 한다. OpenAI는 LSM 트리처럼 백그라운드에서 작은 L0 팩을 더 큰 "cover"로 합치며, 모노레포는 L4까지 간다고 밝혔다. 기존 팩이 불변이므로 합치는 동안에도 서빙은 계속된다.
구현에 대해 OpenAI는 Rust로 처음부터 새로 썼고, 범용 하드웨어에서 돌며, Codex와 함께 킥오프부터 프로덕션까지 10주가 걸렸다고 밝혔다. HN에 인용된 원문은 "The core of Pando was designed by a single engineer, implemented by teams of agents, and deployed by a handful of engineers"이고, 2026년 4월부터 기존 시스템 앞의 read-write 프록시로 트래픽을 받기 시작했다. 검증에는 표준 Git 대비 conformance 테스트, negotiation·pack planning의 경쟁 조건을 잡는 deterministic simulation, 에이전트가 쓴 Lean·TLA+ 명세, 에이전트 red-teaming이 쓰였다고 한다. Jujutsu 지원이 글 하단에 언급된다고 전해진다.
🛠️ 클라이언트 쪽 변경: openai/git 포크 해부
서버를 바꾸면 클라이언트도 바뀌어야 한다. 여기부터는 공개 저장소 github.com/openai/git(2026-07-10 생성, 기본 브랜치 codex, git/git 대비 115 커밋 ahead, 변경 파일 85개)의 문서 diff를 gh api로 직접 읽은 내용이라 단정형으로 쓴다. 커밋 작성자는 Taylor Blau, Aaron Friel, Daniel Reynaud, Elijah Newren, Pia Park이다.
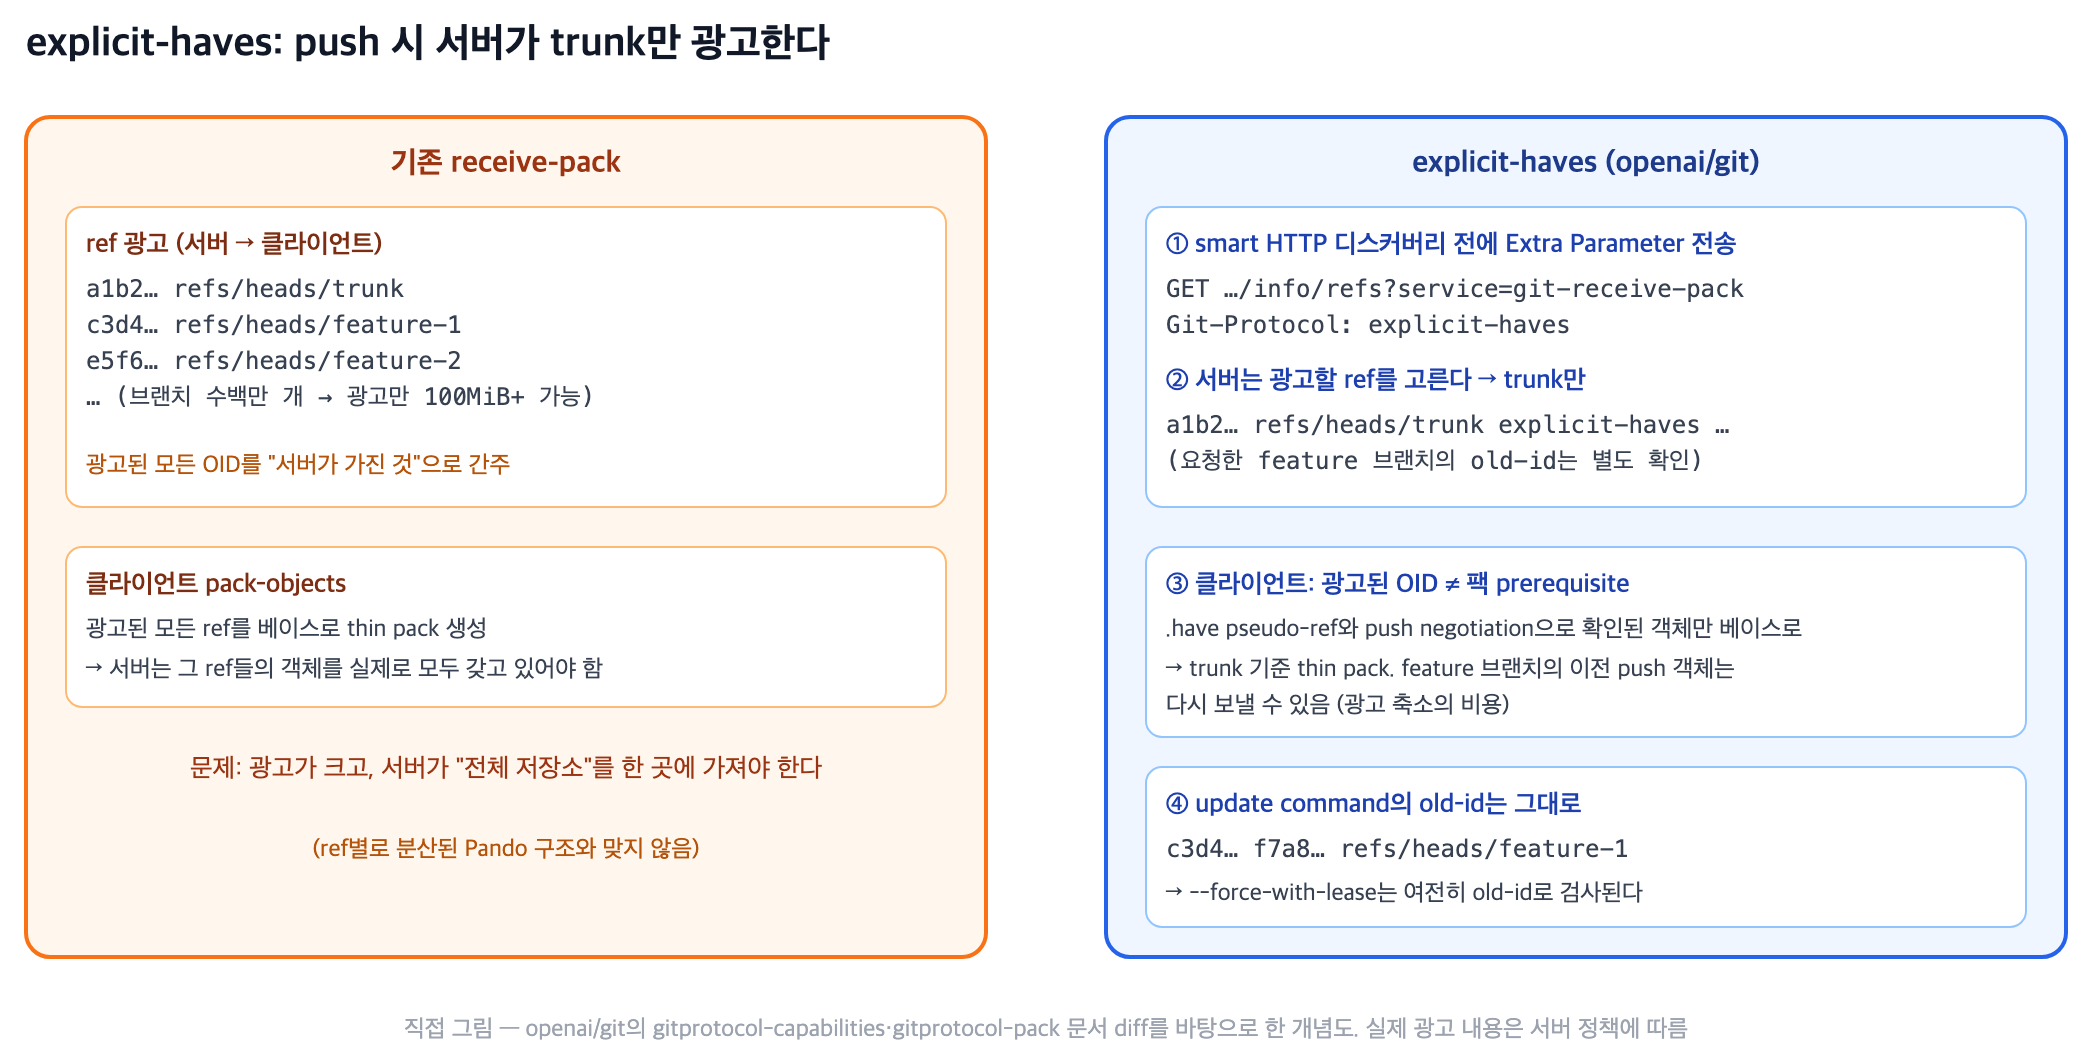
explicit-haves. 수백만 개의 브랜치를 전부 광고하면 광고만으로 수십 MiB가 된다. 포크는 receive-pack에 explicit-haves capability를 추가했다. gitprotocol-capabilities 문서의 새 절을 그대로 옮기면 다음과 같다.
The receive-pack server can advertise 'explicit-haves' to indicate that the object IDs of its named refs are not necessarily pack prerequisites. When a client requests this capability, it MUST NOT treat an object as a pack prerequisite merely because the server advertised a named ref that points to it. Objects named by ".have" pseudo-refs and common objects explicitly acknowledged by push negotiation remain valid pack prerequisites. This capability does not otherwise change how the client uses advertised refs, including for reference matching and update preconditions.
smart HTTP에서는 클라이언트가 ref 광고 전에 bare explicit-haves Extra Parameter를 먼저 보내고, "서버가 그 클라이언트에게 어떤 ref를 광고할지 고를 수 있게" 한다. 이것이 "push 시 trunk만 광고"를 가능하게 하는 장치다. 광고된 OID는 여전히 update command의 old-id로 쓰이므로 --force-with-lease 검사는 그대로 동작한다(gitprotocol-pack: "The advertised object ID of a named ref is still used as the old-id in the corresponding update command"). 비용도 있다. OpenAI가 밝힌 대로 feature 브랜치를 다시 push할 때 trunk 밖의 객체를 다시 보낼 수 있다.
no-ref-delta와 병렬 인덱싱. Git 팩 포맷(gitformat-pack)에는 델타 베이스를 같은 팩 안의 오프셋으로 가리키는 OBJ_OFS_DELTA(type 6)와 객체 ID로 가리키는 OBJ_REF_DELTA(type 7)가 있다. REF_DELTA는 팩 바깥의 객체를 가리킬 수 있어서 thin pack의 기반이 되지만, 바로 그 때문에 packfile-uri로 받은 여러 팩은 광고된 순서대로 인덱싱해야 한다. 포크의 packfile-uri.adoc은 이유를 이렇게 적는다. "a later pack may contain a REF_DELTA whose base is installed by an earlier response pack." 서버가 no-ref-delta를 광고하고 클라이언트가 요청하면 inline 팩과 모든 URI 팩에 REF_DELTA가 없다는 약속이 성립하고, 클라이언트는 팩을 동시에 인덱싱할 수 있다. 이를 위해 git pack-objects --no-ref-delta, git index-pack --no-ref-delta(REF_DELTA가 있으면 거부) 옵션, protocol v2 fetch의 no-ref-delta 인자, receive-pack 쪽 capability가 추가됐다. 문서는 no-ref-delta가 ofs-delta를 함축하지 않는다고 명시한다.
packfile-uri 다운로드의 인증과 재시도. 원래 Git의 packfile-uri 설계 문서는 "Additional HTTP headers (e.g. authentication)"을 미래 과제로 남겨 두었다. 포크는 팩 다운로드가 다른 Git HTTP 요청과 같은 인증·리다이렉트 설정을 쓰고, 자격증명을 팩 URL 기준으로(credential.useHttpPath 포함) 찾도록 바꿨다. 502·503·504는 1초, 2초 + 최대 1초 지터로 두 번까지 재시도하고, Retry-After는 10초까지만 존중하며, 429는 http.maxRetries·http.retryAfter·http.maxRetryTime을 따른다. 중단된 전송은 재시도하지 않는다.
midx 안정화. 커밋 로그의 절반 가까이가 multi-pack-index 관련이다. incremental MIDX 체인 검증, 중간에 사라진 팩 복구, compaction 실패 시 중단, 레이어 승격 재시도 같은 제목들이다. maintenance: account for promisor pack geometry처럼 로컬 유지보수가 수많은 작은 팩을 감당하도록 한 변경도 있다. 클라이언트가 수천 개의 작은 팩을 받는 세계에서는 로컬 저장소의 팩 관리가 곧 성능이다.
설정 예시는 포크 문서에 있는 옵션 이름만 썼다.
# 클라이언트 (openai/git 포크 기준)
[fetch]
    uriprotocols = https       # packfile-uri 수신 허용 프로토콜 (기본 비어 있음)
    packfileUriJobs = 4        # 동시 다운로드·인덱싱 수. 서버가 no-ref-delta를 광고하고
                               # 클라이언트가 요청했을 때만 1 초과 값이 적용됨
[http]
    maxRetries = 3             # 429 재시도 횟수 (기본 0)

# 서버 (upload-pack)
[uploadpack]
    allowNoRefDelta = true     # v2 fetch에서 no-ref-delta 광고. URI 팩은 관리자가
                               # pack-objects --no-ref-delta 로 만들었음을 보장해야 함
git pack-objects --no-ref-delta --stdout < objects.txt > pack.pack   # REF_DELTA 없는 팩 생성
git index-pack --no-ref-delta pack.pack                              # REF_DELTA가 있으면 거부
OpenAI는 packfile-uri 개선 일부를 upstream Git에 보냈고 나머지는 이 저장소에 공개했다고 밝혔다. 저장소의 CI 워크플로는 "Codex Git" 릴리스 아티팩트(LTO·PGO 빌드, Windows arm64, dugite 포크)를 만든다.
📊 OpenAI가 밝힌 수치
아래는 전부 OpenAI 주장(벤더 수치) 이며 독립 벤치마크가 아니다. 둘 이상의 2차 출처가 일치한 항목만 실었다.
| 항목 | OpenAI 주장 |
|---|---|
| master 커밋 수 증가 | 2024 Q1 → 2026 Q3 +1,378%, 2026 Q4 추정 +2,442% |
| 중앙값 push 지연 | "nearly 5x" 감소 |
| 일일 서빙량 | 약 1 PB/일 |
| 피크 서빙량 | 1시간에 57 TB 이상, 99% 이상 로컬 디스크 캐시 적중 |
| 네트워크 | 표준 클라우드 VM에서 10 Gbps 링크 포화 |
| 팩 크기 | 중앙값 20 KiB 미만, p99 3 MiB 미만 |
| 개발 기간 | Codex와 함께 10주, 2026년 4월 프로덕션 투입 |
merge 신뢰성 99.99%, "a handful of CPU cores"로 1 PB/일, 브랜치 수백만 개와 100 MiB를 넘는 전체 브랜치 목록은 각각 단일 출처에서만 확인되어 "전해진다" 수준으로만 적어 둔다. 초당 push 수나 동시 pusher 수 같은 처리량 수치는 어느 출처에도 없다.
🔍 Anthropic Scion·Google/Meta와의 비교
Anthropic은 2026년 10월 "Redesigning source control"에서 자체 SCM Scion을 공개했다. 원문을 직접 읽었으므로 아래 수치는 단정형이다. Anthropic은 모노레포를 5개월 만에 Git에서 완전히 이전했고, 하루 merge가 2026년 5월 약 2,500건에서 9월 30,000건 이상으로 늘었다. main 히스토리는 거의 100 GB, CI 체크아웃은 하루 약 2,500만 회이며, Scion 인프라의 CPU·메모리는 이전 Git 미러 구성의 200분의 1이고 캐시 계층의 적중률은 99% 이상이다. 설계는 항상 온라인인 클라이언트, 서버에서 수행하는 커밋·merge·rebase·blame, API로 노출된 질의, packfile 없는 분산 저장, main과 릴리스 브랜치 외의 ref 지양, sparse·가상화 체크아웃이다. ref 이동은 Spanner 한 행의 compare-and-swap이다. Anthropic은 Scion이 "Git과 크게 다르며" 범용 대체재가 아니라고 못 박았고, 공개 계획 대신 설계를 공유하고 GitHub·GitLab·OSS 커뮤니티와 협력하겠다고 했다.
| OpenAI Pando | Anthropic Scion | |
|---|---|---|
| 접근 | Git 프로토콜·클라이언트 유지, 백엔드 교체 | Git을 떠나 새 SCM |
| 저장 단위 | push된 packfile 그대로 (불변) | changeset (packfile 없음) |
| ref 조정 | ref별 독립 version, 전역 순서 없음 | Spanner 행 CAS, ref 자체를 지양 |
| 클라이언트 | openai/git 포크 (explicit-haves, no-ref-delta) | 전용 클라이언트, 서버 측 커밋 |
| 개발 | Codex와 10주, Rust | 7명, 5개월 |
| 공개 | 내부 전용, 포크·upstream 패치만 공개 | 내부 전용, 설계 공유 예정 |
두 글의 차이는 "Git 호환을 지킬 것인가"다. Pando는 git push·git fetch가 그대로 동작하는 대신 Git 프로토콜의 제약(광고, thin pack, 팩 단위 전송)을 확장으로 우회했고, Scion은 호환을 포기한 대신 커밋을 서버로 옮겨 push 자체를 없앴다. HN에서는 "Google·Meta는 수년 전부터 비슷한 설계였다"는 지적과 함께, 이 글이 Anthropic 글에 대한 응답이라는 시각도 있었다.
⚠️ 한계와 논쟁
HN 스레드(264점, 179댓글)의 비판을 추리면 다섯 가지다.
- 검증 불가한 수치. 벤치마크가 없다. 초당 push, 동시 pusher 같은 기본 처리량이 빠져 있고, 시뮬레이션은 OpenAI 스스로 "production benchmarks"가 아니라고 표기했다.
- trunk만 광고의 비용. 광고를 줄이는 대신 feature 브랜치 재push에서 객체가 중복 전송될 수 있다. 큰 바이너리를 브랜치에 올려 두는 워크플로라면 체감될 수 있다.
- 멀티브랜치 스냅샷 부재. causal consistency는 "여러 브랜치를 한 시점에 읽는" 보장을 포기한다. 릴리스 브랜치 여러 개를 함께 다루는 도구는 이 가정을 다시 확인해야 한다.
- 클라이언트 팩 신뢰. "풀지 않고 저장"은 서버가 팩 내용을 완전히 재구성해 보지 않는다는 뜻이다. 스트리밍 검증이 무엇을 검사하는지가 공개되지 않아, 에이전트가 만든 악성 팩에 대한 방어가 충분한지 묻는 댓글이 있었다.
- 커밋 폭증 자체에 대한 의문. 커밋 수가 자산인지 부채인지, 수정 커밋이 수정 커밋을 낳는 것은 아닌지 하는 논쟁이 스레드의 큰 줄기였다. OpenAI 저자의 답글은 없었다.
여기에 하나를 더하자면, Pando 자체는 공개되지 않았다. OpenAI는 "Pando를 가능하게 한 기술을 사용자와 공유할 방법을 모색 중"이라고만 밝혔다.
💡 일반 팀이 가져갈 수 있는 것
Pando를 쓸 수는 없지만, 그 설계의 상당 부분은 표준 Git에 이미 있다. 아래는 전부 git-scm.com 공식 문서에서 확인한 것이다.
- packfile-uri — protocol v2 전용. 서버가
packfile-uris를 광고하고 클라이언트가 지원 프로토콜을 보내면, 서버는 팩 일부를 URI(CDN 등)로 대체해 보낼 수 있다. 클라이언트는 connectivity check 전에 모든 URI를 받아 인덱싱한다. 클라이언트 설정은fetch.uriprotocols(기본 비어 있음)이다. - bundle-uri —
git clone --bundle-uri=<uri>로 fetch 전에 번들을 받아 "seed"한다. 서버는 v2bundle-uri명령으로 번들 목록을 광고할 수 있고, 목록의bundle.mode는all/any다. 문서는 목적을 "서버 자원 소비 최적화"로 적는다. - partial clone —
git clone --filter=<filter-spec>으로 서버가 reachable 객체의 부분집합만 보내게 한다. 빠진 객체는 promisor remote에서 필요할 때 받는다. 온라인이어야 한다는 전제는 Scion의 "always-online client"와 같은 전제다. - multi-pack-index —
git multi-pack-index write --incremental,compact <from> <to>,expire,repack --batch-size=<size>. 작은 팩을 여럿 두고 점진적으로 합치는 서버 측 compaction의 로컬 버전이다. - maintenance —
git maintenance register/start. incremental 전략의 기본 일정은 commit-graph 매시간, prefetch 매시간, loose-objects 매일, incremental-repack 매일, gc 비활성이다. incremental-repack은multi-pack-index expire뒤multi-pack-index repack을 돌리는 두 단계로 동시 실행과의 경쟁을 피한다. - --force-with-lease —
git push --force-with-lease=<refname>:<expect>는 원격 ref의 현재 값이<expect>일 때만 갱신한다. Pando의 ref별 version 검사와 같은 "lease" 모델이 이미 클라이언트에 있다.
git clone --filter=blob:none --bundle-uri=https://cdn.example.com/repo.bundle https://git.example.com/repo.git
git maintenance start                              # 백그라운드 스케줄 등록
git multi-pack-index write --incremental           # 기존 체인 위에 새 레이어 추가
git push --force-with-lease=refs/heads/feature:a1b2c3d origin feature
Codex든 Claude Code든 에이전트 여러 개가 같은 저장소에 동시에 push하는 팀이라면, 서버를 바꾸기 전에 이 여섯 가지를 먼저 켜 보는 것이 순서다. 에이전트 실행 환경 쪽 인프라는 샌드박싱 도구 지도에서 다뤘다.
📚 참고
- OpenAI, "Scaling Git at OpenAI" (2026-11-02, 원문 직접 열람 불가): https://openai.com/index/scaling-git-at-openai/ · RSS: https://openai.com/news/rss.xml
- openai/git 저장소(
codex브랜치): https://github.com/openai/git —Documentation/gitprotocol-capabilities.adoc,gitprotocol-pack.adoc,gitprotocol-v2.adoc,technical/packfile-uri.adoc,config/fetch.adoc,config/uploadpack.adoc,config/http.adoc,git-pack-objects.adoc,git-index-pack.adoc - Hacker News 스레드: https://news.ycombinator.com/item?id=50345924
- Anthropic, "Redesigning source control for the agentic era": https://www.anthropic.com/engineering/redesigning-source-control
- Git 공식 문서: gitprotocol-v2 · gitprotocol-pack · gitprotocol-capabilities · gitformat-pack · packfile-uri · bundle-uri · partial-clone · git-multi-pack-index · git-maintenance · git-push · git-clone
- 교차 확인에 쓴 2차 정리글: kingy.ai, developersdigest.tech, smartscope.blog, cellcog.ai, startupfortune.com의 "Scaling Git at OpenAI" 요약 (둘 이상 일치한 항목만 사용)
본 글의 그림은 직접 그렸습니다.