FreeToken: 대역폭 적응 실행으로 엣지에서 MoE 서빙하기 — 미스를 '옮길지, 그 자리에서 계산할지'를 기계가 정한다
"기존 시스템들은 미스를 얼마나 잘 예측하느냐에서 갈리지, 미스를 어떻게 서빙하느냐에서는 갈리지 않는다. 모든 미스는 결국 PCIe 전송이고, 그래서 예측이 아무리 정확해져도 디코드 지연은 링크에 묶인 채 호스트 연산은 놀고 있다." — 논문 6절(관련 연구)
2026년 8월 17일, UC Berkeley의 Shuo Yang과 Xiaoze Fan을 제1저자로 Kurt Keutzer, Song Han, Matei Zaharia, Ion Stoica가 이름을 올린 팀이 FreeToken: Efficient Edge-Native MoE Serving with Bandwidth-Adaptive Execution(arXiv 2608.16157)을 공개했다. 코드는 github.com/FlashML-org/FreeToken에 Apache-2.0으로 올라와 있고(2026-07-20 생성, 이 글을 쓰는 시점 스타 약 16,000), flashml.ai에서 Windows/Linux 데스크톱 앱도 배포한다.
이 시리즈의 7편 Edge0과 문제의식이 같다. 희소성은 연산을 줄이지, 바이트를 줄이지 않는다. 35B MoE는 토큰당 3B만 쓰지만 전문가 풀은 그대로 수십 GB이고, 개인 기계의 GPU 메모리에는 안 들어간다. Edge0는 전문가를 SSD에 두고 학습된 prerouter로 다음 레이어 라우팅을 한 토큰 먼저 맞혀 로드를 숨겼다. FreeToken은 다른 길을 간다. 예측 정확도를 올리는 대신, 피할 수 없는 미스를 PCIe로 옮길지 CPU에서 그 자리에서 계산할지를 기계마다 측정한 대역폭으로 결정한다. 두 글을 나란히 읽으면 "개인 하드웨어에서 큰 MoE 돌리기"라는 같은 문제에 완전히 다른 레버가 있다는 것이 보인다.
원문: https://arxiv.org/abs/2608.16157 · 코드: https://github.com/FlashML-org/FreeToken
🤔 배경: 엣지 MoE 서빙이 이론 한계에 못 미치는 세 가지 이유
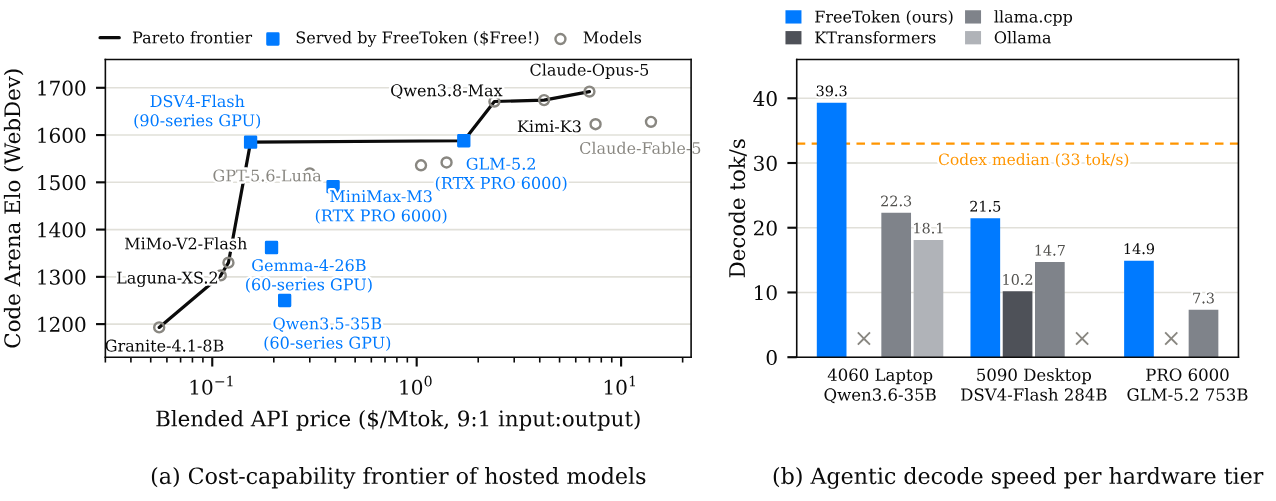
그림 1(a)는 논문의 동기다. 코딩 에이전트의 실제 토큰 비율(입력:출력 9:1)로 환산한 API 가격 대비 Code Arena Elo의 Pareto frontier에서, DeepSeek-V4-Flash부터 GLM-5.2까지의 구간이 정확히 FreeToken이 소비자 GPU로 서빙하는 모델 집합이다. 저자들은 "오픈 웨이트 공개는 누가 모델을 얻을 수 있는지를 정할 뿐, 누가 돌릴 수 있는지는 정하지 않는다"고 쓴다. 그런데 llama.cpp, KTransformers, Ollama는 왜 이 기계들의 이론 한계에 못 미치는가. 논문 2절은 세 가지로 쪼갠다.
프리필은 희소성을 파괴한다. 수천 토큰짜리 프롬프트의 라우팅 합집합은 레이어마다 거의 모든 전문가를 덮으므로, 프리필 한 번은 전문가 풀 전체를 CPU–GPU 링크로 흘려보낸다. FP4 DeepSeek-V4-Flash면 약 140GB로, PCIe 5.0 x16(약 60GB/s)에서 2초, PCIe 4.0 x16에서 5초, 랩톱의 x8에서는 10초 이상이고, 온디맨드 엔진은 이 시간을 통째로 GPU 유휴로 노출한다. 여기에 하네스가 툴 호출마다 컨텍스트를 편집(thinking 블록 제거, 오래된 툴 출력 치환)하는 문제가 겹친다. Qwen3.6의 gated DeltaNet 같은 순환 레이어는 과거를 하나의 상태로 압축하므로 편집 지점 뒤의 체크포인트는 전부 무효가 되고, RTX 5090의 dense BF16 처리량은 H100의 약 1/5이라 수천 토큰의 재프리필을 숨길 수 없다.
디코드는 미스를 어떻게 처리하느냐의 문제다. llama.cpp는 로드 시점에 MoE 텐서를 장치에 고정하고, KTransformers는 "핫" 전문가를 GPU에 핀하고 나머지를 CPU에서 돈다. 라우팅은 토큰마다 바뀌는데 배치는 고정이라 트래픽 대부분이 CPU로 떨어지고 GPU와 PCIe는 논다. 그런데 듀얼채널 DDR5는 80~90GB/s, RTX 5090의 VRAM은 1.8TB/s라 CPU만으로는 못 버틴다. 그리고 미스 하나를 어디서 처리할지는 하드웨어마다 답이 다르다. PCIe로 옮기면 호스트 대역폭과 CPU 코어가 놀고, CPU에서 계산하면 PCIe가 놀고 미래의 캐시 히트도 포기한다. LPDDR5에 PCIe x8인 4060 랩톱과 DDR5에 PCIe 5.0 x16인 5090 데스크톱은 이 균형의 양 극단이고, 스펙 시트로는 못 읽는다.
엣지에는 전용 자원이 없다. 브라우저와 게임이 VRAM을 GB 단위로 가져가고, 세션이 길어지면 KV 캐시 수요가 자라 첫 턴의 전문가/KV 분할은 몇 턴 뒤면 틀린다. 엔진 시작도 잦다. 140GB 풀을 7GB/s NVMe에서 읽는 것만 약 20초다.
🧠 핵심 아이디어: 대역폭을 병목이 아니라 스케줄링 신호로
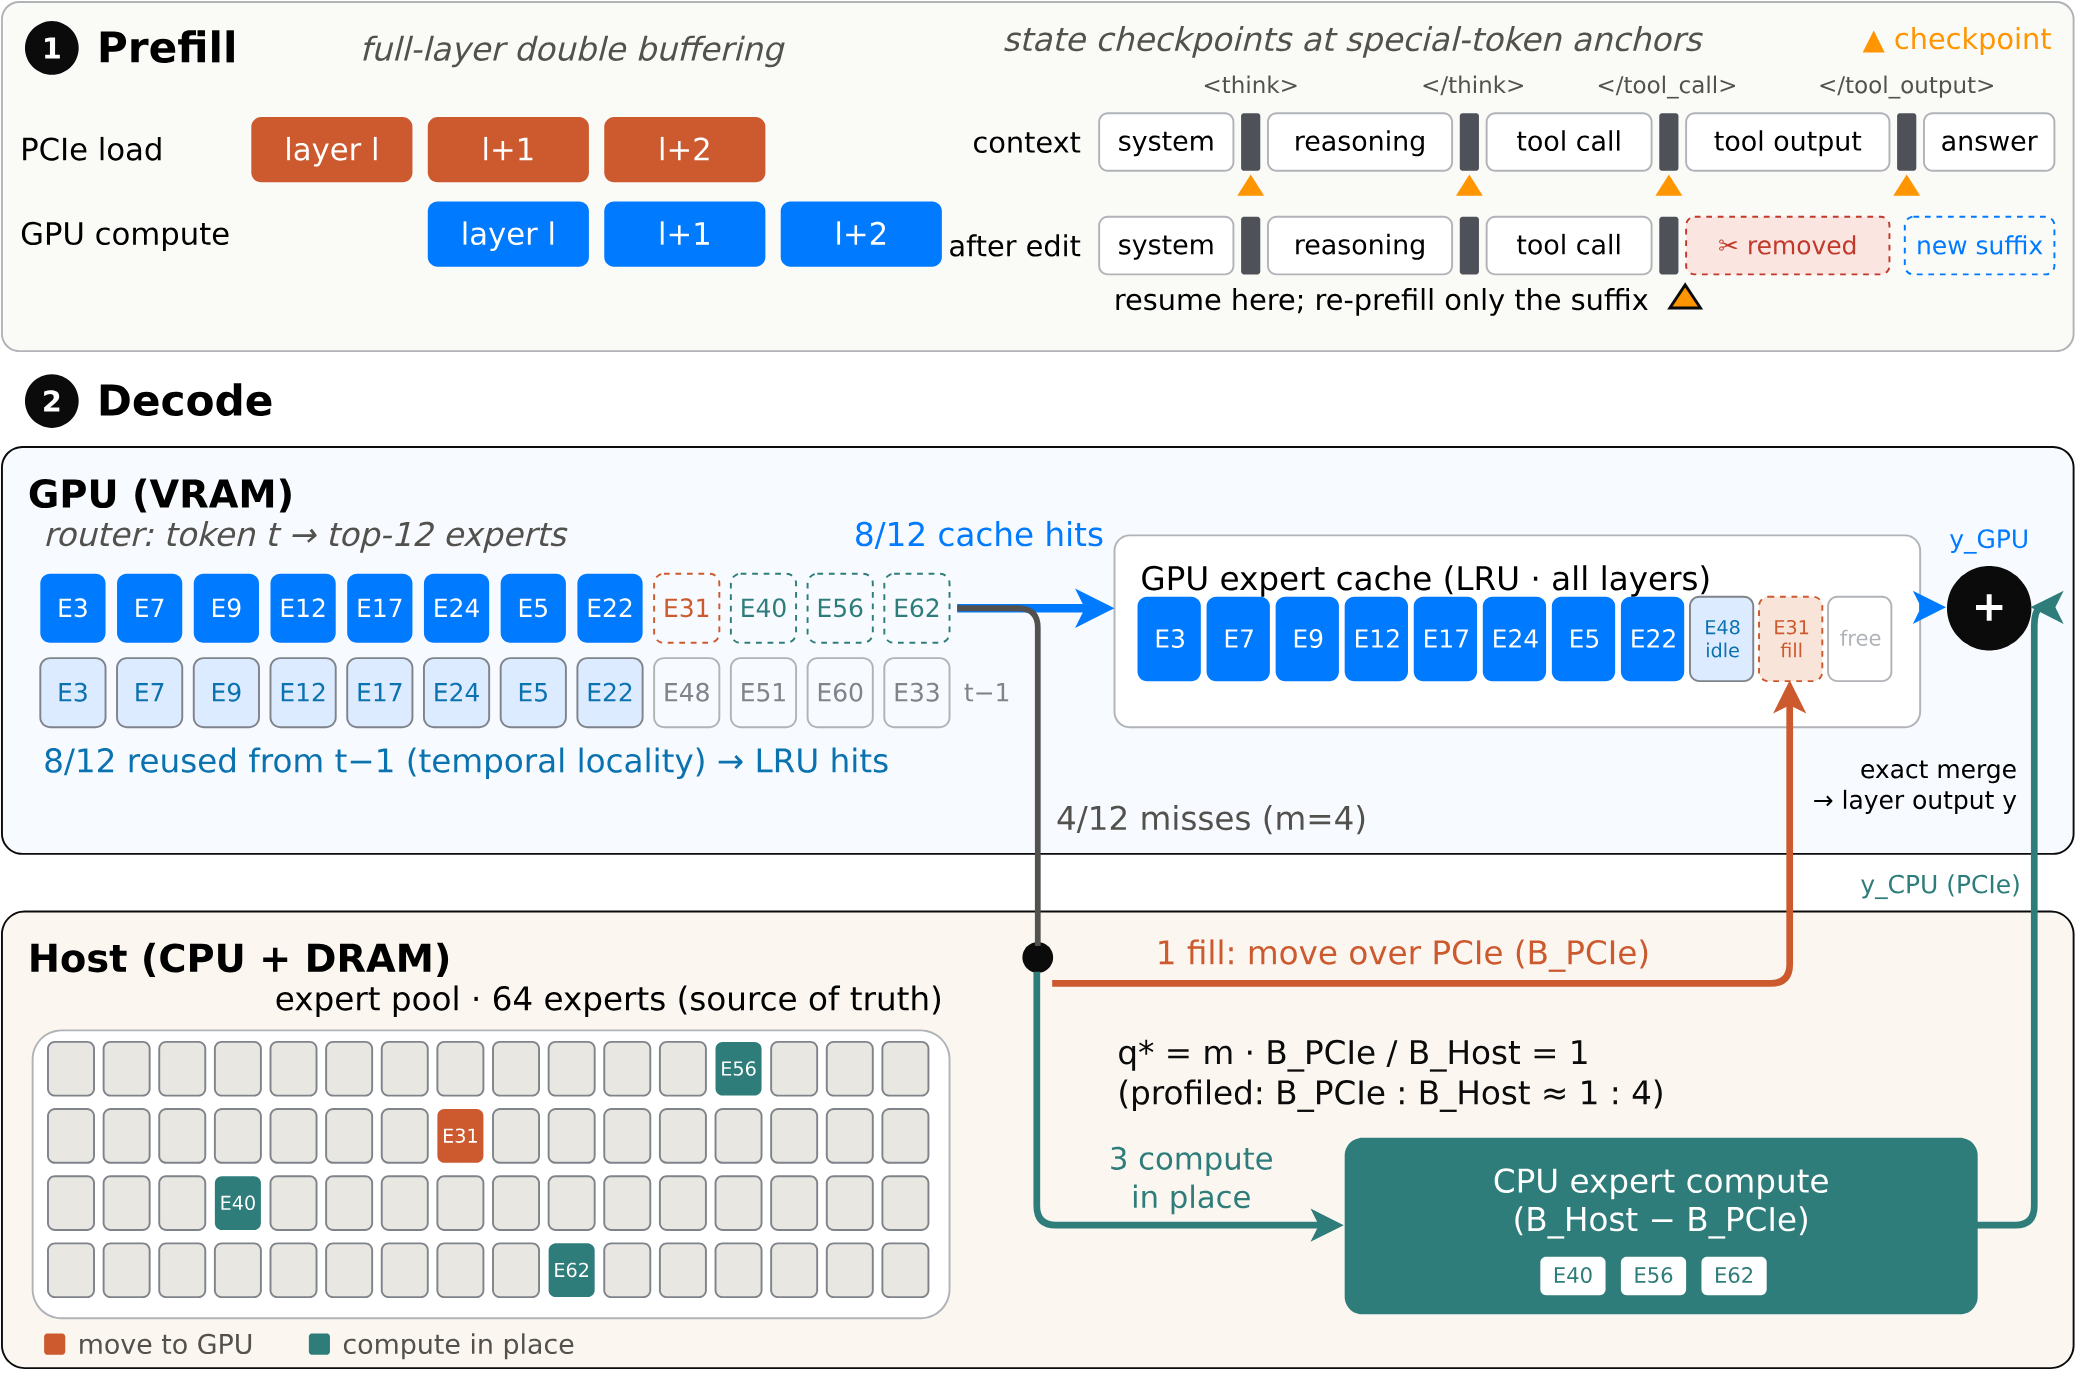
FreeToken의 구조는 두 단계 전문가 메모리 계층이다. CPU 상주 전문가 풀이 source of truth이고, 비전문가 가중치는 GPU에 상주하며, 남는 GPU 메모리는 모든 MoE 레이어가 공유하는 하나의 탄력적 전문가 캐시가 된다. 슬롯 하나가 (레이어, 전문가) 쌍 하나를 평가하는 데 필요한 텐서 전부를 담고, 상주·조회·실행이 텐서 샤드가 아니라 논리 식별자 위에서 돈다. 이 위에 세 가지 원칙이 올라간다.
(1) 대역폭 적응 실행. 프리필에서는 전문가 이동과 연산을 더블 버퍼링하고, 디코드에서는 PCIe 전송과 CPU 직접 실행이 같은 호스트 메모리 대역폭을 나눠 쓴다는 사실로부터 미스 분할 비율 를 닫힌 형태로 구한다.
(2) 의미 인지 캐싱. 프리필에서는 순환 상태 체크포인트를 하네스가 컨텍스트를 자르는 특수 토큰 경계에 앵커링하고, 디코드에서는 인접 토큰의 라우팅 겹침(temporal locality)을 전역 LRU 캐시로 흡수한다.
(3) 탄력적 자원 관리. 스케줄러 safe point에서 GPU 전문가 캐시를 새 메모리 예산으로 재구축하되, 엔진 재시작도 호스트 풀 재로드도 하지 않는다.
Edge0와 대비하면 선명하다. Edge0의 질문은 "다음 토큰이 어떤 전문가를 쓸지 미리 알 수 있는가"였고 답은 학습된 prerouter였다. FreeToken의 질문은 "모르는 채로 남은 미스를 어디서 처리하는가"이고 답은 측정된 대역폭이다. 저자들은 ProMoE, ExpertFlow, FineMoE 같은 예측기 계열을 "미스를 얼마나 잘 예측하느냐에서 갈리지, 어떻게 서빙하느냐에서는 갈리지 않는다"고 정리하는데, 인용되지는 않았지만 Edge0도 분류상 그쪽이다.
📐 방법: 프리필, 디코드, 메모리
프리필: 레이어 단위 더블 버퍼링과 의미 앵커
프리필은 어차피 거의 모든 전문가를 쓰므로 FreeToken은 온디맨드로 가져오지 않는다. 전역 슬롯 풀에서 레이어 전체 크기의 버퍼 두 개를 잡고, GPU가 한 버퍼의 레이어 전문가를 계산하는 동안 전용 전송 스트림이 레이어 의 전체 전문가 집합을 다른 버퍼로 올린다. 레이어 전체를 올리기 때문에 그 레이어의 라우팅이 결정되기 전에 전송을 시작할 수 있다. 버퍼는 디코드 캐시와 슬롯 풀을 공유하므로 별도의 프리필 캐시도, 단계 전환 핸드오프도 없고, 프리필에서 살아남은 엔트리가 디코드를 데운다. 두 레이어분을 못 잡으면 온디맨드로 폴백한다.
순환 상태 쪽은 의미 인지 상태 캐시다. full-attention KV는 SGLang식 radix prefix tree로 관리하고, 순환 레이어의 상태 체크포인트를 그 트리의 노드에 붙인다. 체크포인트 하나가 모든 순환 레이어의 상태를 담아 몇 개밖에 못 들기 때문에 어디에 찍느냐가 가치를 정하는데, FreeToken은 thinking 블록, 툴 호출/출력, 턴의 경계인 특수 토큰에 찍는다. OpenClaw는 마지막 턴 외의 thinking 블록을 제거하고, OpenCode는 오래된 툴 출력을 placeholder로 치환하며, SWE-agent는 마지막 개 외의 관찰을 생략하는데, 모두 특수 토큰으로 표시된 블록 통째로 지우고 그 앞 접두사는 보존한다. 그래서 경계의 체크포인트는 살아남고 새 suffix만 재프리필하면 된다.
디코드: 전역 LRU 캐시와 정책
디코드의 각 MoE 레이어에서 라우터와 캐시 조회가 GPU에서 돌아 이미 상주한 전문가 는 바로 GPU에서 계산하고, 남은 개의 유일 미스 을 처리해야 한다. 캐시는 로드 시점에 고정된 배치가 아니라 라우터가 고른 전문가를 계속 따라가는 공유 LRU다. 히트는 recency를 갱신하고, fill은 새 전문가를 들이고, eviction은 모델이 가장 오래 요구하지 않은 전문가를 내보낸다.
그래도 미스는 남는다(콜드 스타트, 워킹셋 급변, 용량 한계). 이것을 cache-fill 집합 와 CPU-execution 집합 로 나눈다.
는 PCIe로 슬롯에 전송되어 GPU에서 실행되고 이후 재사용을 위해 상주한다. 는 CPU 상주 풀에서 바로 실행되고 상주 상태를 바꾸지 않는다. 두 집합은 동시에 처리된다. 핵심 관찰은 전문가 DMA 전송과 CPU 실행이 같은 호스트 메모리 서브시스템을 읽는다는 것이다. 측정된 PCIe 전송 대역폭을 , 호스트 쪽 전문가 처리 대역폭을 라 하면 PCIe를 포화시킨 뒤 남는 대역폭은
이고, 전문가 하나의 크기를 라 할 때 두 가지의 소요 시간은
이다. 두 가지를 균형시키면
이 공식 하나가 모든 하드웨어 균형을 덮는다. 가 에 접근하면 이 되어 순수 온디맨드 fill로 퇴화한다. 그림 2의 예시는 , 라서 이다. 미스 하나는 PCIe로 옮기고 셋은 CPU가 그 자리에서 계산한다. 실제로는 를 정수로 반올림하고 어떤 전문가를 에 넣을지는 캐시 교체 정책에 맡기며, CPU가 미스 대부분을 처리할 때도 캐시가 데워지도록 최소 하나의 fill은 항상 남긴다. , 는 배포 시 대상 하드웨어에서 프로파일링한다. CPU와 GPU가 각자의 부분합을 합치므로 MoE 출력은 근사 없이 정확하고, CPU 분기를 먼저 띄운 뒤 GPU 미스 경로( 일괄 복사와 의 grouped 평가)를 돌리므로 노출되는 레이어 지연은 두 분기 중 느린 쪽이다. 식 (4)가 균형시키는 양이 바로 이것이다.
탄력적 메모리와 빠른 부팅
CPU 풀이 source of truth이므로 GPU 메모리는 성능에만 영향을 주고 정확성에는 영향을 주지 않는다. 이 성질 위에서 스케줄러 safe point마다 KV 페이지와 전문가 슬롯의 분할을 새 VRAM 예산으로 재구축한다. 부팅은 전문가 가중치를 디스크에서 최종 호스트 레이아웃으로 바로 읽은 뒤에 핀하고(빈 버퍼를 먼저 핀하면 덮어쓸 페이지를 0으로 채우는 낭비가 생긴다), GPU 워밍업은 없다. 첫 요청은 콜드 캐시로 서빙되고 미스가 평범한 디코드 경로로 처리되면서 캐시가 데워진다.
구현: CUDA Graph 안에 들어간 LRU와 CPU 분기
호스트가 캐시를 제어하면 MoE 레이어마다 장치 동기화가 생긴다. FreeToken은 라우팅 의존 제어를 전부 GPU에 두고, 고정 크기 작업 버퍼와 장치 상주 valid count라는 데이터로 표현해 정적으로 캡처한 CUDA Graph 안에서 돌린다. 레이어당 커널 하나가 라우팅된 전문가를 중복 제거하고, 상주 테이블과 대조하고, 를 유도하고, 단일 패스로 가장 오래된 후보 개를 찾아 앞 개를 희생자로 쓰고, 논리 ID를 물리 슬롯 ID나 CPU 할당 플래그로 바꿔 쓴다. CPU 분기도 같은 그래프에 캡처된다. D2H 복사, 호스트 함수 제출 노드, 동시 GPU 경로, 동기화 노드, H2D 결과 복사를 한꺼번에 캡처하므로 토큰마다 Python 스케줄링이 없고, 물리 코어에 핀된 영속 C++ 워커 풀이 아키텍처별 SIMD와 커널 내 역양자화로 대역폭 바운드를 유지한다. 체크포인트는 FTW 포맷으로 (레이어, 전문가) 식별자를 선행 차원으로 하는 뱅크 레이아웃에 미리 합쳐 두어 로드 시 재패킹 없이 병렬 direct I/O로 읽고, 풀을 핀/DMA 등록할 수 없는 환경에서는 순수 CPU MoE 백엔드로 폴백한다.
📊 실험: RTX 5090에서 1.5~2.3배, 8GB 랩톱에서 39.3 tok/s
하드웨어. 여섯 대다. 3090·4090·5090은 임대 듀얼소켓 서버라 CPU 6스레드로 제한하고 GPU의 NUMA 노드에 핀해서 호스트 대역폭을 56.7~77.3GB/s로 맞췄고, 실제 엣지 기계인 5090 데스크톱(Ryzen 9 9950X3D, 53.8GB/s)과 4060 랩톱(i9-13900H, 47.5GB/s)은 제한 없이 돌려 에뮬레이션을 검증했다. 표의 대역폭은 스펙이 아니라 배포 텐서 형상에서 측정한 값이다.
| 시스템 | GPU (VRAM) | PCIe | (GB/s) | CPU | DRAM | (GB/s) |
|---|---|---|---|---|---|---|
| 5090 | RTX 5090 (32GB) | 5.0 x16 | 52.7 | 2× Xeon Gold 6459C (32) | DDR5 180GiB | 77.3 |
| 4090 | RTX 4090 (24GB) | 4.0 x16 | 25.1 | 2× Xeon Platinum 8358P (32) | DDR4 240GiB | 63.2 |
| 3090 | RTX 3090 (24GB) | 4.0 x16 | 25.3 | 2× Xeon Gold 6330 (28) | DDR4 180GiB | 56.7 |
| 5090 desktop | RTX 5090 (32GB) | 5.0 x16 | 49.0 | Ryzen 9 9950X3D (32) | DDR5 192GiB | 53.8 |
| 4060 laptop | RTX 4060 Laptop (8GB) | 4.0 x8 | 11.8 | Core i9-13900H (20) | LPDDR5 32GiB | 47.5 |
| PRO 6000 | RTX PRO 6000 (96GB) | 5.0 x16 | 51.5 | Xeon Platinum 8559C (48) | DDR5 512GiB | 178 |
모델과 워크로드. DeepSeek-V4-Flash(284B, 활성 13B, 공식 MXFP4 전문가)와 Qwen3.6-35B-A3B(BF16; 8GB 랩톱만 공식 NVFP4), 프론티어 티어로 GLM-5.2(753B, 활성 40B, NVFP4, 433GB). 워크로드는 W1 AIME 수학(단일 턴), W2 OpenCode로 SWE-bench 이슈 해결(3턴, 실제 툴 실행), W3 Claude Code로 같은 이슈(동시 서브에이전트, 56~65k 토큰), W4 OpenClaw 이메일/캘린더 에이전트(13턴, 약 24.5k 토큰 시스템 컨텍스트). 베이스라인은 llama.cpp, Ollama, KTransformers, MoE-Infinity이고 가중치 포맷은 비트 단위로 맞췄다. 궤적이 엔진마다 갈리므로 wall-clock 총합은 비교하지 않는다.
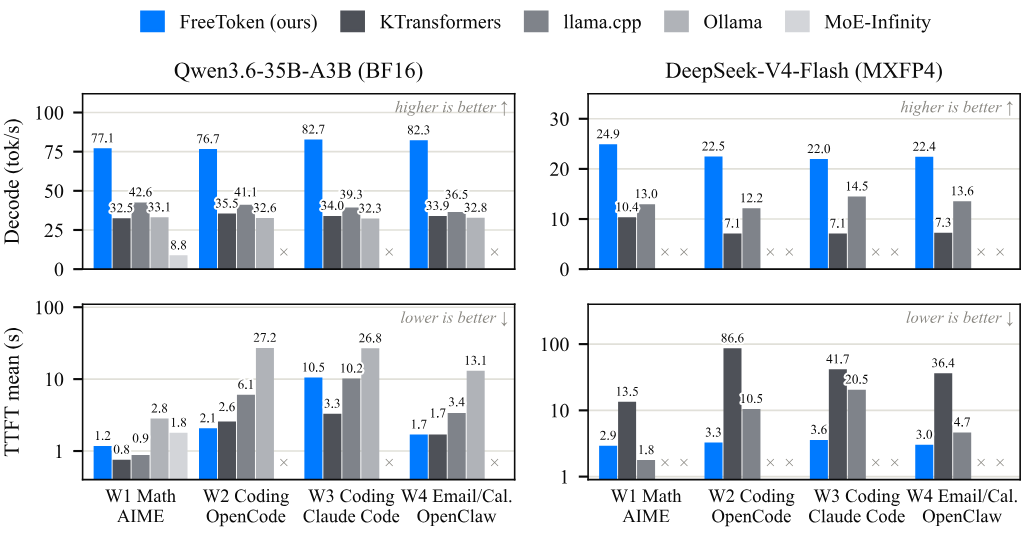
디코드 처리량. RTX 5090(Qwen3.6은 CPU 6스레드, DSV4-Flash는 8스레드)에서 FreeToken은 Qwen3.6 77~83 tok/s, DSV4-Flash 22~25 tok/s로, 워크로드별 최강 베이스라인 대비 각각 1.82.3배, 1.51.9배다. 그림에서 숫자를 옮기면 Qwen3.6 W1은 77.1 vs llama.cpp 42.6, W3는 82.7 vs 39.3이고, DSV4 W2는 22.5 vs llama.cpp 12.2, KTransformers 7.1이다. 눈여겨볼 것은 안정성이다. FreeToken은 세 에이전트 워크로드에서 단일 턴 W1 대비 12% 안에 머무는데, 컨텍스트에 가장 민감한 KTransformers(DSV4)는 W2에서 이미 W1의 31%를 잃는다. 저자들은 "단일 스트림 벤치마크는 베이스라인의 에이전트 성능을 과대평가한다"고 쓴다. MoE-Infinity는 W1만 서빙(8.8 tok/s)했다. 전문가별 프리필 스테이징 상한이 긴 프롬프트에서 중단되고, 번들 서버가 요청 간 KV를 유지하지 않기 때문이다.
TTFT. 평균값으로는 6개 멀티턴 셀 중 5개에서 FreeToken이 최저다(Qwen3.6 W3는 KTransformers의 GPU 프리필 팔이 3.3초로 FreeToken 10.5초보다 빠르고, W1의 짧은 고립 프롬프트는 llama.cpp가 유리). 하지만 꼬리가 엔진을 더 날카롭게 가른다. FreeToken의 최악 턴은 모든 셀에서 44초 미만인데, llama.cpp는 232초, Ollama는 179초, KTransformers는 946초까지 간다. OpenClaw의 idle watchdog는 120초, Claude Code의 기본 요청 타임아웃은 약 10분이므로 저자들은 "꼬리 TTFT는 지연 통계가 아니라 가용성 경계"라고 표현한다.
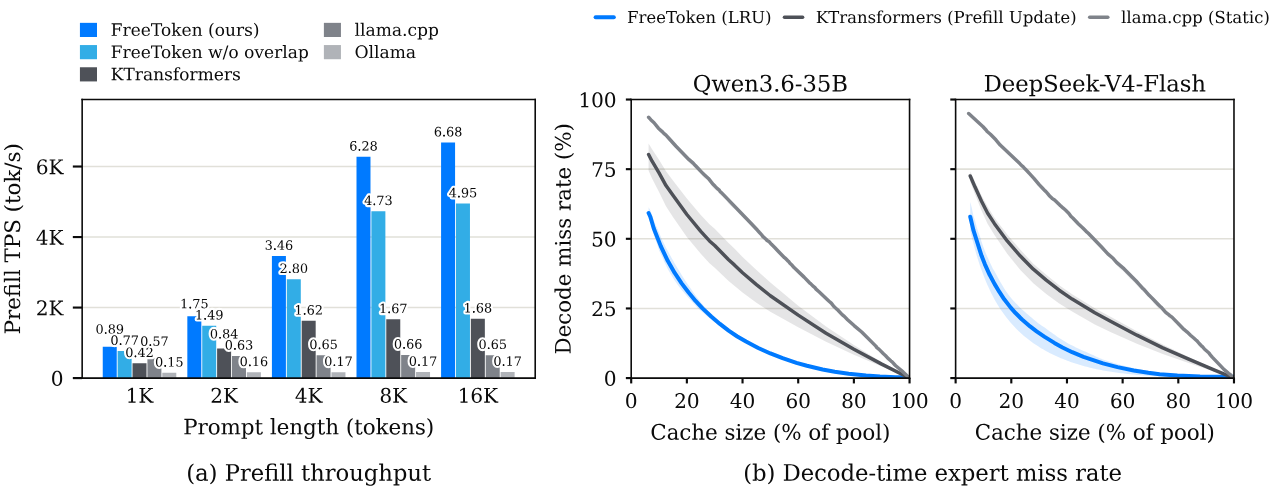
프리필 파이프라이닝. 더블 버퍼링을 켜면 프리필은 전송 바운드가 된다. 8,192토큰 청크 하나가 1.19~1.22초에 끝나는데, 이는 64.4GB 전문가 풀을 52.7GB/s(PCIe 5.0 x16의 실측 상한)로 한 번 흘리는 시간이다. 즉 전문가 연산이 전송 뒤에 완전히 숨었고 16k 토큰에서 6.7k tok/s까지 오른다. 두 번째 버퍼를 끄면 4k에서 19%, 8k에서 25%, 16k에서 26%를 잃고, 숨길 연산의 비중이 커질수록 손실이 커진다.
전문가 지역성. 그림 4(b)는 네 워크로드의 동일한 라우팅 트레이스를 세 엔진의 배치 정책에 같은 캐시 용량으로 재생한 것이다. RTX 5090의 서빙 용량(Qwen3.6 풀의 37%, DSV4-Flash 풀의 11%)에서 FreeToken의 전역 LRU는 디코드 전문가 읽기의 16%와 39% 를 미스하는데, KTransformers의 프리필 갱신 배치는 41%와 59%, llama.cpp의 라우팅 무관 정적 분할은 62%와 89%다. 풀 전체보다 작은 모든 용량에서 순서가 유지된다.
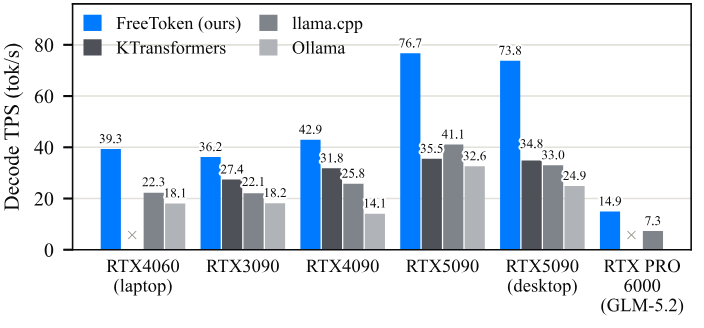
하드웨어 횡단. W2를 다섯 소비자 기계에서 반복하면 최강 베이스라인 대비 3090·4090에서 1.3배, 5090 서버 1.9배, 5090 데스크톱 2.1배, 4060 랩톱 1.8배다. 랩톱의 NVFP4 빌드는 8GB VRAM, PCIe x8 기계에서 39.3 tok/s로 RTX 4090 속도의 92%이자 Codex 프로덕션 트레이스의 중앙값 33 tok/s를 넘는다. 두 5090 열은 GPU가 같고 호스트만 다른데, 다채널 서버에서 듀얼채널 데스크톱으로 옮기면 FreeToken은 디코드의 4%만 잃는 반면 llama.cpp는 CPU 상주 전문가가 DDR5 두 채널에서 굶어 80%만 유지한다. 프론티어 티어에서는 RTX PRO 6000 한 장으로 GLM-5.2를 14.9 tok/s(llama.cpp 7.3, 2.0배) 서빙했고 평균 TTFT는 7.5초 대 7.8초로 비슷하다. KTransformers는 이 모델에 서빙 경로가 없다. GLM-5.2 방식이 753GB~1.5TB의 호스트 상주 전문가를 요구해 512GiB를 넘고, CPU 커널이 NVFP4 레이아웃을 못 읽기 때문이다.
🔍 비판적으로 읽기: Edge0와 나란히
두 논문은 "개인 하드웨어에서 큰 MoE"라는 같은 간판을 달고 있지만, 기계도 전문가의 집도 레버도 다르다.
| 항목 | Edge0 (arXiv 2609.18063) | FreeToken (arXiv 2608.16157) |
|---|---|---|
| 대상 기계 | Apple Silicon 통합 메모리 (Mac mini M4 Pro 24GB, MacBook M2 16GB) | NVIDIA 외장 GPU + 호스트 DRAM (8GB 4060 랩톱 ~ 96GB RTX PRO 6000) |
| 전문가의 집 | SSD (mmap 스트리밍, 페이지 캐시) | 호스트 DRAM (핀 메모리, source of truth) |
| 병목으로 보는 대역폭 | SSD 읽기 지연 (cold page fault) | PCIe 전송 vs 호스트 메모리 |
| 미스 대응 | 학습된 prerouter가 다음 레이어 라우팅을 한 토큰 먼저 예측해 로드를 숨김; 예측 = 라우팅 | 예측 없음. 전역 LRU로 히트를 늘리고, 남은 미스를 로 PCIe fill과 CPU 직접 실행에 분할 |
| 모델 수정 | 있음 (int4 + prerouter + 병합하지 않는 recovery LoRA, 3단계 학습) | 없음 (라우팅과 출력이 원본과 정확히 동일) |
| CPU의 역할 | 별도 분할 없음 (MLX, 통합 메모리) | 전문가 연산 주체로 참여 (SIMD 커널, CUDA Graph에 캡처) |
| 프리필 | whole-layer 로딩 + 페이지 캐시 (35B: 113/140 tok/s cold/warm) | full-layer 더블 버퍼링 (5090: 16k에서 6.7k tok/s) + 의미 앵커 체크포인트 |
| 메모리 탄력성 | 피크 활성 메모리 최소화 (35B: 2.9GiB) | 런타임에 KV/전문가 분할 재구축, 재시작 없음 |
| 보고 성능 | Qwen3.6-35B int4: 20.4 tok/s (Mac mini M4 Pro) | Qwen3.6-35B BF16: 77~83 tok/s (RTX 5090), NVFP4 39.3 tok/s (4060 랩톱 8GB) |
| 품질 비용 | fp16 교사 대비 5개 벤치 평균 −3.9점 | 없음 (bit-exact) |
| 비교 대상 | mlx-lm (상주 서버) | llama.cpp, Ollama, KTransformers, MoE-Infinity |
| 공개 | Apache-2.0, 프레임워크+체크포인트+어댑터 | Apache-2.0, 엔진 + 데스크톱 앱 (FTW 포맷) |
표의 숫자를 직접 비교하는 것은 무의미하다. Edge0의 20.4 tok/s는 체크포인트가 메모리에 안 들어가는 상황에서 SSD를 읽으며 낸 숫자이고, FreeToken의 77 tok/s는 180GiB DDR5 호스트에 전문가 풀 전체가 핀된 숫자다. 전문가가 DRAM에 있다는 전제 자체가 Edge0가 풀려던 문제를 하드웨어로 우회한 것이고, 반대로 Edge0의 접근은 PCIe/DRAM 대역폭 균형이 아예 없는 통합 메모리 기계용이다. 두 논문은 서로를 인용하지 않고(FreeToken이 한 달 먼저 나왔다) 교차 비교된 적도 없다.
그래도 읽으면서 든 생각 몇 가지를 적는다.
모델은 깔끔하지만 가정이 많다. 식 (2)~(4)는 PCIe DMA와 CPU 전문가 읽기가 호스트 대역폭을 선형으로 나눠 쓰고, CPU 커널이 순수 대역폭 바운드이며, 전문가 크기 가 균일하다고 가정한다. 4.1절에서 CPU 커널을 "대역폭 바운드로 유지한다"고 쓴 것은 이 가정을 구현으로 지탱하려는 것인데, 6스레드로 제한한 Xeon과 14코어 랩톱 i9에서 똑같이 성립하는지에 대한 ablation은 없다. 를 고정값으로 두고 흔들어 본 민감도 실험도 보이지 않는다. 논문이 보여주는 것은 "측정 기반 분할이 정적 배치보다 낫다"이지 "이 분할이 최적"이 아니다.
의 기여분이 분리되지 않았다. 두 5090 열에서 FreeToken이 4%, llama.cpp가 20%를 잃었다는 결과는 호스트 메모리 채널 수가 FreeToken에는 덜 중요하다는 뜻이고, 이는 미스 대부분이 LRU 히트로 흡수되어 CPU 분기가 작다는 것이기도 하다. 그림 4(b)는 미스율만 보여줄 뿐 "LRU + 온디맨드 fill"과 "LRU + "의 처리량 차이는 보고되지 않았다.
TTFT의 셀 하나는 졌다. Qwen3.6 W3(Claude Code, 56~65k 토큰)에서 FreeToken의 평균 TTFT 10.5초는 KTransformers 3.3초의 3배다. 저자들은 KTransformers의 "GPU 프리필 팔"을 이유로 들지만, 가장 에이전트다운 셀에서 프리필이 밀린 셈이라 설명이 더 필요하다. 꼬리 지연(44초 vs 946초)이 실사용에선 더 중요하다는 주장에는 동의한다.
품질을 건드리지 않는 것이 가장 큰 장점이자 한계다. Edge0는 양자화와 라우팅 근사로 평균 3.9점을 잃는 대신 2.9GiB로 내려갔다. FreeToken은 bit-exact를 지키는 대신 전문가 풀 전체가 DRAM에 들어가야 한다. 4060 랩톱의 32GiB에 Qwen3.6 NVFP4는 들어갔지만, 같은 랩톱에서 DSV4-Flash 140GB를 돌릴 방법은 이 논문에 없다. DRAM 아래 SSD 계층(Edge0가 산 자리)을 붙이는 것이 자연스러운 다음 단계로 보이는데, 논문은 이를 다루지 않는다.
측정 조건의 비대칭. DSV4-Flash에서 Ollama와 MoE-Infinity, GLM-5.2에서 KTransformers가 빠졌다. "경쟁자가 못 돈다"는 것 자체가 결과이긴 하지만 그림 3의 DSV4 열은 사실상 두 엔진과의 비교이고, 모든 숫자는 저자 측정이다.
🔧 직접 돌려보기
README 기준 설치와 실행은 다음과 같다. uv pip install "freetoken[accel]"로 설치하거나 소스에서 uv pip install -e ".[accel]"로 빌드한다.
ft serve --model ~/models/Qwen3.6-35B-A3B
# 로그에 "API server is ready to serve on 127.0.0.1:1919"가 뜨면 준비 완료
curl http://127.0.0.1:1919/v1/models
ft launch claude   # claude / codex / dsh / hermes / openclaw / opencode
--model은 Hugging Face 리포 ID도 받고, dtype·백엔드·캐시 크기·툴 호출 파서는 체크포인트와 GPU에서 자동으로 정해진다고 적혀 있다. 서버는 OpenAI API(/v1/chat/completions)와 Anthropic API(/v1/messages)를 둘 다 제공하므로 ft launch claude로 코딩 에이전트를 바로 붙일 수 있다. README는 RTX 30/40/50 시리즈 네이티브 지원을 명시하고, Apple Silicon이나 AMD는 공식 README에 없다(RDNA3·Windows 네이티브·Rust 포트 같은 비공식 포크가 여럿 보이지만 검증하지 않았다).
💡 정리
FreeToken의 기여를 한 문장으로 줄이면, "미스를 예측하는 문제"에서 "미스를 서빙하는 문제"로 질문을 옮겼다는 것이다. 전문가 풀은 호스트 DRAM에 두고, GPU 메모리는 모든 레이어가 공유하는 LRU 캐시로 쓰며, 남는 미스는 기계에서 측정한 비율로 PCIe 전송과 CPU 직접 실행에 나눠 두 분기를 동시에 돌린다. 이 제어를 전부 CUDA Graph 안에 넣어 토큰당 호스트 스케줄링을 없앴고, 하네스가 컨텍스트를 자르는 특수 토큰 경계에 순환 상태 체크포인트를 찍어 재프리필을 줄였다. 결과는 RTX 5090에서 llama.cpp·KTransformers 대비 1.5~2.3배, 8GB 랩톱에서 35B 모델 39.3 tok/s, 96GB 워크스테이션 GPU 한 장에서 753B GLM-5.2 14.9 tok/s다.
이 시리즈에서 Edge0가 "통합 메모리 + SSD + 학습된 예측"의 축이었다면 FreeToken은 "외장 GPU + DRAM + 측정된 분할"의 축이다. 둘 다 전문가 풀의 바이트 문제를 피하지 않고 정면으로 다루지만, 하나는 모델을 고쳐 메모리를 줄였고 하나는 런타임을 고쳐 대역폭을 다 썼다. 개인 기계의 다음 세대 엣지 엔진이 두 레버를 같이 당기게 될지가 궁금하다.
📚 참고
- 원문: FreeToken: Efficient Edge-Native MoE Serving with Bandwidth-Adaptive Execution (arXiv 2608.16157) · HTML
- 코드: github.com/FlashML-org/FreeToken (Apache-2.0) · 데스크톱 앱: flashml.ai
- 이 블로그: Edge0: 35B MoE를 SSD에서 3GiB 메모리로 서빙하기 (시리즈 7편), KV Cache 최적화 가이드
- 비교 대상 엔진: llama.cpp, KTransformers, Ollama
본 글의 그림은 원문에서 가져왔습니다.