VLA 배포와 응용, 그리고 전망 — 실시간 추론부터 2026년의 한계까지
"벤치마크 성공률 90%와 하루 18시간 무중단 운영 사이에는 전혀 다른 공학이 있다."
이 글은 VLA 시리즈 6편이자 마지막 편이다. 5편에서 SmolVLA를 LeRobot으로 파인튜닝해 봤다면, 이제 남은 질문은 "이걸 실제 로봇에 올려서 하루 종일 돌리려면 무엇이 더 필요한가"다. 이 글은 네 가지를 다룬다. (1) 실시간 추론 — 지연과 주파수 문제를 액션 청킹, 비동기 추론, 압축, 그리고 2026년의 실시간 flow VLA(FASTER, TIDAL)가 어떻게 푸는지, (2) 사후학습 — 모방학습을 넘어 로봇 자신의 경험으로 학습하는 π*0.6의 Recap, (3) 메모리와 안전 — Physical Intelligence의 MEM, Gemini Robotics의 ASIMOV, (4) 2026년 응용 현황과 남은 한계. 마지막에 시리즈 전체를 묶는다.
🤔 왜 "배포"가 별도의 문제인가
2편에서 봤듯 VLA는 수십억 파라미터의 VLM 백본 위에 액션 헤드를 얹은 구조다. 문제는 로봇 제어 루프가 보통 수십 Hz로 돈다는 것이다. Efficient VLA 서베이(Yu et al., 2510.24795)는 파운데이션 VLA의 병목을 세 가지로 정리한다. 실시간 비호환성, 과도한 연산 비용, 비효율적 데이터 수집이다.
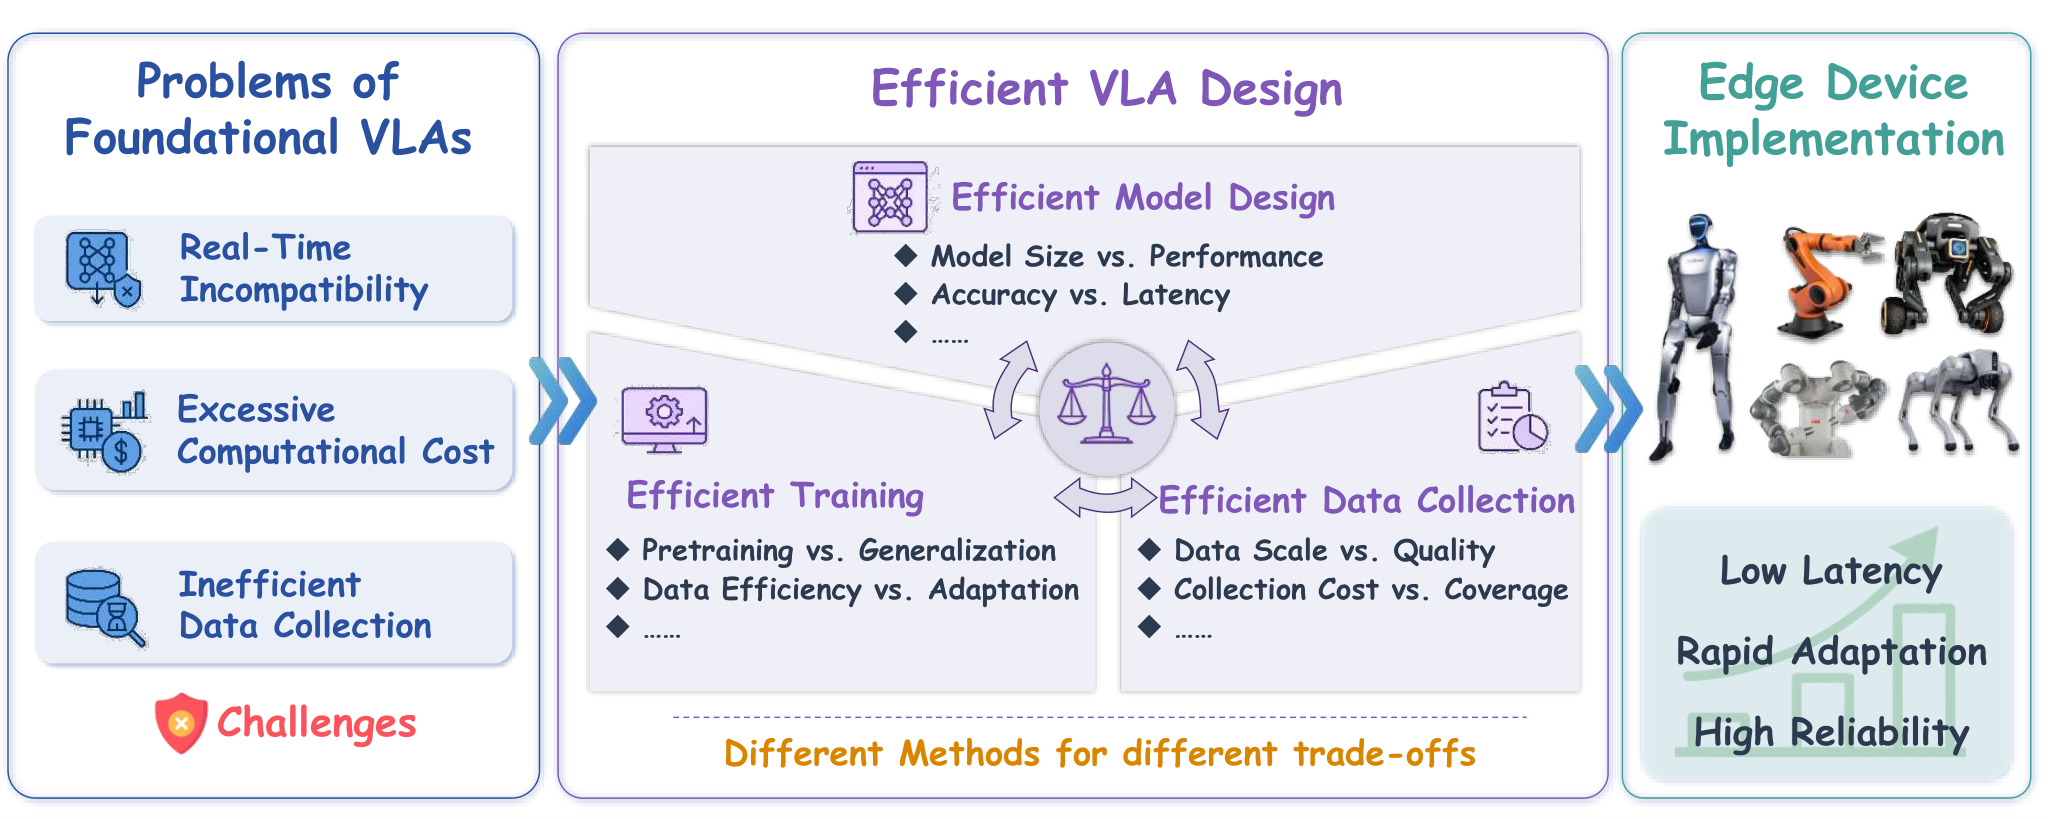
서베이의 Table I이 상황을 숫자로 보여준다.
| 모델 | 파라미터 | 추론 지연 | 주파수 | 하드웨어 |
|---|---|---|---|---|
| RT-2 (PaLI-X) | 55B | 330–1000 ms | 1–3 Hz | 멀티 TPU 클라우드 |
| RT-2 (PaLI-X) | 5B | 200 ms | 5 Hz | 멀티 TPU 클라우드 |
| OpenVLA | 7B | 166 ms | 6 Hz | RTX 4090 |
| π0 | 3.3B | 73 ms | 20/50 Hz | RTX 4090 |
| GR00T N1 | 2.2B | 63.9 ms | – | L40 |
(출처: 2510.24795 Table I. "20/50"은 추론 주파수/제어 주파수가 다른 경우다.)
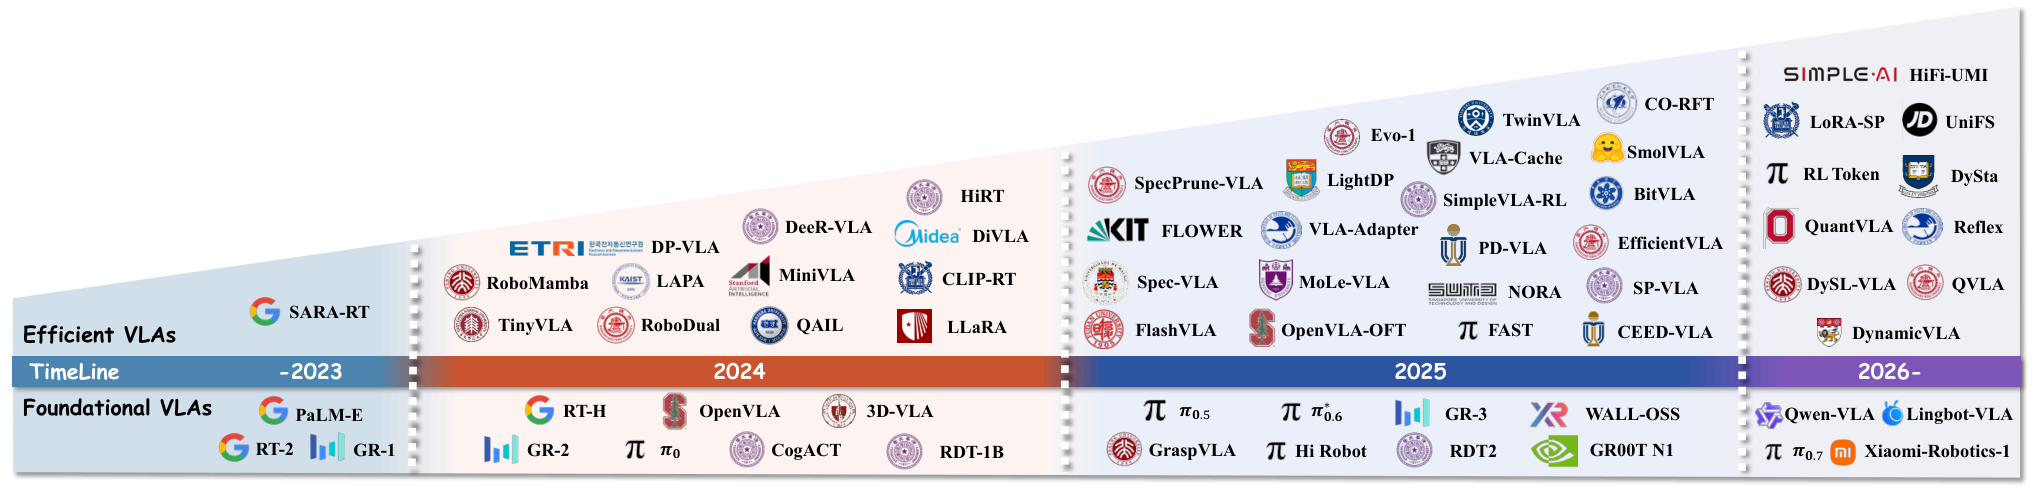
서베이의 타임라인을 보면 2024년 말부터 효율화 연구가 폭발적으로 늘었다. 파운데이션 모델이 "되는가"를 증명하자마자 "엣지에서 돌아가는가"가 다음 질문이 된 것이다.
RT-2가 1–3 Hz였던 것에서 π0가 수십 Hz까지 온 것은 두 가지 변화 덕분이다. 첫째는 모델을 키우지 않고 백본을 3B 안팎으로 맞춘 것, 둘째는 한 번의 추론으로 여러 스텝의 액션을 내는 액션 청킹이다. 하지만 청킹은 공짜가 아니다. 청크를 실행하는 동안 로봇은 눈을 감고 있는 셈이라, 환경이 바뀌면 낡은 계획을 그대로 밀고 나간다. 배포 공학의 핵심은 이 "청크 길이 vs 반응성" 트레이드오프를 다루는 데 있다.
🧠 실시간 추론의 네 가지 레버
1) 비동기 추론
가장 단순한 처방은 추론과 실행을 분리하는 것이다. SmolVLA(2506.01844)는 논문 초록에서 "지각·액션 예측을 액션 실행에서 분리하는 비동기 추론 스택"을 제안하며, 이것이 청크 단위 액션 생성으로 더 높은 제어 주파수를 가능하게 한다고 설명한다. 아이디어는 FASTER 논문의 그림이 가장 명확하게 보여준다.
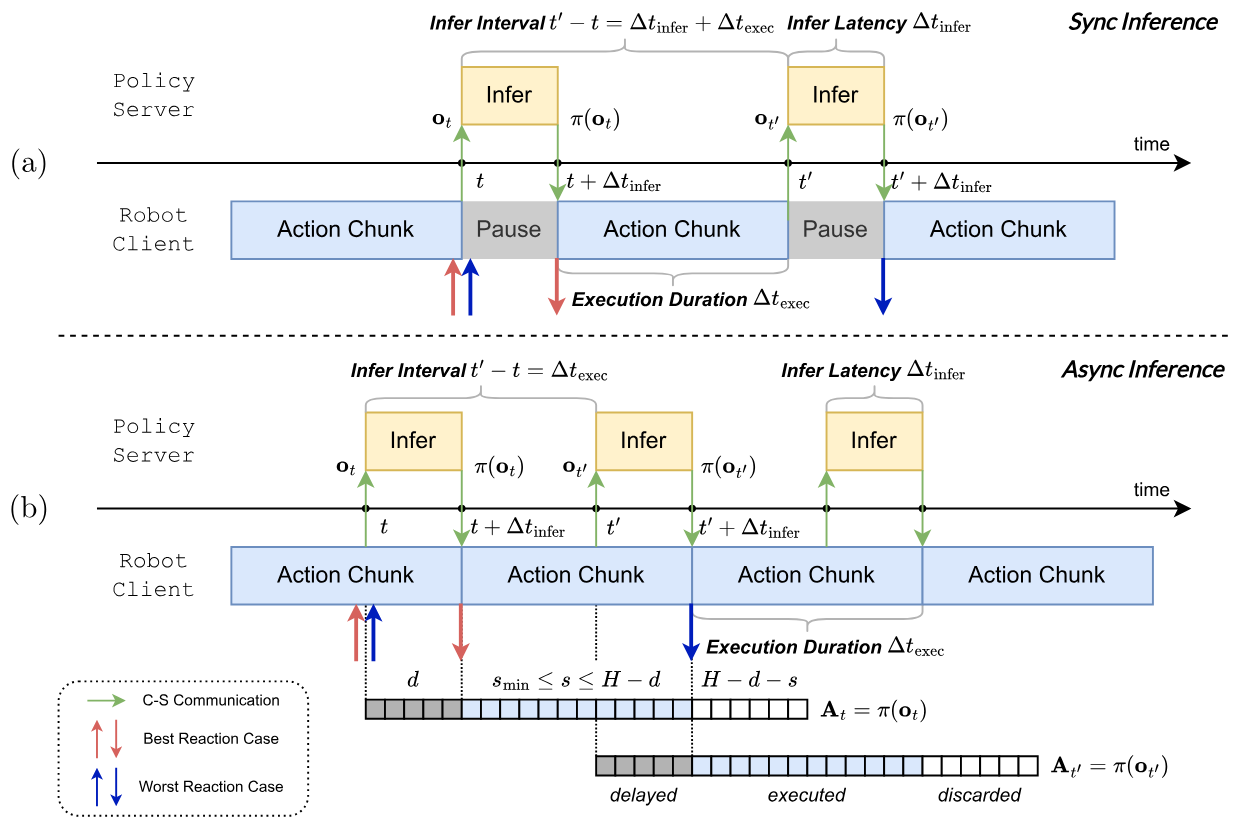
동기 방식(a)에서는 추론 중 로봇이 멈춘다. 비동기 방식(b)에서는 청크를 실행하는 동안 다음 추론을 돌리고, 새 청크가 도착하면 이미 지나간 앞부분 스텝을 버리고 이어 붙인다. 멈춤은 없어지지만, FASTER 저자들은 여기서 중요한 지적을 한다. 비동기 추론은 궤적을 매끄럽게 만드는 데 집중했지, 환경 변화에 얼마나 빨리 반응하는가는 해결하지 않았다는 것이다. 반응 시간은 "첫 액션까지의 시간(Time to First Action, TTFA)"과 실행 구간 길이에 좌우되는데, flow matching 기반 VLA는 디노이징 스텝을 전부 끝내야 첫 액션이 나온다.
2) 압축: 양자화·프루닝·캐싱
LLM 서빙에서 쓰던 도구들이 거의 그대로 들어온다. 서베이는 모델 압축을 레이어 프루닝, 양자화, 토큰 최적화(압축·프루닝·캐싱)로 분류한다.
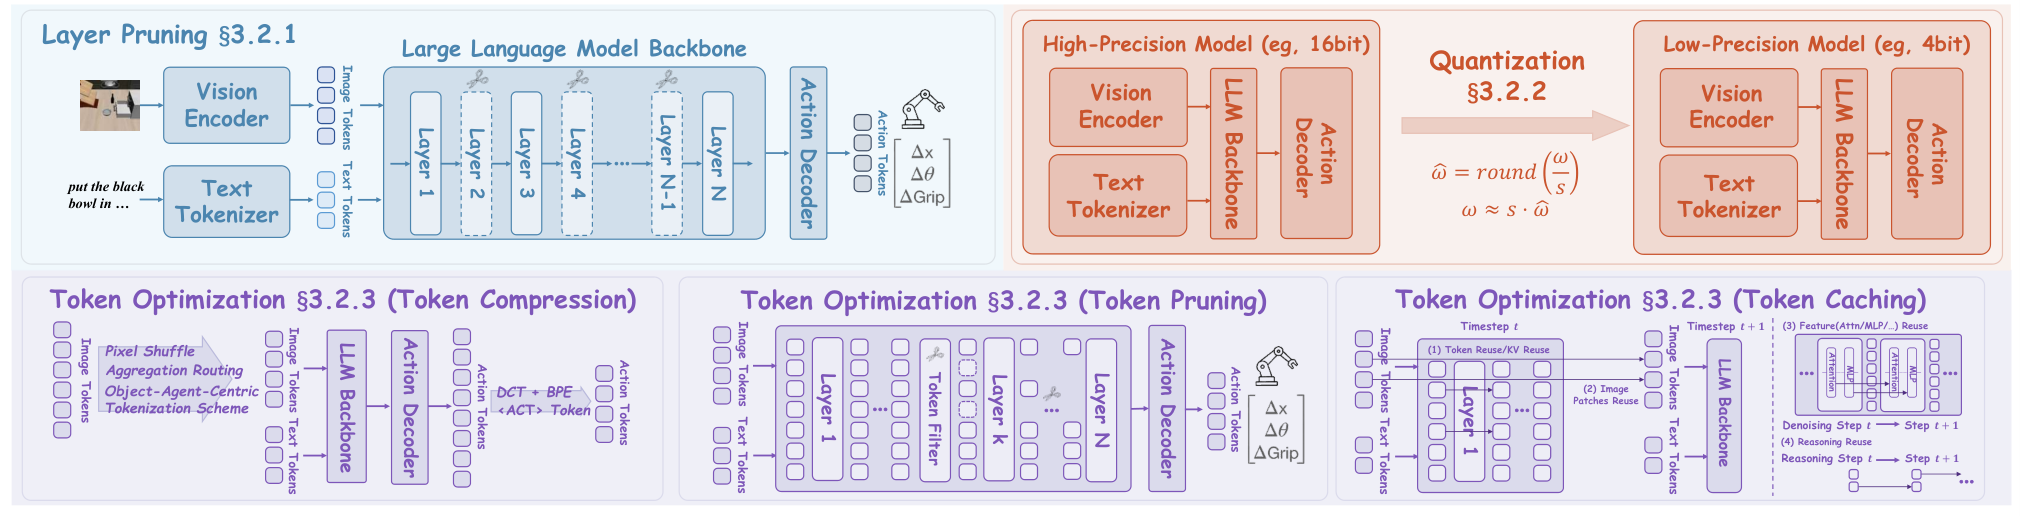
- 양자화: OpenVLA는 4비트 사후 양자화로 GPU 메모리를 절반으로 줄이면서 성능 손실은 미미했다고 서베이가 정리한다. BitVLA처럼 1비트(삼진) 가중치까지 간 시도도 있다.
- 토큰 프루닝: 로봇 카메라 프레임은 연속된 두 장이 거의 같다. FlashVLA, EfficientVLA, SP-VLA, LightVLA 등이 중복 이미지 토큰을 잘라낸다.
- 캐싱: VLA-Cache는 이전 프레임과 같은 패치의 KV를 재사용하고, HybridVLA는 diffusion 스텝 간 KV를 캐시한다. KV Cache 글에서 다룬 원리가 시간축으로 확장된 셈이다.
- 병렬·투기적 디코딩: OpenVLA-OFT는 자기회귀 대신 청크를 병렬로 디코딩하고, PD-VLA·CEED-VLA는 Jacobi 반복으로, Spec-VLA는 투기적 디코딩으로 토큰 생성을 가속한다.
- 레이어 스킵: SmolVLA는 VLM의 절반 깊이만 쓰고, DeeR-VLA는 입력 난이도에 따라 동적으로 조기 종료한다.
서베이 자체가 지적하듯 방법마다 측정 기준이 달라 "몇 배 빨라졌다"를 가로로 비교하긴 어렵다. 실무에서는 양자화 + 토큰 프루닝 + 비동기 추론을 겹쳐 쓰고, 성공률 저하를 태스크별로 재측정하는 게 현실적이다.
3) FASTER: 첫 액션만 먼저 뽑는다
2026년 3월 공개된 FASTER(Fast Action Sampling for ImmediaTE Reaction, 2603.19199)는 flow 기반 VLA의 반응 지연 문제를 정면으로 겨눈다. 핵심 관찰은 단순하다. 청크 안의 모든 액션을 같은 스텝 스케줄로 디노이징하니, 당장 필요한 첫 액션도 10스텝을 다 기다려야 한다는 것이다.
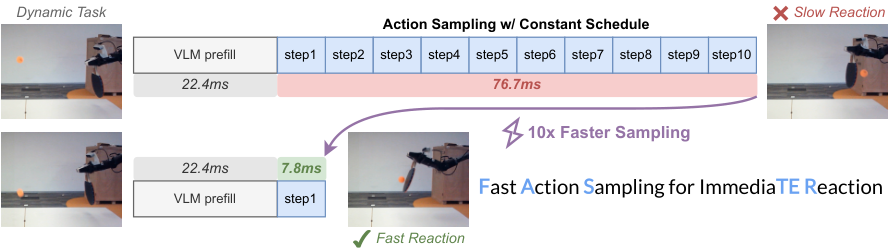
해법은 Horizon-Aware Schedule이다. 청크 앞쪽 액션에는 적은 스텝을, 뒤쪽에는 많은 스텝을 배분해 첫 액션을 1스텝에 뽑고 나머지는 스트리밍으로 흘려보낸다. 아키텍처 변경 없이 파인튜닝 파이프라인에 끼워 넣을 수 있고, π0.5와 X-VLA에 적용했다. 그림의 "10×"는 디노이징 스텝 수(10→1) 기준이고, 로봇 측 파이프라인에서 실제 측정한 TTFA는 비동기 대비 π0.5에서 1.27–1.29배, X-VLA에서 2.54–3.09배 빨라졌다(RTX 4090/4060). 특히 추론이 약 3 Hz밖에 안 나오는 RTX 4060에서 이득이 컸다. 실로봇 실험은 AgileX Cobot Magic으로 탁구공 받아치기였고, 동기 방식은 아예 반응하지 못한 반면 FASTER가 가장 빨리 라켓을 맞췄다고 보고한다.
4) TIDAL: 의도는 느리게, 제어는 빠르게
2026년 1월의 TIDAL(Temporally Interleaved Diffusion and Action Loop, 2601.14945)은 같은 문제를 계층 분리로 푼다. 느린 매크로 루프가 VLM을 한 번 호출해 의미적 의도 임베딩을 캐시하고, 빠른 마이크로 루프가 최신 proprioception과 모션 단서를 조건으로 single-step flow 적분과 실행을 번갈아 수행한다.
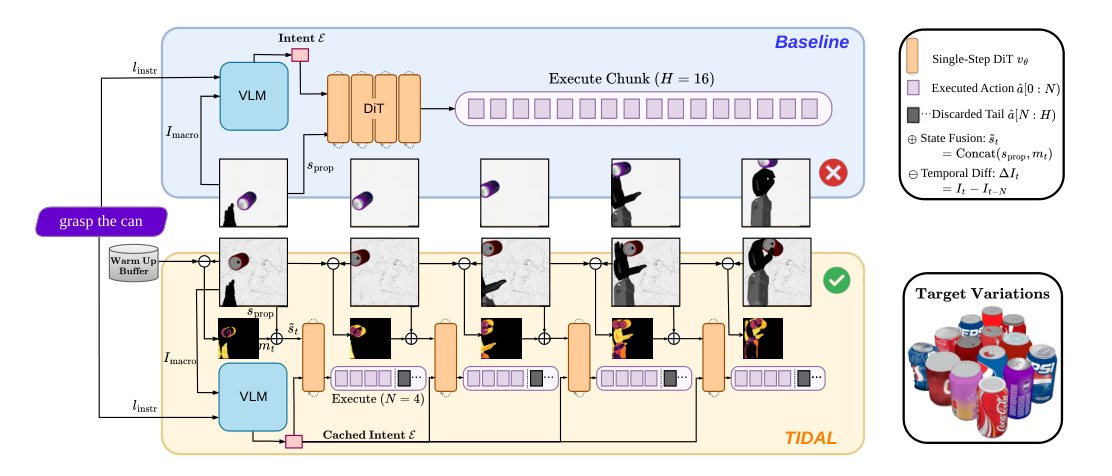
캐시된 의도는 시간이 지나면 낡는다. TIDAL은 학습 때 일부러 시간적으로 어긋난 쌍(오래된 의도 + 최신 상태)을 넣어, 정책이 낡은 의도를 현재 proprioception으로 보정하도록 가르친다. 16스텝 청크 중 앞 4스텝만 실행하고 나머지를 버리며 약 9 Hz로 제어를 갱신한다. 움직이는 물체를 잡는 동적 인터셉션 태스크에서 개방 루프 대비 약 2.5배 성능, 피드백 주파수 4배를 보고했고, 정적 태스크의 성공률은 약간 떨어졌다고 솔직하게 적었다.
FASTER와 TIDAL은 접근은 다르지만 같은 메시지를 준다. 2026년의 VLA 배포 문제는 "모델을 작게"에서 "첫 액션을 빨리, 그리고 계속 보정"으로 옮겨갔다.
🔁 RL 사후학습: π*0.6와 Recap
3편에서 π0 → π0.5 계보를 봤다. 2025년 11월 17일 Physical Intelligence가 공개한 π*0.6는 여기에 강화학습을 더한다. 모방학습만으로는 시연자의 실력을 넘기 어렵고, 시연 데이터는 정책이 실제로 빠지는 실패 상태를 잘 덮지 못한다. Recap(RL with Experience & Corrections via Advantage-conditioned Policies)은 세 가지 데이터를 한 모델에 녹인다.
- 오프라인 RL 사전학습 — π0.6·π0.5가 지도학습으로 하던 사전학습을 오프라인 RL로 대체한다.
- 시연으로 태스크 파인튜닝.
- 로봇 위 RL — 정책이 돌다가 실수하면 텔레오퍼레이터가 개입해 교정하고(expert corrections), 자율 에피소드의 성공/실패가 보상 라벨이 된다.
기술적 핵심은 가치 함수와 어드밴티지 조건화다. 가치 함수는 "이 상황이 다른 상황에 비해 얼마나 좋은가"(블로그의 한 변형은 완료까지 남은 스텝 수의 음수)를 예측하고, 어떤 행동이 가치를 올렸으면 좋은 행동, 내렸으면 나쁜 행동으로 어드밴티지를 매긴다. 그리고 이 어드밴티지를 입력 주석으로 정책에 넣어, 좋은 데이터·나쁜 데이터를 버리지 않고 전부 학습한다. 실행 시에는 "높은 어드밴티지 행동을 하라"고 조건을 준다. 대형 VLA에 정책 경사를 직접 돌리는 대신 데이터를 전부 보존하면서 라벨만 바꾸는, 확장성을 우선한 설계다.
블로그가 보고한 결과는 다음과 같다(벤더 주장).
- 에스프레소 제조, 세탁물 접기, 상자 조립 등 가장 어려운 태스크에서 로봇 경험 학습 후 처리량 2배 이상, 실패율 절반 이하.
- 에스프레소는 오전 5:30부터 오후 11:30까지 연속 운영, 각 단계 성공률 90% 이상.
- 새로운 집에서 처음 보는 세탁물 50점을 중단 없이 접기, 실제 공장에서 초콜릿 포장 상자 59개 조립·라벨링.
π*0.6의 백본은 5B VLM + 액션 expert로, π0.5보다 약간 커졌다. 논문은 arXiv가 아닌 자체 PDF로 공개됐다.
🧠 메모리와 장기 과제: MEM
VLA는 기본적으로 "현재 프레임 → 다음 청크" 함수라 10분짜리 태스크에서 "소금을 이미 넣었는지"를 모른다. 2026년 3월 3일 Physical Intelligence는 π0.6 위에 **Multi-Scale Embodied Memory(MEM)**를 발표했다.
- 단기 메모리: 최근 관측을 효율적인 비디오 인코더로 넣는다. 표준 ViT에 희소 공간 어텐션과 인과적 시간 어텐션을 번갈아 끼우되 시간 어텐션은 대략 4레이어마다 하나, 상위 레이어에서는 히스토리 토큰을 떨어뜨려 백본에 전달되는 토큰 수를 줄인다.
- 장기 메모리: 고수준 서브태스크 추론 단계에서 "접시 세 장을 치웠다" 같은 텍스트 노트를 생성하고, 여러 사건을 요약해 합치며, 컨텍스트가 넘치지 않도록 동적으로 골라 쓴다.
약 15분 길이 태스크(그릴드 치즈 샌드위치 만들기, 부엌 전체 치우기 등)에서 메모리 없는 버전과 비디오만·텍스트만 쓰는 변형 대비 "유의미한 향상"을 보였다고 하지만, 블로그 본문에 정확한 수치는 없다. 저자들도 수 시간·수 일 단위 컨텍스트는 비디오로는 불가능하며, 잘못 설계된 메모리는 모방학습의 고질적 문제인 **인과 혼동(causal confusion)**을 부른다고 짚는다.
🛡️ 안전과 평가: ASIMOV에서 ASIMOV-Agentic까지
VLA가 집과 공장에 들어가면 "성공률" 외의 축이 필요하다. Google DeepMind는 2025년 3월 Gemini Robotics(2503.20020)를 내면서 ASIMOV 데이터셋을 공개했다. 로봇 행동의 의미적 안전성("이 행동이 사람을 다치게 할 수 있는가")을 평가하는 데이터셋이고, 아시모프의 3원칙에서 영감을 받은 **로봇 헌법(Robot Constitution)**을 데이터 기반으로 생성·자동 수정하는 프레임워크를 함께 제안했다. 저수준 충돌 회피·접촉력 제한부터 고수준 의미 판단까지 층을 쌓는 접근이다.
2026년 7월 30일 발표된 Gemini Robotics 2는 세 모델로 구성된다. VLA인 Gemini Robotics 2, 고수준 플래너이자 사람과 소통하는 Gemini Robotics ER 2(모델 카드 기준 Gemini 3.5 Flash 기반), 로봇에서 로컬로 도는 On-Device 2. 체크포인트 하나로 세 가지 로봇 구성을 제어했고, On-Device 2는 새 양팔 로봇에 보통 200개 미만의 예시로 몇 시간 안에 적응한다고 한다. 안전 측면에서는 ASIMOV-Agentic 벤치마크를 새로 도입했는데, ER 2가 VLA로부터 온 안전하지 않은 툴 호출을 거부하는지, 태스크 가능 여부를 예측하는지, 불확실할 때 사람에게 도움을 요청하는지를 본다. 사람이 너무 가까이 오면 안전 툴 호출로 로봇을 정지시키는 기능도 소개했다. 별도의 Safety Technical Report가 있다(본 글에서는 블로그 본문만 확인했다).
눈여겨볼 점은 DeepMind가 공개한 성공률이다. Apptronik Apollo 전신 조작에서 테이블 위 물체 집기 68.4%, 바닥 45.7%, 선반 76.3%, 다섯손가락 Sharpa 핸드로 전구 끼우기 36%, 쓰레기봉투 묶기 44%, 지퍼백 닫기 40%다. 블로그 자체가 "다지 손 조작은 여전히 어렵다", "이동 속도는 개선이 필요하다"고 적고 있다.
🏭 2026년 응용 현황
서베이는 응용을 자율주행, 모바일 매니퓰레이션·스마트홈, 산업 제조·물류, 인간-로봇 협업·의료 보조로 나눈다. 각 분야의 제약이 다르다. 가정은 엣지 배포·프라이버시·희소한 시연 데이터가 문제고, 산업은 처리량·연속 운영 신뢰성·정밀 삽입·접촉 제어가 문제다. 2026년 공식 발표를 기준으로 현황을 추리면 다음과 같다(모두 벤더 발표다).
| 분야 | 사례(공식 출처) | 상태 |
|---|---|---|
| 가정 | Physical Intelligence π*0.6 / MEM — 에스프레소, 세탁, 부엌 정리 | 연구 데모, 수 시간 연속 운영 |
| 자동차 공장 | Figure 03 + Helix 02, BMW Spartanburg Hall 52 (2026-06-30) — 얇은 부품 피킹과 전신 협응이 필요한 물류 워크플로 | 파일럿 배포 |
| 자동차 공장 | Hyundai·Boston Dynamics Atlas — 2026년 물량은 RMAC(훈련·검증 센터)와 Google DeepMind로, HMGMA 부품 시퀀싱은 2028년 목표 | 훈련 단계 |
| 범용 플랫폼 | Gemini Robotics 2 — ER 2는 AI Studio 공개, VLA·On-Device 2는 얼리 액세스 | 제한 공개 |
Figure는 2026년 4월 기준 BotQ 공장에서 3세대 로봇 350대 이상을 출하했고 생산 속도를 하루 1대에서 시간당 1대로 올렸다고 밝혔다. 다만 BMW 투입은 "데모" 성격의 물류 워크플로이며 독립 검증 보도는 찾지 못했다. Hyundai의 "연 3만 대 생산 시설"은 계획이고, 실제 공장 라인 투입은 2028년부터다. 즉 2026년 11월 현재 휴머노이드 VLA의 공장 배포는 파일럿과 훈련 센터 단계이며, "수만 대 배포"는 로드맵이다.
⚠️ 2026년 시점의 솔직한 한계
- 성공률의 천장이 낮다. 가장 앞선 Gemini Robotics 2조차 다지 손 태스크가 32–44%대다. 벤치마크 수치와 "하루 종일 실패 없이"는 다른 문제이며, π*0.6가 RL로 실패율을 절반으로 줄였다는 것은 거꾸로 모방학습만으로는 그 수준이 안 된다는 뜻이다.
- 반응성은 여전히 하드웨어 종속이다. FASTER의 측정에서 같은 모델이 RTX 4090에서 80 ms, RTX 4060에서 303 ms의 TTFA를 보였다. 엣지에서 수십 Hz 반응을 내려면 양자화·프루닝·스케줄링을 모두 겹쳐야 하고, 각 기법의 성공률 손실은 태스크마다 다시 재야 한다.
- 메모리는 15분, 그 너머는 미지. MEM은 15분 태스크에 머물고, 수 시간·수 일 단위 컨텍스트는 저자들도 미해결로 둔다.
- 데이터 딜레마. 서베이가 정리한 대로 실로봇 시연은 비싸고, 시뮬·비디오 데이터는 힘·proprioception이 빠져 있어 운동학적 모호성을 남긴다. 자율 탐색으로 커버리지를 늘리면 충돌 위험과 노이즈 보상이 따라온다(안전-효율 딜레마).
- 평가 표준이 없다. 효율화 방법들은 서로 다른 지표로 속도를 재고, 안전 벤치마크는 ASIMOV 계열 하나가 사실상 유일하다. "이 VLA가 저 VLA보다 안전하다"를 말할 공통 척도가 아직 없다.
- 공개 수치 대부분이 벤더 발표다. π*0.6, MEM, Gemini Robotics 2, Figure의 수치는 모두 자체 블로그 기준이고, 독립 재현은 거의 없다.
📚 시리즈 정리
| 편 | 글 | 한 줄 요약 |
|---|---|---|
| 1 | VLA란 무엇인가 | 모방학습·언어조건 정책에서 RT-2로, "인터넷 지식을 행동으로" |
| 2 | VLA 해부 | VLM 백본, 액션 표현, autoregressive vs diffusion vs flow, 액션 청킹 |
| 3 | 모델 계보 | RT-2 → OpenVLA → π0/π0.5 → GR00T, Gemini Robotics, SmolVLA 비교 |
| 4 | 데이터와 크로스 임바디먼트 | OXE, DROID, LeRobot 포맷, 시뮬, co-training, 왜 어려운가 |
| 5 | SmolVLA 파인튜닝 실습 | LeRobot 설치부터 학습·평가·실패 패턴까지 |
| 6 | 배포와 응용, 전망 (이 글) | 실시간 추론, RL 사후학습, 메모리, 안전, 2026년의 한계 |
시리즈를 관통하는 흐름은 하나다. 2023년의 VLA는 "VLM이 로봇을 움직일 수 있는가"를 증명했고, 2024–25년은 "어떤 아키텍처와 데이터로 일반화하는가"를 다뤘다. 2026년의 질문은 "얼마나 빨리 반응하고, 얼마나 오래 기억하며, 실패에서 스스로 배우고, 사람 옆에서 안전하게 멈추는가"다. 모델 하나의 문제에서 시스템의 문제로 옮겨 온 것이다. 다음에 이 시리즈를 갱신한다면 아마 그 네 가지 축에서 숫자가 얼마나 올라갔는지를 세는 글이 될 것이다.
📚 참고
- Yu et al., A Survey on Efficient Vision-Language-Action Models, arXiv:2510.24795
- Lu et al., FASTER: Rethinking Real-Time Flow VLAs, arXiv:2603.19199
- Sun et al., TIDAL: Temporally Interleaved Diffusion and Action Loop for High-Frequency VLA Control, arXiv:2601.14945
- Shukor et al., SmolVLA, arXiv:2506.01844
- Physical Intelligence, π*0.6: a VLA that learns from experience (2025-11-17), pi.website/blog/pistar06
- Physical Intelligence, Multi-Scale Embodied Memory (2026-03-03), pi.website/research/memory
- Gemini Robotics Team, Gemini Robotics: Bringing AI into the Physical World, arXiv:2503.20020 / DeepMind 블로그 (2025-03-12)
- Google DeepMind, Gemini Robotics 2 brings whole body intelligence to robots (2026-07-30), deepmind.google
- Figure AI, F.03 Arrives at BMW (2026-06-30), figure.ai/news/f-03-at-bmw; Ramping Figure 03 Production, figure.ai/news/ramping-figure-03-production
- Hyundai Motor Group, AI Robotics Strategy at CES 2026, hyundai.com newsroom
본 글의 그림은 각 논문/공식 블로그에서 가져왔습니다(출처: Efficient VLA 서베이 2510.24795 Fig. 1·4·6, FASTER 2603.19199 Fig. 1·2, TIDAL 2601.14945 Fig. 1).