VLA 해부: VLM 백본부터 액션 헤드까지
"액션 토큰은 LLM의 언어 토큰에 대응하는 일반화된 개념이다." — 액션 토큰화 서베이(arXiv 2507.01925) 1절
이 글은 VLA 시리즈 2편이다. 1편에서 VLM이 왜 로봇의 두뇌가 되었는지를 봤다면, 이번에는 그 두뇌를 해부대에 올린다. VLA는 결국 "이미지·언어·관절 상태를 받아 다음 몇 스텝의 관절 명령을 내놓는 함수"인데, 어떤 VLM을 쓰는지보다 액션을 어떤 형태로 표현하고 어떤 헤드로 뽑아내는지가 모델 간 차이의 대부분을 만든다. OpenVLA, Octo, π0, FAST, GR00T N1 다섯 논문을 부품 단위로 비교하고, 수식은 flow matching 하나만 쓴다. 다음 3편에서는 이 부품들이 실제 모델 계보에서 어떻게 조합되었는지 비교표로 정리한다.
🤔 VLA를 다섯 부품으로 나누면
어떤 VLA든 다음 다섯 조각으로 분해할 수 있다.
- VLM 백본: 인터넷 규모 이미지·텍스트로 사전학습된 비전 인코더 + 언어 모델. 의미 이해와 언어 접지(grounding)를 담당한다.
- 관측 인코딩: 여러 카메라 뷰(3인칭·손목)와 고유수용 상태(proprioception, 관절 각도 )를 토큰 열로 바꾸는 방법.
- 액션 표현: 연속적인 관절 명령을 이산 토큰으로 바꿀지, 연속값 그대로 둘지.
- 액션 헤드: 백본 출력에서 액션을 생성하는 모듈. 자기회귀 디코딩, diffusion, flow matching 중 하나이고, 백본과 결합하는 방식(별도 MLP, action expert, cross-attention DiT)이 갈린다.
- 청킹과 주파수: 한 번 추론에 몇 스텝의 액션을 내놓고(action chunk ), 로봇은 몇 Hz로 돌리며, 추론은 얼마나 자주 다시 하는가.
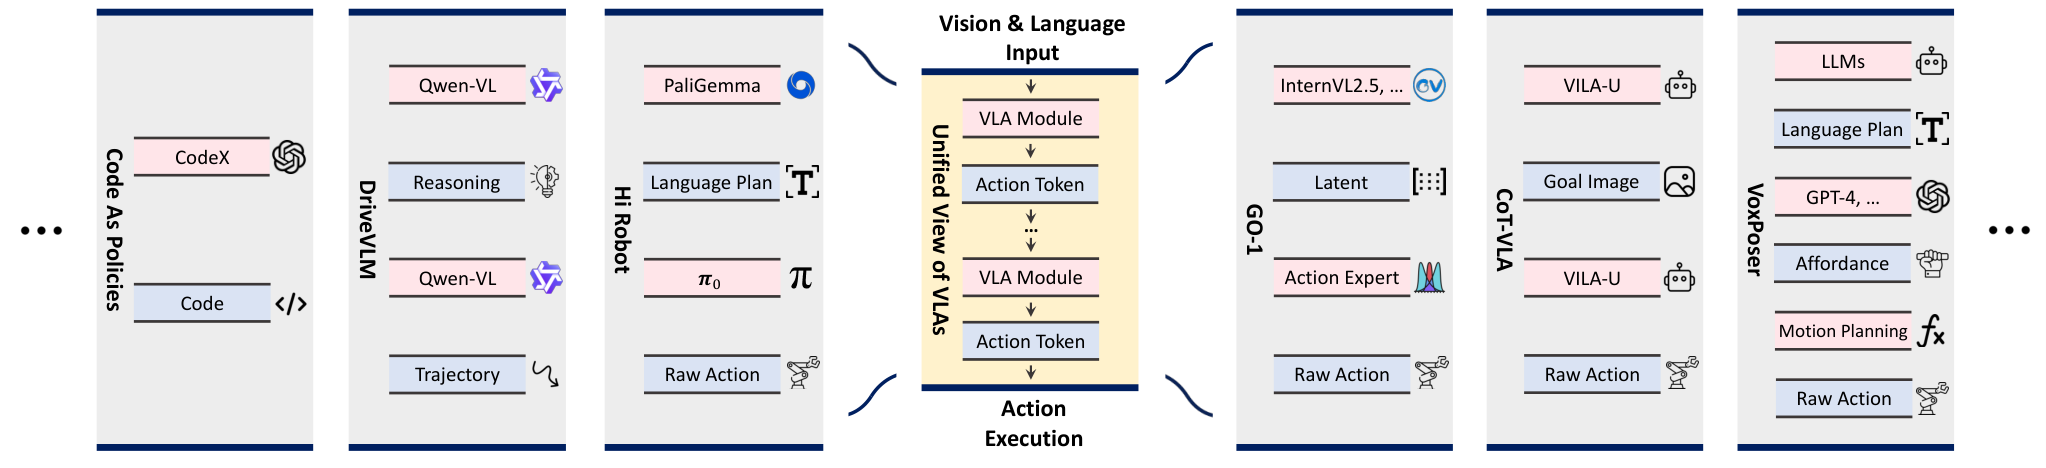
2025년 7월의 액션 토큰화 서베이(arXiv 2507.01925)는 이 중 3·4번을 더 넓게 본다. 모델이 비전·언어 입력에서 최종 모터 명령에 이르기까지 중간에 생성하는 모든 것, 즉 언어 계획, 코드, 어포던스, 궤적, 목표 이미지, 잠재 표현, 원시 액션, 추론 흔적을 전부 액션 토큰이라 부르고 여덟 범주로 나눈다. 이 글은 그중 마지막 단계인 원시 액션(raw action) 을 다루는 모델들, 즉 관절 명령을 직접 출력하는 end-to-end VLA에 집중한다. 서베이는 "원시 액션이 end-to-end 학습의 이상형이지만 데이터 가용성에 묶여 있다"고 정리하고, 앞으로는 상위 계층이 언어·코드로 장기 계획을 하고 하위 계층이 원시 액션을 내는 계층 구조가 될 것으로 본다.
🧠 백본과 관측 인코딩
OpenVLA: 표준 VLM 레시피에 액션 토큰만 얹기
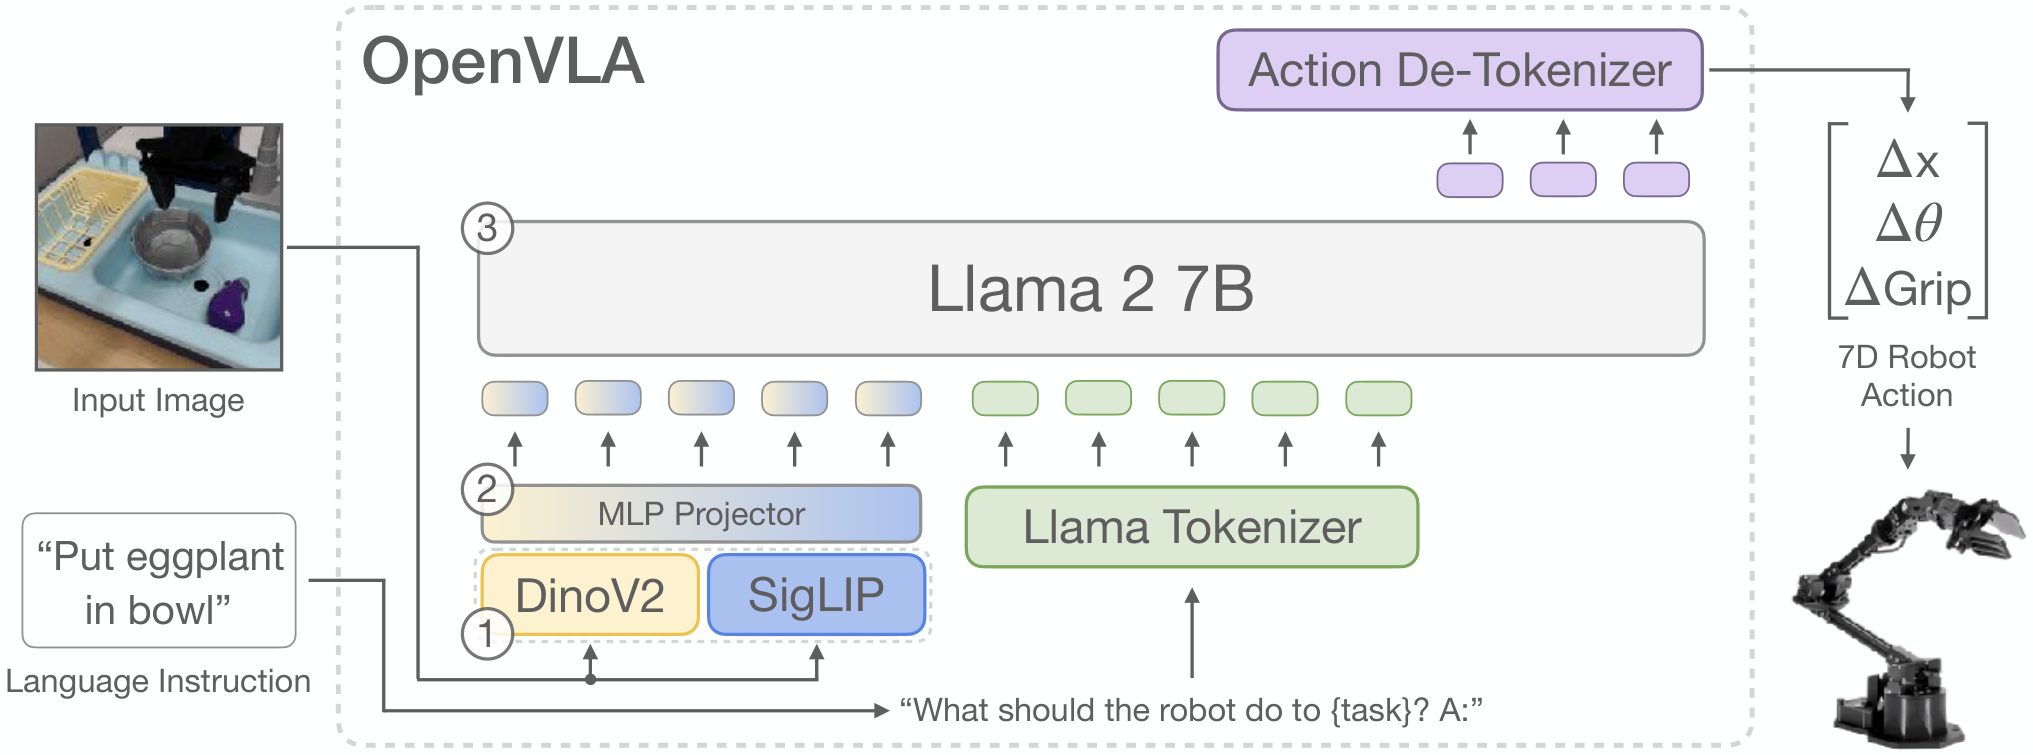
OpenVLA(arXiv 2406.09246)는 가장 교과서적인 구성이다. Prismatic-7B VLM을 그대로 가져와, 6억 파라미터의 비전 인코더(SigLIP과 DinoV2 특징을 채널 방향으로 이어 붙인 융합 인코더), 2층 MLP 프로젝터, Llama 2 7B 언어 모델을 쓴다. 입력은 이미지 한 장과 언어 지시뿐이다. 관절 상태도, 과거 프레임도 넣지 않는다. 저자들은 DinoV2를 더한 이유로 공간 추론에 유리한 저수준 특징을 들고, 부록 ablation에서 SigLIP만 쓴 변형과 비교한다.
학습 비용은 A100 64장으로 14일, 총 21,500 A100-시간이고, 추론 시 bf16으로 15GB 메모리를 쓰며 RTX 4090 한 장에서 약 6Hz로 돈다. 이 "6Hz"가 뒤에서 액션 표현을 논할 때 핵심 제약이 된다.
π0: 멀티뷰 + 상태 토큰을 late fusion으로
π0(arXiv 2410.24164)는 PaliGemma(SigLIP 400M + Gemma 2B, 합쳐 약 3B)를 백본으로 쓴다. 관측 는 로봇당 2~3장의 카메라 이미지, 언어 명령, 관절 각도 벡터로 구성되고, 이미지는 ViT를 거쳐, 상태 는 선형 투영을 거쳐 언어 토큰과 같은 임베딩 공간에 놓인다. 크로스 임바디먼트 학습을 위해 상태와 액션 벡터는 데이터셋 중 최대 차원인 18차원으로 zero-padding한다. 7-DoF 단일 팔부터 14-DoF 양팔, 17차원 액션의 모바일 매니퓰레이터까지 한 모델이 받는 방식이다.
GR00T N1: 중간 층 임베딩을 꺼내 쓰기
GR00T N1(arXiv 2503.14734)은 NVIDIA Eagle-2 VLM(SmolLM2 LLM + SigLIP-2 인코더)을 쓰는데, 224×224 이미지를 pixel shuffle로 프레임당 64개 토큰으로 줄이고, LLM의 마지막 층이 아니라 12번째 층 임베딩을 액션 모듈에 넘긴다. 저자들은 중간 층을 쓰는 편이 추론도 빠르고 정책 성공률도 높았다고 보고한다. 공개된 GR00T-N1-2B는 총 2.2B 파라미터 중 VLM이 1.34B다.
Octo: VLM 없이 가벼운 트랜스포머
비교 기준으로 Octo(arXiv 2405.12213)도 보자. Octo는 VLM 백본이 아니라 언어는 동결된 T5-base(111M)로, 이미지는 얕은 CNN으로 토큰화한 뒤 자체 트랜스포머(Octo-Small 27M, Octo-Base 93M)에 넣는다. 3인칭 이미지는 256토큰, 손목 이미지는 64토큰이다. 관측 토큰은 같은 시점 이전의 관측과 과제 토큰에만 인과적으로 attention하는 블록 마스크를 쓰며, 없는 모달리티는 통째로 마스킹해 파인튜닝 때 카메라나 액션 공간을 바꿀 수 있게 설계했다. 인터넷 지식은 T5 임베딩을 통해서만 들어오므로 엄밀히는 "VLA"보다 "범용 로봇 정책"이지만, 액션 헤드 설계는 이후 모델에 그대로 이어진다.
📐 액션 표현: 이산 토큰인가, 연속값인가
256-bin 토큰화와 그 한계
RT-2와 OpenVLA는 액션을 언어 토큰처럼 다룬다. OpenVLA는 각 액션 차원을 학습 데이터의 1~99 백분위 구간을 256개 균등 구간으로 나눠 정수 하나로 만들고(RT-2의 min-max 대신 분위수를 써서 이상치에 강하게 했다), Llama 토크나이저에서 가장 적게 쓰이는 마지막 256개 토큰을 덮어써 액션 토큰으로 쓴다. 학습 목표는 액션 토큰에 대한 표준 next-token 교차 엔트로피다. 7차원 액션 한 스텝은 토큰 7개가 되고, 매 스텝 디코딩을 7번 해야 하므로 7B 모델에서 6Hz가 나온다.
FAST 논문(arXiv 2501.09747)은 이 방식이 고주파 데이터에서 무너지는 이유를 장난감 실험으로 보인다. 샘플링 주파수를 올릴수록 인접 토큰의 상관이 강해져 토큰당 정보량이 떨어지고, 결국 모델이 첫 액션을 복사만 하는 퇴화가 일어난다. 1초짜리 청크를 binning으로 토큰화하면 BridgeV2(7차원, 5Hz)는 35토큰이지만 셔츠 접기(14차원, 50Hz)는 700토큰이다.
FAST: 액션을 압축한 뒤 토큰화
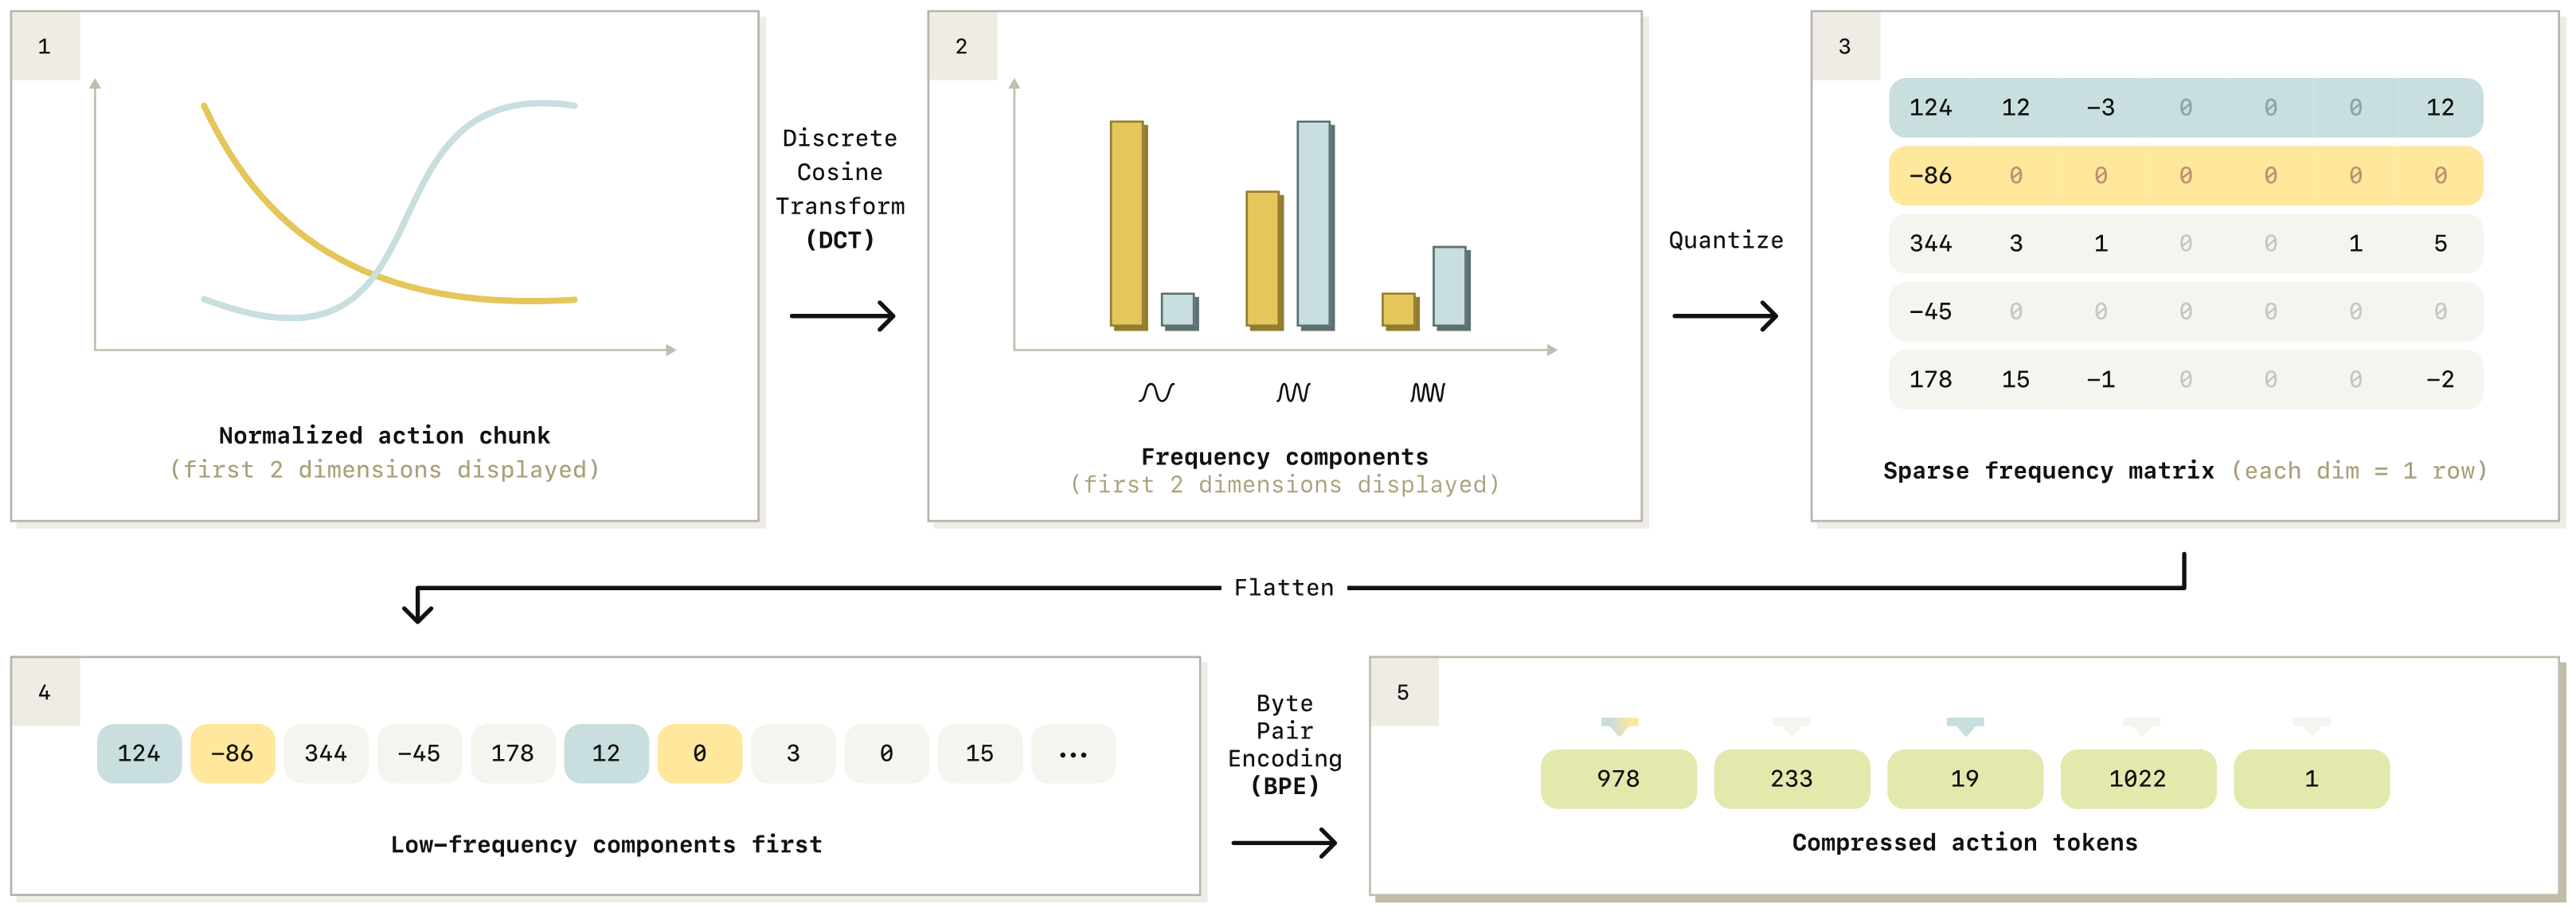
FAST(Frequency-space Action Sequence Tokenization)는 "토큰화 전에 압축하라"는 한 줄로 요약된다. 1초 액션 청크를 1~99 분위수로 에 정규화하고, 차원별로 이산 코사인 변환(DCT) 을 적용한 뒤, 계수를 스케일-반올림해 대부분 0인 희소 행렬로 만든다. 이를 저주파 성분이 먼저 오도록 평탄화하고 BPE로 압축한다. 저주파를 먼저 두는 이유는 자기회귀 예측에서 전체 궤적의 형태를 먼저 결정하는 편이 롤아웃이 안정적이기 때문이다. 하이퍼파라미터는 DCT 스케일과 BPE 어휘 크기 둘뿐이고 모든 연산이 가역이라 디코딩이 빠르다.
표 I 기준으로 같은 1초 청크가 BridgeV2 35→20, DROID(15Hz) 105→29, 테이블 치우기(20Hz) 140→28, 셔츠 접기(50Hz) 700→53 토큰으로 줄어든다. 흥미롭게도 팔 하나당 약 30토큰으로 주파수와 거의 무관하게 수렴하는데, 저자들은 이것이 신호 자체의 복잡도에 맞는 표현을 찾은 증거라고 해석한다. 100만 개 청크로 학습한 범용 토크나이저 FAST+는 HuggingFace AutoProcessor로 공개되어 있고, 데이터셋별 토크나이저와 성능이 거의 같다.
연속 표현
세 번째 길은 토큰화를 아예 하지 않는 것이다. Octo·π0·GR00T N1은 액션 청크를 실수 벡터 그대로 두고 생성 모델(diffusion 또는 flow matching)로 분포를 학습한다. Octo의 ablation(표 II)에서 diffusion 헤드는 MSE 헤드나 이산 교차 엔트로피 헤드보다 성능이 좋았고, MSE 헤드는 "느리게 움직이고 그리퍼 회전을 못 하는" 평균 회귀(hedging) 정책을 만들었다고 보고한다. 액션 분포가 다봉(multimodal)이라서 평균을 맞추는 회귀로는 안 된다는 것이 Diffusion Policy 이후 공유된 결론이다.
🛠️ 액션 헤드: 자기회귀 vs diffusion vs flow matching
Octo: readout 토큰 + 작은 diffusion MLP
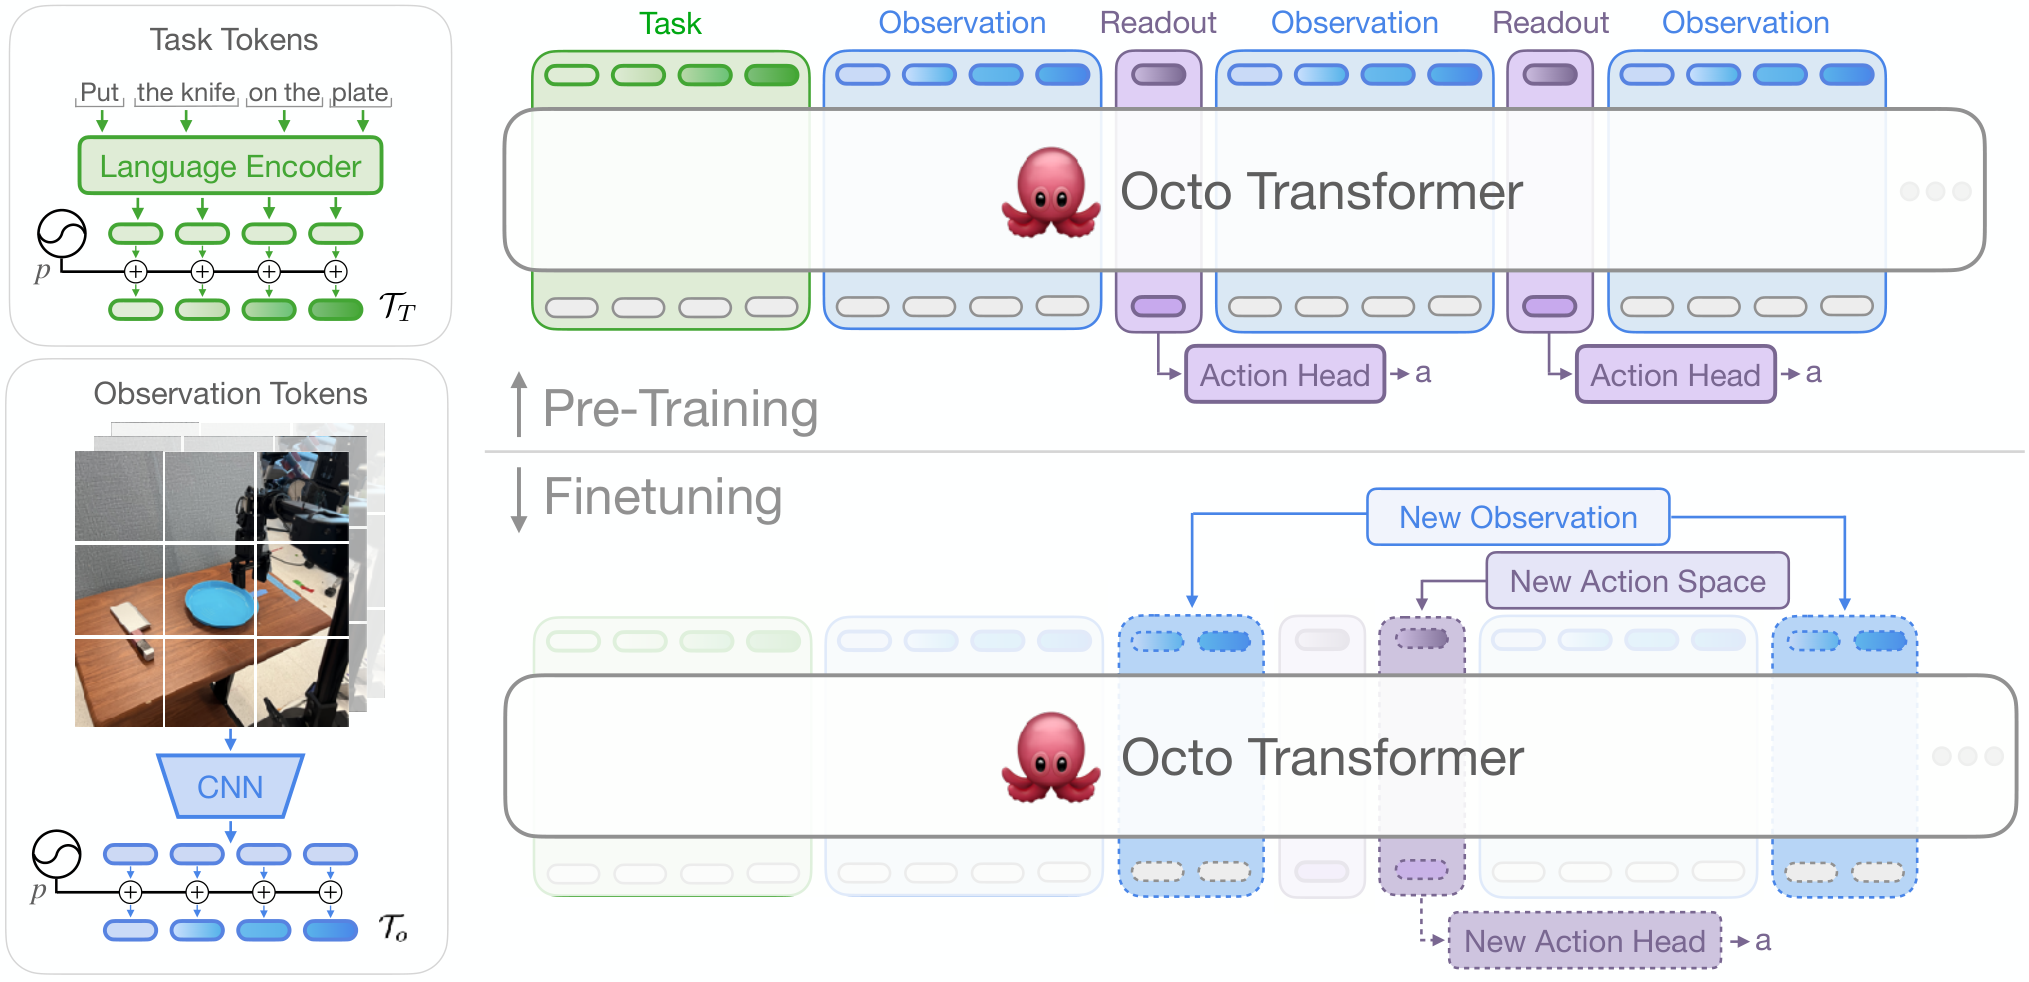
Octo는 입력 열 사이에 학습 가능한 readout 토큰을 끼운다. readout은 앞선 관측·과제 토큰을 읽지만 아무도 readout을 읽지 않아 BERT의 [CLS]처럼 수동적 요약 벡터로 작동한다. 이 임베딩 에 3층 MLP(hidden 256) diffusion 헤드를 붙여 DDPM 목표로 학습하고, 추론 시 코사인 스케줄로 20스텝 디노이징을 돌린다. 핵심은 백본 forward는 한 번, 디노이징은 작은 헤드 안에서만 반복한다는 점이다. 백본이 93M밖에 안 되니 비용 문제는 아니었지만, 이 "백본 1회 + 헤드 K회" 구조가 이후 VLA들의 기본 패턴이 된다.
π0: action expert와 flow matching
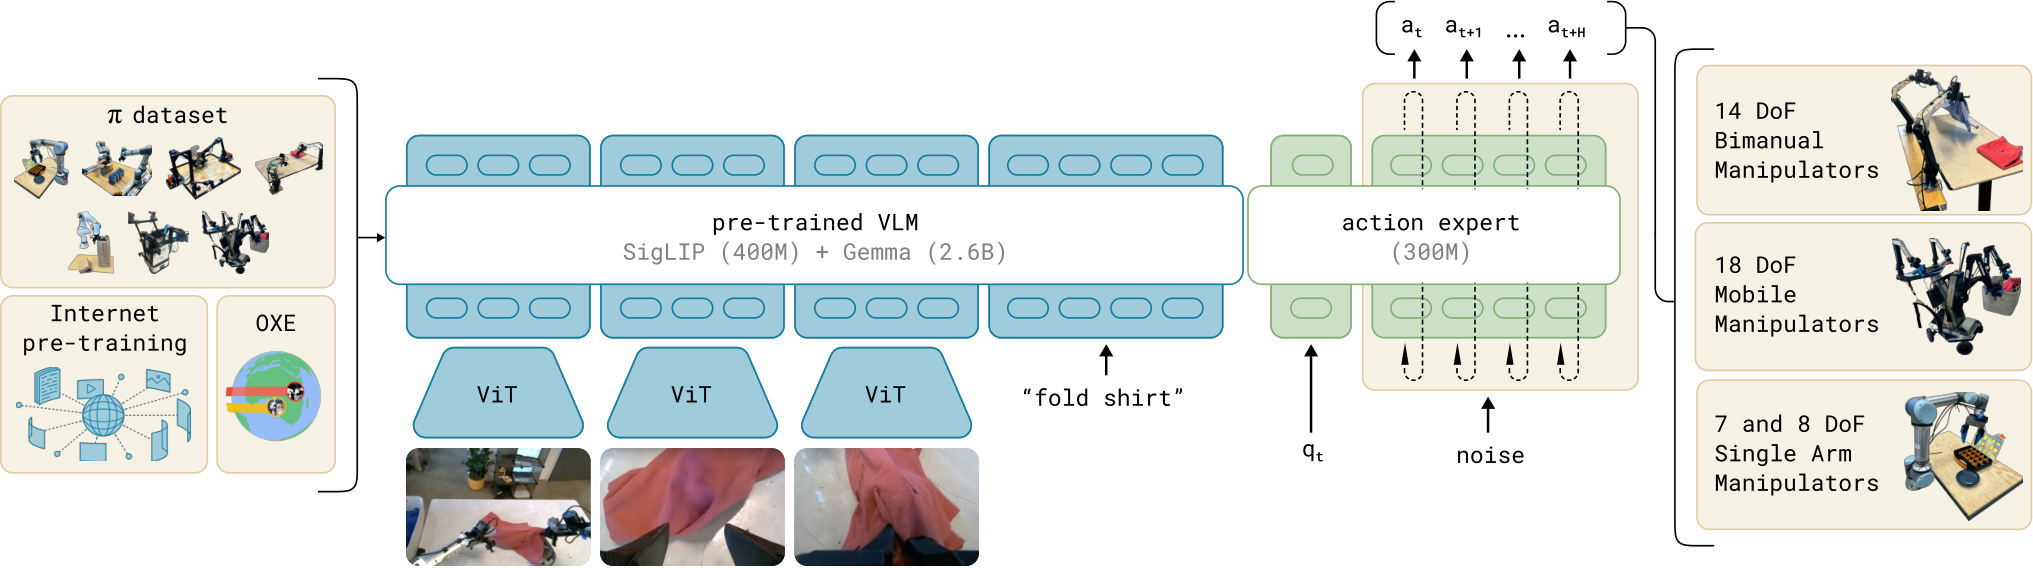
π0는 Transfusion에서 영감을 받아 하나의 트랜스포머에 두 벌의 가중치를 둔다. 이미지·언어 토큰은 PaliGemma에서 초기화한 큰 가중치(width 2048, depth 18)로, 상태 와 노이즈 섞인 액션 토큰은 처음부터 학습하는 action expert(width 1024, mlp_dim 4096, 약 300M)로 라우팅된다. 두 expert는 self-attention 층에서만 섞이므로 폭이 달라도 된다. 저자들은 이를 "mixture of experts에 원소가 둘"이라고 설명하고, 로봇 토큰에 별도 가중치를 쓰는 편이 성능이 더 좋았다고 적는다. 어텐션 마스크는 3블록 블록-인과형이다. → → 순으로, 블록 안은 양방향이지만 뒤 블록을 볼 수 없다. VLM 사전학습에서 못 본 입력이 VLM 토큰의 표현을 흔들지 않게 하고, 블록을 따로 둬서 적분 스텝마다 그 KV를 캐시할 수 있게 한 설계다.
액션 생성은 conditional flow matching이다. 액션 청크 ()에 노이즈 를 섞어 을 만들고, 네트워크 가 노이즈에서 데이터로 향하는 벡터장을 맞추도록 학습한 뒤, 추론 때는 그 벡터장을 에서 까지 오일러 적분한다.
DDPM과 달리 경로가 직선(linear-Gaussian, optimal transport path)이라 10스텝이면 충분하고, 스텝 수가 고정된 스케줄이 아니라 적분 간격 로 조절된다. 타임스텝 는 균등분포 대신 , 로 샘플링해 노이즈가 큰 쪽을 더 자주 본다. 이미지 생성에서는 중간 타임스텝을 강조하는 logit-normal이 흔하지만, 저자들은 관측 가 텍스트 프롬프트보다 훨씬 강한 조건이라 "조건부 평균 액션"을 배우는 초기 구간이 더 어렵다고 추정한다. 추론 비용은 RTX 4090에서 카메라 3장 기준 이미지 인코딩 14ms, 관측 forward 32ms, action expert 10회 27ms로 온보드 총 73ms다(표 I).
π0-FAST: 같은 백본, 자기회귀 디코딩
FAST 논문은 π0와 같은 백본에 action expert 대신 FAST 토큰을 자기회귀로 디코딩하는 π0-FAST를 만들어 정면 비교한다. 결과는 양면적이다. 성능은 세탁물 접기까지 포함해 diffusion π0와 대등했고, 학습 GPU-시간은 5배 적게 들었으며 DROID에서는 언어 지시를 더 잘 따랐다. 반면 추론은 1초 청크당 diffusion π0가 100ms 안쪽인 데 비해 π0-FAST는 약 750ms다. 30~60개 토큰을 2B 언어 모델 전체로 디코딩해야 하기 때문이다(diffusion 쪽은 300M expert를 10회). 저자들은 정적 조작 과제에서는 이 지연이 성능을 해치지 않았다고 하면서도 speculative decoding 등 LLM 추론 가속 기법을 과제로 남긴다.
GR00T N1: System 2와 System 1을 cross-attention으로
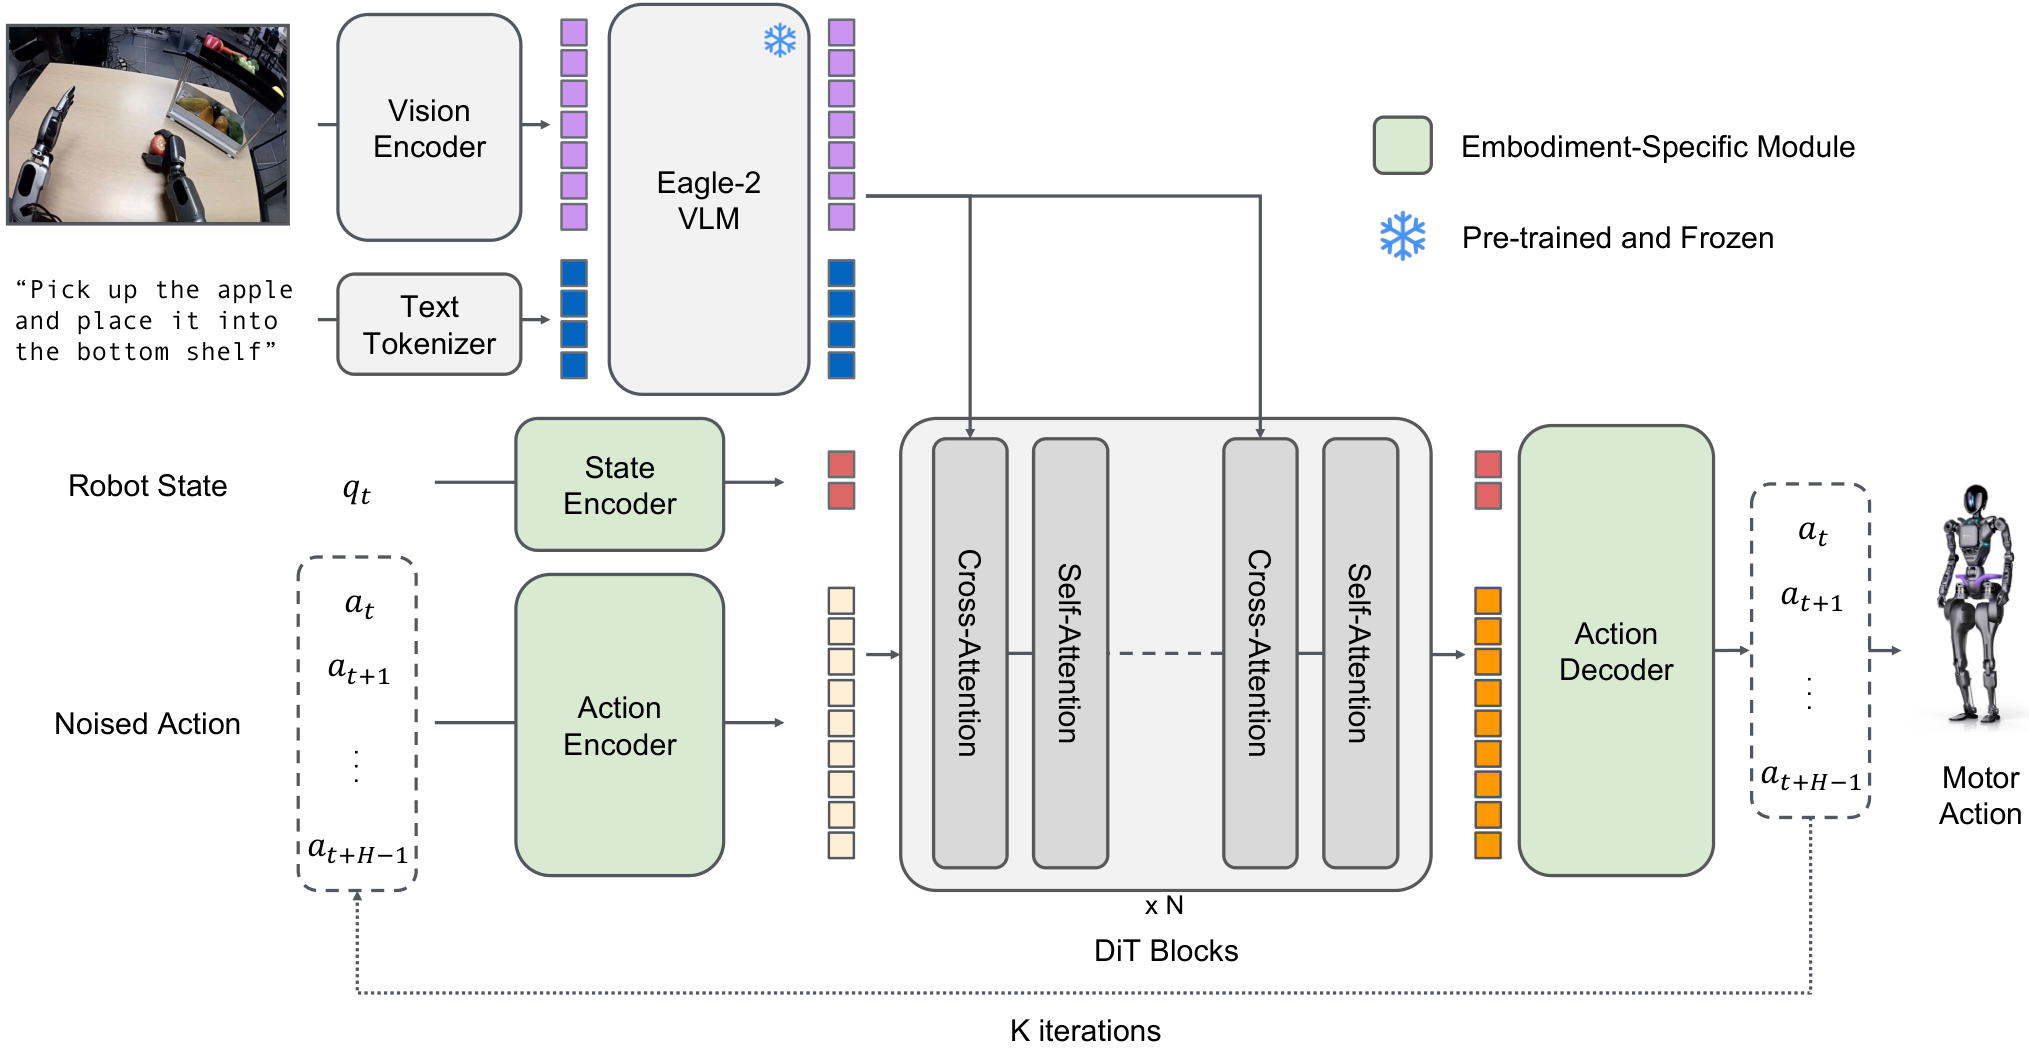
GR00T N1은 같은 flow matching을 쓰되 결합 방식이 다르다. π0가 하나의 attention 공간 안에서 두 expert를 섞는다면, GR00T N1은 VLM(System 2)과 Diffusion Transformer(System 1) 를 분리하고, DiT 블록의 cross-attention으로 VLM 토큰을 주입한다. DiT는 cross-attention과 self-attention 블록이 번갈아 쌓이고(Flamingo·VIMA 방식), self-attention은 노이즈 액션 토큰과 상태 임베딩만 다룬다. 임바디먼트마다 다른 상태·액션 차원은 임바디먼트별 MLP 인코더·디코더가 공통 차원으로 맞춘다. π0의 zero-padding과 대비되는 선택이다. 손실은 π0와 같은 형태( 방향으로 부호만 반대)이고 타임스텝 샘플링도 π0의 Beta 분포를 그대로 쓴다. 적분은 스텝이면 모든 임바디먼트에서 충분했다고 보고하며, 16스텝 청크 하나를 L40 GPU에서 bf16으로 63.9ms에 뽑는다. 논문은 System 2가 10Hz, System 1이 120Hz로 돈다고 설명한다.
📊 비교표
| OpenVLA | Octo-Base | π0 | π0-FAST | GR00T-N1-2B | |
|---|---|---|---|---|---|
| 백본 | Prismatic-7B (SigLIP+DinoV2, Llama 2 7B) | T5-base + CNN + 자체 트랜스포머 | PaliGemma 3B | PaliGemma 3B | Eagle-2 (SigLIP-2 + SmolLM2) |
| 파라미터 | 7B | 93M | 3.3B (expert 300M 포함) | 3B | 2.2B (VLM 1.34B) |
| 관측 | 이미지 1장 + 언어 | 멀티뷰, 히스토리, 목표 이미지 | 2~3뷰 + 언어 + | 2~3뷰 + 언어 + | 멀티뷰 + 언어 + |
| 액션 표현 | 256-bin 이산 토큰 | 연속 | 연속 | FAST(DCT+BPE) 토큰 | 연속 |
| 액션 헤드 | LLM 자기회귀 | readout + MLP diffusion(DDPM 20스텝) | action expert, flow matching 10스텝 | LLM 자기회귀 | DiT cross-attention, flow matching 4스텝 |
| 청크 | 1 (스텝당) | 청크(크기는 설정) | 50 | 1초 분량 | 16 |
| 추론 시간(논문) | 약 6Hz, RTX 4090 | – | 73ms, RTX 4090 | 약 750ms/청크, RTX 4090 | 63.9ms, L40 |
Octo의 청크 크기는 논문 본문에 하나의 수로 명시돼 있지 않아 "설정"으로 두었다. π0-FAST의 파라미터 수는 action expert가 없으므로 PaliGemma 3B로 적었다.
🔍 액션 청킹과 추론 주파수
청킹은 ACT가 대중화한 아이디어로, 한 번 추론에 미래 스텝을 뽑아 open-loop로 실행하는 것이다. 추론 횟수가 로 줄고, 저주파 추론으로 고주파 제어가 가능해지며, 행동이 매끄러워진다. 다섯 논문의 선택을 보면 다음과 같다.
- OpenVLA는 청킹이 없다. 그래서 6Hz 추론이 곧 6Hz 제어이고, 논문은 8비트 양자화 시 추론이 1.2Hz로 떨어지자 성능이 크게 하락한 것을 "느린 추론이 학습 데이터의 시스템 역학과 달라져서"라고 분석한다. 50Hz ALOHA 같은 고주파 세팅은 한계로 명시한다.
- Octo는 청킹이 움직임을 일관되게 만든다고 보고했고, temporal ensembling은 receding horizon 이상의 이득이 없었다고 적는다.
- π0는 청크를 뽑되 다 쓰지 않는다. 20Hz UR5e·Franka는 16스텝(0.8초)마다, 50Hz 로봇은 25스텝(0.5초)마다 다시 추론한다. temporal ensembling은 초기에 시도했으나 성능을 해쳐 버리고, 청크를 open-loop로 실행한다.
- GR00T N1은 이고, 접근 자체를 "System 2는 10Hz, System 1은 120Hz"로 설명한다. 4스텝 적분으로 63.9ms라는 수치가 이를 뒷받침한다.
- π0-FAST는 청킹 덕분에 750ms 지연도 정적 과제에서는 견뎠지만, 동적 과제에서는 문제가 될 것임을 저자들도 인정한다.
정리하면 자기회귀 헤드는 토큰 수가 곧 지연이고, FAST는 토큰 수를 10배 이상 줄여 그 지연을 "견딜 수 있는" 수준으로 만든 것이다. diffusion/flow 헤드는 백본 1회 + 작은 헤드 K회라서 지연이 K에 선형이고, K는 DDPM 20 → flow matching 10 → 4로 계속 줄고 있다. 어느 쪽이든 청킹 없이는 VLM 크기의 백본을 실시간 제어에 쓰기 어렵다. 실시간 추론과 비동기 실행은 6편에서 다시 다룬다.
⚠️ 한계와 주의
- 헤드 비교는 공정하기 어렵다. FAST 논문의 π0 vs π0-FAST는 같은 백본·데이터를 쓴 드문 정면 비교지만, 그조차 "성능 대등, 학습 5배 빠름, 추론 7배 느림"이라는 트레이드오프로 끝난다. 다른 논문 간 성공률 비교는 로봇·과제·평가 프로토콜이 달라 거의 의미가 없다.
- 관측 설계가 수치를 좌우한다. OpenVLA는 이미지 1장만 받고 상태를 안 넣는데, 이는 설계 선택이지 한계가 아닐 수 있다. 반대로 π0의 18차원 zero-padding과 GR00T의 임바디먼트별 MLP 중 어느 쪽이 더 나은지는 두 논문이 직접 비교하지 않았다.
- 수식 하나로 flow matching을 다 설명한 것은 아니다. π0와 GR00T N1은 모두 linear-Gaussian 경로와 오일러 적분만 쓴다. Beta 타임스텝 샘플링의 효과는 π0 논문에서 가설로 제시되었을 뿐 ablation 수치는 없다.
- 이 글의 수치는 모두 각 논문 본문·부록에서 가져왔다. 2026년 시점에는 π0.5, SmolVLA, GR00T N1.5 등 후속 모델이 세부 구성을 바꿨으므로 계보는 3편을 참고하길 바란다.
📚 참고
- Kim et al., OpenVLA: An Open-Source Vision-Language-Action Model, arXiv 2406.09246
- Octo Model Team, Octo: An Open-Source Generalist Robot Policy, arXiv 2405.12213
- Black et al., π0: A Vision-Language-Action Flow Model for General Robot Control, arXiv 2410.24164
- Pertsch et al., FAST: Efficient Action Tokenization for Vision-Language-Action Models, arXiv 2501.09747
- NVIDIA, GR00T N1: An Open Foundation Model for Generalist Humanoid Robots, arXiv 2503.14734
- Zhong et al., A Survey on Vision-Language-Action Models: An Action Tokenization Perspective, arXiv 2507.01925
- 시리즈: 1편 VLA란 무엇인가 · 3편 모델 계보
본 글의 그림은 각 논문/공식 블로그에서 가져왔습니다(출처: OpenVLA Fig. 2, π0 Fig. 3, FAST Fig. 4, Octo Fig. 1, GR00T N1 Fig. 3, 액션 토큰화 서베이 Fig. 1).