Genie 4: 소리와 실시간 편집을 얻은 월드 모델은 로봇 학습 데이터가 되는가
"Genie 4는 오디오를 네이티브로 생성하는 우리의 첫 실시간 월드 모델이다." — Google DeepMind 블로그, 2026년 10월 27일
2026년 10월 27일 Google DeepMind가 Genie 4를 공개했고, 다음 날 AI타임스가 "말하고 편집되는 월드 모델"로 보도했다. 공식 블로그(Raia Hadsell, Diego Rivas, Hang Qi 명의)는 Genie 4를 "더 큰 사실성과 더 나은 실시간 인터랙티브 시뮬레이션"을 제공하는 월드 모델로 소개하고, 월드 시뮬레이션이 AGI로 가는 핵심 단계이며 로봇과 에이전트의 학습 환경을 만들 수 있다고 적었다. 이 글의 질문은 그 마지막 문장이다. 월드 모델이 로봇 학습 데이터가 되는가. 먼저 공식 자료로 확인되는 것과 안 되는 것을 가르고, 이 블로그에서 다룬 H-JEPA와 VLA 데이터 편에 비추어 그 주장을 뜯어본다.
미리 적어 두면, Genie 4에는 기술 보고서도 모델 카드도 논문도 없다. 1차 출처는 DeepMind 블로그와 모델 페이지뿐이고, 둘 다 해상도·프레임레이트·지연·파라미터·학습 데이터를 적지 않는다. 그래서 이 글의 숫자 대부분은 Genie 3(2025년 8월)과 Genie 1 논문(ICML 2024)에서 온다.
원문: Genie 4: A new generation of world simulation · 모델 페이지
🤔 Genie 3에서 Genie 4로: 공식적으로 더해진 것
Genie 3 블로그(2025년 8월 5일)는 수치를 적었다. 720p, 24fps, 수 분(a few minutes) 동안 일관성을 유지하는 실시간 탐색, 그리고 1분 전까지의 시각 기억. 텍스트로 날씨를 바꾸거나 물체를 넣는 promptable world events도 이미 Genie 3에 있었다. 아래는 그 글에 실린 공식 비교표다.
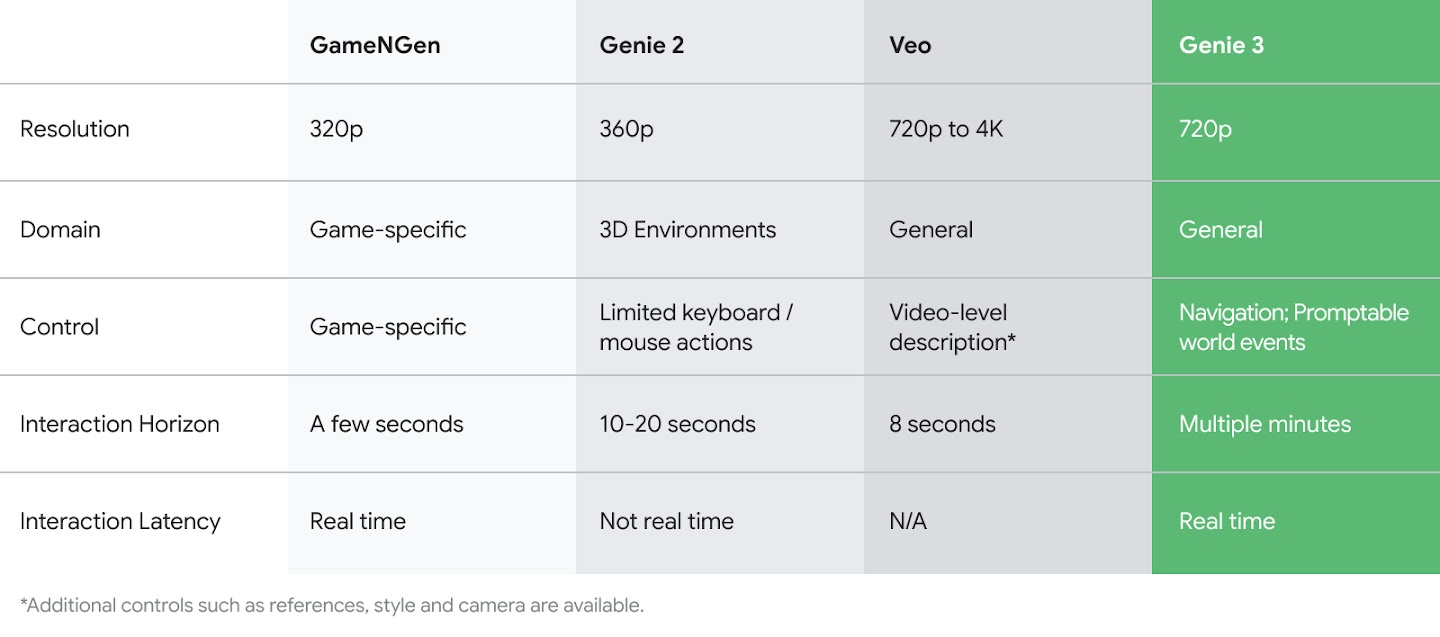
Genie 4 블로그와 모델 페이지가 새로 명시한 것은 네 가지다.
- 네이티브 오디오. 환경음, 음악, 그리고 캐릭터와 주고받는 대화가 영상과 함께 생성된다. 모델 페이지는 "발밑의 낙엽 소리, 군중의 환호, 사용자나 서로에게 말하는 캐릭터"를 예로 든다. 후처리가 아니라 모델이 직접 내놓는다는 것이 "네이티브"의 뜻이다.
- 실시간 자연어 조종(steering). 시뮬레이션이 돌아가는 중에 날씨, 카메라 위치, 사람·물체 추가를 텍스트로 지시한다. Genie 3의 world events와 비슷해 보이지만, 블로그는 Gemini가 프롬프트를 현재 장면에 맞게 고쳐 쓰고 입력 사이에도 세계를 계속 진행시킨다고 설명한다.
- 물리와 사람 동작. 공기역학·충돌 같은 시나리오와 주변에 반응하는 캐릭터 동작을 든다. 정량 지표는 없다.
- Gemini 결합. Gemini Omni가 "실세계의 외양과 행동"에 시뮬레이션을 고정하고, 다른 Gemini 모델이 일관성·연속성을 위한 추론을 맡는다. Gemini 3.8 Flash는 가이드 에이전트로 장면을 관찰하고 목표를 단계로 쪼개 각 단계의 성공을 검증하며, 세계가 바뀌거나 사용자가 개입하면 다시 계획한다.
네 번째 항목이 Genie 3와 가장 다른 지점이다. Genie 3는 텍스트와 키보드 입력이 모델에 직접 들어가는 단일 모델이었다. Genie 4 블로그의 서술은 두 층이다. 아래층의 Genie 4가 프레임과 소리를 만들고, 위층의 Gemini가 사용자의 말을 장면에 맞게 번역하거나(조종), 목표를 단계로 쪼개 진행을 감시한다(가이드 에이전트). "복잡한 인과와 여러 단계의 행동을 시간에 걸쳐 일관되게" 유지한다는 설명은 아래층이 아니라 이 위층의 몫이다. 바꿔 말하면 Genie 4의 "일관성"에는 픽셀 모델의 기억뿐 아니라 언어 모델의 계획이 섞여 있고, 둘의 기여를 따로 잰 수치는 없다. TechCrunch 브리핑에서 Tejas Kulkarni가 말한 "하이브리드 월드 모델", 즉 Gemini가 쓴 코드와 텍스트를 Genie가 실시간으로 받아들이는 구조는 이 두 층을 앞으로 더 붙이겠다는 뜻으로 읽힌다.
정리하면 다음과 같다. "공식"은 DeepMind 블로그·모델 페이지, "미공개"는 두 자료 어디에도 없다는 뜻이다.
| 항목 | Genie 3 (공식) | Genie 4 (공식) |
|---|---|---|
| 해상도 | 720p | 미공개 |
| 프레임레이트 | 24fps | 미공개 |
| 지속 시간 | 수 분 | "수 분의 연속 인터랙션, 장시간 세션은 아님" |
| 기억 | 약 1분 전까지 | 미공개 (한계 항목에 "드리프트" 언급) |
| 오디오 | 없음 | 네이티브 생성 (환경음·음악·대화) |
| 편집 | promptable world events | Gemini가 해석하는 실시간 자연어 조종 |
| 입력 | 텍스트, 키보드 | 텍스트, 키보드·마우스 |
| 파라미터·학습 데이터 | 미공개 | 미공개 |
| 기술 보고서 | 없음 | 없음 |
TechCrunch는 Genie 4가 "최대 2분, 전작의 두 배" 동안 일관성을 유지한다고 썼고 AI타임스도 이를 인용했다. 그런데 이 문장은 DeepMind 발언으로 귀속되어 있지 않고, 공식 자료는 "수 분"이라고만 적으며 Genie 3도 "수 분"이었다. 두 배라는 비교는 출처가 확인되지 않는 수치다. 위키백과의 "30fps"와 "110억 파라미터"도 마찬가지인데, 110억은 Genie 1 논문의 숫자다.
🧠 원리: Genie 계보가 공개한 구조
Genie 4의 내부는 공개되지 않았으므로, 구조를 이해하려면 공개된 유일한 설계인 Genie 1 논문(Bruce et al., ICML 2024, arXiv 2402.15391)으로 돌아가야 한다. 11B 파라미터 모델을 행동 라벨이 없는 인터넷 영상으로 학습했고, 세 부분으로 이루어진다.
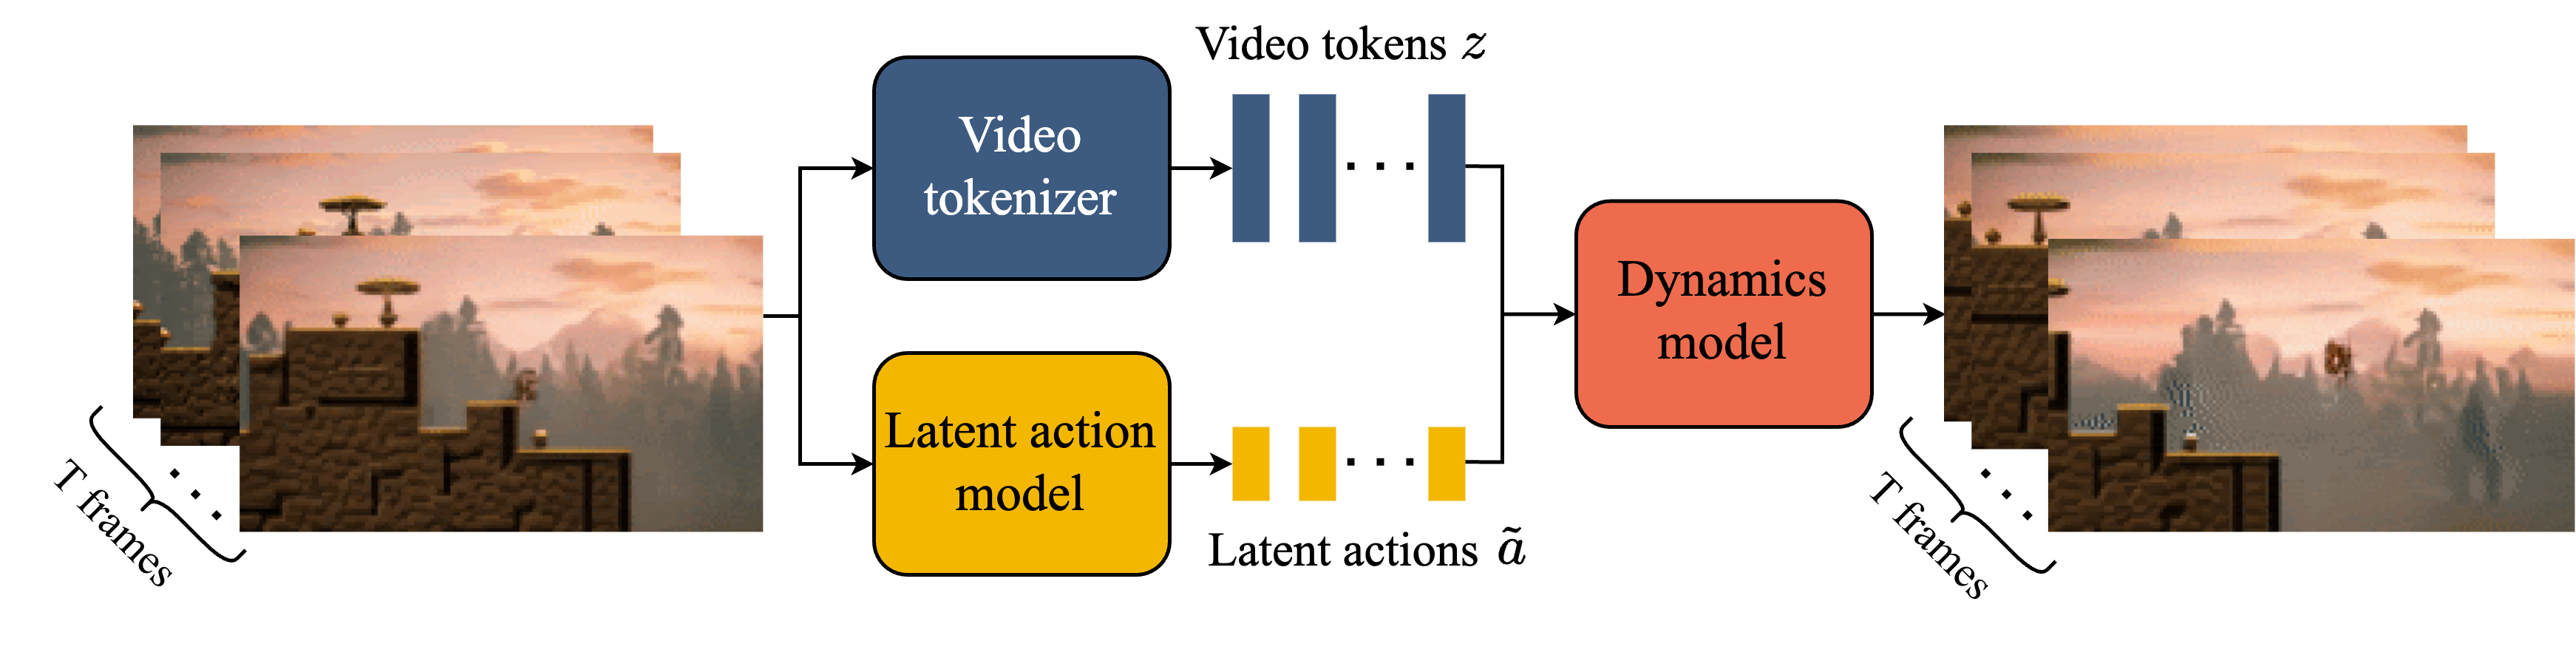
- 비디오 토크나이저: 프레임을 이산 토큰 로 압축하는 VQ-VAE.
- 잠재 행동 모델(LAM): 연속한 두 프레임 사이에 "무슨 행동이 있었는지"를 라벨 없이 추론해 작은 이산 코드 로 만든다. 행동 라벨이 없는 영상으로 제어 가능한 모델을 만드는 핵심이다.
- 동역학 모델: 토큰과 잠재 행동을 받아 다음 프레임 토큰을 예측한다.
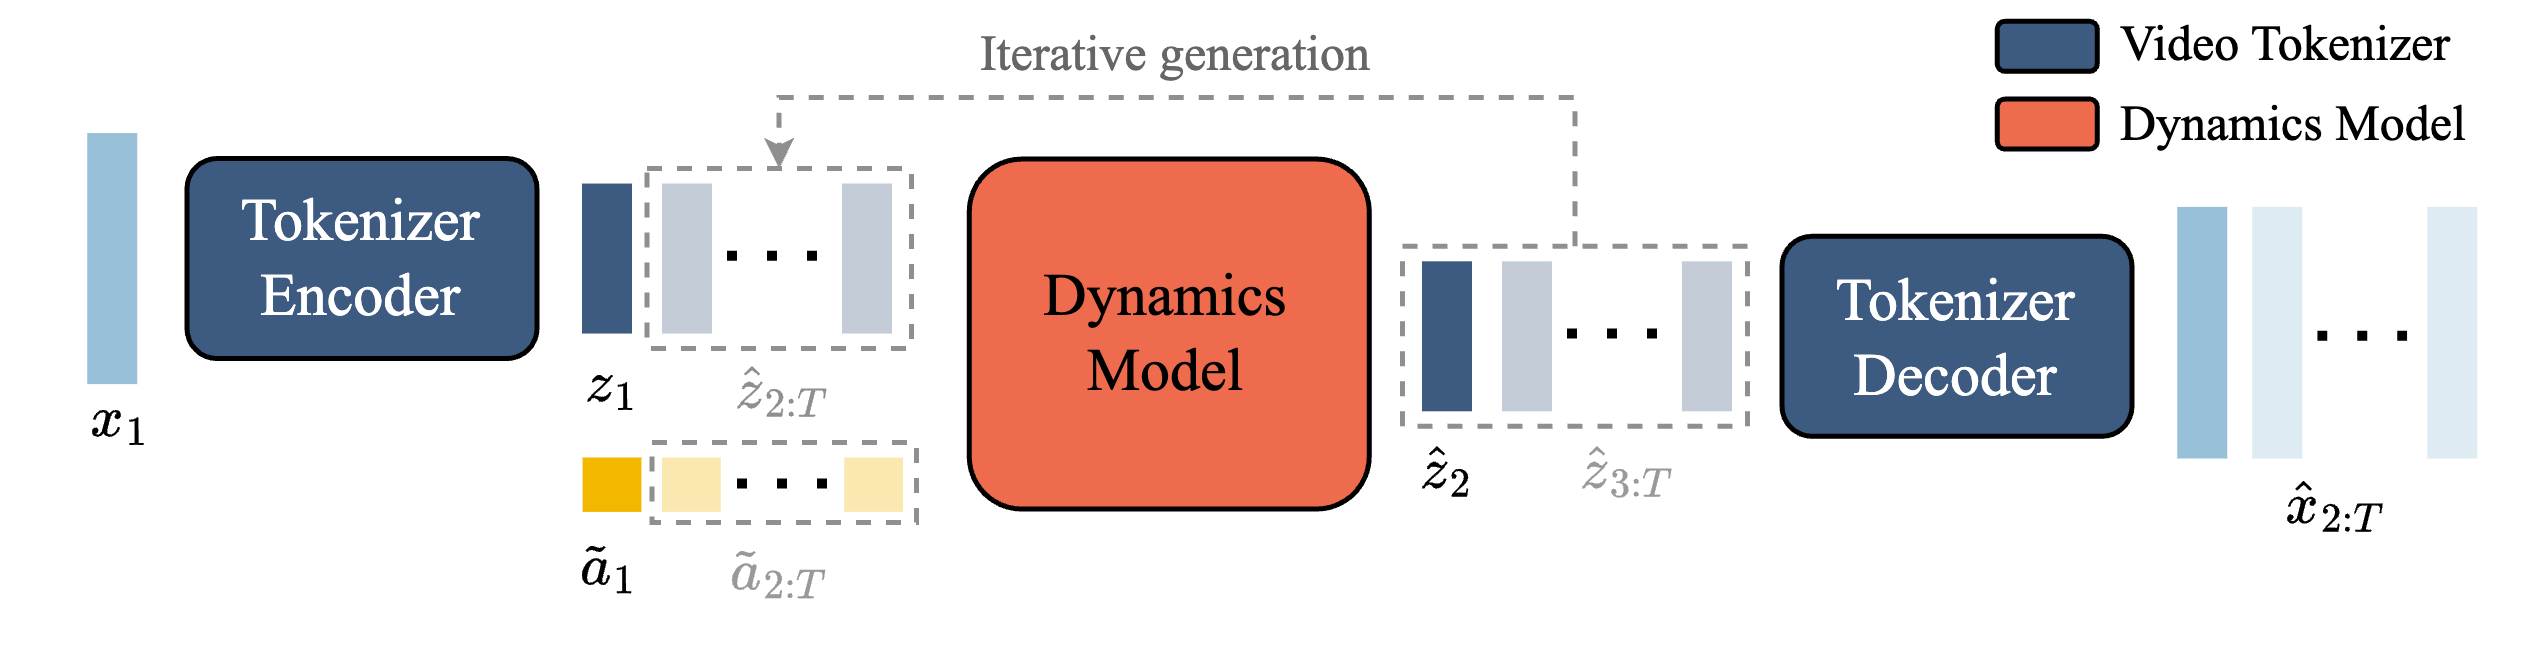
추론은 프레임 하나와 사용자 행동으로 시작해 다음 프레임을 자기회귀로 계속 만드는 루프다. Genie 3 블로그가 "NeRF나 Gaussian Splatting 같은 명시적 3D 표현 없이 프레임 단위로 생성하며, 일관성은 창발적(emergent)"이라고 적은 것과 같은 그림이다. 이 구조가 Genie 4까지 유지되는지는 확인할 수 없다. 블로그가 Gemini Omni를 언급하는 것을 보면 Gemini 계열의 멀티모달 능력이 어떤 식으로든 들어갔다고 보이지만, 그 이상은 추측이다.
여기서 H-JEPA와의 차이가 분명해진다. 두 쪽 다 "월드 모델"이지만 예측 대상이 다르다. Genie는 픽셀(정확히는 픽셀 토큰)을 되살리는 생성 모델이고, JEPA 계열은 잠재 공간에서 다음 상태의 임베딩만 예측하며 예측 불가능한 세부는 버린다. 그래서 H-JEPA는 사람이 볼 영상을 만들지 않는 대신 그 잠재 공간에서 바로 행동 시퀀스를 최적화해 계획(planning)을 한다. Genie 4는 사람이 보고 듣는 환경을 만들고, 계획은 바깥의 Gemini가 한다. 하나는 로봇 머릿속의 시뮬레이터이고 다른 하나는 로봇을 둘러싼 시뮬레이터다.
이 차이는 장단점을 맞바꾼다. H-JEPA 글에서 보았듯 잠재 예측 모델은 DROID처럼 장면이 에피소드마다 바뀌는 데이터에서 "행동이 있어야만 예측되는 로봇 팔"을 버리고 변하지 않는 장면 정체성만 남기는 slow-feature collapse에 빠질 수 있어, 그걸 막는 손실 설계가 논문의 절반을 차지했다. 픽셀을 전부 되살리는 Genie 계열은 이 붕괴를 구조적으로 피한다. 모든 것을 그려야 하니 무엇도 버릴 수 없다. 대신 그 대가로 사람에게 보여 줄 필요가 없는 세부(나뭇잎의 흔들림, 조명의 미세한 변화)까지 매 프레임 계산하고, 계획은 밖에서 해야 한다. Genie 3 블로그가 실시간 상호작용을 위해 "초당 여러 번" 계산이 일어나야 한다고 적은 것도 이 비용 때문이다. 로봇 학습의 관점에서 어느 쪽이 유리한가는 아직 열린 문제이고, 두 계열이 같은 벤치마크에서 비교된 적은 없다.
🤖 월드 모델이 로봇 학습 데이터가 되는가
블로그의 로보틱스 예시는 이렇다. Gemini 4 Argon이 과제를 단계로 나누고, 각 단계가 텍스트 캡션으로 Genie 4에 전달되어 장면이 렌더링된다. 데모는 Apptronik의 휴머노이드 Apollo가 체커를 두는 장면이다. 블로그는 이것을 Gemini Robotics 작업과 연결하고, 시뮬레이션 시나리오를 테스트하는 능력이 좋아진다고 쓴다. 중요한 건 블로그가 "Genie 4로 로봇을 학습시켰다"고는 어디에도 쓰지 않았다는 점이다. 모델 페이지의 에이전트 학습 언급도 SIMA 같은 게임 에이전트가 새 기술을 배우는 데 쓸 수 있다는 수준이다.
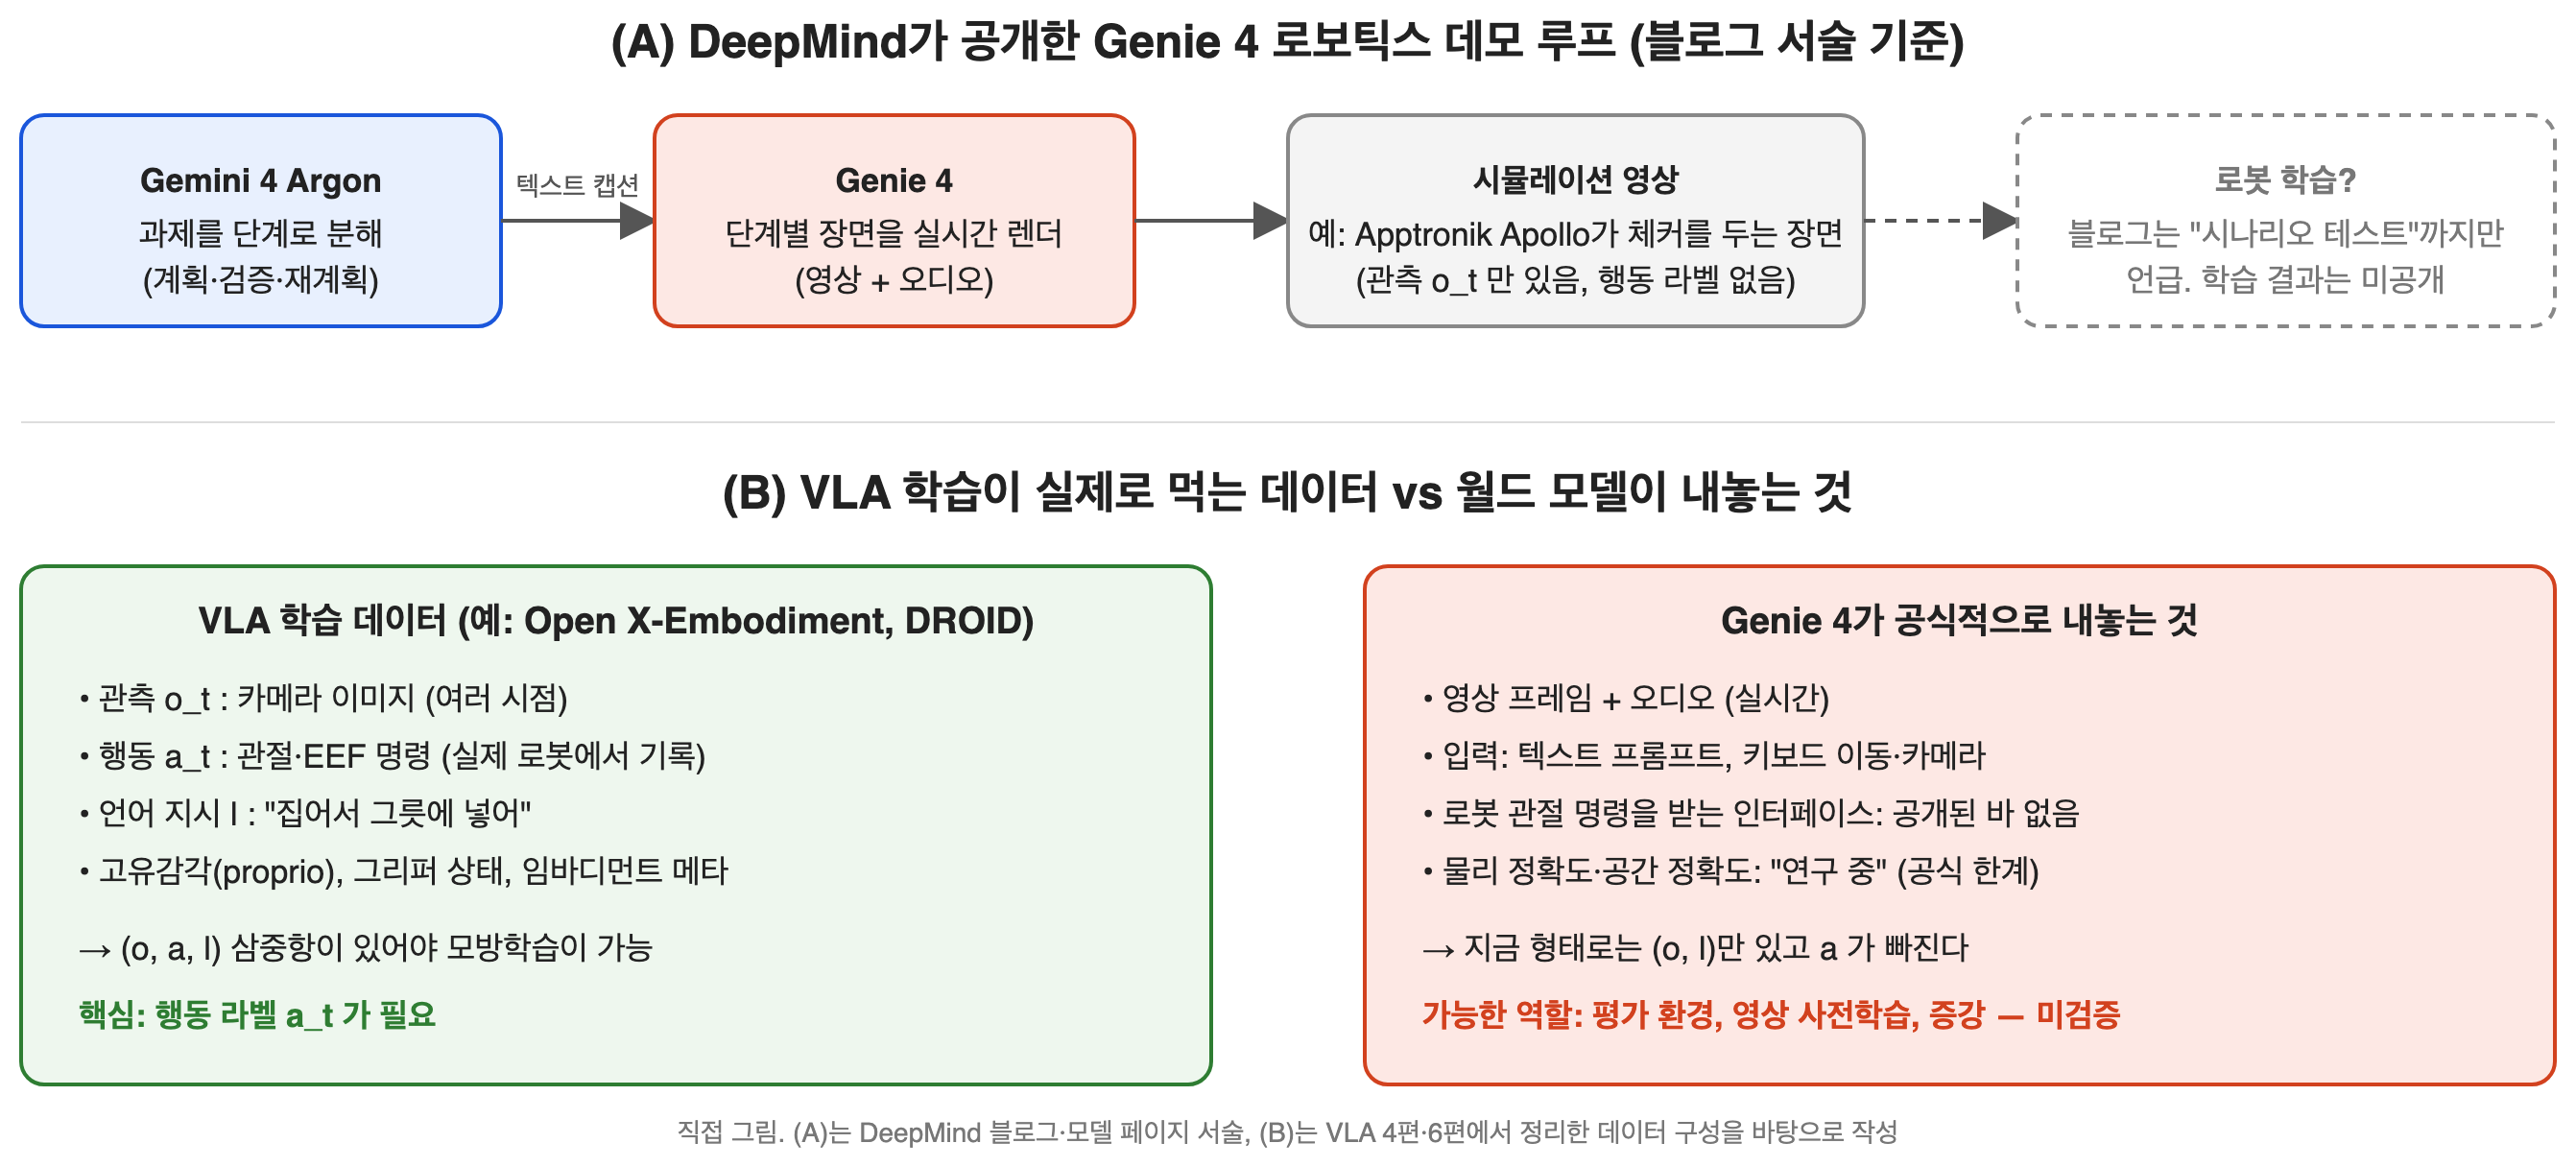
VLA 4편에서 정리했듯 VLA가 먹는 데이터는 (관측, 행동, 언어 지시) 삼중항이다. Open X-Embodiment와 DROID의 가치는 영상이 아니라 그 영상에 붙은 로봇 관절·엔드이펙터 명령에 있다. Genie 4가 공식적으로 받는 입력은 텍스트 프롬프트와 키보드·마우스이고, 내놓는 것은 영상과 오디오다. 로봇 관절 명령을 받는 인터페이스는 공개된 바 없고, Genie 3 블로그는 "에이전트가 직접 수행할 수 있는 행동의 범위가 제한된다"는 것을 한계로 명시했다. 즉 지금 형태의 Genie 4는 (관측, 언어)는 주지만 행동 라벨은 주지 않는다.
그렇다고 쓸모가 없다는 건 아니다. 세 가지 역할이 현실적이다.
- 평가 환경. 실로봇 없이 정책을 돌려 보는 용도인데, 4편에서 짚었듯 시뮬레이션 점수가 실로봇 순위를 보장하려면 SimplerEnv처럼 real-to-sim 상관이 검증되어야 한다. Genie 4는 모델 페이지가 "복잡한 물리 상호작용과 공간 정확도는 연구 중"이라고 적은 상태라 그 검증이 아직 없다.
- 영상 사전학습·증강. GR00T N1이 비디오 생성 모델로 실로봇 데이터를 88시간에서 827시간으로 늘린 "neural trajectory"처럼, 생성 영상이 데이터 피라미드의 중간층이 되는 선례는 있다. 다만 거기서는 실로봇 궤적을 출발점으로 삼아 행동 라벨을 유지했다. Genie 4가 그 역할을 하려면 로봇 행동으로 조건화할 수 있어야 하는데, 공개된 바 없다.
- 고수준 계획 검증. Argon 데모가 실제로 보여준 것이 이것이다. 언어 모델이 세운 단계가 장면에서 그럴듯하게 이어지는지를 눈으로 확인하는 용도이며, 저수준 제어 학습과는 다른 층이다.
VLA 6편의 결론과 맞물린다. 그 글에서 Gemini Robotics 2는 고수준 플래너(ER 2)와 VLA를 분리했고, 공개 수치 대부분이 벤더 발표였다. Genie 4의 로보틱스 이야기도 같은 구조다. Gemini가 계획하고 Genie가 보여 주는 조합은 플래너 쪽에 걸려 있고, 그 결과로 로봇 정책이 좋아졌다는 수치는 없다. DeepMind의 Tejas Kulkarni가 브리핑에서 말한 "하이브리드 월드 모델"(Gemini가 구조와 서사를, Genie가 외양과 소리를 맡는 결합)도 방향 제시이지 결과 보고가 아니다.
🛠️ DeepMind가 말하는 용도와 안전장치
블로그가 로보틱스 외에 든 용도는 창작 쪽이 더 많다. 영상 제작의 사전 시각화(pre-visualization)와 여러 테이크를 빠르게 돌려 보는 "드래프트 모드", 오래된 사진 한 장을 탐색 가능한 환경으로 바꾸는 것, 홍수·산불 같은 사건을 시각화하는 저널리즘 용도, 게임·인터랙티브 디자인에서 컨셉을 바로 탐색 가능한 프로토타입으로 만드는 것, 기업의 "zero-to-one" 시나리오 생성이다. 블로그의 예시 프롬프트 열세 개 중 로봇은 둘(UR5 팔이 실험실 플레이트에 액체를 떨어뜨리는 장면, Apollo 체커)뿐이고 나머지는 안개 낀 호수의 색소폰 연주자, 남극 상공의 열기구, 1980년대 일본 시골 역 같은 창작 장면이다. DeepMind의 Diego Rivas는 브리핑에서 실시간성의 가치가 "몰입 상태(flow)를 유지해야 하는" 아이디어 구상과 스토리보드 작업에서 가장 크다고 말했다. 즉 1차 자료가 보여 주는 무게 중심은 로봇이 아니라 창작 도구다.
안전장치는 세 가지가 적혀 있다. 다른 모델과 같은 정책에 따른 가드레일, 프리뷰 전 유해·악의적 콘텐츠를 막기 위한 내부 안전 평가, 그리고 생성된 모든 영상과 오디오에 SynthID 워터마크를 넣는다는 것이다. 평가의 내용이나 결과 수치는 없다. 모델 페이지의 면책 문구도 읽어 둘 만하다. 공개된 녹화는 실시간 상호작용이지만 "결과는 예시이며 시퀀스는 짧게 편집되었다"고 적혀 있다. 블로그의 데모 영상을 성능의 증거로 읽을 때 염두에 둘 부분이다.
📋 공개된 것과 공개되지 않은 것
| 구분 | 내용 | 출처 |
|---|---|---|
| 공개 | 날짜(2026-10-27), 저자, 네이티브 오디오, 실시간 조종, Gemini Omni·3.8 Flash·4 Argon 결합 | DeepMind 블로그 |
| 공개 | 한계 6항목, 지속 시간 "수 분", SynthID 워터마크, 내부 안전 평가 | 모델 페이지 |
| 공개 | 가용성: 신뢰 테스터 리서치 프리뷰 → AI Ultra 구독자(Project Genie) → Gemini API·AI Studio 얼리 액세스 파트너, 대기자 명단 | 블로그·모델 페이지 |
| 미공개 | 해상도, fps, 지연, 파라미터, 아키텍처, 학습 데이터, 벤치마크, 가격 | — |
| 미공개 | 로봇 학습에 쓴 결과, 행동 조건화 인터페이스 | — |
| 외부 보도 | "최대 2분, 전작의 2배" | TechCrunch, 귀속 없음 |
가용성 일정은 "coming soon"과 "over the coming weeks"뿐이고 날짜는 없다. 2026년 1월의 Project Genie(Genie 3 기반)가 AI Ultra 구독자에게 열렸던 전례를 보면 같은 경로가 될 것으로 보인다.
⚠️ 한계와 주의
모델 페이지가 스스로 적은 한계를 그대로 옮긴다.
- 일관성 드리프트. 긴 세션, 여러 번의 프롬프트 편집, 이동 중에 시각적 세부와 물체 영속성(object permanence)이 흐트러진다. Genie 3의 "1분 기억"이 개선되었는지는 적혀 있지 않다.
- 다중 에이전트. 사용자·여러 에이전트·공유 환경 간의 복잡한 상호작용은 열린 문제다.
- 실세계 정확도. 실제 장소를 완벽히 재현하지 못한다.
- 텍스트. 읽을 수 있는 글자는 입력 설명에 있을 때만 대체로 나온다.
- 세션 길이. 수 분이지 장시간이 아니다.
- 오디오 정확도. 실시간 오디오의 정확도를 개선 중이다.
여기에 독자 입장에서 더할 것이 있다. 첫째, 비교할 숫자가 없다. Genie 3는 720p/24fps를 적었는데 Genie 4는 적지 않았다. 더 좋아졌으면 적었을 것이라고 추측할 수도 있지만 추측일 뿐이다. 둘째, "물리가 좋아졌다"는 벤더 주장이다. 공기역학과 충돌을 예로 들지만 측정치가 없고, 로봇 시뮬레이터로 쓰려면 바로 그 물리가 정량적으로 맞아야 한다. 셋째, 실시간이라는 말에는 계산 비용이 숨어 있다. 신뢰 테스터에게만 열려 있고 가격이 없는 상태에서, 수백만 에피소드를 돌리는 로봇 학습의 비용 구조에 맞는지는 알 수 없다. 넷째, Runway의 GWM Worlds 2처럼 실시간 영상·오디오·편집을 내세운 경쟁 모델이 이미 있으므로, 오디오와 편집 자체는 Genie 4만의 것이 아니다. 차별점은 Gemini와의 결합인데, 그 결합의 효과를 잴 벤치마크가 아직 없다.
결론은 제목의 질문으로 돌아간다. Genie 4는 사람이 보고 듣고 고치는 시뮬레이터로서는 Genie 3보다 분명히 한 걸음 나아갔다. 그러나 로봇 학습 데이터가 되려면 행동 조건화, 물리 검증, 비용, 그리고 학습 결과 공개가 필요하고, 그중 하나도 아직 공식 자료에 없다. 지금은 "로봇 학습 환경이 될 수 있다"는 벤더의 방향 제시로 읽는 것이 정확하다.
📚 참고
- Google DeepMind, Genie 4: A new generation of world simulation (2026-10-27) — deepmind.google
- Google DeepMind, Genie 모델 페이지 (한계·가용성·안전) — deepmind.google/models/genie
- Google, Introducing Genie 4 (2026-10-27) — blog.google
- Google DeepMind, Genie 3: A new frontier for world models (2025-08-05) — deepmind.google
- Bruce et al., Genie: Generative Interactive Environments (ICML 2024) — arXiv:2402.15391
- TechCrunch, Google's Genie 4 world model adds audio, more realistic worlds, and real-time steering (2026-10-27) — techcrunch.com
- AI타임스, 구글 딥마인드 Genie 4 보도 (2026-10-28) — aitimes.com
- 관련 글: H-JEPA · VLA 4편 데이터 · VLA 6편 배포와 전망
그림 출처: fig1은 Google 블로그의 Genie 4 공식 영상 썸네일, fig2는 DeepMind Genie 3 블로그의 비교표, fig3·fig4는 Genie 1 논문(arXiv 2402.15391) Figure 2·7, fig5는 공식 서술을 바탕으로 직접 그렸다.