VLA 4편 — 데이터: Open X-Embodiment부터 크로스 임바디먼트와 스케일링까지
"RT-1-X는 데이터가 적은 도메인에서 원래 방법보다 평균 50% 높은 성공률을 보였지만, 데이터가 많은 도메인에서는 오히려 underfit했다." — Open X-Embodiment (2023)
이 글은 VLA 시리즈 4편이다. 3편에서 RT-2부터 π0.5, GR00T N1까지 모델 계보를 훑었다면, 이번에는 그 모델들이 무엇을 먹고 자랐는지를 본다. LLM이 Common Crawl 위에서 태어났다면 VLA는 어떤 데이터 위에서 태어나는가, 로봇이 다르면 데이터를 섞는 게 왜 어려운가, 그리고 "데이터를 더 모으면 성능이 오른다"는 말이 로봇에서도 성립하는가를 1차 출처 수치로 정리한다. 다음 5편에서는 여기서 설명한 LeRobot 포맷으로 직접 파인튜닝을 돌린다.
🤔 왜 데이터가 문제인가
LLM은 인터넷이라는 공짜 코퍼스가 있었다. 로봇은 없다. 로봇 데이터 한 에피소드는 사람이 텔레오퍼레이션 장치를 잡고 실제 팔을 움직여야 생기고, 그 결과물은 특정 로봇·특정 카메라 배치·특정 제어 주파수에 묶여 있다. 그래서 VLA의 데이터 문제는 세 겹이다.
- 양: 가장 큰 공개 데이터셋도 수백 시간 단위다. 텍스트 코퍼스의 조 단위 토큰과 비교하면 수십 배가 아니라 수십만 배 차이다.
- 이질성: 로봇마다 액션 공간(관절 vs 엔드이펙터, 7D vs 14D), 카메라 수와 위치, 제어 주파수(5 Hz부터 50 Hz까지)가 다르다. 이걸 한 모델에 넣으려면 "공통 언어"가 필요하다.
- 다양성: 같은 실험실 테이블에서 1만 에피소드를 찍는 것과 100개 집에서 1만 에피소드를 찍는 것은 전혀 다른 데이터다. 뒤에서 보겠지만 일반화에 중요한 건 후자다.
이 세 문제에 대한 답이 각각 크로스 임바디먼트 데이터셋(OXE), "in-the-wild" 데이터셋(DROID), co-training 믹스처(π0.5, GR00T N1)다.
📚 공개 실로봇 데이터셋 세 개
Open X-Embodiment (OXE, 2023)
Google DeepMind가 주도해 21개 기관, 60개 기존 데이터셋을 하나의 포맷으로 합친 프로젝트다. 22종의 로봇 임바디먼트, 100만 개 이상의 실로봇 궤적, 527개 스킬(160,266개 태스크)을 담고 있다. 데이터는 RLDS 포맷(직렬화된 tfrecord)으로 배포된다.
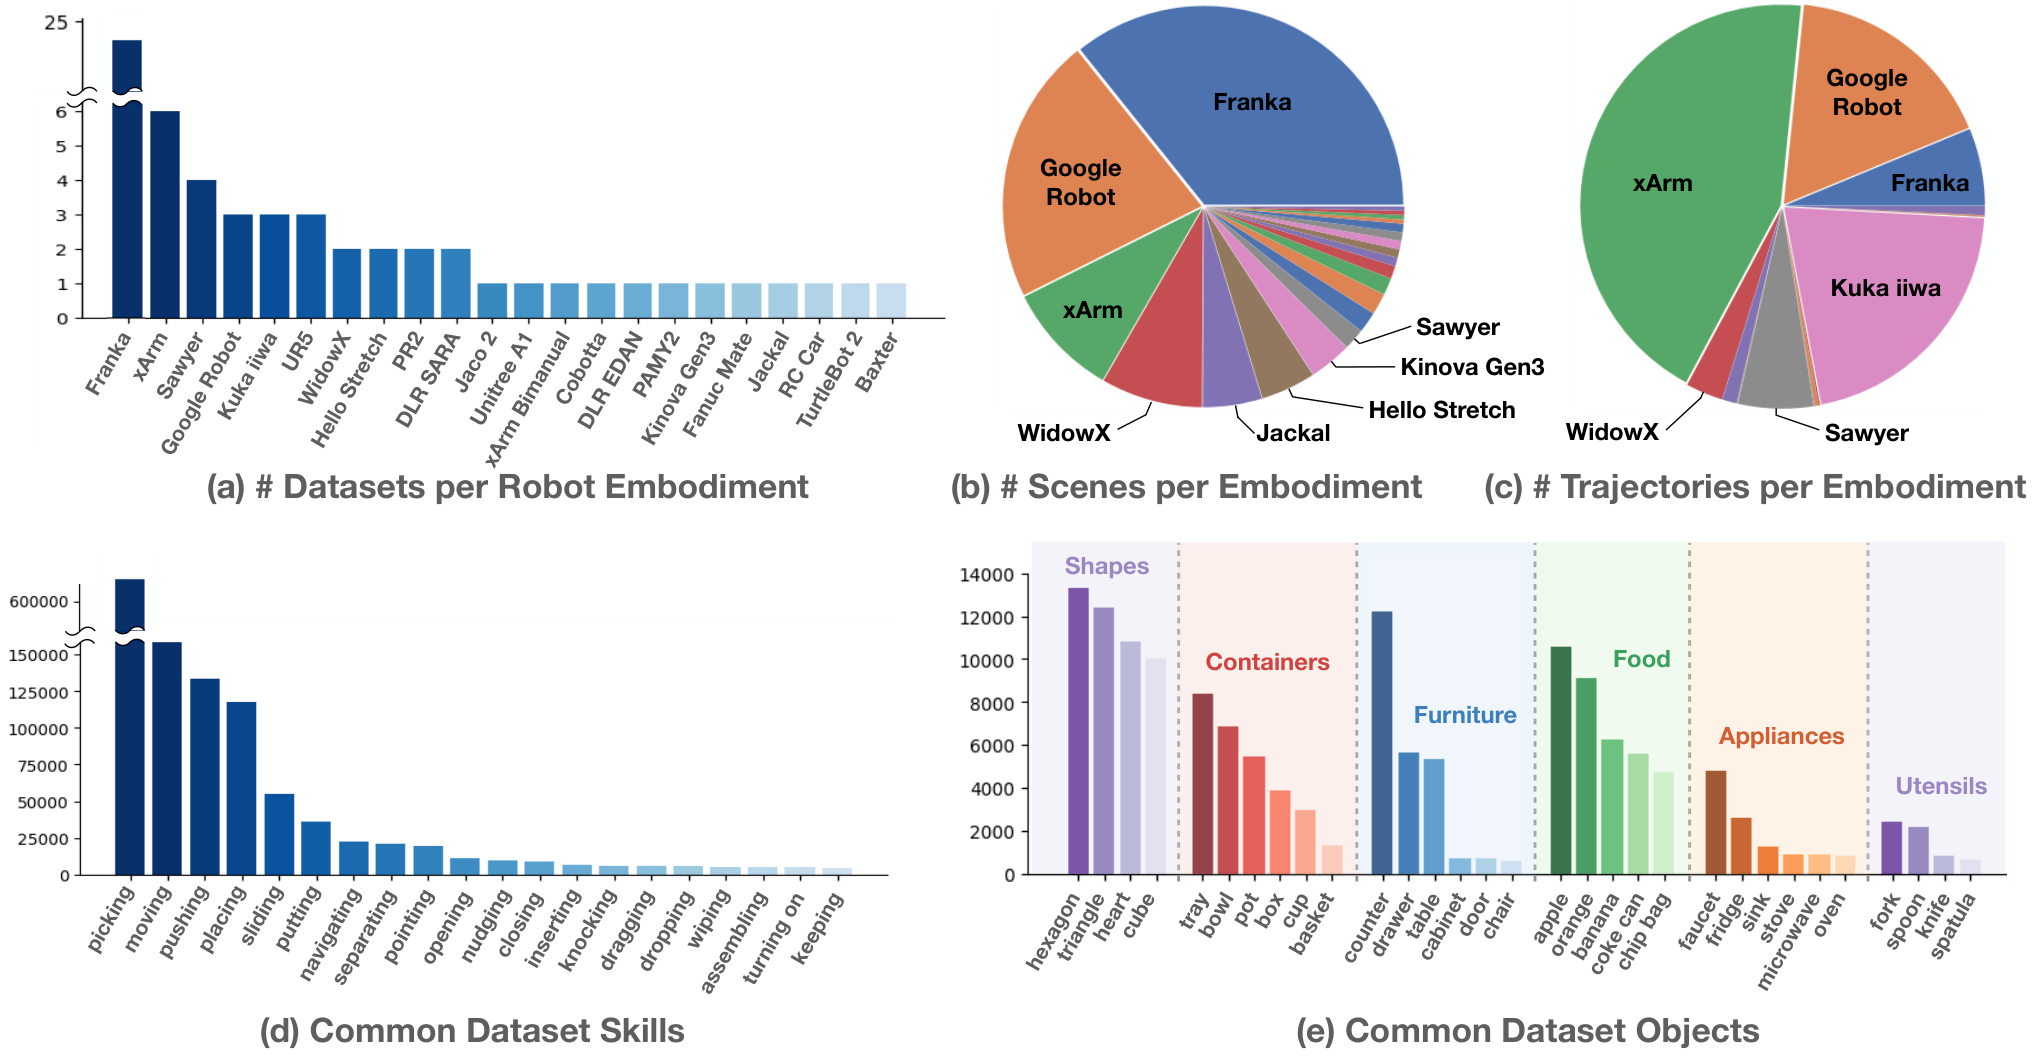
그림에서 눈여겨볼 점은 불균형이다. 데이터셋 수는 Franka가 압도적인데 궤적 수는 xArm과 Kuka iiwa가 많다. 스킬도 picking·moving·pushing·placing 네 개가 대부분이고 나머지는 롱테일이다. "22종 로봇"이라는 숫자만 보면 고르게 섞인 것 같지만 실제 분포는 심하게 쏠려 있다.
OXE가 이질적인 로봇을 한 모델에 넣기 위해 쓴 방법은 단순하다. 모든 로봇의 액션을 7차원 엔드이펙터 델타(x, y, z, roll, pitch, yaw, gripper)로 통일하고, 데이터셋별로 정규화한 뒤 각 차원을 256개 bin으로 이산화한다. 관측은 데이터셋마다 대표 카메라 뷰 하나만 고른다. 논문 스스로 좌표계는 정렬하지 않았다고 명시한다. 즉 같은 액션 벡터가 로봇마다 다른 움직임을 뜻할 수 있는데도 모델이 알아서 맥락(이미지)으로 구분하기를 기대한 것이다.
결과는 긍정적 전이의 첫 증거였다. RT-1-X는 데이터가 적은 5개 도메인 중 4개에서 원래 방법을 이겼고 평균 성공률은 50% 높았다. 반면 Bridge나 RT-1처럼 데이터가 많은 도메인에서는 RT-1-X가 underfit해서 단일 도메인 모델보다 못했다. 55B 규모의 RT-2-X는 Google Robot에서 Bridge에만 있던 스킬(emergent skill)을 27.3%에서 75.8%로 약 3배 끌어올렸다. 다만 미지 물체·환경에 대한 일반화는 RT-2와 RT-2-X가 "대체로 비슷"했다. 크로스 임바디먼트 데이터는 새 스킬을 옮기는 데는 효과가 있었지만 모델 용량이 작으면 큰 데이터셋을 소화하지 못한다는 교훈이 여기서 나왔다.
DROID (2024)
OXE가 "있는 데이터를 모으기"였다면 DROID는 처음부터 다양성을 목표로 새로 찍은 데이터셋이다. 13개 기관, 50명의 수집자가 북미·아시아·유럽의 52개 건물에서 12개월간 모았다. 76k개 궤적, 약 350시간, 564개 장면, 84개 태스크다.
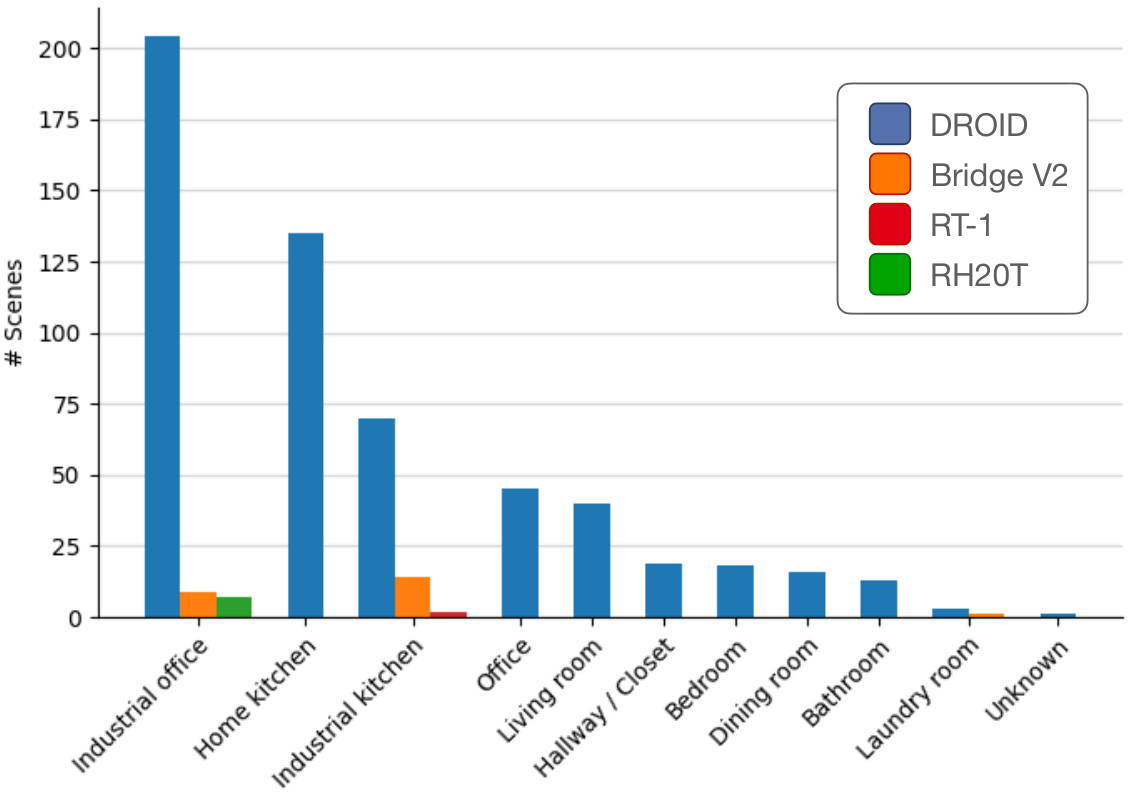
하드웨어는 모든 기관이 동일하게 맞췄다. Franka Panda 7DoF 팔 + Robotiq 2F-85 그리퍼를 높이 조절되는 바퀴 달린 책상에 올리고, 외부 Zed 2 스테레오 카메라 2대 + 손목 Zed Mini 1대, 제어 주파수 15 Hz, Meta Quest 2 컨트롤러로 텔레오퍼레이션했다. 카메라 위치를 에피소드마다 바꿔서 총 1,417개의 3인칭 시점이 캘리브레이션 정보와 함께 들어 있다.
효과는 수치로 나왔다. DROID와 co-training한 정책은 차선책 대비 in-distribution에서 22%p, OOD에서 17%p 높은 성공률을 보였다. 더 중요한 실험은 같은 7,362개 궤적을 20개 장면에서만 뽑은 부분집합 vs 다양한 장면에서 뽑은 부분집합 비교다. 후자가 OOD에서 더 좋았다. 저자들의 결론은 "DROID의 강점은 크기에, 특히 다양성에 있다"는 것이다.
BridgeData V2 (2023)
Berkeley의 저가 로봇 WidowX 250 기반 데이터셋이다. 60,096개 궤적(텔레오퍼레이션 50,365개 + 스크립트 정책 9,731개), 24개 환경, 13개 스킬. 카메라는 고정 over-the-shoulder RGB-D 1대, 위치를 랜덤화한 RGB 2대, 손목 RGB 1대로 총 4개 뷰이고 제어 주파수는 5 Hz다. 규모는 DROID보다 작지만 "저가 로봇 + 공개 데이터"라는 조합 덕에 OpenVLA, Octo, SimplerEnv 등 거의 모든 연구가 Bridge를 벤치마크로 쓴다. 논문의 스케일링 분석도 모델 용량과 데이터 양을 키울수록 goal-conditioned BC 성능이 올라간다는 결과를 보여준다.
비교표
| OXE (2023) | BridgeData V2 (2023) | DROID (2024) | |
|---|---|---|---|
| 성격 | 60개 기존 데이터셋 통합 | 단일 저가 로봇 | 다기관 신규 수집 |
| 로봇 | 22종 | WidowX 250 | Franka Panda |
| 궤적 | 1M+ | 60,096 | 76k (약 350시간) |
| 장면/환경 | 데이터셋별 상이 | 24 환경 | 564 장면, 52 건물 |
| 제어 주파수 | 데이터셋별 상이 | 5 Hz | 15 Hz |
| 카메라 | 대표 뷰 1개 선택 | 4 (RGB-D 1 + RGB 3) | 3 (스테레오, 손목 포함) |
| 포맷 | RLDS (tfrecord) | 자체 → RLDS/LeRobot 변환본 존재 | RLDS → LeRobot 변환본 존재 |
🛠️ LeRobot 데이터셋 포맷 (v3)
위 데이터셋들은 원래 포맷이 제각각이지만, 2025년 이후 커뮤니티 표준은 Hugging Face LeRobotDataset으로 수렴했다. 5편의 파인튜닝은 이 포맷을 전제로 하므로 구조를 알아두면 좋다. 공식 문서 기준 v3.0(lerobot >= 0.4.0)의 설계는 "저장은 큰 파일 몇 개로, API는 에피소드 단위로"라는 원칙이다.
my_dataset/
├── meta/
│   ├── info.json        # 피처 스키마(이름·dtype·shape), fps, 코드베이스 버전, 경로 템플릿
│   ├── stats.json       # 피처별 mean/std/min/max (정규화용, dataset.meta.stats)
│   ├── tasks.jsonl      # 자연어 태스크 ↔ 정수 ID
│   └── episodes/        # 에피소드별 길이·태스크·오프셋 (chunked parquet)
├── data/                # 프레임 단위 parquet 샤드, 한 파일에 여러 에피소드
└── videos/              # 카메라별 mp4 샤드, 한 파일에 여러 에피소드
세 축으로 나뉜다. 상태·액션·타임스탬프 같은 저차원 고주파 신호는 Parquet, 카메라 프레임은 MP4, 에피소드 경계와 스키마는 메타데이터다. v2까지는 에피소드 하나가 파일 하나였는데 v3에서는 여러 에피소드를 한 파일에 이어 붙이고 메타데이터의 오프셋으로 잘라 읽는다. 파일 수가 줄어 수백만 에피소드 규모에서도 초기화가 빨라진다.
학습 코드에서 보는 모습은 이렇다.
from lerobot.datasets import LeRobotDataset

dataset = LeRobotDataset("yaak-ai/L2D-v3")
sample = dataset[100]
# {'observation.state': tensor([...]), 'action': tensor([...]),
#  'observation.images.front_left': tensor([C, H, W]), 'timestamp': tensor(1.234), ...}

# 현재 프레임 기준 -0.2s, -0.1s, 0s 프레임을 쌓아서 반환
dataset = LeRobotDataset(
    "yaak-ai/L2D-v3",
    delta_timestamps={"observation.images.front_left": [-0.2, -0.1, 0.0]},
)
dataset[100]["observation.images.front_left"].shape  # [3, C, H, W]
delta_timestamps가 핵심 편의 기능이다. 2편에서 본 액션 청킹(미래 N스텝 액션을 한 번에 예측)이나 관측 히스토리를 쓰려면 "현재 프레임 ±k초"의 윈도우가 필요한데, 이걸 초 단위 오프셋 리스트로 선언하면 데이터셋이 알아서 스택해 준다. 다운로드 없이 Hub에서 바로 읽는 StreamingLeRobotDataset도 있고, lerobot-train에서는 --dataset.streaming=true로 켠다. 직접 녹화할 때는 dataset.save_episode() 후 반드시 dataset.finalize()를 호출해야 parquet 푸터가 써진다. 이걸 빼먹으면 파일이 깨진다.
🎮 시뮬레이션 벤치마크
실로봇 평가는 비싸고 재현이 안 된다. 그래서 VLA 논문의 숫자 대부분은 시뮬레이션에서 나온다. 세 가지가 사실상 표준이다.
- LIBERO (2023): robosuite 위에 만든 평생학습 벤치마크. LIBERO-Spatial(공간 관계), LIBERO-Object(물체 종류), LIBERO-Goal(목표·동작) 각 10개 태스크와 LIBERO-100(단기 90개 + 장기 10개 = LIBERO-Long)까지 총 130개 태스크. 태스크당 Spacemouse로 찍은 50개 시연이 딸려 온다. OpenVLA, π0, SmolVLA 등이 보고하는 "LIBERO 성공률"은 보통 Spatial/Object/Goal/Long 네 스위트 평균이다.
- SimplerEnv (2024): "실로봇 정책을 시뮬레이션에서 평가"하는 real-to-sim 벤치마크. Google Robot과 WidowX(Bridge) 셋업을 재현하고, 제어·시각 차이를 줄여 시뮬레이션 성능이 실로봇 성능과 강하게 상관하도록 설계했다. 실로봇 없이 RT-1·Octo 계열을 비교할 때 쓴다.
- RoboCasa (2024): 주방 중심의 대규모 시뮬레이션. 150개 이상 물체 카테고리의 3D 에셋을 text-to-3D 모델로 만들고 텍스처는 text-to-image로 생성했다. 100개 태스크(원자 태스크 + LLM이 설계를 도운 복합 태스크)와 자동 궤적 생성 파이프라인을 제공하며, 합성 데이터를 늘릴수록 모방학습 성능이 오르는 스케일링 경향을 보고한다. GR00T N1의 시뮬레이션 평가도 RoboCasa 태스크를 쓴다.
주의할 점은 시뮬레이션 점수가 포화되고 있다는 것이다. LIBERO는 최신 모델들이 90%대 후반을 보고하므로 변별력이 떨어졌고, 시뮬레이션에서 1등인 모델이 실로봇에서도 1등이라는 보장은 SimplerEnv처럼 real-to-sim 상관을 검증한 벤치마크에서만 어느 정도 성립한다.
🧪 Co-training: 로봇 데이터만으로는 부족하다
π0.5의 데이터 믹스처
Physical Intelligence의 π0.5는 "본 적 없는 집에서 주방 청소"를 목표로 했고, 그 핵심을 모델 구조가 아니라 데이터 믹스처에서 찾았다.
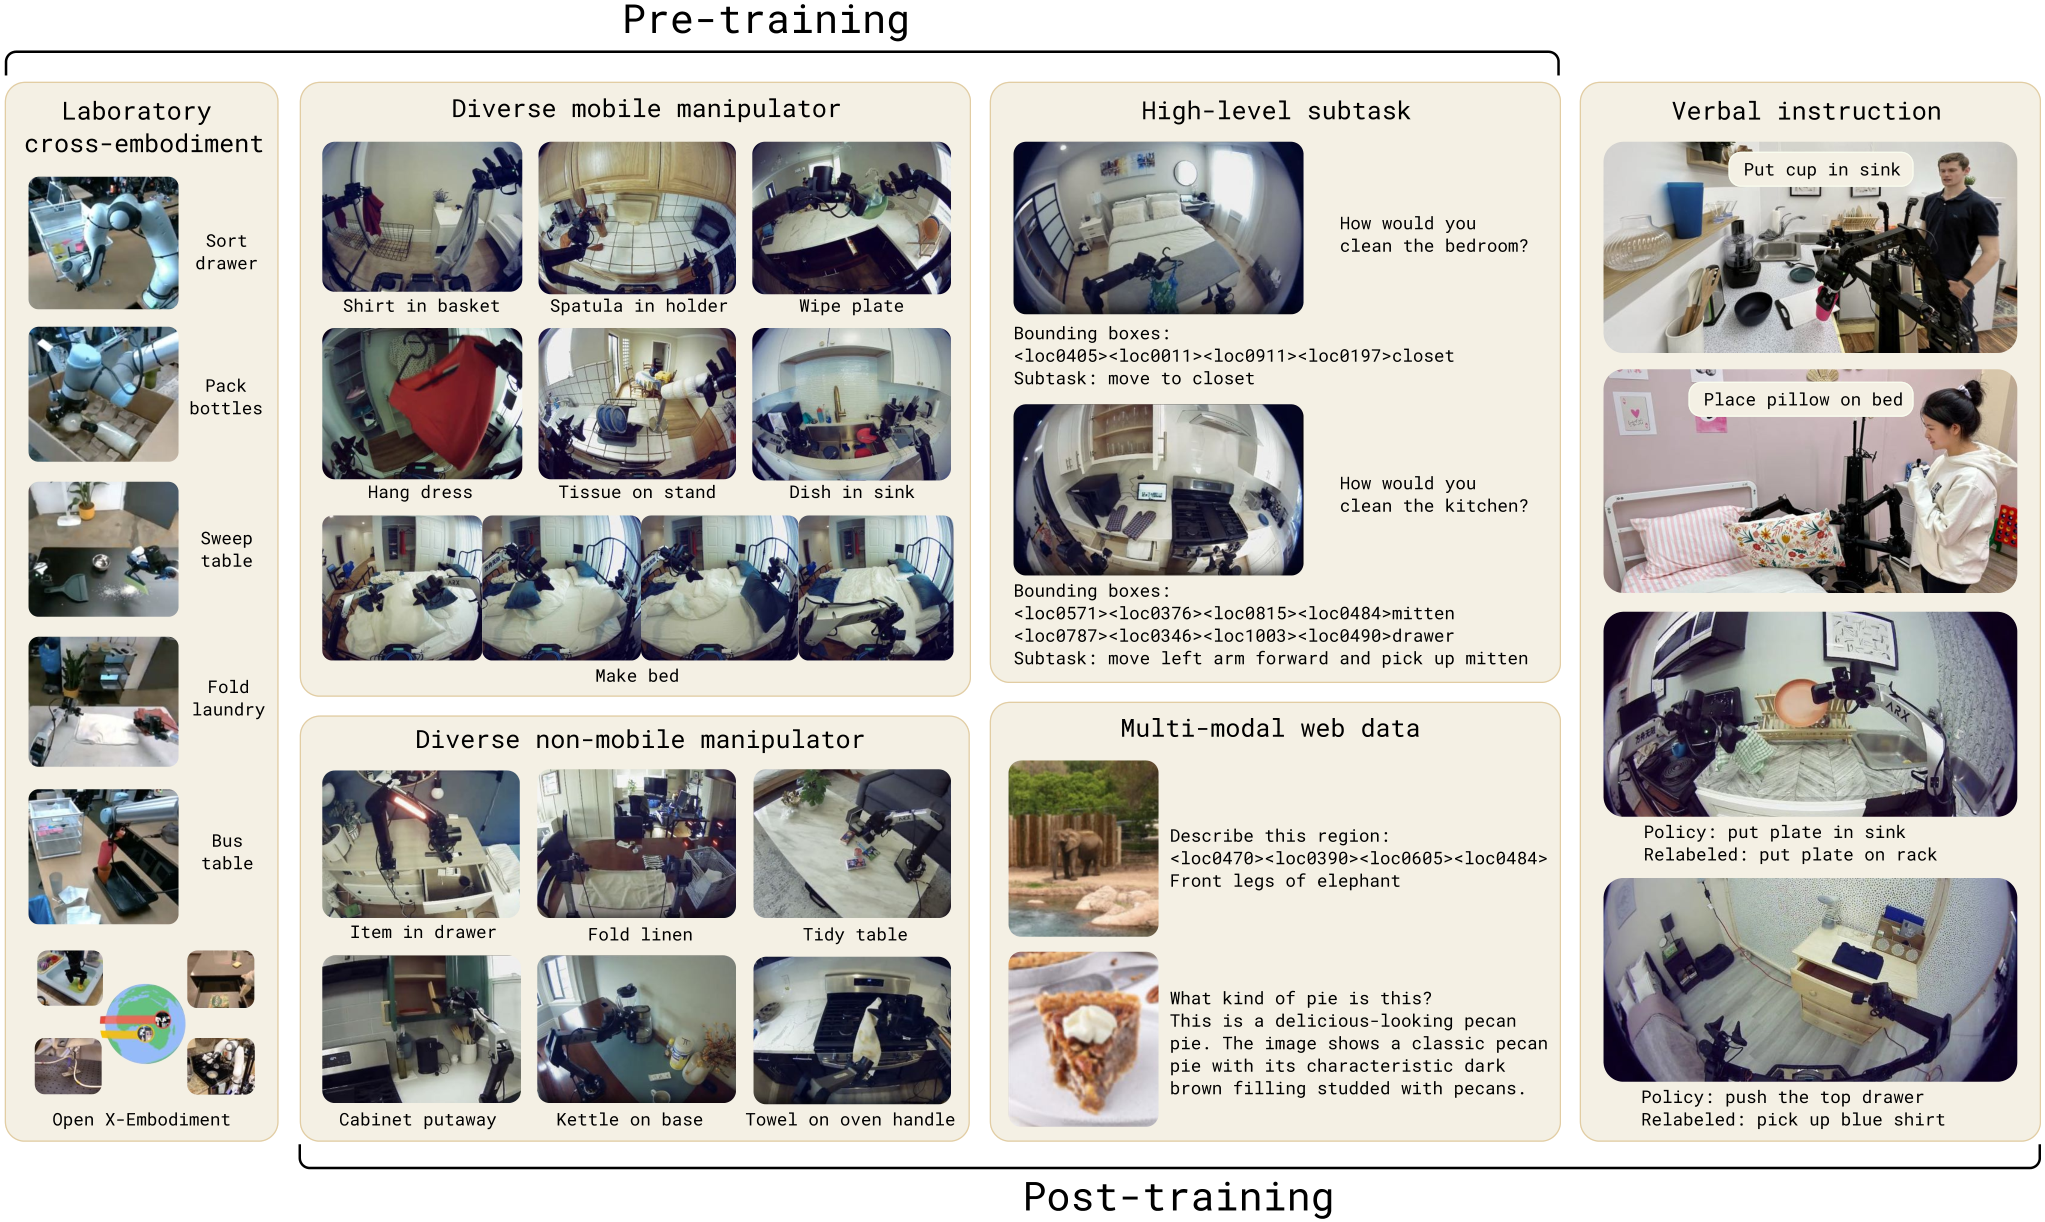
데이터 소스는 여섯 가지다.
| 약어 | 내용 | 사용 단계 |
|---|---|---|
| MM | 모바일 매니퓰레이터, 약 100개 집에서 약 400시간 | 사전 + 사후 |
| ME | 테이블에 고정된 단일/양팔 로봇, 다양한 집 | 사전 + 사후 |
| CE | 실험실 크로스 임바디먼트 데이터 + OXE | 사전만 |
| HL | 고수준 서브태스크 예측(텍스트 + 바운딩 박스) | 사전 + 사후(일부) |
| WD | 웹 데이터(캡셔닝, VQA, 객체 위치) | 사전 + 사후 |
| VI | 사람의 말로 된 개입 지시 | 사후만 |
놀라운 숫자는 사전학습 예시의 97.6%가 평가 대상인 "모바일 매니퓰레이터의 집안일"이 아니라는 것이다. 사전학습 280k 스텝은 FAST 이산 토큰으로 전체 믹스처를 돌리고, 사후학습 80k 스텝에서 flow matching 액션 전문가를 붙이면서 MM·ME의 성공 에피소드와 WD·VI로 좁힌다.
어블레이션이 어떤 데이터가 중요한지 말해 준다. ME나 CE를 빼면 mock home 성능이 유의하게 떨어지고 둘 다 빼면 더 떨어진다. 즉 다른 로봇의 데이터가 모바일 매니퓰레이터의 집안일 성능을 올린다. 반면 WD를 빼도 mock home 태스크에서는 유의한 차이가 없었는데, OOD 물체에 대한 언어 따르기에서는 WD를 빼면 유의하게 나빠졌다. 웹 데이터는 손 움직임이 아니라 "저게 뭔지"를 아는 데 기여한다는 뜻이다.
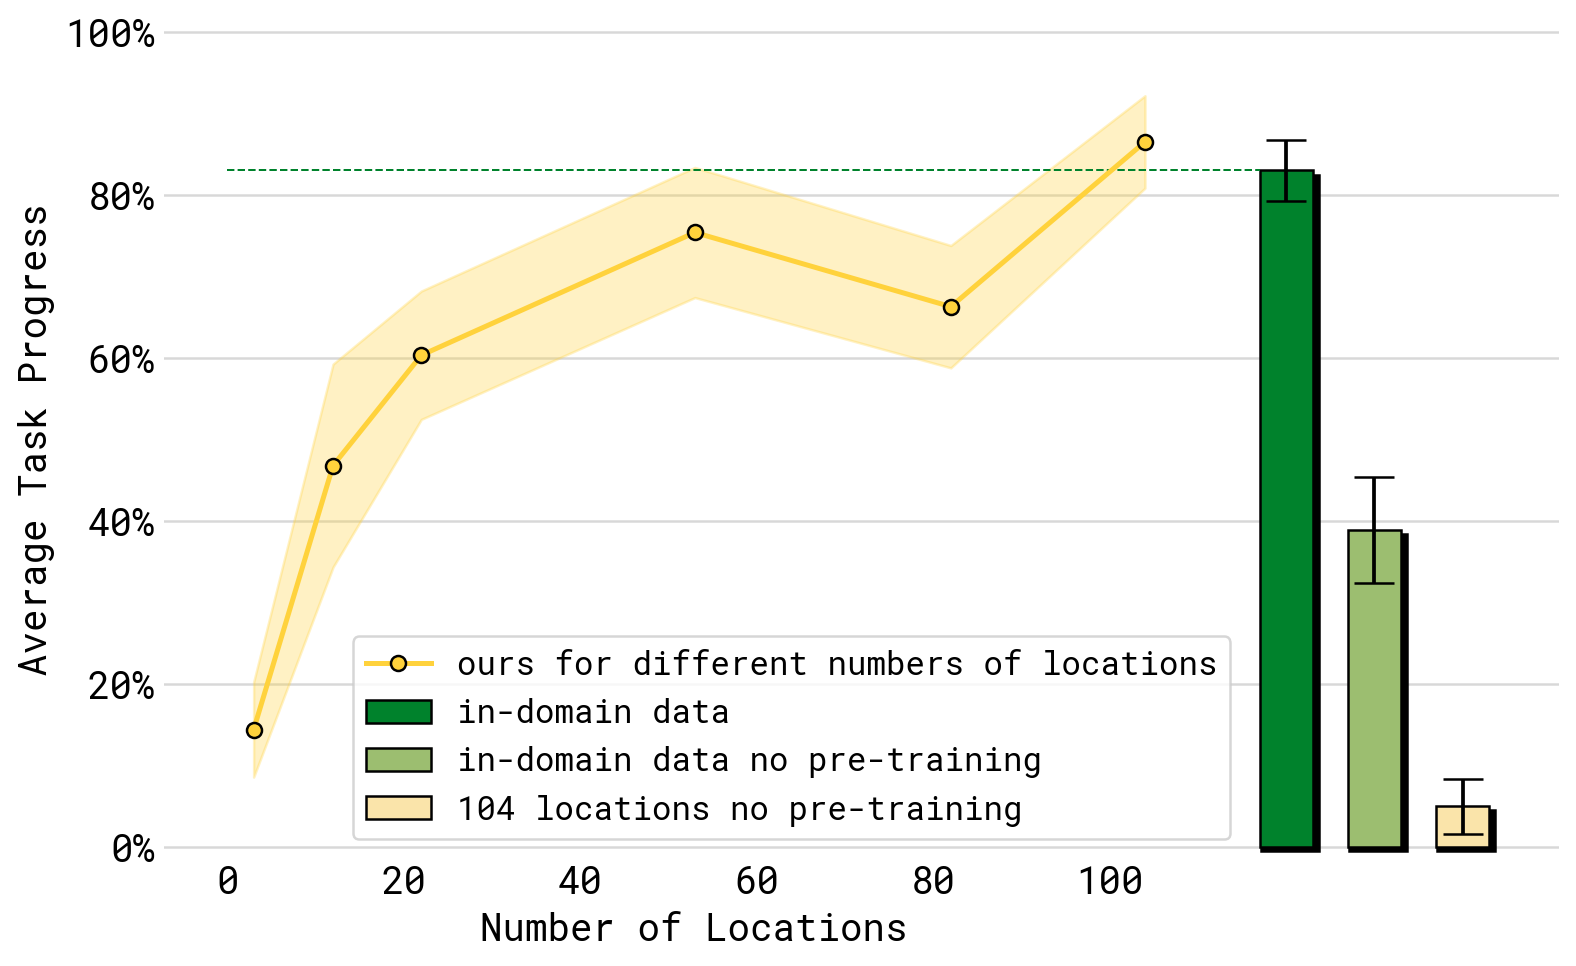
그리고 장소 수 스케일링이다. 3, 12, 22, 53, 82, 104개 장소로 학습하면 성능이 대체로 올라가고, 104개 장소 모델은 테스트 집에서 직접 찍은 데이터로 학습한 모델과 비슷하다. 막대 세 개 중 맨 오른쪽이 중요하다. 사전학습(CE·WD 등) 없이 104개 장소 데이터만으로 학습하면 5% 수준으로 무너진다. 다양한 집의 데이터와 크로스 임바디먼트 사전학습은 대체재가 아니라 보완재다.
GR00T N1의 데이터 피라미드
NVIDIA GR00T N1(2.2B, 그중 VLM 1.34B)은 같은 아이디어를 피라미드로 그렸다.
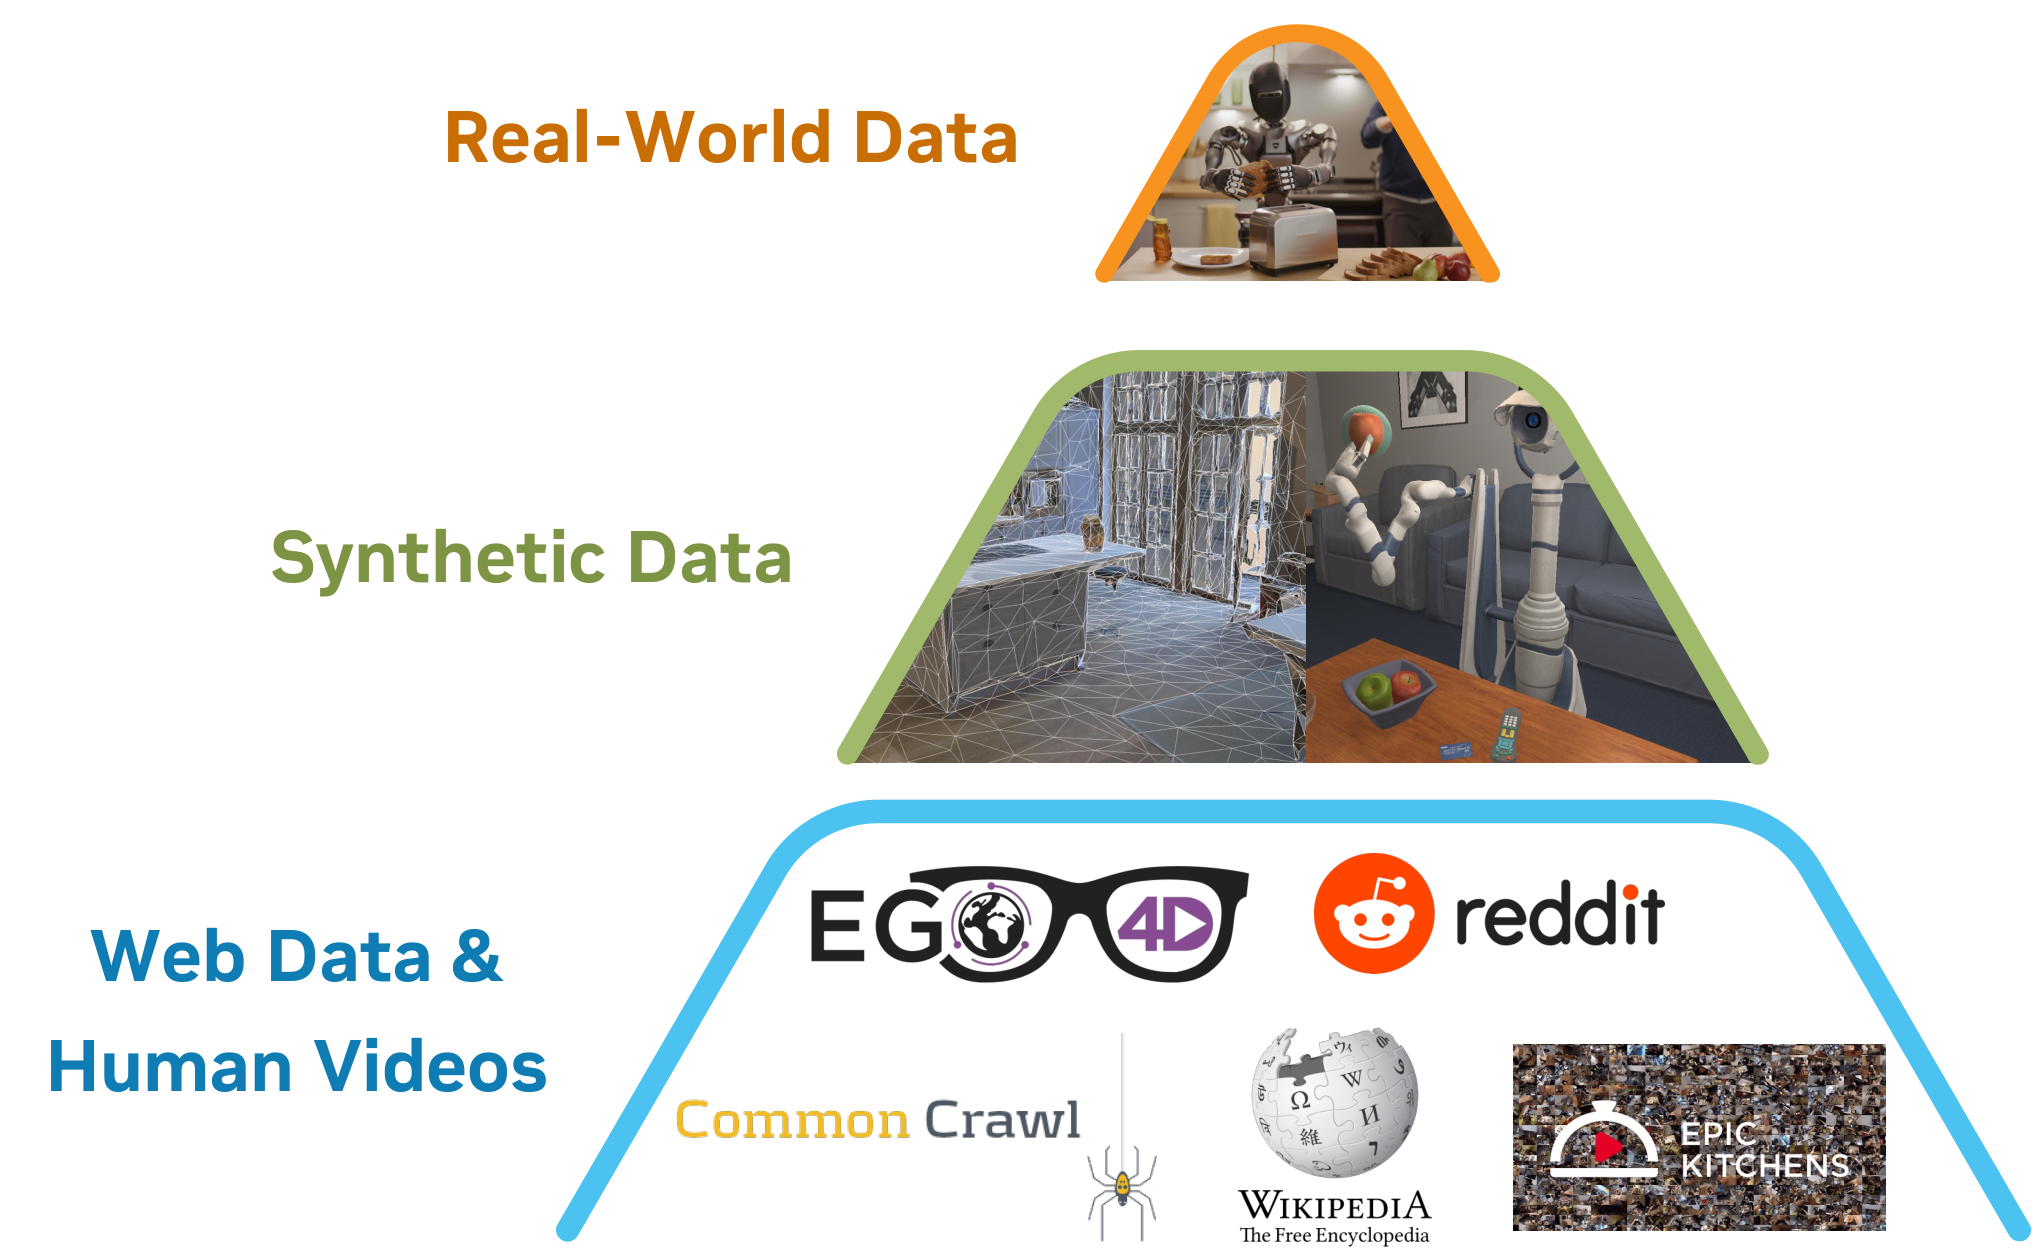
- 바닥: 웹 데이터·사람 비디오. Ego4D, Ego-Exo4D, EPIC-KITCHENS, HOI4D, HoloAssist 등 1인칭 비디오. 액션 라벨이 없으므로 VQ-VAE 목적함수로 학습한 잠재 액션 코드북을 역동역학 모델로 써서 프레임 사이의 "잠재 액션"을 붙이고, 이를 별도 임바디먼트(LAPA)처럼 취급한다.
- 중간: 합성 데이터. 시뮬레이션 궤적 78만 개(사람 시연 6,500시간, "9개월 연속 시연"에 해당)와, 비디오 생성 모델로 실로봇 데이터를 증강한 neural trajectory. 사내 텔레오퍼레이션 데이터는 neural trajectory로 88시간에서 827시간으로 늘어났다.
- 꼭대기: 실로봇 데이터. OXE(RT-1, Bridge V2, DROID 등)와 AgiBot-Alpha(100대 로봇, 학습 시작 시점 기준 14만 궤적), 그리고 휴머노이드 텔레오퍼레이션 데이터.
π0.5와 GR00T N1의 공통점은 분명하다. 평가 대상 로봇의 데이터는 전체의 일부에 불과하고, 나머지는 다른 로봇·시뮬레이션·사람 비디오·웹으로 채운다. 그리고 그 "나머지"를 빼면 성능이 무너진다.
🔧 크로스 임바디먼트가 어려운 이유
데이터를 섞으면 좋다는 건 알겠는데, 왜 그냥 다 합쳐서 학습하면 안 되는가. 세 가지 불일치 때문이다.
액션 공간 불일치. OXE는 모든 로봇을 7D 엔드이펙터 델타로 환원했지만, 양팔 로봇(14D 이상), 휴머노이드 손(수십 D), 모바일 베이스(+3D)는 7D로 표현되지 않는다. π0 계열은 가장 큰 액션 차원에 맞춰 제로 패딩하고, GR00T N1은 임바디먼트별 별도 인코더/디코더 MLP를 둔다. 2025년 10월의 X-VLA(0.9B)는 데이터 소스마다 학습 가능한 soft prompt 임베딩을 두어 임바디먼트 차이를 흡수하는 방식을 택했다. 어느 쪽이든 "공통 모터 언어"가 아니라 "공통 백본 + 로봇별 어댑터"로 수렴하는 중이다. 좌표계·단위(미터 vs 관절 라디안)·절대 vs 델타 표현까지 다르면 정규화 통계(stats.json의 mean/std)를 데이터셋별로 따로 관리해야 한다.
카메라 불일치. OXE는 데이터셋당 대표 카메라 하나만 골랐고, DROID는 매 에피소드 카메라 위치를 바꿨고, Bridge는 4개 뷰를 쓴다. 손목 카메라 유무, 해상도, 시야각이 다르면 같은 "컵을 집어라"도 전혀 다른 이미지 분포가 된다. 5편에서 다룰 파인튜닝의 흔한 실패 원인 1순위가 바로 학습 데이터와 배포 환경의 카메라 불일치다.
주파수 불일치. Bridge 5 Hz, DROID 15 Hz, π0 계열 50 Hz. 액션 청크 하나가 Bridge에서는 2초, π0에서는 0.2초를 뜻한다. 타임스탬프 기준으로 리샘플링하거나(LeRobot의 delta_timestamps가 초 단위인 이유) 모델에 주파수를 조건으로 넣어야 한다.
여기에 데이터 불균형이 겹친다. OXE에서 보았듯 궤적 수 기준으로는 소수 로봇이 대부분을 차지하므로, 단순히 균등 샘플링하면 작은 데이터셋은 묻힌다. Octo·OpenVLA·π0 모두 데이터셋별 샘플링 가중치를 손으로 조정했다. 2026년 7월의 서베이 "Data Pyramid for Embodied Manipulation"(2607.24744)은 데이터 소스를 실로봇·UMI류·1인칭/3인칭 사람 비디오·시뮬레이션·일반 VL 데이터의 5단계로 나누고, 스케일이 클수록 로봇 정렬도는 낮아지는 트레이드오프를 핵심 축으로 제시하면서 "임바디먼트 간 액션 정렬"을 여전히 열린 문제로 꼽는다.
📈 데이터 스케일링 법칙은 성립하는가
LLM의 스케일링 법칙처럼 "데이터 x배 → 성능 y"의 깔끔한 곡선이 로봇에도 있을까. 가장 체계적인 답은 Lin 등의 "Data Scaling Laws in Imitation Learning for Robotic Manipulation"(2410.18647)이다. UMI(손에 드는 그리퍼)로 4만 개 이상의 시연을 모으고 1만 5천 회 이상의 실로봇 롤아웃으로 검증했다.
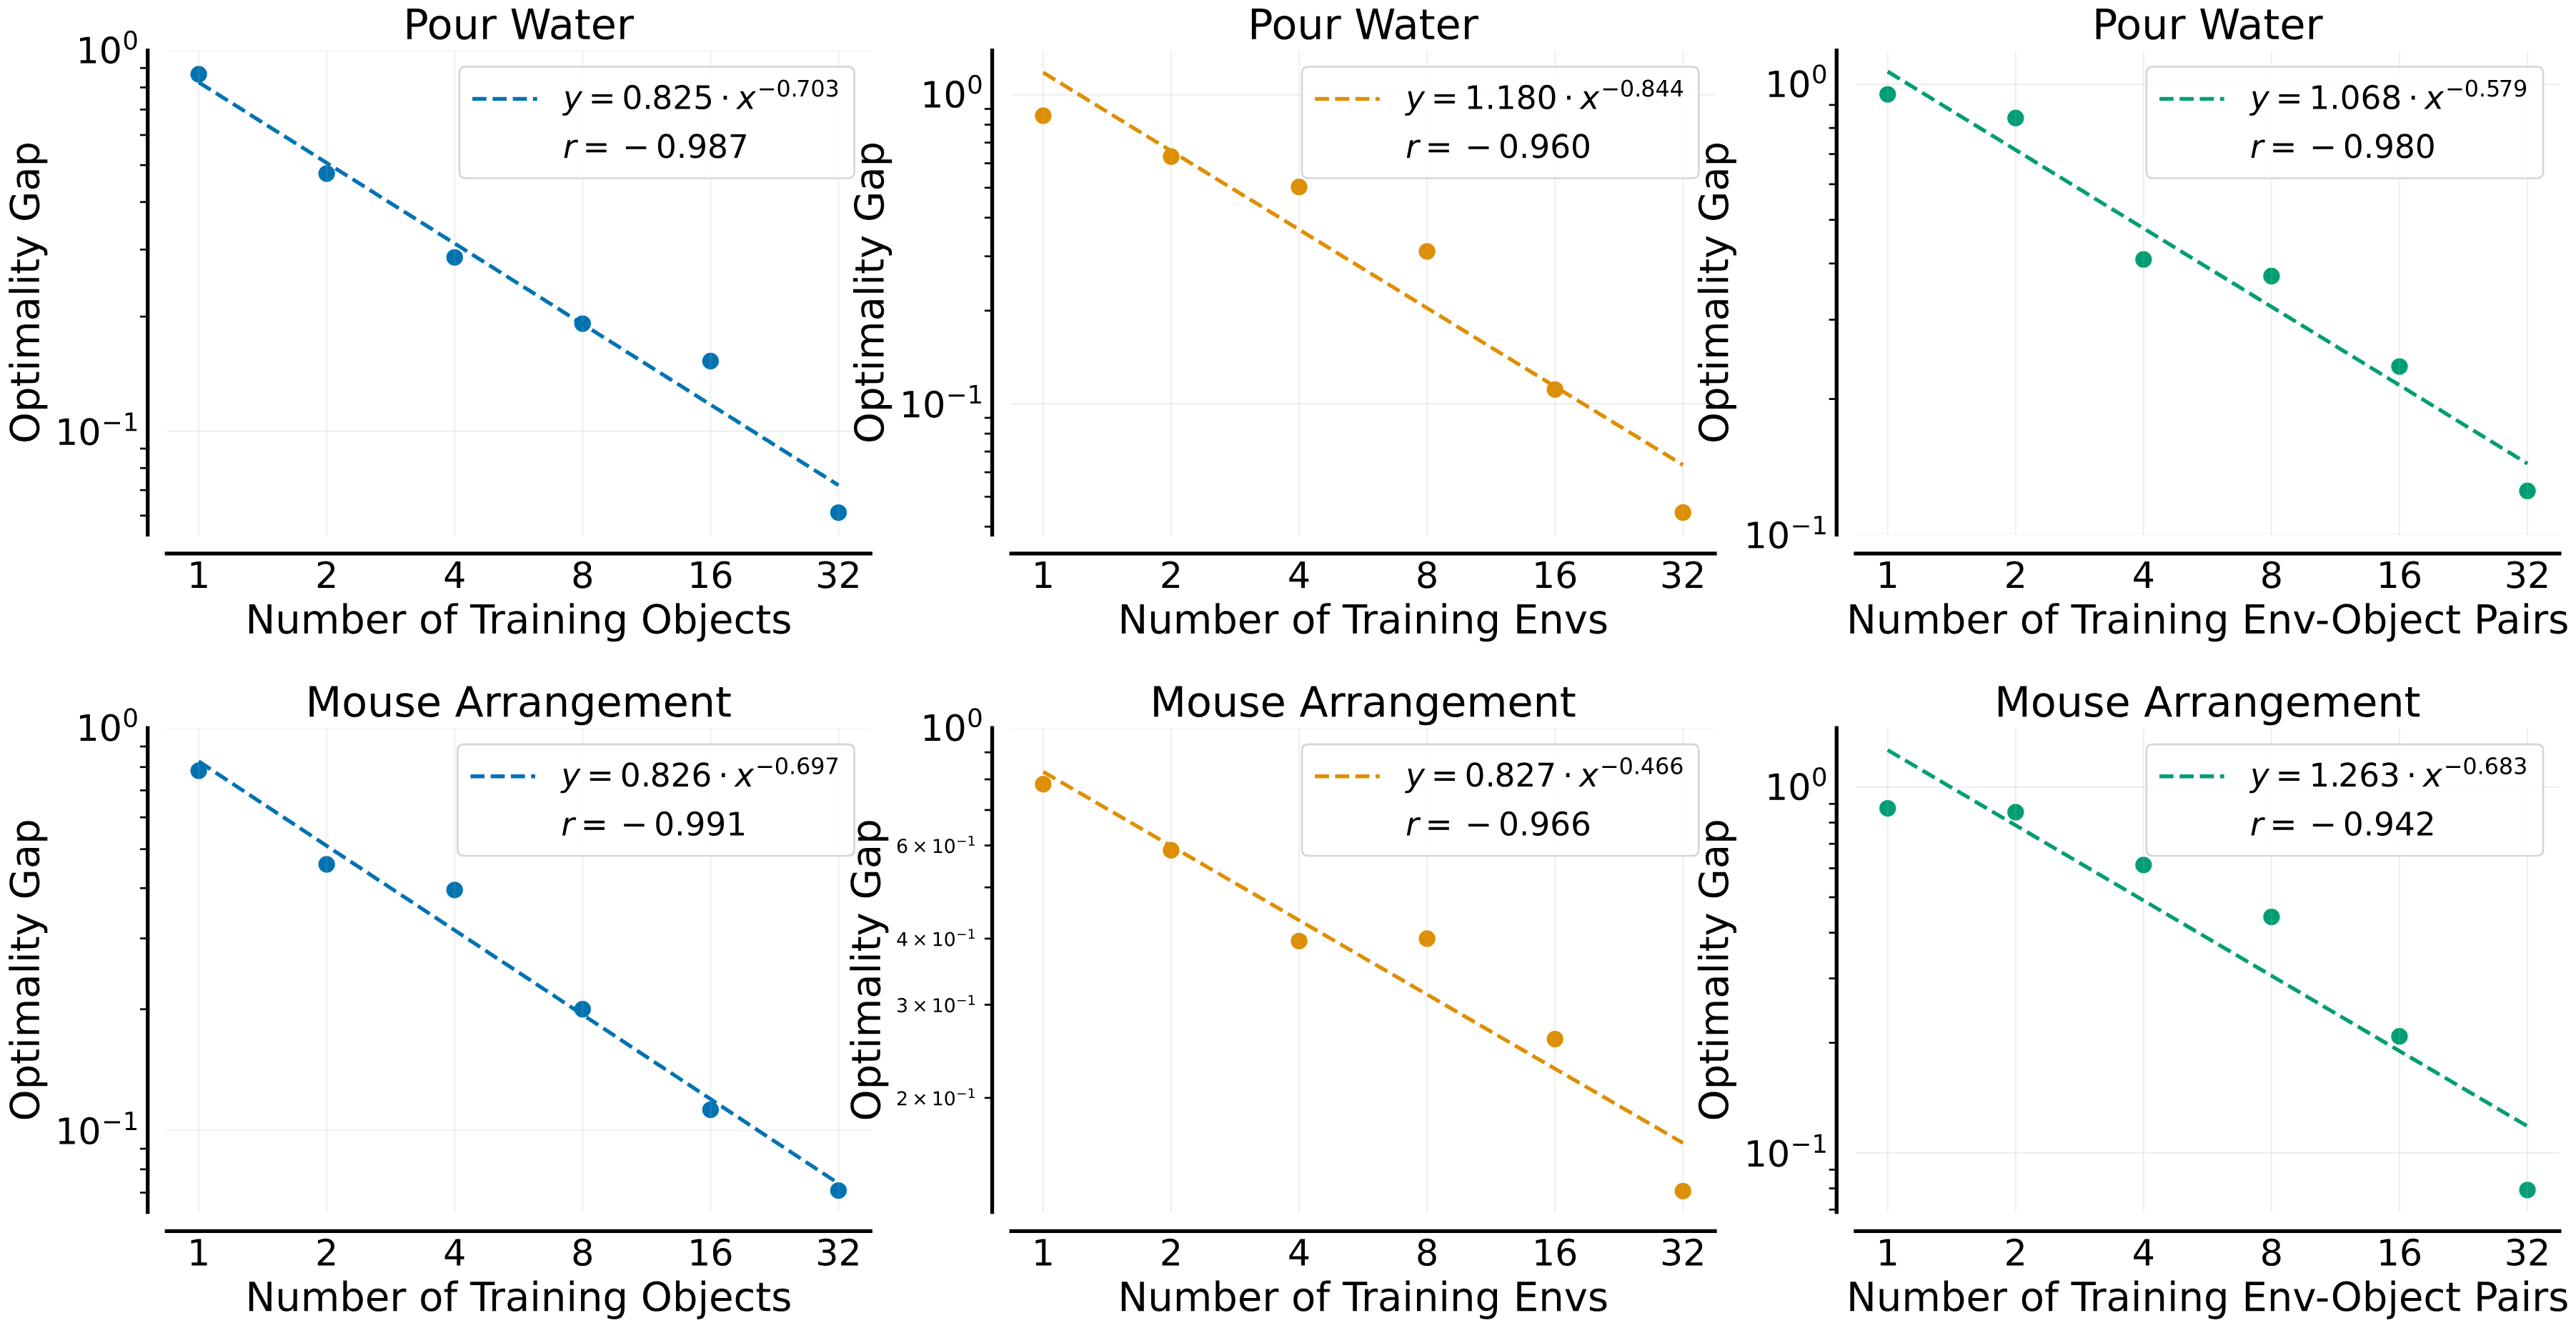
결론은 세 줄이다.
- 새 환경·새 물체에 대한 일반화 성능은 훈련 환경 수와 물체 수에 대해 대략 멱법칙을 따른다(그림의 지수 약 −0.5에서 −0.8, 상관계수 −0.94 이하).
- 반면 총 시연 수와의 상관은 약하다(−0.62, −0.79). 환경·물체당 시연이 일정 수를 넘으면 더 찍어도 효과가 거의 없다.
- 실용 처방: 32개 환경-물체 쌍 × 약 50개 시연. 4명이 오후 한나절에 모을 수 있고, 이 레시피로 8개 미지 환경에서 Pour Water 85.0%, Mouse Arrangement 92.5%, Fold Towels 87.5%, Unplug Charger 90.0%의 성공률을 얻었다.
이 결과는 DROID의 "다양성이 크기보다 중요" 실험, π0.5의 "장소 수 스케일링"과 같은 방향을 가리킨다. 로봇 데이터에서 스케일링 축은 에피소드 수가 아니라 환경·물체·임바디먼트의 다양성이다.
2026년에는 규모 자체도 한 단계 올라갔다. Xiaomi-Robotics-1(2607.15330, 2026년 7월)은 UMI 장치로 모은 10만 시간 이상의 실세계 조작 궤적으로 사전학습하고, 사전학습 데이터와 모델 크기를 키울수록 성능이 오르며 그 이득이 사후학습 후 실로봇 성능으로 이어진다고 보고한다(RoboCasa365 57.4%, 이전 최고 46.6%, 모두 벤더 측 보고). DROID 350시간에서 2년 만에 300배다. 같은 해 6월의 "Learning Action Priors for Cross-embodiment Robot Manipulation"(2606.26095)은 VLA 정렬 전에 액션 궤적만으로 flow matching 모션 프라이어를 학습하면 1단계의 액션 데이터를 늘릴수록 더 일반적인 프라이어가 되어 다운스트림 VLA가 좋아진다고 주장한다. 다만 두 논문 모두 "멱법칙 지수"를 명시적으로 제시하진 않으므로, 로봇의 스케일링 법칙은 아직 "경향"이지 LLM처럼 예측 가능한 "법칙"은 아니라고 보는 게 정확하다.
⚠️ 정리와 주의
- 크로스 임바디먼트는 작동하지만 공짜가 아니다. OXE는 긍정적 전이를 보였지만 소형 모델은 underfit했고, 액션·카메라·주파수 정렬은 지금도 로봇별 어댑터와 수작업 가중치로 때우고 있다.
- 다양성 > 양. DROID, π0.5, Lin 등 세 독립적인 결과가 환경·물체 수가 스케일링의 진짜 축이라고 말한다. 같은 테이블에서 1,000개 더 찍는 것보다 다른 방 10곳에서 50개씩 찍는 게 낫다.
- 로봇이 아닌 데이터가 절반 이상이다. π0.5 사전학습의 97.6%가 평가 로봇 외 데이터였고, GR00T N1은 사람 비디오와 합성 데이터를 잠재 액션·neural trajectory로 로봇 데이터처럼 쓴다.
- 시뮬레이션 숫자는 조심해서 읽자. LIBERO는 포화 중이고, real-to-sim 상관이 검증된 SimplerEnv 같은 벤치마크가 아니면 시뮬레이션 순위가 실로봇 순위를 보장하지 않는다.
- 포맷은 LeRobot으로 수렴. 새 데이터를 찍거나 공개 데이터를 쓴다면 v3 포맷(
meta/,data/,videos/)과delta_timestamps,finalize()만 알면 된다. 다음 5편에서 실제로 파인튜닝한다.
📚 참고
- Open X-Embodiment Collaboration, "Open X-Embodiment: Robotic Learning Datasets and RT-X Models" — arXiv:2310.08864
- Khazatsky et al., "DROID: A Large-Scale In-The-Wild Robot Manipulation Dataset" — arXiv:2403.12945
- Walke et al., "BridgeData V2: A Dataset for Robot Learning at Scale" — arXiv:2308.12952
- Liu et al., "LIBERO: Benchmarking Knowledge Transfer for Lifelong Robot Learning" — arXiv:2306.03310
- Li et al., "Evaluating Real-World Robot Manipulation Policies in Simulation" (SimplerEnv) — arXiv:2405.05941
- Nasiriany et al., "RoboCasa: Large-Scale Simulation of Everyday Tasks for Generalist Robots" — arXiv:2406.02523
- Hugging Face, "LeRobotDataset v3.0" — huggingface.co/docs/lerobot/lerobot-dataset-v3
- Physical Intelligence, "π0.5: a Vision-Language-Action Model with Open-World Generalization" — arXiv:2504.16054
- NVIDIA, "GR00T N1: An Open Foundation Model for Generalist Humanoid Robots" — arXiv:2503.14734
- Lin et al., "Data Scaling Laws in Imitation Learning for Robotic Manipulation" — arXiv:2410.18647
- Zheng et al., "X-VLA: Soft-Prompted Transformer as Scalable Cross-Embodiment Vision-Language-Action Model" — arXiv:2510.10274
- Jing et al., "Learning Action Priors for Cross-embodiment Robot Manipulation" — arXiv:2606.26095
- Xiaomi Robotics Team, "Xiaomi-Robotics-1: Scaling Vision-Language-Action Models with over 100K Hours of Real-World Trajectories" — arXiv:2607.15330
- Ye et al., "Data Pyramid for Embodied Manipulation: A Survey" — arXiv:2607.24744
본 글의 그림은 각 논문(Open X-Embodiment, DROID, π0.5, GR00T N1, Lin et al. 2024)에서 가져왔습니다.