VLA란 무엇인가: 인터넷 지식을 로봇의 행동으로
"로봇 행동을 또 하나의 언어로 표현하면, 인터넷 규모 비전-언어 데이터와 함께 학습할 수 있다." — RT-2 논문 Figure 1
2023년 7월 Google DeepMind가 공개한 RT-2 논문은 제목에 낯선 약어 하나를 넣었다. VLA, Vision-Language-Action. 이미지와 문장을 받아 텍스트를 내놓던 비전-언어 모델(VLM)에 "로봇 팔을 어디로 움직일지"도 텍스트처럼 뱉게 하자는 것이었다. 3년이 지난 지금 VLA는 로봇 학습의 기본 어휘가 됐고, Physical Intelligence·Google DeepMind·NVIDIA가 각자 파운데이션 모델을 내놓으며 경쟁한다.
이 글은 VLA 시리즈 1편이다. 모델 하나를 깊게 파기 전에, 로봇 학습이 어떤 길을 거쳐 VLA에 도착했고 그 전환이 정확히 무엇을 바꿨는지 짚는다. 다음 편은 VLA 해부: VLM 백본부터 액션 헤드까지다.
시리즈 전체 로드맵은 다음과 같다.
- VLA란 무엇인가 (이 글): 역사, RT-1→RT-2 전환, 로드맵
- VLA 해부: VLM 백본부터 액션 헤드까지: 관측 인코딩, 액션 표현, autoregressive vs diffusion vs flow matching
- 모델 계보: RT-2 → Octo·OpenVLA → π0 계열 → GR00T·Gemini Robotics·SmolVLA
- 데이터와 크로스 임바디먼트: Open X-Embodiment, DROID, 시뮬레이션, 사람 비디오
- 실습: LeRobot로 SmolVLA 파인튜닝
- 배포와 응용, 전망: 실시간 추론, RL 사후학습, 안전, 남은 과제
🤔 VLA 이전: 로봇은 어떻게 배웠나
로봇에게 "서랍에서 사과를 꺼내 카운터에 놓아"를 가르치는 가장 단순한 방법은 사람이 조종기로 수백 번 시범을 보이고, 그 (카메라 이미지 → 조종 명령) 쌍을 지도학습으로 외우게 하는 것이다. 이것이 모방학습(imitation learning), 그중에서도 **행동 복제(behavior cloning, BC)**다. 보상 함수를 설계하기 어려운 조작 과제에서 강화학습 대신 널리 쓰였고, 손실 함수도 평범하다. 연속 행동이면 MSE, 이산 행동이면 교차 엔트로피다.
문제는 일반화였다. BC 정책은 본 적 있는 물체, 본 적 있는 배경, 본 적 있는 문장 안에서만 잘 작동했다. 과제가 하나 늘 때마다 시범을 새로 모아야 했고, 과제마다 별도의 정책을 두면 과제 사이에 지식이 공유되지 않았다. 언어로 과제를 지정하면 하나의 정책이 여러 과제를 한꺼번에 배우고 "사과를 집어"와 "컵을 집어"가 '집기'라는 동작을 공유하게 된다는 점에서, 언어 조건화는 처음부터 일반화를 위한 장치였다. 2021년 전후로 이 한계를 **언어 조건 정책(language-conditioned policy)**으로 넓히려는 시도가 나왔다. VLA 서베이(Ma et al., 2024)가 초기 사례로 꼽는 모델들을 보면 흐름이 보인다.
- CLIPort(2021): CLIP의 언어·이미지 임베딩을 Transporter 네트워크와 결합해, 문장으로 지시한 pick-and-place 위치(SE(2))를 출력한다. "인터넷에서 배운 시각-언어 표현을 로봇에 빌려 쓰자"는 발상의 초기형이다.
- BC-Z(2021): 언어 지시 또는 사람 시범 영상을 FiLM 층으로 이미지 특징에 섞어 넣고, 학습에 없던 과제로의 제로샷 일반화를 보였다.
- Gato(2022): 하나의 파라미터 세트로 Atari, 이미지 캡셔닝, 블록 쌓기를 모두 수행하는 "제너럴리스트 에이전트". 서로 다른 모달리티를 하나의 토큰 열로 통일했다.
- SayCan(2022): 학습 없이 LLM이 세운 계획을 BC-Z 같은 저수준 정책에 연결했다. "LLM은 계획, 정책은 실행"이라는 계층 구조의 대표다.
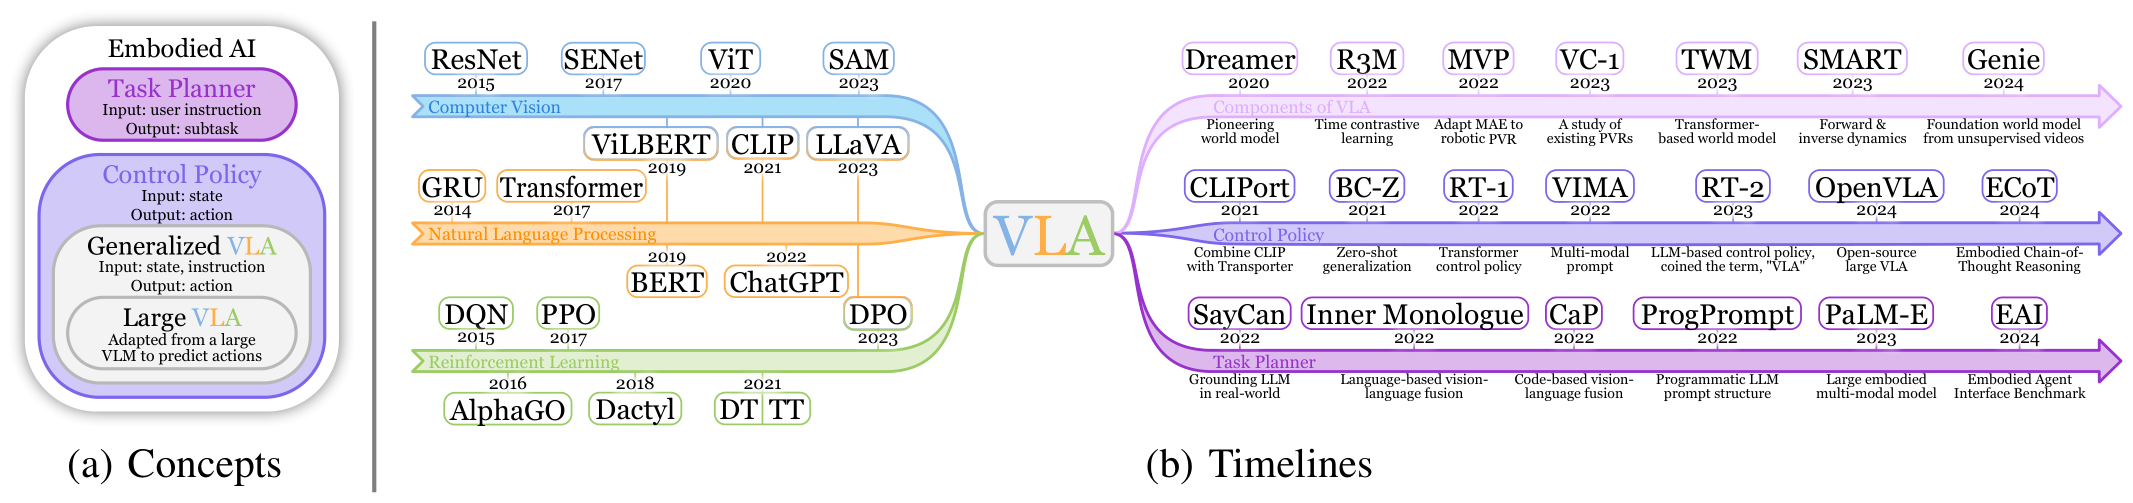
서베이의 이 그림이 지형을 잘 요약한다. 컴퓨터 비전·NLP·강화학습이라는 세 줄기가 VLA로 합류하고, VLA는 다시 저수준 제어 정책(상태를 받아 행동을 내놓는 쪽)과 고수준 과제 계획기(지시를 서브태스크로 쪼개는 쪽)로 나뉜다. 서베이는 "VLA"를 넓게는 "시각·언어·행동 세 모달리티를 다루는 임바디드 AI 모델 전반"으로, 좁게는 RT-2가 처음 쓴 의미, 즉 **대형 VLM을 행동 예측에 맞게 적응시킨 모델(Large VLA)**로 구분한다. 이 시리즈가 다루는 것은 주로 후자다.
🧠 RT-1: 트랜스포머 정책, 하지만 아직 "로봇 데이터만"
2022년 12월 Google이 공개한 **RT-1(Robotics Transformer 1)**은 VLA 직전 세대의 정점이다. 핵심 질문은 "LLM처럼 로봇 정책도 데이터와 모델을 키우면 일반화하는가"였고, 답을 얻기 위해 데이터부터 모았다. 13대의 이동 조작 로봇으로 17개월 동안 약 13만 개의 시범 에피소드, 700개 이상의 지시문(pick, move near, open/close drawer, place upright 등 스킬 그룹)이다.
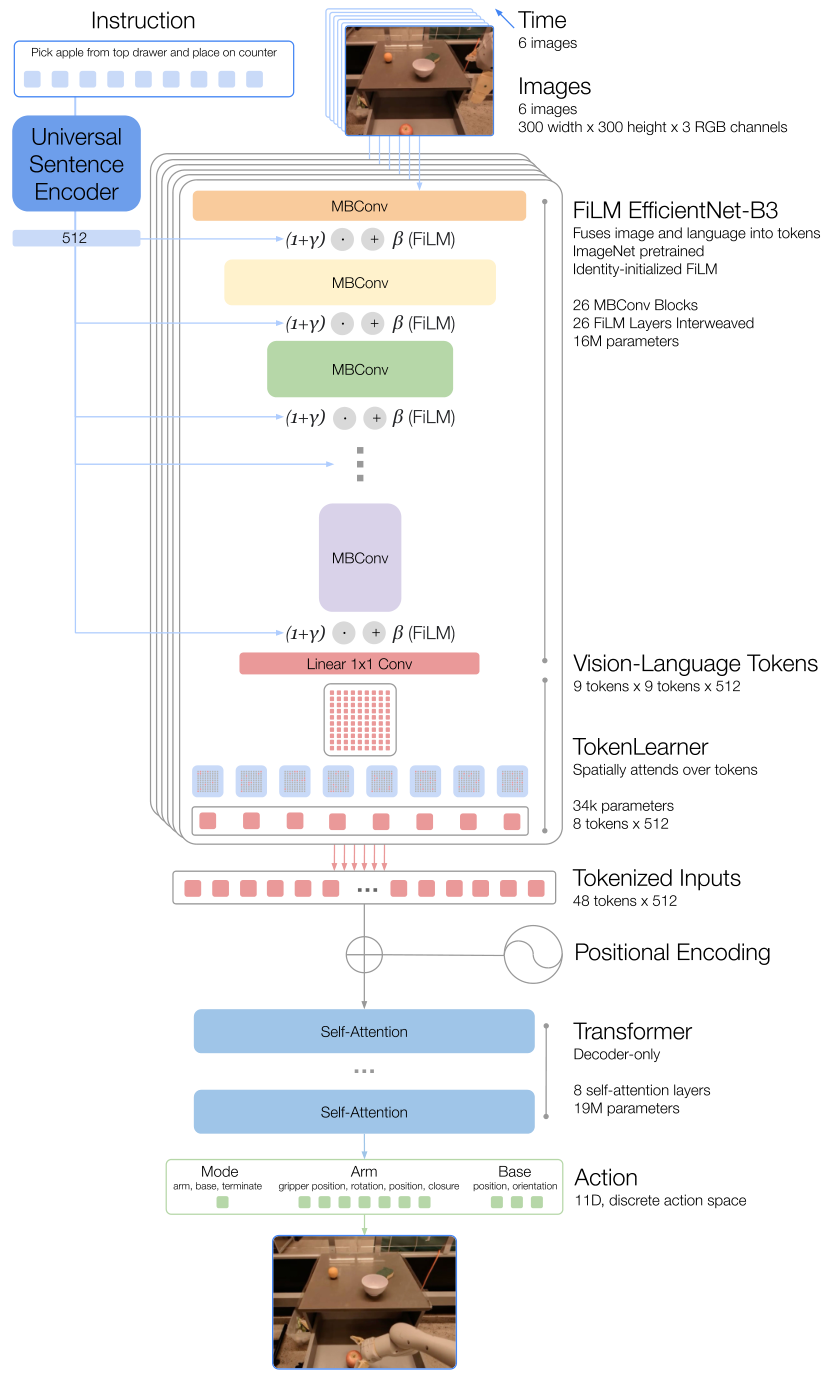
구조는 그림 그대로다. 문장은 Universal Sentence Encoder로 임베딩하고, ImageNet 사전학습된 EfficientNet-B3에 FiLM 층을 끼워 이미지와 언어를 섞는다. TokenLearner가 토큰을 81개에서 8개로 줄여 6프레임을 48 토큰에 담고, 8층 트랜스포머가 행동을 낸다. 행동은 팔 7차원, 베이스 3차원, 모드 1차원의 11차원이며 각 차원을 256개 구간으로 이산화해 분류 문제로 푼다. 전체 파라미터는 약 3,500만 개, 실행 주파수는 3 Hz다.
결과는 당시 기준 인상적이었다. 3,000회 이상의 실제 로봇 평가에서 본 과제 97%, 못 본 과제 76%(Gato 52%, BC-Z 19%), 방해 물체 83%, 새 배경 59%를 기록했다. 시뮬레이션 데이터를 섞으면 시뮬레이션에만 있던 물체에 대한 성공률이 23%에서 87%로 올랐고, 다른 로봇(Kuka)의 bin-picking 데이터를 섞으면 해당 과제 성공률이 22%에서 39%로 올랐다. SayCan과 결합한 장기 과제(최대 50단계)에서는 새 주방에서 실행 성공률 67%를 보였는데 BC-Z는 13%, Gato는 0%였다.
여기서 눈여겨볼 설계가 하나 있다. 연속값인 팔의 위치와 회전을 굳이 256개 구간으로 쪼개 분류 문제로 바꾼 것이다. 이렇게 하면 출력이 토큰이 되고, 트랜스포머가 언어 모델처럼 이산 토큰을 예측하는 형태가 된다. RT-2가 이 토큰을 VLM의 어휘에 그대로 얹을 수 있었던 것은 RT-1이 이미 행동을 토큰으로 만들어 두었기 때문이다.
그러나 RT-1에는 분명한 천장이 있었다. 비전 백본은 ImageNet 분류기이고 언어 인코더는 문장 임베딩기일 뿐, 모델이 세계에 대해 아는 것은 13만 에피소드 안에 있는 것이 전부였다. "가장 작은 물체를 집어", "숫자 3 위에 놓아" 같은 지시는 로봇 데이터에 없으면 풀 수 없었다.
💡 RT-2: 행동을 텍스트 토큰으로, VLM을 그대로 정책으로
RT-2(2023년 7월)의 발상은 한 문장이다. 이미 인터넷으로 학습된 VLM을 가져와, 로봇 행동을 그 모델의 출력 어휘로 표현하자.
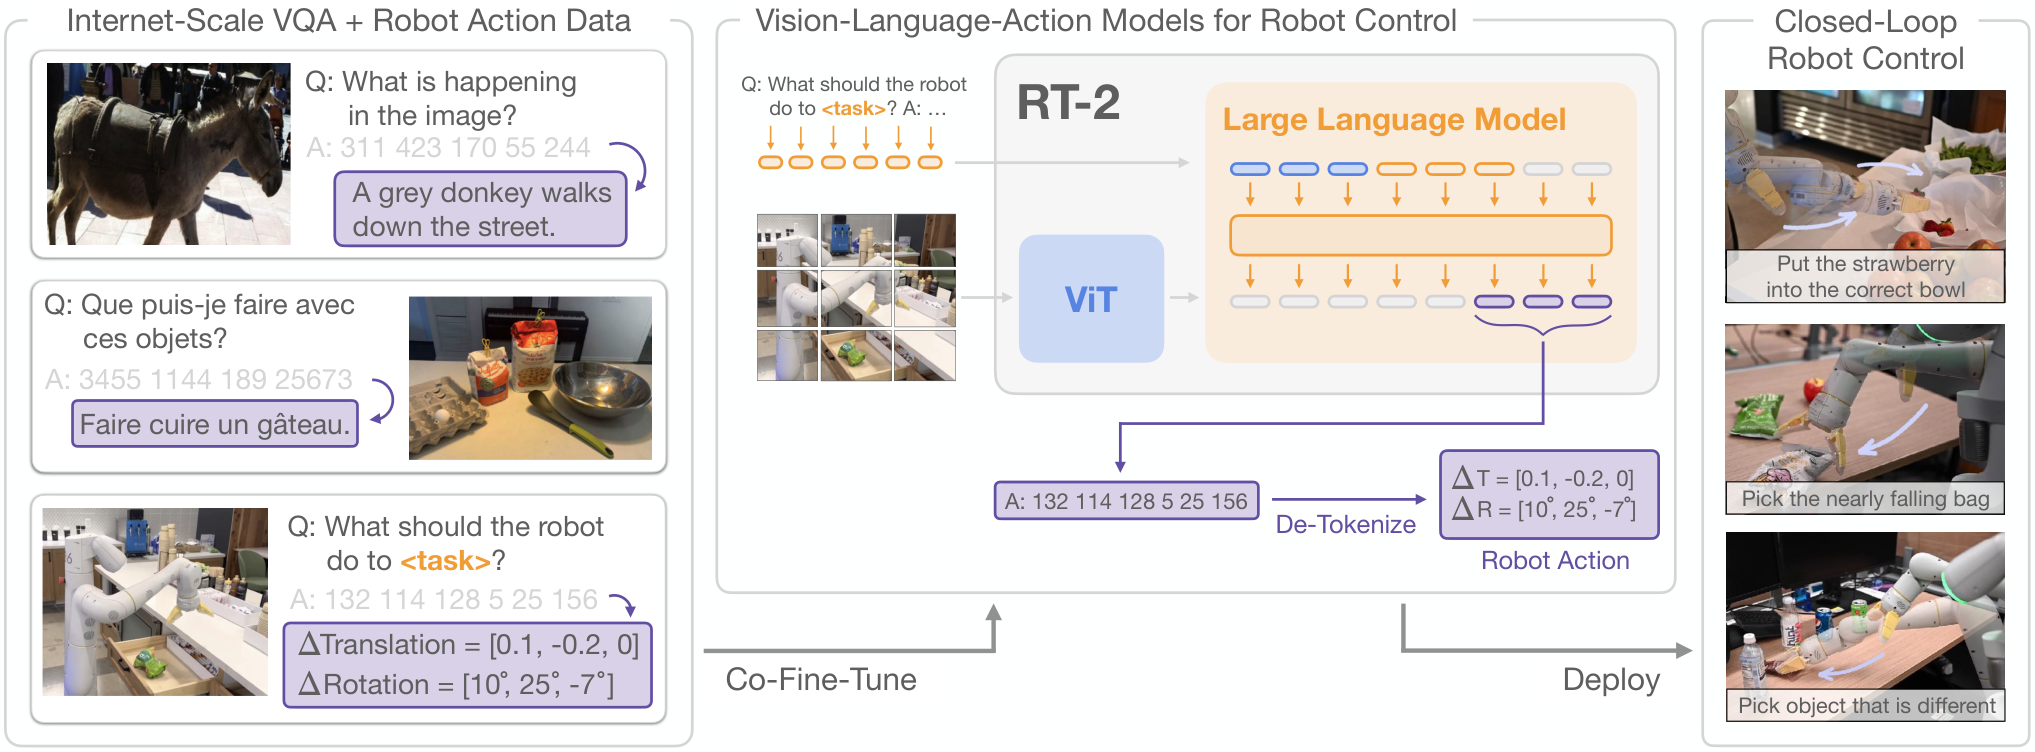
베이스는 두 가지다. **PaLI-X(5B, 55B)**와 PaLM-E(12B). 행동 표현은 RT-1과 같이 차원당 256 구간 이산화지만, 그 구간 번호를 모델의 기존 텍스트 토큰에 매핑한다. PaLI-X는 1,000까지의 정수가 각각 고유 토큰이라 그대로 쓰고, PaLM-E는 가장 드물게 쓰이는 토큰 256개를 덮어쓴다. 그 결과 로봇 행동은 1 128 126 127 135 123 119 127 같은 숫자 문자열이 되고, 모델 입장에서는 VQA 답변과 행동 출력이 같은 문제가 된다.
두 번째 요소는 co-fine-tuning이다. 로봇 데이터만으로 파인튜닝하지 않고 원래의 웹 비전-언어 데이터를 함께 섞는다(PaLI-X는 로봇 데이터 약 50%, PaLM-E는 약 66%). 절제 실험이 이 선택의 무게를 보여 준다. 5B 모델을 처음부터 학습하면 미지 조건 평균 9%, 로봇 데이터로만 파인튜닝하면 42%, co-fine-tuning이면 44%다. 55B에서는 파인튜닝 52% 대 co-fine-tuning **63%**로 차이가 벌어진다. 인터넷 지식을 잊지 않게 유지하는 것이 곧 일반화 성능이다.
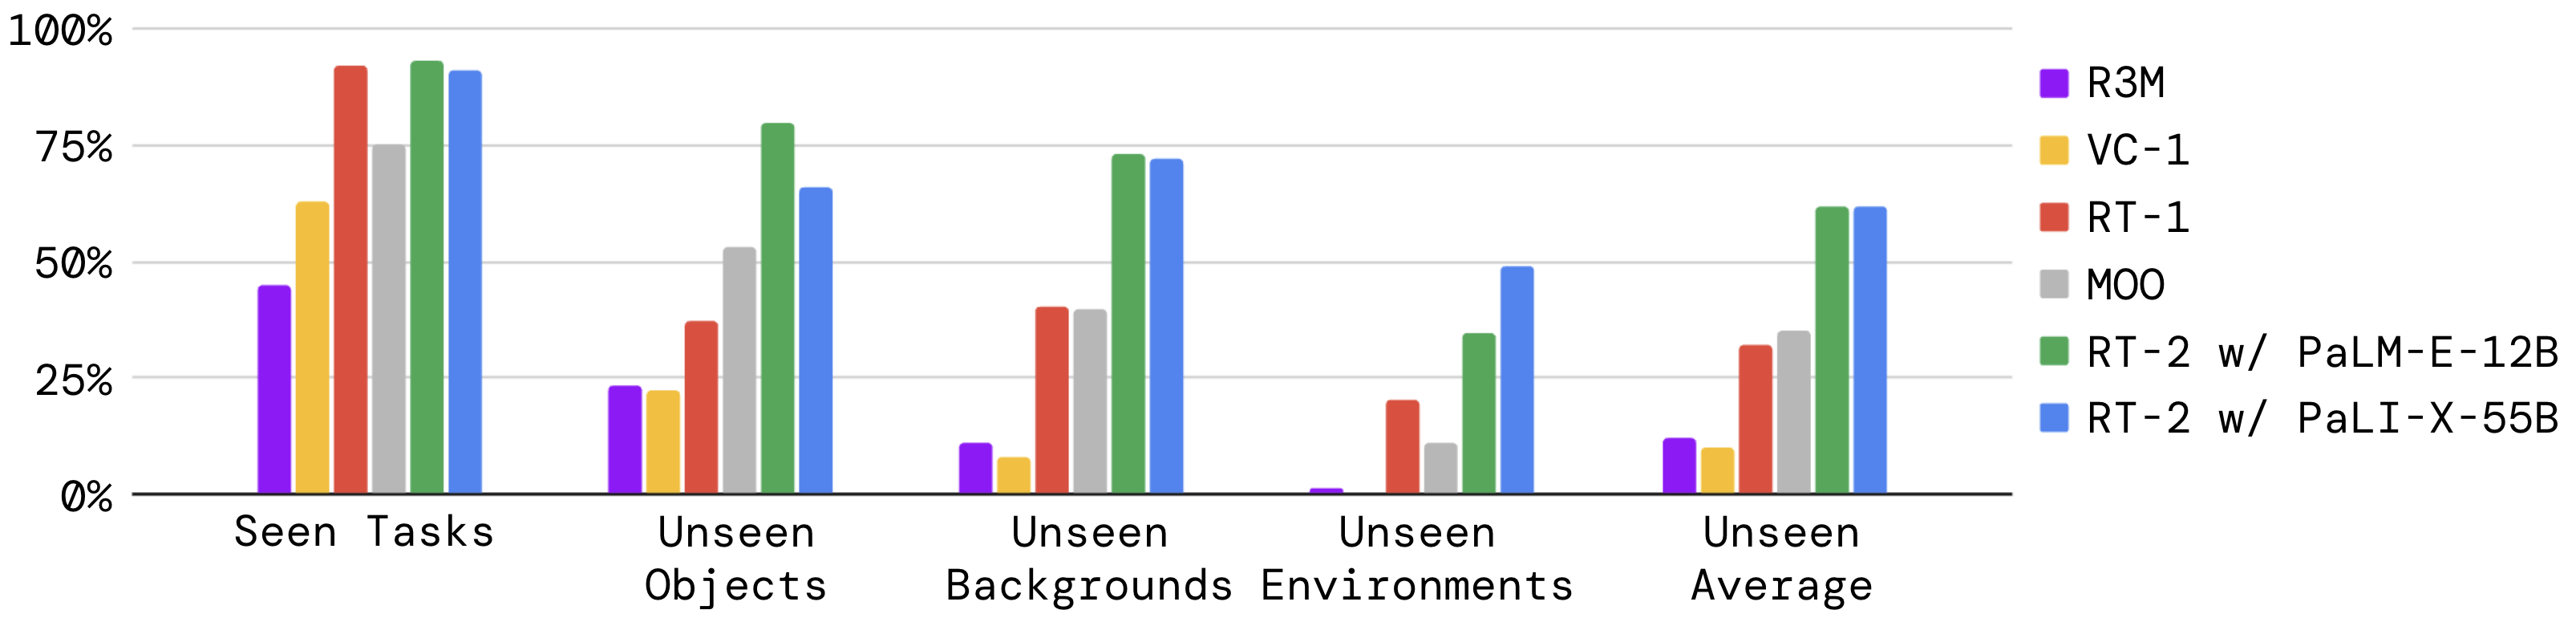
6,000회 이상의 실제 로봇 평가에서 본 과제 성공률은 RT-1과 거의 같다(RT-1 92%, RT-2-PaLI-X-55B 91%, RT-2-PaLM-E-12B 93%). 차이는 미지 조건에서 난다. 새 물체·배경·환경 평균이 RT-1 32%, MOO 35%인 반면 **RT-2는 두 변형 모두 62%**다. 로봇 데이터는 RT-1과 동일하다. 달라진 것은 백본이 인터넷을 읽었다는 사실뿐이다.
더 흥미로운 것은 논문이 **창발 능력(emergent capabilities)**이라 부른 평가다. 숫자나 아이콘 위에 물체 놓기(기호 이해), 가장 작은/큰 물체 집기(추론), 사람 인식 같은 지시는 로봇 데이터에 전혀 없다. 기호 이해에서 RT-2-PaLI-X-55B는 82%, RT-1은 16%였고 전체 평균은 60% 대 17%였다. 같은 과제에서 12B PaLM-E 변형은 40%로, 모델 크기가 창발 능력을 좌우한다는 점도 드러났다.
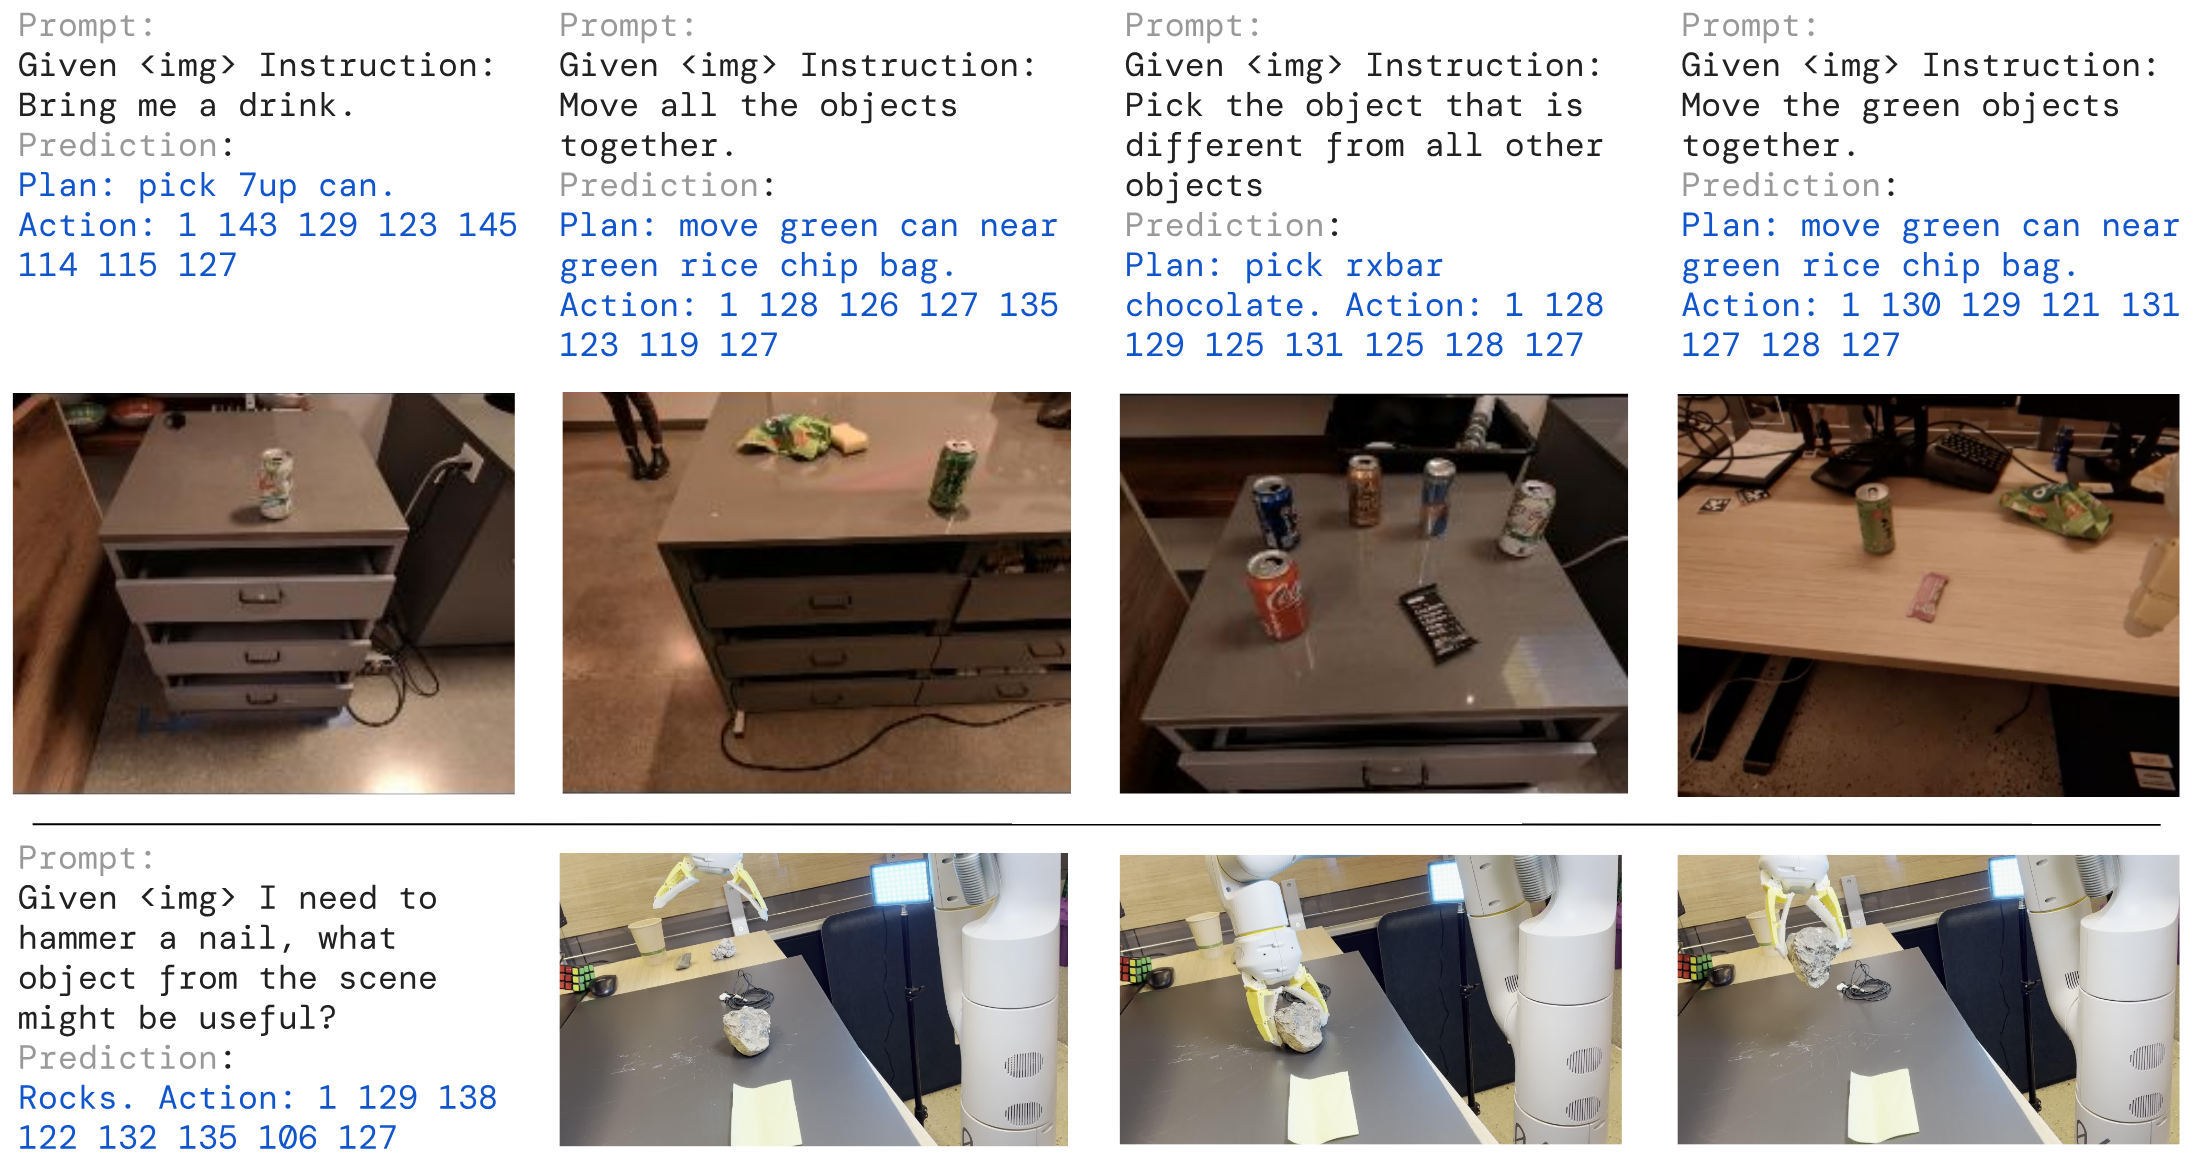
행동이 텍스트이니 chain-of-thought도 자연스럽게 붙는다. 출력 앞에 Plan: pick rxbar chocolate. 같은 계획 문장을 먼저 쓰게 하면, "배고파"라는 지시에서 간식을 고르거나 "못을 박아야 해"에서 돌을 집는 식의 다단계 의미 추론이 하나의 모델 안에서 일어난다. SayCan이 LLM과 정책을 두 모델로 나눠 하던 일을 RT-2는 한 모델의 디코딩으로 수행한다.
실제 로봇 바깥에서도 같은 경향이 확인됐다. 시뮬레이션 벤치마크 Language-Table에서 RT-2-PaLI-3B는 90%(±10)를 기록해 LAVA 77%, RT-1 74%, BC-Zero 72%를 앞섰다. 실제 로봇 평가 6,000회와 합치면, 로봇 데이터를 그대로 둔 채 백본만 바꿨을 때 어떤 일이 생기는지에 대한 상당히 일관된 그림이 나온다.
📐 "인터넷 지식을 행동으로"가 뜻하는 것
RT-1에서 RT-2로의 전환을 표로 놓고 보면 무엇이 바뀌었는지 분명해진다.
| RT-1 (2022.12) | RT-2 (2023.07) | |
|---|---|---|
| 백본 | ImageNet EfficientNet-B3 + USE 문장 임베딩 | 웹 사전학습 VLM (PaLI-X 5B/55B, PaLM-E 12B) |
| 파라미터 | 약 35M | 5B / 12B / 55B |
| 행동 표현 | 11차원, 차원당 256 구간 이산화 → 전용 출력층 | 같은 이산화 → VLM의 텍스트 토큰으로 출력 |
| 학습 데이터 | 로봇 시범 13만 에피소드 | 같은 로봇 데이터 + 웹 VQA/캡션 데이터 co-fine-tuning |
| 본 과제 성공률 | 92% | 91~93% |
| 미지 조건 평균 | 32% | 62% |
| 추론 속도 | 3 Hz (로봇 온보드) | 55B 약 1~3 Hz, 5B 약 5 Hz (다중 TPU 클라우드) |
VLA가 가져온 것은 새로운 손동작이 아니다. RT-2 논문 스스로 한계로 적었듯 로봇은 로봇 데이터에 있던 동작 이상을 얻지 못한다. 대신 얻는 것은 세 가지다.
- 의미 일반화: 처음 보는 물체·단어·배경을 VLM의 시각-언어 공간으로 받아 적절한 (이미 아는) 동작에 연결한다.
- 지시 해석: "가장 작은 것", "피곤한 사람에게 줄 음료"처럼 로봇 데이터에 없는 개념을 언어 공간에서 풀어 행동으로 접지(grounding)한다.
- 단일 모델 계획: 계획과 제어를 한 토큰 열 안에서 처리할 수 있다.
이 세 가지가 "인터넷 지식을 행동으로"의 실제 내용이다. 대가도 있다. 수십억 파라미터 모델을 실시간으로 돌리려면 클라우드 TPU가 필요했고, 이산 토큰을 하나씩 자기회귀로 뽑는 방식은 느리고 정밀한 연속 제어에 불리하다. 논문이 적은 세 번째 한계는 더 현실적이다. RT-2를 만들려면 PaLI-X나 PaLM-E급 VLM이 있어야 하는데, 2023년 시점에 그런 VLM을 가진 조직이 거의 없었다. 모델도 가중치도 공개되지 않았기 때문에 외부 연구자는 결과를 재현할 수 없었고, 이 공백이 2024년 Octo와 OpenVLA 같은 공개 VLA의 동기가 됐다. 2024년 이후의 VLA 연구 대부분은 결국 세 문제, 즉 추론 효율, 행동 표현, 그리고 공개 재현성을 둘러싸고 전개된다.
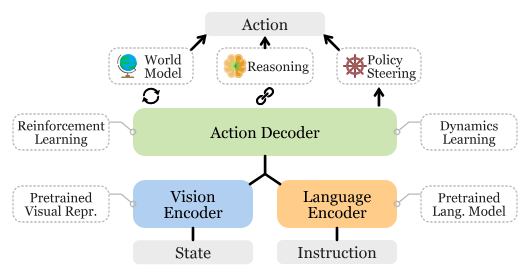
서베이가 그린 일반 구조를 기준으로 보면, 이 시리즈 2편은 가운데 Action Decoder(이산 토큰, FAST, diffusion, flow matching, action expert)를, 4편은 두 인코더에 들어가는 데이터를, 6편은 점선으로 붙은 RL·추론·월드 모델을 다룬다. 월드 모델과 계층적 계획의 관계는 이 블로그의 H-JEPA 글과도 이어진다.
📊 2026년 11월, VLA는 어디까지 왔나
RT-2 이후 3년의 변화를 공식 출처에서 확인한 범위로만 적는다. 상세 계보와 비교표는 3편에서 다룬다.
- Physical Intelligence는 2024년 10월 π0, 2025년 4월 π0.5, 2025년 11월 RL로 경험에서 배우는 π*0.6을 거쳐 2026년 4월 16일 π0.7을 공개했다. 공식 블로그는 π0.7을 "조종 가능한(steerable) 제너럴리스트 모델"로 소개하는데, 프롬프트에 과제 문장뿐 아니라 속도·품질 같은 메타데이터, 제어 방식(관절/엔드이펙터), 월드 모델이 생성한 서브골 이미지까지 넣을 수 있다. 학습 데이터에 UR5e 빨래 접기 데이터가 없었는데도 양팔 UR5e로 빨래를 접었다고 주장한다. 2026년 10월에는 최신 모델을 API 베타(데이터 업로드·파인튜닝·클라우드 추론)로 열었다.
- Google DeepMind의 공식 모델 페이지는 현재 Gemini Robotics 2(비전·언어를 모터 제어로 바꾸는 VLA, "발끝부터 손끝까지" 휴머노이드 전신 제어, "몇 시간이면 어떤 양팔 로봇에도 적응"), Gemini Robotics ER 2(물리 공간 추론·계획), On-Device 2(로봇 온보드 실행)를 나열한다. ER 2는 AI Studio에서 쓸 수 있고 나머지는 대기 명단 방식이다. 발표일은 공식 페이지에 없어 여기선 적지 않는다.
- NVIDIA의 공개 모델 GR00T N1.7은 3B 파라미터, Cosmos-Reason2-2B(Qwen3-VL 계열) 백본에 flow matching DiT 액션 헤드를 쓰고, 2만 시간의 사람 1인칭 영상(EgoScale)을 로봇 데이터와 함께 사전학습했다. 저장소는 TensorRT 기준 RTX PRO 6000에서 약 40 Hz, Jetson AGX Thor에서 약 28 Hz를 제시한다(벤더 주장). 코드는 Apache 2.0, 가중치는 NVIDIA Open Model License다.
세 흐름의 공통점을 꼽으면 (1) VLM 백본은 여전히 중심이고, (2) 행동 헤드는 이산 토큰에서 flow matching 같은 연속 생성으로 옮겨 갔으며, (3) 사람 영상·서브골 이미지·RL 경험처럼 로봇 시범 바깥의 데이터를 끌어오는 것이 경쟁의 축이 됐다는 점이다. 다만 세 회사 모두 성능 수치는 자사 평가이고, 이들을 같은 조건에서 비교한 독립 벤치마크는 아직 없다.
⚠️ 읽을 때 주의할 점
- RT-1·RT-2의 성공률은 Google의 특정 로봇·특정 주방에서 측정한 값이다. 다른 로봇으로 옮기면 그대로 재현되지 않으며, 이것이 4편의 주제인 크로스 임바디먼트 문제다.
- "창발"이라는 표현은 로봇 데이터에 없던 지시를 처리했다는 뜻이지, 없던 동작을 만들었다는 뜻이 아니다.
- VLA라는 용어는 좁게는 Large VLA(VLM 기반), 넓게는 시각·언어·행동을 다루는 모델 전반을 가리킨다. 논문마다 범위가 다르니 어느 의미인지 확인하고 읽는 편이 좋다.
다음 편 VLA 해부: VLM 백본부터 액션 헤드까지에서는 RT-2 이후 모델들이 행동을 어떻게 표현하고 생성하는지, 그리고 왜 flow matching이 주류가 됐는지를 구조 수준에서 뜯어본다.
📚 참고
- Brohan et al., RT-1: Robotics Transformer for Real-World Control at Scale (Google, arXiv 2212.06817, 2022.12) · HTML
- Brohan et al., RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control (Google DeepMind, arXiv 2307.15818, 2023.07) · HTML
- Ma, Song, Zhuang, Hao, King, A Survey on Vision-Language-Action Models for Embodied AI (arXiv 2405.14093, IEEE TNNLS 2025) · HTML
- Physical Intelligence, π0.7: a Steerable Model with Emergent Capabilities (2026.04.16) · 블로그 목록
- Google DeepMind, Gemini Robotics 모델 페이지
- NVIDIA, Isaac-GR00T 저장소 (GR00T N1.7) · GR00T N1 논문
- 이 블로그의 관련 글: H-JEPA 계층적 월드 모델
본 글의 그림은 각 논문(RT-1, RT-2, VLA 서베이)에서 가져왔습니다(출처 표기).