LeRobot로 SmolVLA 파인튜닝하기: 설치부터 평가까지
"Fine-tuning is an art." — LeRobot SmolVLA 문서
이 글은 VLA 시리즈 5편이다. 4편에서 데이터 포맷과 크로스 임바디먼트를 봤으니, 이제 직접 손을 움직일 차례다. Hugging Face의 LeRobot로 SmolVLA(450M)를 내 로봇 데이터 또는 LIBERO 시뮬레이션에 파인튜닝하는 전 과정을 따라간다. 모든 커맨드와 설정 키는 공식 문서(huggingface.co/docs/lerobot)와 main 브랜치 소스(pyproject.toml 기준 v0.6.2)에서 확인한 것만 적었다. GPU가 없어 실행은 못 하더라도, 이름이 틀려서 실패하는 일은 없도록 했다. 다음 편은 6편: 배포와 전망이다.
원문: SmolVLA (arXiv 2506.01844) · LeRobot SmolVLA 문서
🤔 왜 SmolVLA + LeRobot인가
실습 대상으로 SmolVLA를 고른 이유는 셋이다. 첫째, 작다. 논문 기준 전체 450M 파라미터, 액션 익스퍼트는 약 100M이라 A100 한 장은 물론 Colab에서도 돌아간다. 둘째, 공개 커뮤니티 데이터로 사전학습됐다. 481개 LeRobot 데이터셋, 22.9K 에피소드, 10.6M 프레임이 전부이며 데이터셋·코드·가중치가 모두 Apache-2.0이다. 셋째, LeRobot가 만든 모델이라 학습 스크립트·데이터 포맷·평가 환경이 한 저장소 안에서 맞물린다. π0/π0.5도 같은 lerobot-train으로 파인튜닝할 수 있지만(pip install -e ".[pi]", --policy.type=pi0), 3B급이라 입문 실습에는 SmolVLA가 적당하다.
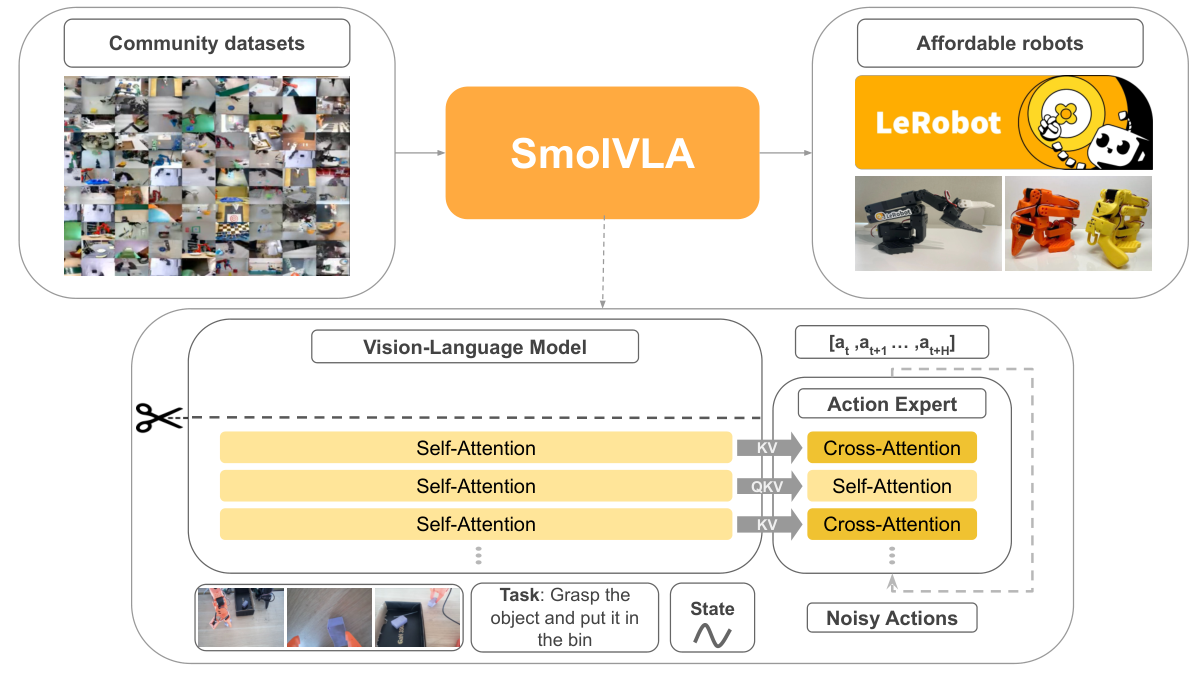
구조는 2편에서 다룬 "VLM + 액션 익스퍼트" 전형이다. 파인튜닝 관점에서 중요한 점만 짚으면, VLM 백본(HuggingFaceTB/SmolVLM2-500M-Video-Instruct)의 앞 16개 레이어만 쓰고(num_vlm_layers=16), 익스퍼트 폭은 VLM의 0.75배(expert_width_multiplier=0.75), 액션 청크 50개(chunk_size=50)를 flow matching 10스텝(num_steps=10)으로 디코딩한다. 그리고 기본 파인튜닝 설정은 VLM을 얼리고 익스퍼트만 학습한다. 이 값들이 전부 configuration_smolvla.py의 데이터클래스 필드라 --policy.<필드명>=값으로 CLI에서 덮어쓸 수 있다.
🛠️ 1. 설치
Python 3.12 이상이 필요하다. 문서는 miniforge(conda)를 권장한다.
conda create -y -n lerobot python=3.12
conda activate lerobot
conda install ffmpeg -c conda-forge   # TorchCodec 비디오 디코딩용

git clone https://github.com/huggingface/lerobot.git
cd lerobot
pip install -e ".[training]"   # 학습: dataset + accelerate + wandb
pip install -e ".[smolvla]"    # SmolVLA 의존성(transformers, num2words, accelerate)
v0.6부터 기본 패키지는 가볍고 기능별 extra로 쪼개져 있다. 실제 로봇 녹화는 [core_scripts](+ SO-100/101이면 [feetech]), LIBERO 시뮬레이션은 [libero](Linux 전용)를 추가한다. PyPI에서 pip install 'lerobot[training,smolvla]'로 설치해도 된다. 설치 확인은 lerobot-info.
📦 2. 데이터셋: LeRobotDataset v3 구조
SmolVLA는 베이스 모델이라 내 환경 데이터로 파인튜닝해야 쓸 만해진다. 문서는 50 에피소드를 시작점으로 권한다. 논문 실험용 lerobot/svla_so100_pickplace는 큐브 위치 5곳 × 10회 = 50 에피소드이며, 25 에피소드로 시도했을 때는 성능이 나쁘게 나왔다고 문서가 명시한다.
녹화
SO-101 리더-팔로워 구성 기준 커맨드다(il_robots 문서).
hf auth login --token ${HUGGINGFACE_TOKEN} --add-to-git-credential
HF_USER=$(NO_COLOR=1 hf auth whoami | awk -F': *' 'NR==1 {print $2}')

lerobot-record \
    --robot.type=so101_follower \
    --robot.port=/dev/tty.usbmodem585A0076841 \
    --robot.id=my_awesome_follower_arm \
    --robot.cameras="{ front: {type: opencv, index_or_path: 0, width: 1920, height: 1080, fps: 30}}" \
    --teleop.type=so101_leader \
    --teleop.port=/dev/tty.usbmodem58760431551 \
    --teleop.id=my_awesome_leader_arm \
    --display_data=true \
    --dataset.repo_id=${HF_USER}/record-test \
    --dataset.num_episodes=5 \
    --dataset.single_task="Grab the black cube" \
    --dataset.streaming_encoding=true \
    --dataset.encoder_threads=2
--dataset.episode_time_s(기본 60초)·--dataset.reset_time_s(기본 60초)·--dataset.num_episodes(기본 50)로 흐름을 조절하고, 녹화 중 →/n은 다음 에피소드, ←/r은 재녹화, ESC/q는 종료·인코딩·업로드다. 끝나면 기본으로 Hub에 올라가며(--dataset.push_to_hub=False로 끌 수 있다) 로컬 사본은 ~/.cache/huggingface/lerobot/{repo-id}에 남는다. 이어서 녹화하려면 같은 커맨드에 --resume=true를 붙이되, 이때 num_episodes는 추가할 개수다.
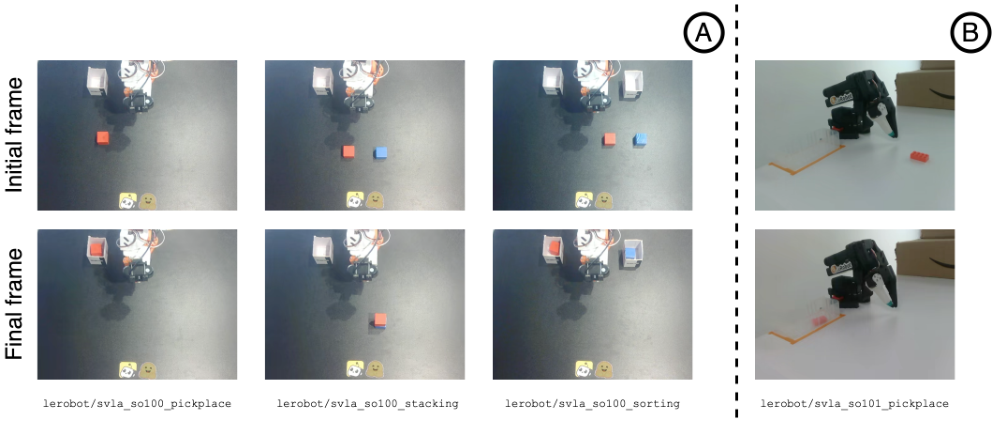
데이터 수집 팁은 문서 그대로다. 카메라를 고정하고, 잡는 방식을 일관되게 하고, 조작 대상이 카메라에 항상 보이게 한다. "카메라 화면만 보고 내가 그 일을 할 수 있는가"가 기준이다. 변형(위치·물체·조명)은 기본 성공률이 나온 뒤 조금씩 늘린다.
디스크 구조
v3.0(lerobot >= 0.4.0)은 에피소드 단위 파일 대신 여러 에피소드를 큰 파일로 묶고 메타데이터로 경계를 찾는다.
my_dataset/
├── meta/
│   ├── info.json       # 피처 스키마(이름·dtype·shape), fps, 코드 버전, 경로 템플릿
│   ├── stats.json      # 피처별 mean/std/min/max → 정규화에 사용
│   ├── tasks.jsonl     # 자연어 태스크 ↔ 정수 ID
│   └── episodes/       # 에피소드별 길이·태스크·오프셋 (chunked parquet)
├── data/               # 프레임 단위 parquet (한 파일에 여러 에피소드)
└── videos/             # 카메라별 mp4 (한 파일에 여러 에피소드)
피처 키는 observation.state, action, observation.images.<카메라명>, timestamp, episode_index 등이다. LeRobotDataset(repo_id)로 불러오면 인덱스마다 텐서 딕셔너리를 돌려주고 delta_timestamps로 시간 창을 지정한다. 기존 v2.1 데이터셋은 python -m lerobot.scripts.convert_dataset_v21_to_v30 --repo-id=<HF_USER/DATASET_ID>로 변환한다. 파이썬 API로 직접 만들 때는 push_to_hub() 전에 반드시 dataset.finalize() 를 호출해야 parquet 푸터가 써진다.
LIBERO 데이터셋
실로봇이 없다면 LIBERO로 같은 파이프라인을 연습할 수 있다. LeRobot가 변환해 둔 데이터셋이 둘 있는데, 내용은 같고 저장 방식만 다르다.
lerobot/libero |
HuggingFaceVLA/libero |
|
|---|---|---|
| 에피소드 / 프레임 / 태스크 | 1,693 / 273,465 / 40 | 동일 |
| 카메라 | 2 × 256×256×3 (observation.images.image, image2) |
동일 |
| state / action 차원 | 8 / 7 | 동일 |
| 영상 인코딩 | MP4 (torchcodec 또는 pyav 필요) | parquet 안 PNG |
| 다운로드 | 1.9 GB | 69.9 GB |
문서는 lerobot/libero를 권장한다(37배 작고 로딩 속도는 동등). 결과를 보고할 때는 --dataset.revision=<commit-sha>를 고정하라는 조언도 있다.
🚀 3. 파인튜닝 커맨드
내 데이터로 (사전학습 가중치에서 시작)
cd lerobot && lerobot-train \
  --policy.path=lerobot/smolvla_base \
  --dataset.repo_id=${HF_USER}/mydataset \
  --batch_size=64 \
  --steps=20000 \
  --output_dir=outputs/train/my_smolvla \
  --job_name=my_smolvla_training \
  --policy.device=cuda \
  --wandb.enable=true
--policy.path가 핵심이다. Hub의 lerobot/smolvla_base에서 config와 가중치를 함께 불러오고, 그 뒤에 오는 --policy.* 인자는 그 config를 덮어쓴다(TrainPipelineConfig.validate()가 parser.get_path_arg("policy")로 처리). 문서 기준 20k 스텝이 A100 한 장에서 약 4시간이다. 메모리가 부족하면 배치를 줄이고, 로딩 시간이 짧게 유지되는 한 올린다. 옵션 전체는 lerobot-train --help.
학습 중 체크포인트는 outputs/train/my_smolvla/checkpoints/<step>/pretrained_model/에 --save_freq(기본 20,000) 간격으로 저장되고, 중단 뒤 재개는 다음과 같다.
lerobot-train \
  --config_path=outputs/train/my_smolvla/checkpoints/last/pretrained_model/train_config.json \
  --resume=true
학습이 끝나면 --policy.repo_id=${HF_USER}/my_smolvla를 줬을 때 Hub에 푸시되며, 원치 않으면 --policy.push_to_hub=false.
LIBERO로 (VLM만 사전학습, 익스퍼트는 처음부터)
export MUJOCO_GL=egl   # 헤드리스 서버
lerobot-train \
  --policy.type=smolvla \
  --policy.load_vlm_weights=true \
  --policy.push_to_hub=false \
  --dataset.repo_id=lerobot/libero \
  --dataset.video_backend=torchcodec \
  --output_dir=./outputs/libero_smolvla \
  --steps=100000 \
  --batch_size=64
위 커맨드는 문서의 예시 그대로인데, --policy.path 대신 --policy.type=smolvla를 쓴 점에 주목하자. 이 경우 SmolVLA config의 기본값(load_vlm_weights=False)으로 시작하므로 --policy.load_vlm_weights=true를 줘야 VLM이 SmolVLM2 가중치를 받고, 액션 익스퍼트는 랜덤 초기화된다. 논문의 시뮬레이션 파인튜닝 설정(100k 스텝, 배치 64)과 같다. 로봇 사전학습을 활용하고 싶다면 --policy.path=lerobot/smolvla_base --dataset.repo_id=lerobot/libero로 바꾸면 된다.
알아둘 기본값
TrainPipelineConfig와 SmolVLAConfig의 기본값 중 실습에서 건드릴 만한 것만 추렸다.
| 키 | 기본값 | 의미 |
|---|---|---|
--steps |
100,000 | 총 학습 스텝 |
--batch_size |
8 | SmolVLA 문서는 64 권장 |
--save_freq / --log_freq |
20,000 / 200 | 체크포인트·로그 간격 |
--num_workers |
4 | 데이터로더 워커 |
--policy.optimizer_lr |
1e-4 | AdamW, β=(0.9, 0.95) |
--policy.scheduler_warmup_steps / scheduler_decay_steps |
1,000 / 30,000 | 코사인 감쇠, 최종 lr 2.5e-6 |
--policy.chunk_size / n_action_steps |
50 / 50 | 청크 길이 / 한 번에 실행할 스텝 |
--policy.resize_imgs_with_padding |
(512, 512) | 패딩 리사이즈 |
--policy.tokenizer_max_length |
48 | 태스크 문장 토큰 상한 |
--policy.max_state_dim / max_action_dim |
32 / 32 | 짧으면 패딩 |
정규화는 normalization_mapping에 따라 STATE·ACTION은 MEAN_STD, VISUAL은 IDENTITY다. 즉 이미지는 그대로 들어가고 상태·액션만 meta/stats.json의 평균·표준편차로 정규화된다.
🧊 4. 동결 전략: 무엇을 학습시킬 것인가
SmolVLA config의 파인튜닝 플래그는 세 개이고 기본값은 모두 True다.
| 플래그 | 기본 | 효과 |
|---|---|---|
--policy.freeze_vision_encoder |
True |
SigLIP 비전 인코더 동결 |
--policy.train_expert_only |
True |
VLM 전체 동결, 액션 익스퍼트만 학습 |
--policy.train_state_proj |
True |
상태 투영층(state_proj) 학습 (set_requires_grad에서 처리) |
즉 기본 파인튜닝은 "익스퍼트(약 100M) + 상태 투영"만 학습한다. 논문도 사전학습·파인튜닝 모두 VLM을 얼리고 익스퍼트만 학습했다고 밝히며, VLM 전체 파인튜닝과의 비교는 보고하지 않았다. 참고로 π0 문서에서는 같은 두 플래그의 기본값이 false(전체 학습)이고, train_expert_only=true로 바꾸면 메모리를 줄일 수 있다고 안내한다. 선택 기준을 정리하면 이렇다.
- 데이터 50~200 에피소드, 단일 로봇: 기본값 유지. 가장 적은 VRAM, 과적합 위험도 낮다.
- 카메라·조명이 사전학습 분포와 많이 다름:
--policy.freeze_vision_encoder=false를 시도. 다만 익스퍼트 그라디언트가 VLM을 거쳐 SigLIP까지 흘러야 하므로train_expert_only=false가 함께 필요하다. - 데이터가 수천 에피소드 이상, 언어 지시가 다양함:
--policy.train_expert_only=false로 VLM까지 학습. 메모리·시간이 크게 늘고 lr을 낮춰야 할 가능성이 높다(문서에 권장 lr은 없다).
LoRA(PEFT)
main 브랜치에는 PEFT 연동이 들어 있다(pip install -e ".[peft]"). --policy.path로 사전학습 모델을 지정한 뒤 --policy.use_peft=true 또는 --peft.* 옵션을 주면 policy.wrap_with_peft()로 어댑터가 감싸진다. PeftConfig의 필드는 method_type(기본 "LORA"), r(기본 16), lora_alpha, target_modules(문자열·리스트·정규식, 정책별 기본값 있음), full_training_modules(어댑터와 함께 완전 학습·저장할 모듈, PEFT의 modules_to_save), init_type이다. 저장 시에는 get_base_model()과 어댑터가 함께 처리된다. 단, 이 글을 쓰는 시점의 안정 문서(v0.6.1)에는 PEFT 페이지가 없고 소스 코드로만 확인했으므로, 사용 전 lerobot-train --help로 --peft 섹션이 보이는지 먼저 확인하자.
📊 5. 평가
시뮬레이션: lerobot-eval
LIBERO 네 표준 스위트를 태스크당 10 에피소드씩 돌리는 권장 커맨드다(총 400 에피소드, 논문 보고 프로토콜과 동일).
lerobot-eval \
  --policy.path=./outputs/libero_smolvla/checkpoints/last/pretrained_model \
  --env.type=libero \
  --env.task=libero_spatial,libero_object,libero_goal,libero_10 \
  --eval.batch_size=1 \
  --eval.n_episodes=10 \
  --env.max_parallel_tasks=1
--env.task는 스위트 이름(libero_spatial, libero_object, libero_goal, libero_10, libero_90), --env.task_ids=[0]로 특정 태스크만, --eval.batch_size는 병렬 환경 수(EvalConfig 기본값은 n_episodes=50, batch_size=0=자동)다. 시드별로 몇 % 흔들리므로 3개 시드 평균을 권한다. 두 정책을 같은 에피소드로 비교하려면 --seed를 맞추고 --env.init_states=true를 켠다. --env.control_mode=relative|absolute는 체크포인트의 액션 파라미터화와 맞춰야 한다. 참고 수치로, 논문의 SmolVLA 0.45B는 LIBERO 평균 87.3%(Spatial 90 / Object 96 / Goal 92 / Long 71)이고, LeRobot가 재현한 π0.5 파인튜닝은 평균 97.5%다.
실로봇: lerobot-rollout
lerobot-rollout \
  --strategy.type=base \
  --robot.type=so101_follower \
  --robot.port=/dev/ttyACM0 \
  --robot.id=my_blue_follower_arm \
  --robot.cameras="{ front: {type: opencv, index_or_path: 8, width: 640, height: 480, fps: 30}}" \
  --task="Grasp a lego block and put it in the bin." \
  --policy.path=${HF_USER}/my_smolvla
--task는 녹화 때 쓴 문장과 똑같이 준다. --strategy.type은 base(녹화 없음), sentry(계속 녹화·자동 업로드), episodic(에피소드 단위 리셋), dagger(사람 개입) 중 고른다. 느린 VLA에는 --inference.type=rtc(Real-Time Chunking)를 켤 수 있다.
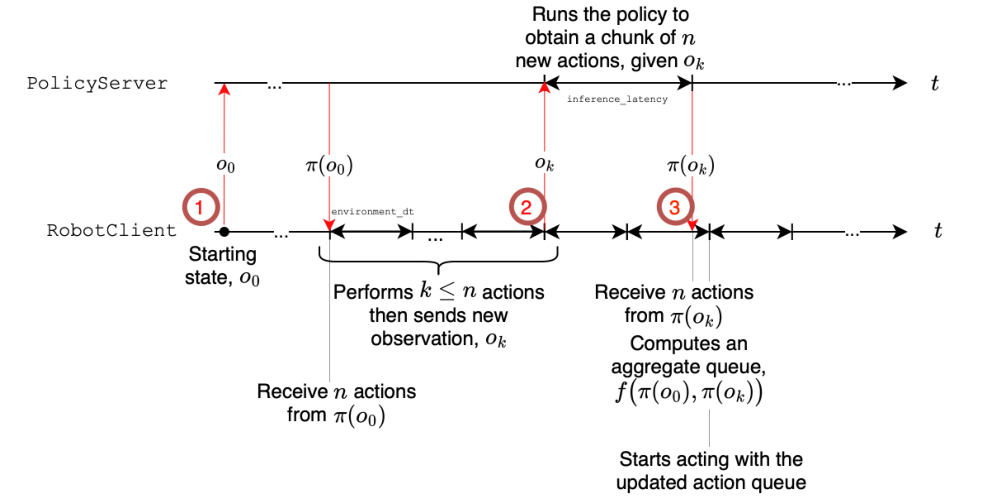
논문은 이 비동기 스택으로 SO-100 과제 완료 시간을 13.75초에서 9.70초로 약 30% 줄였고, 고정 시간 안에 pick-place 사이클을 9회에서 19회로 늘렸다(성공률은 평균 78.3→73.3으로 소폭 하락). 배포 쪽 이야기는 6편에서 이어간다.
⚠️ 6. 흔한 실패와 대처
과적합. 50 에피소드에 20만 스텝을 돌리면 학습 손실은 내려가지만 로봇은 데모를 통째로 외운 듯 특정 위치에서만 성공한다. 문서가 20k 스텝을 시작점으로 둔 이유다. --save_freq를 줄여 중간 체크포인트(checkpoints/010000 등)를 여러 개 남기고 실제 성공률로 고른다. 손실값은 성공률의 대리 지표가 아니다. 논문 Table 5가 보여주듯 성능 차이는 스텝 수보다 데이터(단일 과제 40% → 다중 과제 51.7% → 커뮤니티 사전학습 78.3%)에서 더 크게 난다.
카메라 키 불일치. observation.images.<이름>은 정규화 통계 층에 인코딩되므로 학습 데이터와 평가 환경의 키가 다르면 바로 깨진다. LIBERO는 observation.images.image(agentview)와 image2(손목)를 쓴다. 키가 다르면 lerobot-train/lerobot-eval 모두 지원하는 --rename_map으로 맞춘다(사전학습 체크포인트가 있을 때만 유효). 카메라 수가 사전학습과 다를 때는 --policy.empty_cameras=N으로 빈 카메라를 채우는 옵션도 있다(smolvla_aloha_sim이 사용).
정규화 통계. 상태·액션은 meta/stats.json의 mean/std로 정규화된다. 녹화 뒤 에피소드를 지우거나 합쳤다면 통계가 어긋날 수 있다. π0 문서의 lerobot-edit-dataset --operation.type recompute_stats가 통계 재계산 진입점이다. 녹화 중 finalize()를 안 불렀다면 parquet 자체가 깨져 로딩이 안 된다.
fps·타임스탬프. --tolerance_s(기본 1e-4)보다 큰 타임스탬프 오차가 있으면 데이터셋 로딩에서 실패한다. 다른 fps로 녹화한 에피소드를 섞지 않는다.
태스크 문장. 토크나이저 상한이 48 토큰(tokenizer_max_length)이고, 평가 때 --task가 녹화 문장과 다르면 조건부가 어긋난다. 문서 예시처럼 같은 문자열을 그대로 쓴다.
VRAM. --batch_size를 줄이는 것이 첫 번째 수단이다. --policy.dtype=bfloat16은 PreTrainedConfig 공통 필드이며 논문도 bf16 + torch.compile()(--policy.compile_model=true)로 학습했다. [libero]는 Linux에서만 설치되고 헤드리스면 MUJOCO_GL=egl을 잊지 말자.
💰 7. 비용
문서가 밝힌 수치는 하나다. SmolVLA 20k 스텝 ≈ A100 1장 4시간. 여기에 공개 단가를 곱하면 감이 온다. lerobot-train은 --job.target=<flavor>만 붙이면 Hugging Face Jobs에서 같은 커맨드가 그대로 돈다(분 단위 과금, 기본 타임아웃 2일).
| 하드웨어(HF Jobs) | GPU 메모리 | 시간당 | 20k 스텝(≈4h) 추정 |
|---|---|---|---|
a10g-small |
24 GB | $1.00 | 시간 미확인(A100보다 느림) |
a100-large |
80 GB | $2.50 | 약 $10 |
h200 |
141 GB | $5.00 | 미확인 |
즉 데이터 50 에피소드짜리 실습 한 바퀴는 커피 두세 잔 값이다. LIBERO 100k 스텝은 문서에 시간이 없어 단순 비례(5배)로 20시간·$50 정도로 짐작할 수 있으나 확인된 수치는 아니다. 참고로 LeRobot가 π0.5를 LIBERO에 추가 파인튜닝할 때는 H100 8장, 배치 256, 6k 스텝을 썼다. GPU가 전혀 없다면 공식 Colab 노트북(training-smolvla.ipynb)이 있다.
lerobot-train \
  --policy.path=lerobot/smolvla_base \
  --dataset.repo_id=${HF_USER}/mydataset \
  --policy.repo_id=${HF_USER}/my_smolvla \
  --batch_size=64 --steps=20000 \
  --job.target=a100-large --job.timeout=6h
🔍 정리
LeRobot 파인튜닝의 뼈대는 네 줄이다. lerobot-record로 50 에피소드를 v3 포맷으로 녹화하고, lerobot-train --policy.path=lerobot/smolvla_base로 익스퍼트만 20k 스텝 학습하고, lerobot-eval(시뮬) 또는 lerobot-rollout(실로봇)으로 성공률을 재고, 체크포인트를 성공률로 고른다. 실패의 대부분은 모델이 아니라 데이터(에피소드 수, 카메라 키, 정규화 통계, 태스크 문장)에서 나온다. 다음 6편에서는 이렇게 만든 정책을 실시간으로 돌리는 문제, 즉 지연·청킹·양자화와 RL 사후학습을 다룬다.
📚 참고
- Shukor et al., "SmolVLA: A Vision-Language-Action Model for Affordable and Efficient Robotics", arXiv 2506.01844
- LeRobot 문서: SmolVLA, Installation, LeRobotDataset v3.0, Imitation Learning on Real-World Robots, LIBERO, π0
- LeRobot 소스(
main, v0.6.2):configuration_smolvla.py,configs/train.py,configs/default.py,scripts/lerobot_train.py,scripts/lerobot_eval.py - 모델·데이터: lerobot/smolvla_base, lerobot/libero, lerobot/svla_so100_pickplace
- Hugging Face Jobs 가격
- Liu et al., "LIBERO: Benchmarking Knowledge Transfer for Lifelong Robot Learning", arXiv 2306.03310
본 글의 그림은 SmolVLA 논문(arXiv 2506.01844)에서 가져왔습니다.