확산 언어 모델 에이전트의 메타인지 디코딩: 토큰을 언제 확정하고 어디서 멈출지 배우는 플러그인
"확산 모델은 토큰을 고정 크기 블록으로 처리하기 때문에, 도구 호출이 끝난 경계 너머의 꼬리 토큰을 쓸데없이 계산하고 결국 버린다." — 논문 1절
2026년 10월 27일 럿거스대학교의 Mingyu Zhao, Shuhang Lin(공동 1저자), Ligong Han, Dimitris Metaxas 등이 Metacognitive Decoding: Efficient Inference for Diffusion Language Agents(arXiv 2610.37642, 10월 30일 v2)를 공개했다. 코드는 github.com/IlluminatingFish/metacognitive-controller에 있다(11월 3일 기준 스타 0, 라이선스 파일 없음, README에 "멀티홉 QA 인터페이스는 이 버전에 포함되지 않음"이라고 적혀 있다). 이 블로그는 KV 캐시나 하네스 비용처럼 자기회귀 모델의 추론 비용은 여러 번 다뤘지만 확산 언어 모델은 처음이라, 글의 앞 3분의 1은 확산 언어 모델이 어떻게 생성하는지부터 정리한다.
원문: https://arxiv.org/abs/2610.37642
🧩 입문: 확산 언어 모델은 어떻게 텍스트를 만드는가
자기회귀(AR) 모델은 토큰을 왼쪽에서 오른쪽으로 하나씩 뽑는다. 토큰 하나당 forward 한 번이고, KV 캐시 덕에 각 forward는 새 토큰 한 위치만 계산한다. 길이는 EOS가 나올 때까지 자유롭게 늘어난다. 마스크 확산 언어 모델(masked diffusion LM, dLLM)은 이 과정을 뒤집는다. 응답 길이 L만큼 [MASK] 토큰을 깔아 놓고, 매 스텝 모든 마스크 위치의 토큰 분포를 동시에 예측한 뒤 그중 일부만 확정(reveal)하고 나머지는 다시 마스크로 둔다. 이를 T번 반복하면 T번의 forward로 L개의 토큰이 나온다. 학습 목표는 BERT식 마스크 복원이지만 마스크 비율을 0~1 사이에서 무작위로 뽑아 가중치를 준 형태이고(Sahoo et al., 2024), LLaDA(Nie et al., 2025)가 이 방식으로 8B 규모에서 instruction-following과 추론이 되는 것을 보였다.
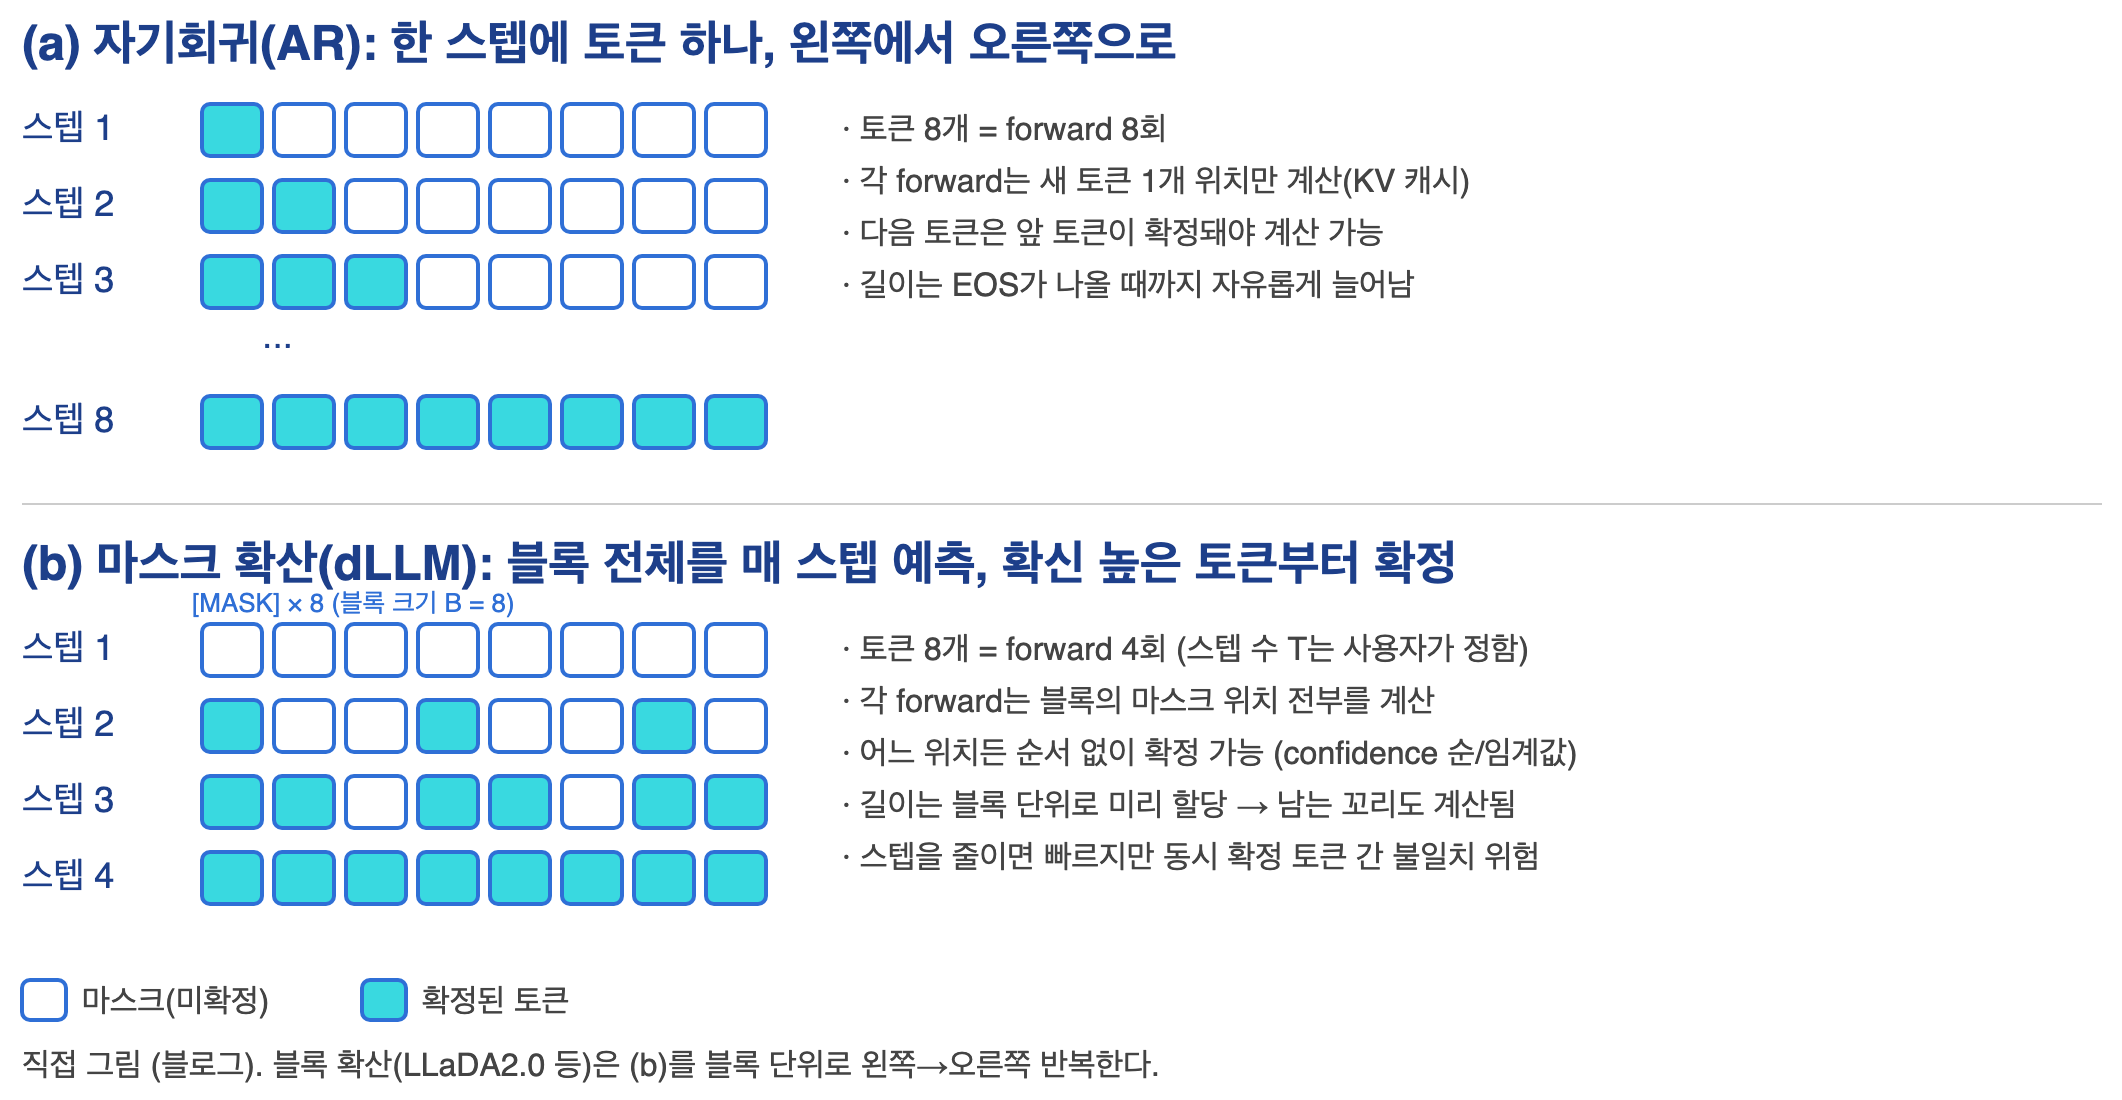
위 그림은 이 글을 위해 직접 그린 것이다. 세 가지가 중요하다.
첫째, 어떤 토큰을 먼저 확정할지는 디코딩 정책이 정한다. 가장 단순한 방법은 매 스텝 L/T개를 confidence(argmax 확률) 순으로 고르는 것이고(LLaDA), Fast-dLLM(Wu et al., 2026)은 confidence가 임계값을 넘는 토큰은 개수 제한 없이 한꺼번에 확정한다. 엔트로피 상한으로 개수를 정하거나(Ben-Hamu et al., 2025), 이전 스텝의 예측 이력을 쓰거나(SlowFast, CreditDecoding), 이미 확정한 토큰을 다시 마스크해 고치는(ReMDM) 변형도 있다. 논문의 관련 연구 절이 이 계보를 정리하고 있다.
둘째, 스텝 수 T는 속도와 품질을 맞바꾸는 손잡이다. T를 줄이면 forward가 줄지만 한 스텝에 여러 토큰을 동시에 확정하므로, 각 위치가 독립적으로 뽑힌 토큰끼리 서로 맞지 않는 경우가 생긴다. 논문도 "여러 토큰을 한 스텝에 드러내면 모델 평가 횟수는 줄지만 생성 품질이 떨어질 수 있다"고 적는다. 그래서 위의 정책들은 대부분 "확실한 토큰은 많이, 불확실한 토큰은 조금씩" 확정하려는 시도다.
셋째, 길이를 미리 정해야 한다. 순수 마스크 확산은 응답 길이를 처음에 고정하고, 블록 확산(Block Diffusion, Arriola et al., 2025; LLaDA2.0, Bie et al., 2025)은 블록 안에서는 병렬 디노이징, 블록 사이에서는 자기회귀로 이어 붙여 가변 길이를 지원한다. 논문이 쓰는 백본이 이 블록 확산이고, 컨텍스트 c와 K개의 블록에 대해 확률은 다음처럼 쪼개진다.
앞 식이 블록 단위 인수분해(논문 식 1), 뒤 식이 각 마스크 위치 i에서 백본이 내놓는 예측 토큰과 그 confidence(식 2)다. 블록 크기 B(저장소 설정은 48)만큼의 칸이 한 번에 할당되므로, 응답이 블록 중간에서 끝나면 남은 칸도 디노이징이 끝날 때까지 계속 계산된다. 에이전트에서 이게 문제가 되는 이유는 다음 절에서 나온다.
🤔 배경: 에이전트는 왜 확산 디코딩에 안 맞는가
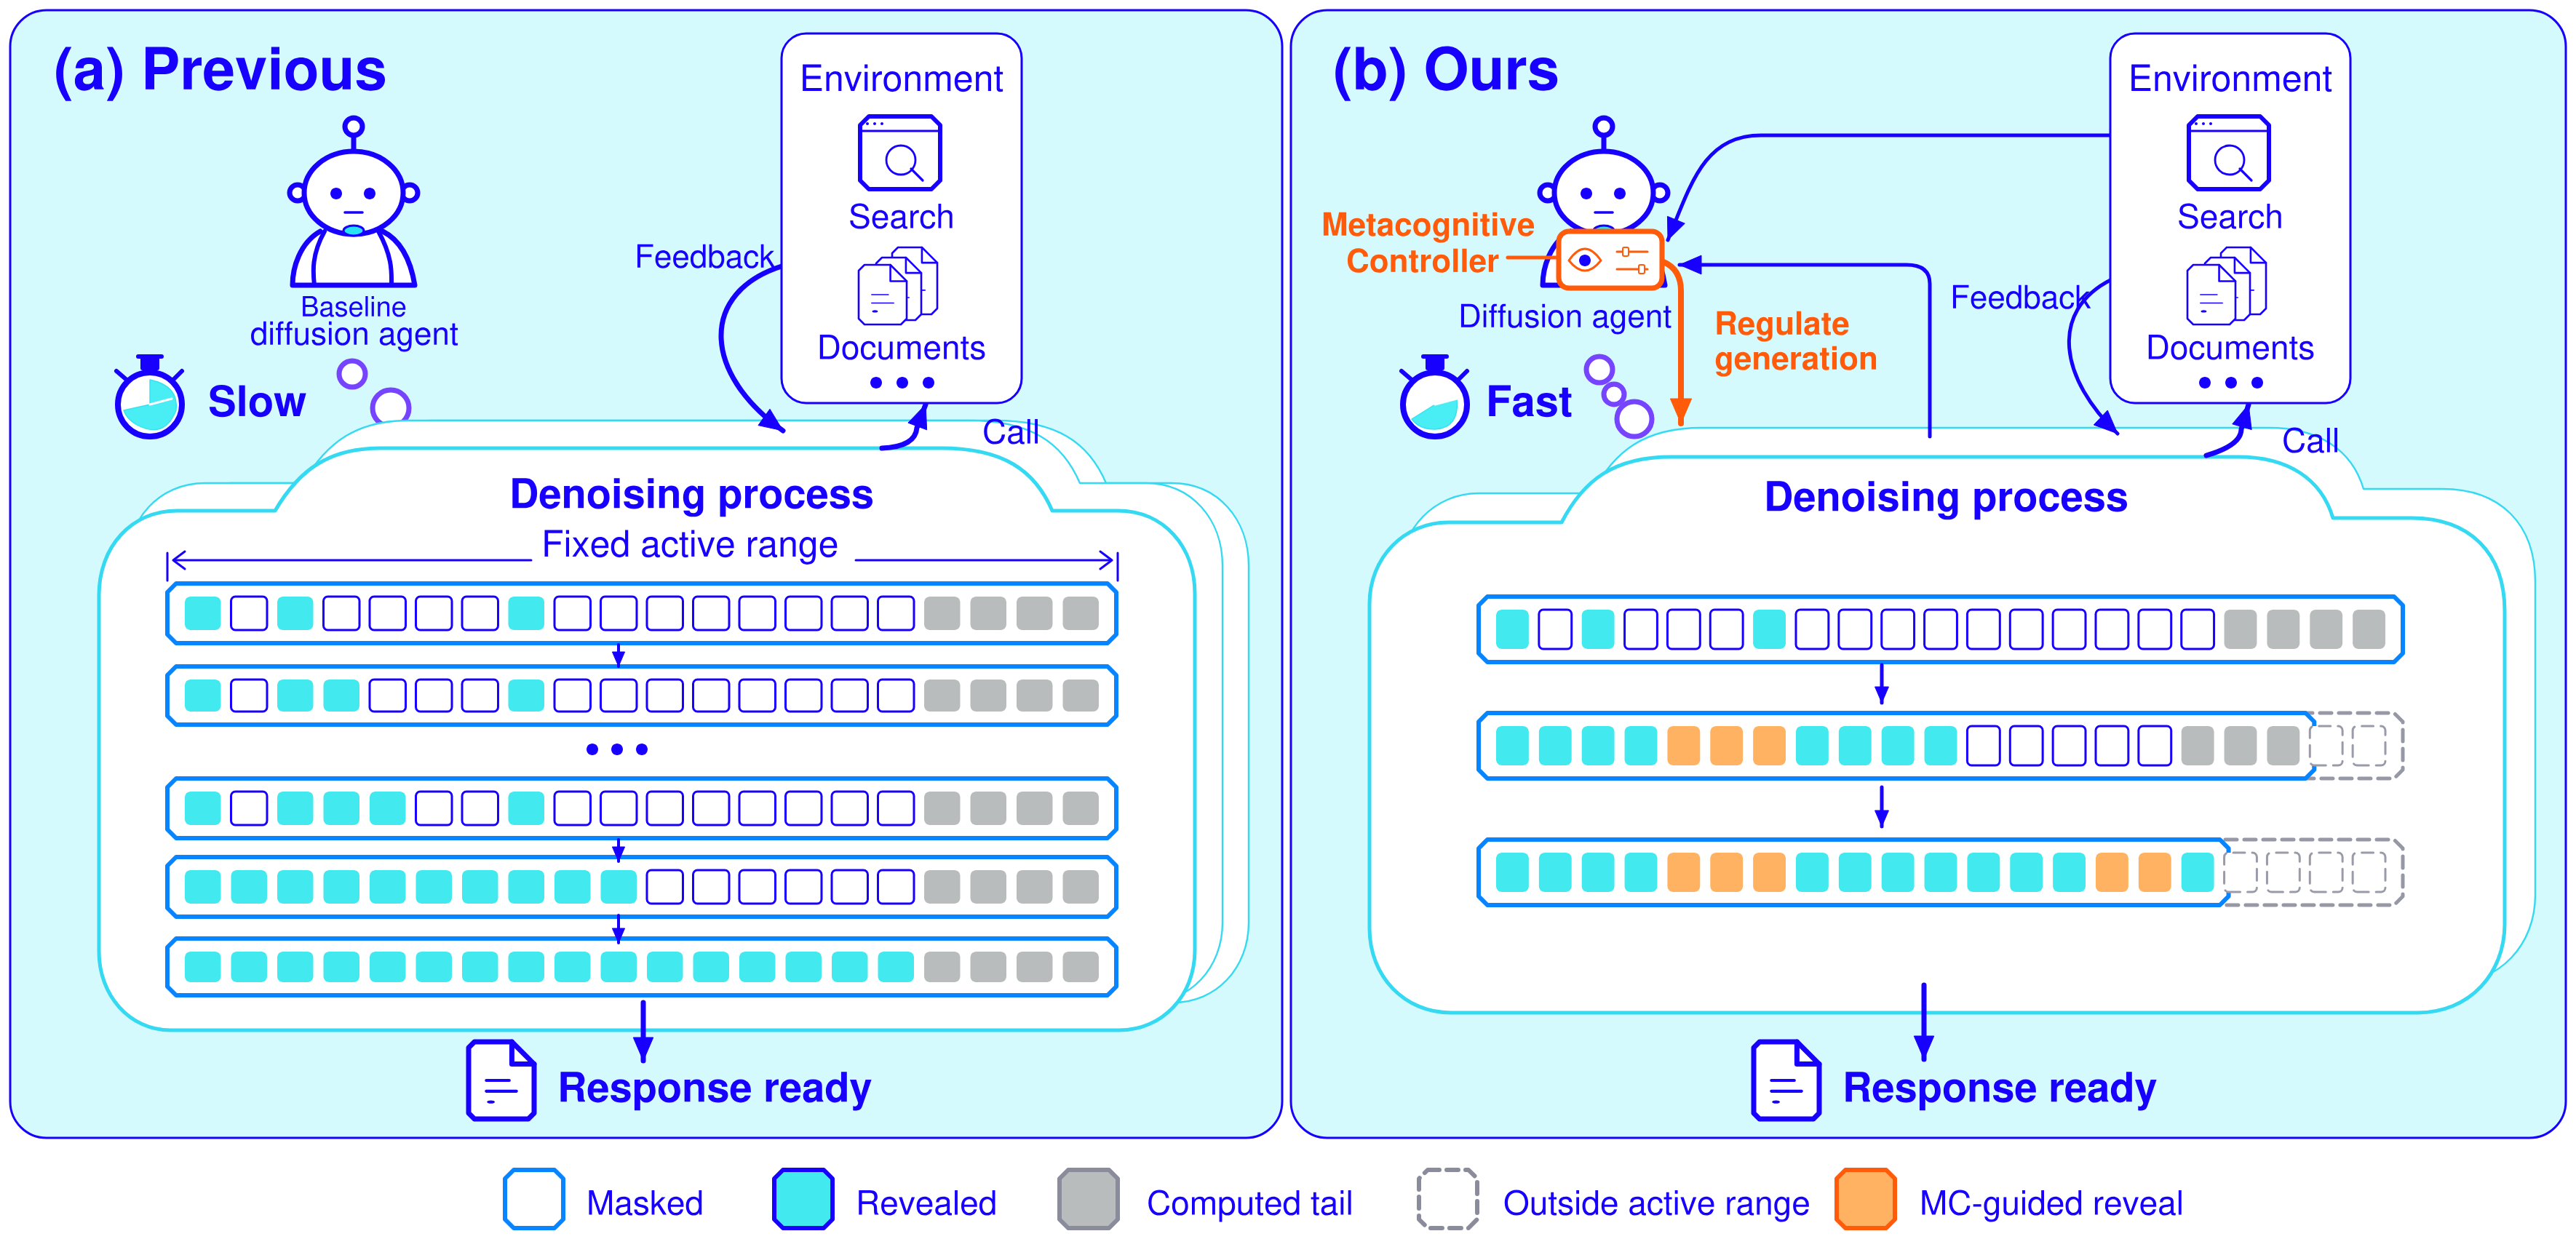
저자들은 에이전트 응답의 두 가지 구조적 특징이 균일한 디코딩과 충돌한다고 본다.
첫째, 에이전트 출력은 매우 예측 가능한 서식(도구 호출 JSON 템플릿, <think>·</tool_call> 같은 태그)과 어려운 추론이 섞여 있다. 모든 토큰을 같은 규칙으로 확정하면 쉬운 토큰에 스텝을 낭비하거나 어려운 토큰을 너무 일찍 확정해 틀린다.
둘째, 에이전트에는 실행 경계가 있다. 도구 호출을 만들고 나면 환경 응답을 기다려야 하므로 그 뒤의 토큰은 전부 버려진다. 그런데 블록 확산은 블록 크기만큼 칸을 할당하니 경계 너머의 꼬리를 계속 계산한다. 그림 1(a)의 회색 칸이 그것이다. 논문 4.5절의 사례에서는 백본만 쓴 에이전트가 </tool_call> 뒤에 앞의 추론을 그대로 되풀이한 40개 위치를 만들었고, 환경은 이를 모두 버렸다.
그래서 저자들이 원하는 것은 "어느 토큰을 확정할지"와 "몇 칸을 계산할지"를 백본의 confidence와 에이전트의 상호작용 상태 두 가지를 보고 정하는 디코더다. 이를 사람의 메타인지(자기 사고를 감시하고 조절하는 능력)에 빗대 메타인지 컨트롤러라고 부른다.
🧠 핵심 아이디어: 얼어붙은 백본 위의 작은 감시자
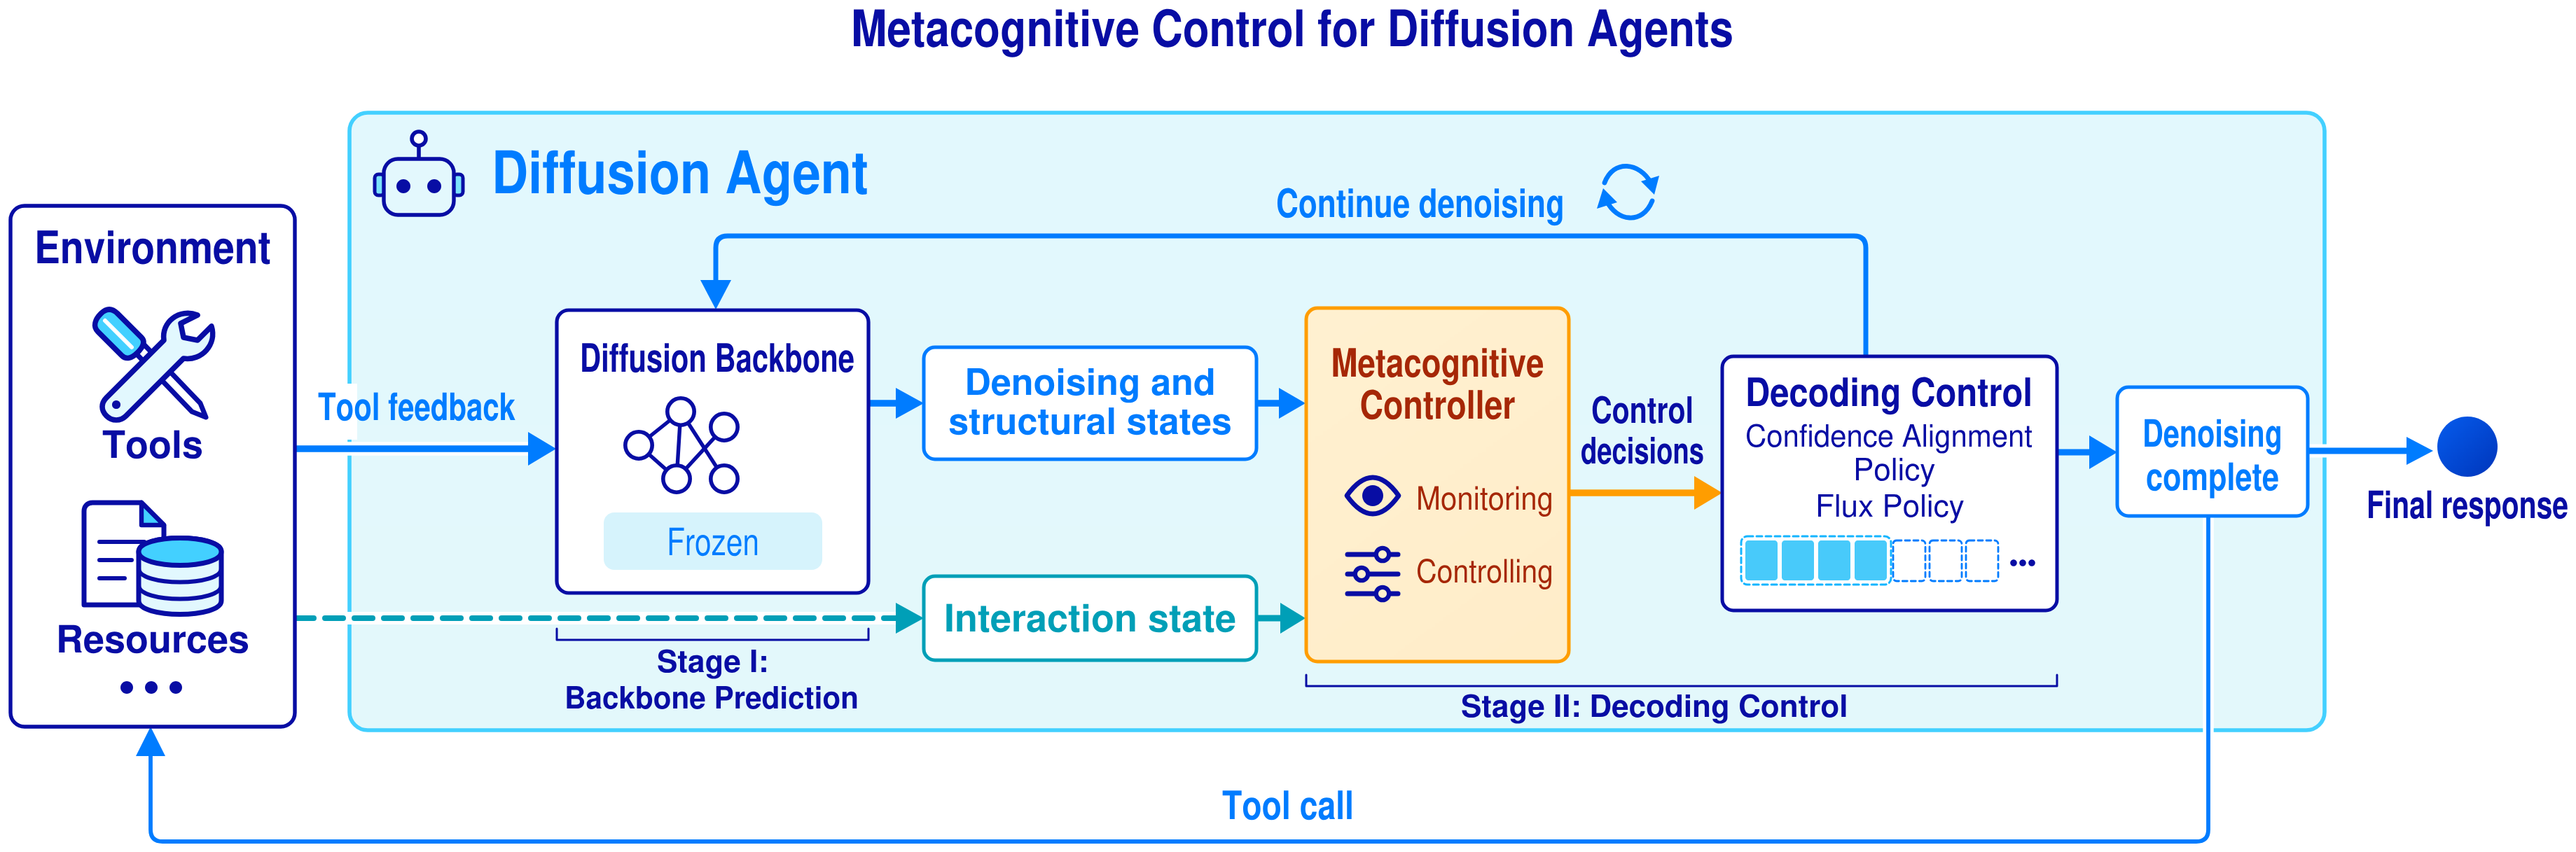
설계 원칙은 둘이다. 백본은 얼린다(비싼 백본 post-training을 피한다). 그리고 백본의 원래 생성에 최소한으로만 개입한다. 그래서 디코딩이 두 단계로 나뉜다. Stage I에서 백본이 평소처럼 마스크 위치의 토큰 분포를 내면, Stage II에서 컨트롤러가 그 예측과 감시 신호를 받아 두 정책으로 디코딩을 조절한다.
컨트롤러가 관찰하는 것은 세 묶음이다.
| 신호 | 내용 |
|---|---|
| 디노이징 상태 (모델 내부) | 각 위치의 예측 불확실성, 확정 여부, 현재 블록 안에서의 진행도 |
| 구조 상태 (모델 내부) | 도구 호출·thinking·최종 답변의 반복 서식 패턴과, 지금까지 생성된 부분과의 호환성 |
| 상호작용 상태 (환경) | 현재 턴 번호, thinking·도구 호출·최종 답변이 각각 완료됐는지 |
이 신호는 위치별 입력, 구조 후보 입력, 전역 입력으로 묶여 컨트롤러에 들어가고, 컨트롤러는 2층 Transformer 인코더다. 백본이 8B라면 거의 공짜에 가까운 크기다.
📐 방법: 두 정책과 보상 설계
Confidence Alignment 정책: 서식은 통째로, 토큰은 임계값을 조절해서
에이전트 과제의 샘플 trajectory에서 반복되는 구조 세그먼트(예: </think>, <tool_call>{"name": "search", "arguments": {"query": [, ]}}</tool_call>)를 미리 추출해 구조 후보로 만든다. 디코딩 중 각 후보는 현재 블록의 호환 가능한 위치와 짝지어지고, 이미 생성된 토큰과 그 위치에서 일치하는 후보만 남긴다. 컨트롤러는 후보 표현에 선형 헤드를 얹어 점수를 매기고, 전역 표현에서 예측한 상대 임계값을 최고 점수가 넘으면 그 세그먼트의 마스크 칸을 한꺼번에 채운다.
남은 마스크 위치 i에 대해서는 컨트롤러가 위치별 임계값 오프셋을 예측한다. 백본 예측 토큰은 confidence가 기본 임계값에서 오프셋을 뺀 값 이상일 때 확정된다. 즉 Fast-dLLM의 전역 고정 임계값을 위치마다, 스텝마다 학습된 값으로 흔드는 것이고, 쉬운 토큰은 문턱을 낮춰 빨리, 어려운 토큰은 문턱을 높여 천천히 확정하게 된다.
Flux 정책: 활성 범위를 줄였다가 필요하면 되돌리기
블록 크기 B의 칸 중 몇 칸까지를 활성 범위로 둘지를 컨트롤러가 softmax로 예측한다. 추론 때는 이미 확정된 비패딩 토큰을 모두 보존하는 길이 중 확률이 가장 높은 것을 고르고, 그 위치에 '빈 토큰(empty token)'을 놓는다. 그 너머의 칸은 이후 디노이징에서 아예 계산에 참여하지 않는다. 활성 범위를 다 채웠는데도 턴이 끝나지 않았으면, 컨트롤러가 갱신된 상태에서 더 긴 범위를 고르고 빈 토큰을 옮긴 뒤 늘어난 칸을 마스크로 복원한다. 복원이 시작되면 그 블록 안에서는 범위가 늘어나기만 하고 줄지는 않는다. 그림 1(b)에서 오른쪽 칸이 점선으로 바뀌는 것이 이것이다.
학습: trajectory 단위 보상과 GRPO
백본 없이 컨트롤러만 학습하되, 보상은 상호작용 trajectory 전체에 준다. 과제가 틀리면 0, 맞으면 상대 비용 e(τ)에 따라 깎인 값이다.
여기서 F(τ)는 백본과 컨트롤러의 추론 비용(FLOPs), F_ref(q)는 같은 얼린 백본을 컨트롤러 없이 돌렸을 때의 비용으로 미리 계산해 고정한다. η가 비용 척도, α가 효율 민감도다. 비용이 기준의 η배를 넘으면 맞아도 보상이 0이 된다. 롤아웃 때는 매 디노이징 스텝마다 활성 범위 길이를 샘플링하고, 범위가 그대로면 구조 후보 수락 여부를, 남은 위치마다 토큰 수락 여부를 독립적으로 샘플링한다. 그룹 안에서 보상을 표준화해 어드밴티지를 만드는 GRPO(Shao et al., 2024) 그대로다. 학습 비용은 A100 8장에서 스테이지당 40라운드라고만 적혀 있다.
정리하면 이 논문은 training-free가 아니다. Fast-dLLM이나 엔트로피 기반 정책은 추가 학습 없이 붙지만, 메타인지 컨트롤러는 백본마다, 과제군마다 trajectory를 뽑아 따로 학습한다(4.4절에서 LLaDA와 Dream에 각각 학습했다고 명시). 다만 백본은 건드리지 않는다는 점에서 DLLM-Searcher 같은 백본 post-training보다는 가볍다.
📊 실험: FLOPs 20.6%의 실체
벤치마크는 다섯이다. 도구 호출은 BFCL v3의 live·non-live 서브셋을 각각 1:1로 학습·평가에 나눴고(Lu et al., 2025를 따름), 멀티홉 QA는 HotpotQA·2WikiMultiHopQA·MuSiQue에서 각 1,000문항을 뽑았다(DLLM-Searcher를 따름). 지표는 BFCL 공식 평가기의 정확도와 QA의 cover exact match(정답이 예측 안에 포함되는지)다. 비용은 전체 trajectory에 걸친 주요 행렬 연산 FLOPs(컨트롤러 포함)를 10의 12승 단위로 센다. 백본은 LLaDA-8B-Instruct를 도구 사용 trajectory로 SFT한 것이고, "LLaDA-8B (SFT)"는 그 백본에서 컨트롤러만 뺀 대조군이다.
| 방법 | BFCL Live Acc / FLOPs | BFCL Non-live | HotpotQA | 2Wiki | MuSiQue |
|---|---|---|---|---|---|
| Fast-dLLM | 57.46 / 57.58 | 52.66 / 54.98 | 43.20 / 324.16 | 67.70 / 340.49 | 21.20 / 342.32 |
| LLaDA-8B-Tools | 50.00 / 2889.56 | 37.27 / 1375.23 | 16.50 / 4310.92 | 22.80 / 4185.11 | 2.20 / 2644.99 |
| DLLM-Searcher | 40.85 / 547.10 | 16.09 / 433.45 | 37.10 / 1277.25 | 50.40 / 1261.22 | 17.80 / 1237.25 |
| LLaDA-8B (SFT) | 66.52 / 32.49 | 63.60 / 19.28 | 45.70 / 175.00 | 67.10 / 204.51 | 20.70 / 197.38 |
| LLaDA2.0-mini | 69.72 / 43.79 | 79.42 / 14.12 | 36.30 / 142.09 | 41.00 / 199.93 | 10.80 / 168.37 |
| Ours | 70.96 / 18.48 | 65.47 / 12.51 | 46.60 / 131.91 | 67.90 / 147.68 | 20.30 / 142.83 |
(논문 Table 1. 정확도 %, FLOPs는 10의 12승.)
초록의 "가장 효율적인 베이스라인 대비 평균 20.6% FLOPs 절감"은 이 표에서 벤치마크마다 가장 FLOPs가 낮은 베이스라인을 골라 계산한 것이다. 직접 셈해 보면 BFCL Live는 SFT 대비 43.1%, 나머지 넷은 LLaDA2.0-mini 대비 11.4%, 7.2%, 26.1%, 15.2%이고 평균이 20.6%로 맞다. 비교 상대에 따라 숫자가 크게 달라진다는 뜻이기도 하다. 논문이 본문에 적은 다른 비교는 이렇다.
- 같은 백본에서 컨트롤러만 뺀 SFT 대비: FLOPs 24.6~43.1% 절감, 정확도는 4개 벤치마크에서 상승(BFCL Live +4.44, Non-live +1.87, HotpotQA +0.90, 2Wiki +0.80), MuSiQue −0.40. 이것이 메타인지 제어 자체의 효과다.
- Fast-dLLM 대비: 같은 백본 가중치·도구 인터페이스·생성 예산에서 디코딩과 캐싱만 다르게 했을 때 FLOPs 56.6~77.2% 절감, BFCL에서 정확도 +13.50/+12.81.
- LLaDA2.0-mini(16B MoE) 대비: 4개 벤치마크에서 정확도가 높고 5개 모두에서 FLOPs가 낮다. 단 BFCL Non-live는 79.42 대 65.47로 크게 진다.
- 과제 특화 모델 대비: LLaDA-8B-Tools와 DLLM-Searcher를 전부 이기며, 멀티홉 QA에서 DLLM-Searcher보다 FLOPs가 88.3~89.7% 적다.
글쓴이가 확인한 불일치 하나. 이 논문을 소개하는 2차 요약 중에 "지연시간 45% 감소"라는 표현이 있었는데, 논문 본문·표·초록 어디에도 45%라는 숫자도, 지연시간(latency, wall-clock) 측정값도 없다. 논문이 보고하는 것은 전부 FLOPs이고, 가장 가까운 수치는 SFT 대비 BFCL Live의 43.1%다. 저장소의 추론 스크립트가 generation_seconds를 기록하기는 하지만 논문에 그 값은 실리지 않았다. 이 글은 논문 기준으로 쓴다.
어블레이션과 트레이드오프
| 설정 | BFCL Live | BFCL Non-live | HotpotQA | 2Wiki | MuSiQue |
|---|---|---|---|---|---|
| w/o flux policy | 70.07 / 26.95 | 64.46 / 17.39 | 47.60 / 149.71 | 66.70 / 162.46 | 19.60 / 162.93 |
| w/o conf. align. | 69.63 / 23.11 | 64.46 / 14.55 | 48.90 / 145.49 | 68.90 / 166.48 | 19.10 / 167.32 |
| 전체 컨트롤러 | 70.96 / 18.48 | 65.47 / 12.51 | 46.60 / 131.91 | 67.90 / 147.68 | 20.30 / 142.83 |
flux 정책을 빼면 FLOPs가 평균 24.5%, confidence alignment를 빼면 16.3% 늘어난다(논문 Table 2). 정확도 변화는 작고 방향도 일정하지 않다. HotpotQA와 2Wiki에서는 오히려 한 정책을 뺀 쪽이 더 높다(48.90 대 46.60, 68.90 대 67.90). 두 정책이 비용을 줄이는 것은 분명하지만 정확도를 올리는 장치는 아니라고 읽는 게 맞다.
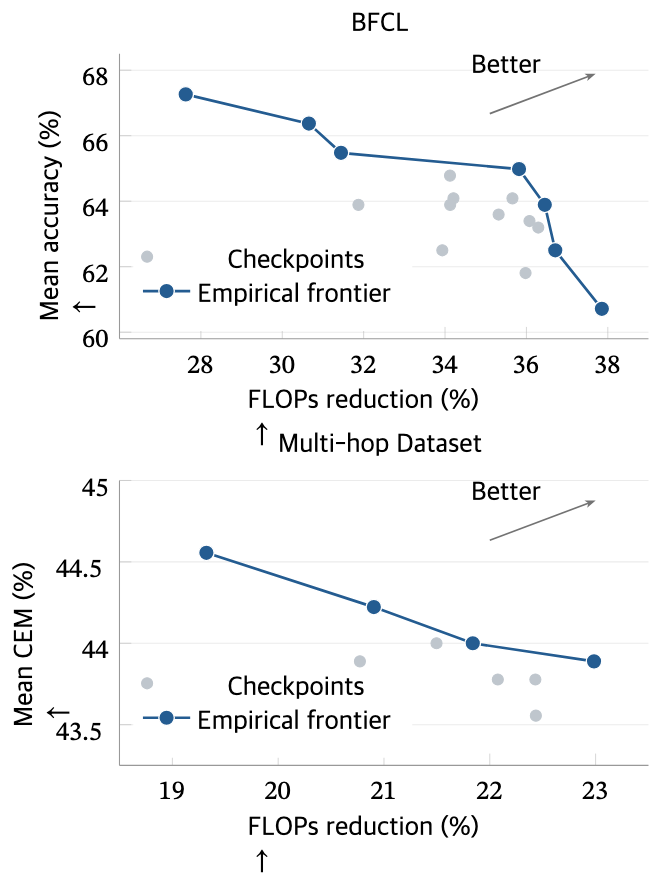
그림 3은 학습 중 여러 체크포인트를 찍어 본 정확도-절감률 평면이다. BFCL에서는 절감률을 28%에서 38%로 밀면 평균 정확도가 67.3에서 60.8까지 떨어지고, 멀티홉에서는 19%에서 23%로 가는 동안 CEM이 0.7점 빠진다. 보상의 η·α가 이 전선 위의 위치를 정하는 손잡이인 셈인데, 논문은 어떤 값을 썼는지 적지 않았다.
다른 백본
Dream-7B(Ye et al., 2025)에 컨트롤러를 따로 학습시켜 붙이면 BFCL Live 17.2%, Non-live 29.0%, HotpotQA 52.9%, 2Wiki 58.0%, MuSiQue 67.5% FLOPs가 준다(Table 3). 정확도는 Non-live +1.72, HotpotQA +1.10이지만 2Wiki −0.60, MuSiQue −2.20이다. LLaDA보다 절감폭이 멀티홉에서 훨씬 큰데, 그만큼 정확도도 더 깎였다. 백본마다 전선의 모양이 다르다는 정도로 읽는 게 안전하다.
사례
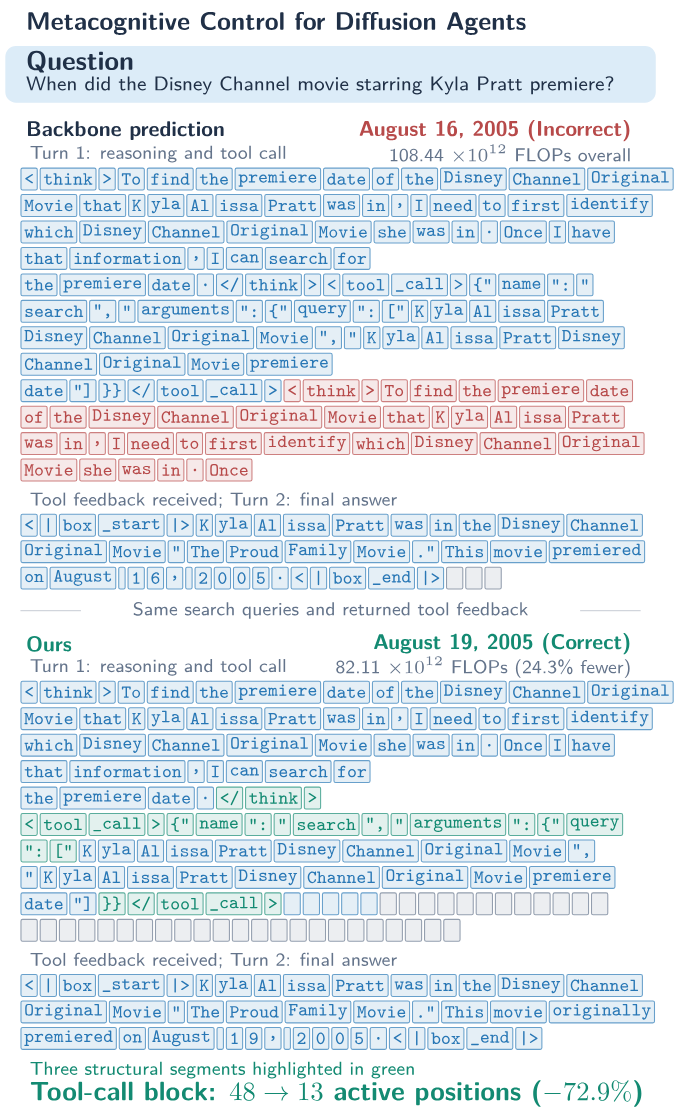
같은 백본, 같은 검색 쿼리, 같은 도구 응답으로 두 에이전트를 비교한 것이 그림 4다. 백본만 쓴 쪽은 </tool_call> 뒤에 앞 추론을 되풀이한 40칸을 만들었고 이는 환경이 버린다. 컨트롤러가 붙은 쪽은 초록색 세 구조 세그먼트(</think>, search 호출 접두사, 호출 닫는 시퀀스)를 통째로 확정하고, 마지막 도구 호출 블록에서 flux 정책이 48칸 중 13칸만 활성으로 남겼다(−72.9%). 전체 상호작용 FLOPs는 108.44에서 82.11(×10의 12승)로 24.3% 줄었고 답도 8월 19일로 맞았다. 다만 이것은 선택된 한 사례이고, 정답이 바뀐 것은 도구 응답이 같았는데도 두 번째 턴의 생성이 달랐기 때문이라 컨트롤러의 효율 효과와 정확도 효과를 분리해 보여 주지는 못한다.
🔍 비판적으로 읽기
1. FLOPs는 지연시간이 아니다. flux 정책이 줄이는 것은 한 스텝에 계산하는 위치 수다. 그런데 GPU에서 블록 48칸을 13칸으로 줄여도 배치가 작으면 커널은 어차피 메모리 대역폭에 묶여 있어 벽시계 시간은 그만큼 줄지 않는다. dLLM의 실제 지연시간을 지배하는 것은 디노이징 스텝 수(forward 횟수)인데, 논문은 스텝 수도 지연시간도 보고하지 않는다. confidence alignment가 구조 세그먼트를 한 번에 채우면 스텝이 줄어들 것이라 추정은 되지만, 수치가 없다. 저장소 README도 현재 total_flops 필드가 "2P × 처리 위치 수 + 컨트롤러 비용"으로 추정한 값이며 "논문 표에 쓴 행렬 연산 계수 방식이 아니다"라고 적어 두었다.
2. 비교 대상이 공정하게 정렬돼 있지 않다. LLaDA-8B-Tools는 다른 SFT 데이터, DLLM-Searcher는 다른 백본 post-training과 P-ReAct, LLaDA2.0-mini는 다른 모델이다. 표 1에서 깨끗한 비교는 SFT 대조군과 Fast-dLLM 둘뿐이고, Fast-dLLM이 도구 사용 SFT 백본에서 SFT 대조군보다 FLOPs가 2배 가까이 높게 나온 이유(임계값 설정, 생성 예산)는 설명이 없다. "가장 효율적인 베이스라인 대비 20.6%"는 벤치마크마다 상대를 바꿔 얻은 평균이다.
3. 과제와 백본마다 다시 학습해야 한다. 구조 세그먼트는 과제 trajectory에서 추출하고(README: "컨트롤러는 학습 때와 같은 구조 템플릿을 써야 한다"), 컨트롤러는 백본마다 따로 GRPO로 돌린다. 새 도구 스키마나 새 서식이 들어오면 후보 집합과 컨트롤러가 함께 바뀌어야 한다. 논문의 Limitations 절은 "진화하는 확산 모델에 컨트롤러를 적응시키는 것이 향후 과제"라는 한 문장뿐이다.
4. 정확도 차이는 대부분 노이즈 폭 안이다. 멀티홉 QA의 ±1점, BFCL의 ±2점은 1,000문항·1:1 분할에서 반복 실행 없이 나온 값이다. 어블레이션에서 한 정책을 뺀 쪽이 더 높은 벤치마크가 있는 것도 같은 맥락이다. 이 논문의 주장은 "정확도를 유지하면서 비용을 줄였다"로 읽어야지 "정확도를 올렸다"로 읽으면 안 된다.
5. 절대 성능은 낮다. MuSiQue CEM 20.3, HotpotQA 46.6은 같은 규모 AR 에이전트와 비교하면 낮은 편이다(논문에는 AR 비교가 없다). 확산 에이전트가 AR 에이전트의 대안이 되려면 비용 절감 이전에 백본 성능이 따라와야 하는데, 이 논문의 범위 밖이다.
6. 재현 자료. 저장소는 10월 26일에 올라왔고 SFT·컨트롤러 학습·BFCL 추론 코드가 있지만 멀티홉 QA 인터페이스와 라이선스 파일이 없고, 백본·컨트롤러 체크포인트도 "호환되는 것을 준비하라"고만 되어 있다.
💡 정리
이 논문의 기여는 세 줄로 요약된다. (1) 에이전트 응답은 서식과 추론이 섞여 있고 도구 호출 경계 뒤의 꼬리는 버려지므로, 확산 디코딩의 "모든 토큰, 모든 칸을 균일하게" 원칙이 낭비를 만든다. (2) 얼린 백본 위에 2층 Transformer 컨트롤러를 얹어 서식 세그먼트를 통째로 확정하고 토큰별 임계값을 흔드는 정책과 블록의 활성 칸 수를 줄였다 되돌리는 정책을 두고, 전체 trajectory의 정답 여부와 FLOPs로 보상을 줘 GRPO로 학습한다. (3) 같은 백본의 SFT 대조군 대비 FLOPs 24.643.1%, Fast-dLLM 대비 56.677.2%를 줄이면서 정확도를 유지했다.
확산 언어 모델을 처음 접한 독자에게 챙겨 갈 점은, dLLM의 비용이 스텝 수 × 스텝당 계산 위치 수로 쪼개지고, 기존 가속법(Fast-dLLM, 엔트로피 정책, 캐싱)이 주로 앞 항을 건드렸다면 이 논문은 뒤 항까지 에이전트 구조에 맞춰 줄였다는 것이다. 그 대가로 training-free 성질을 잃었고, 실제 지연시간 수치는 아직 없다.
📚 참고
- arXiv:2610.37642 — Metacognitive Decoding: Efficient Inference for Diffusion Language Agents
- github.com/IlluminatingFish/metacognitive-controller — 공식 구현(블록 확산 SFT, 컨트롤러 학습, BFCL 추론)
- LLaDA: Large Language Diffusion Models (Nie et al., 2025)
- Block Diffusion (Arriola et al., 2025)
- Fast-dLLM (Wu et al., 2026)
- DLLM-Searcher (Zhao et al., 2026)
- LLaDA2.0 (Bie et al., 2025)
본 글의 그림은 원문에서 가져왔습니다. 입문 절의 AR/확산 비교 도식(fig5)은 직접 그린 것입니다.