The Generalization Problem: 데이터가 아니라 컴퓨트로 일반화를 사자
"컴퓨트는 지수적으로 늘고 우리가 통제할 수 있다. 데이터는 훨씬 느리게 늘고 우리 손 밖에 있다. 그런데 왜 우리는 데이터로만 스케일하고 있을까?"
오늘 올린 Dust: 역전파 없이 트랜스포머를 사전학습하다 글을 읽고 "그런데 Q Labs는 대체 왜 backprop을 버리려는 걸까"라는 의문이 남았다면, 이 글이 그 답이다. Dust보다 1년 앞선 2025년 8월, Q Labs의 Samip Dahal과 Akshay Vegesna는 The Generalization Problem 이라는 짧은 에세이를 올렸다. 분량은 A4 한 장 남짓이지만, 이후 Decoupling Search and Learning in Neural Net Training(arXiv 2509.10973, 2025.9)과 Dust(2026.10)로 이어지는 연구 프로그램의 설계도 역할을 한다.
이 글은 에세이의 주장을 먼저 정리하고, 그 주장을 처음으로 실험에 옮긴 Decoupling 논문을 살펴본 뒤, 왜 이것이 Dust의 "prequel"인지 짚는다.
원문: https://qlabs.sh/research (The Generalization Problem) / arXiv 2509.10973
🤔 문제 제기: 스케일링의 병목은 컴퓨트가 아니라 데이터
에세이의 출발점은 현재 AI 연구가 "대규모 데이터셋 위에서 큰 신경망을 경사 기반으로 최적화한다" 는 단 하나의 접근으로 수렴했다는 진단이다. Solomonoff 귀납이나 PAC 학습처럼 지능의 근본을 겨냥한 이론은 계산 불가능하거나 실용성이 없어서 뒷전으로 밀렸고, 그 자리를 "brute empiricism"이 채웠다.
저자들은 Bitter Lesson을 인용한다. 컴퓨트와 함께 스케일하는 범용 방법이 결국 이긴다는 교훈이다. 그런데 현재의 스케일링은 역설적으로 데이터 가용성에 묶여 있다.
- 컴퓨트는 지수적으로 늘고, 완전히 프로그래밍 가능하다.
- 데이터는 훨씬 느리게 늘고, 우리 통제 밖에 있다.
- 그런데 경사하강으로 학습하는 신경망은 주로 데이터와 함께 스케일하고, 컴퓨트와는 간접적으로만 스케일한다.
최근의 RL 접근도 마찬가지다. 사전학습 모델과 검증기(verifier)가 생성한 데이터에 의존하는데, 지능이 정말 중요한 대부분의 문제에서는 무한한 데이터도, 완벽한 검증도 없다.
대형 연구소들이 밟을 법한 경로도 언급한다. 강한 사전학습 모델로 학습 알고리즘 코드를 생성하고, 일반화 성능을 런타임에 측정해 부트스트랩하는 식의 "지능 문제 자체에 RL을 적용하는" 접근이다. 이론적으로는 말이 되지만, 현재 모델은 그 방대한 알고리즘 공간을 헤쳐 나갈 만큼 강하지 않고, 결국 RL 환경으로 데이터를 또 스케일한 뒤 지능의 근본을 알아서 발견해 주길 바라야 한다는 것이다.
저자들의 대안은 단순하다. 지능의 근본을 먼저 풀자.
🧠 핵심 가설: 최적의 학습 알고리즘은 "탐색 + prior"다
지능은 일반화다. 그리고 저자들이 원하는 건 데이터 가용성과 무관하게 컴퓨트와 함께 스케일하는 일반화 다. 데이터가 거의 언제나 병목이므로, 최소한의 학습 데이터로 강한 성능을 내는 것이 우선이고, 큰 데이터가 있으면 그것도 활용할 수 있어야 한다.
그렇다면 무한한 컴퓨트가 주어졌을 때 최적의 학습 알고리즘은 어떻게 생겼을까? 저자들의 가설은 두 단계다.
- 데이터와 일치하는 모든 모델을 탐색(search)한다.
- 범용 일반화 prior로 그중 가장 잘 일반화할 모델을 고른다.
여기서 no-free-lunch 정리(Wolpert, 1996)가 등장한다. 탐색만으로는 지능이 안 된다. 유한한 데이터셋에 완벽히 맞는 함수는 무한히 많고, 각각은 보지 못한 데이터에서 다르게 행동하기 때문이다. 탐색은 데이터와 일치하는 함수들을 찾고, prior는 그중 어떤 것이 일반화할지 결정한다. 그리고 탐색은 본질적으로 컴퓨트와 함께 스케일하므로, 이 구조는 데이터가 아닌 컴퓨트와 함께 일반화가 스케일한다.
Solomonoff 귀납이 바로 이 이상형이다. 모든 계산 가능한 모델을 열거하고 단순성으로 가중치를 매긴다. 계산 불가능하지만, 경사 기반 학습에 무엇이 빠져 있는지 를 보여 준다. 바로 "탐색을 통한 다양한 해의 탐험"이다.
탐색: 경사하강은 탐색하지 않는다
순수한 경사하강은 학습 손실의 기울기를 따라 단 하나의 해 로 수렴한다. 다른 대안을 발견할 메커니즘이 없다. 우리가 해 본 "탐색"이라곤 seed나 옵티마이저를 조금씩 바꿔 여러 모델을 학습하는 정도인데, 저자들은 이것을 가설이 요구하는 탐험적 탐색과는 거리가 멀다고 본다.
prior: 암묵적 prior는 최적화할 수 없다
현재 신경망의 prior는 손실 지형, 최적화 동역학, 아키텍처 선택에 암묵적으로 박혀 있다. 덕분에 어느 정도 일반화는 되지만, 직접 최적화할 수 없고, 현대 시스템의 막대한 데이터 요구량이 이 prior가 최적과 거리가 멀다는 것을 시사한다. 저자들은 prior를 명시적이고 범용적으로 만들어야 한다고 주장한다.
고전적인 예가 단순성, 즉 Kolmogorov 복잡도 기반의 Solomonoff prior다. 그런데 단순성은 구현도 어렵고 오해를 부르기도 한다. 과파라미터화 현상이 그 예다. Wilson(2025)은 과파라미터화된 네트워크가 더 평평한 최소점과 더 낮은 유효 차원으로 수렴해서 일반화를 더 잘한다고 보고하고, Lotfi et al.(2024)은 더 큰 언어 모델이 더 타이트한 일반화 경계를 가지며 더 압축 가능하다는 것을 보였다. 단순성을 파라미터 수로 재면 작은 모델을 만들라는 잘못된 결론에 이르지만, "압축 가능성"으로 재면 큰 모델이 더 단순하다. 저자들은 신경망 일반화에 대한 원리적 이론이 아직 초기 단계라고 솔직히 인정한다.
📐 첫 실험: 탐색과 학습을 분리하다 (Decoupling Search and Learning)
에세이는 "최근 논문이 첫 걸음을 뗐다"며 Decoupling 논문을 가리킨다. 핵심 문장은 이것이다.
탐색이 가능한 저차원 다양체인 표현 공간(representation space)에서 진화 탐색 을 하고, 파라미터 공간에서는 경사하강 으로 발견된 표현을 구현한다.
왜 파라미터 공간에서 탐색하면 안 되는가
논문은 탐색이 잘 되는 공간의 두 가지 조건을 제시한다.
- 랜덤 탐색의 실현 가능성. 순진한 랜덤 샘플링이나 섭동으로도 고적합도(high-fitness) 해를 향해 진전이 있어야 한다.
- 상각(amortization). 랜덤 섭동과 그 적합도에서 배워 새로운 고적합도 해를 만들어 내는 샘플러를 학습할 수 있어야 한다.
파라미터 공간은 둘 다 실패한다. 너무 커서 랜덤 샘플링으로 좋은 파라미터를 찾을 확률이 사실상 0이고, 큰 네트워크의 파라미터를 직접 샘플링하는 모델을 학습하기도 어렵다. 그래서 파라미터 공간은 경사하강으로 학습 만 가능하고 탐색 은 불가능하다.
반면 활성값 공간은 훨씬 작아서 랜덤 섭동이 먹히고, 신경망 자체가 자기 표현에 대한 예측 분포를 정의하므로 상각 메커니즘이 내장돼 있다. "좋은 모델은 좋은 표현을 만든다"는 관찰에서, 좋은 표현을 먼저 찾고, 그 표현을 만드는 파라미터를 경사하강으로 배우자 는 분해가 나온다.
표현 공간에서의 층별 진화 탐색
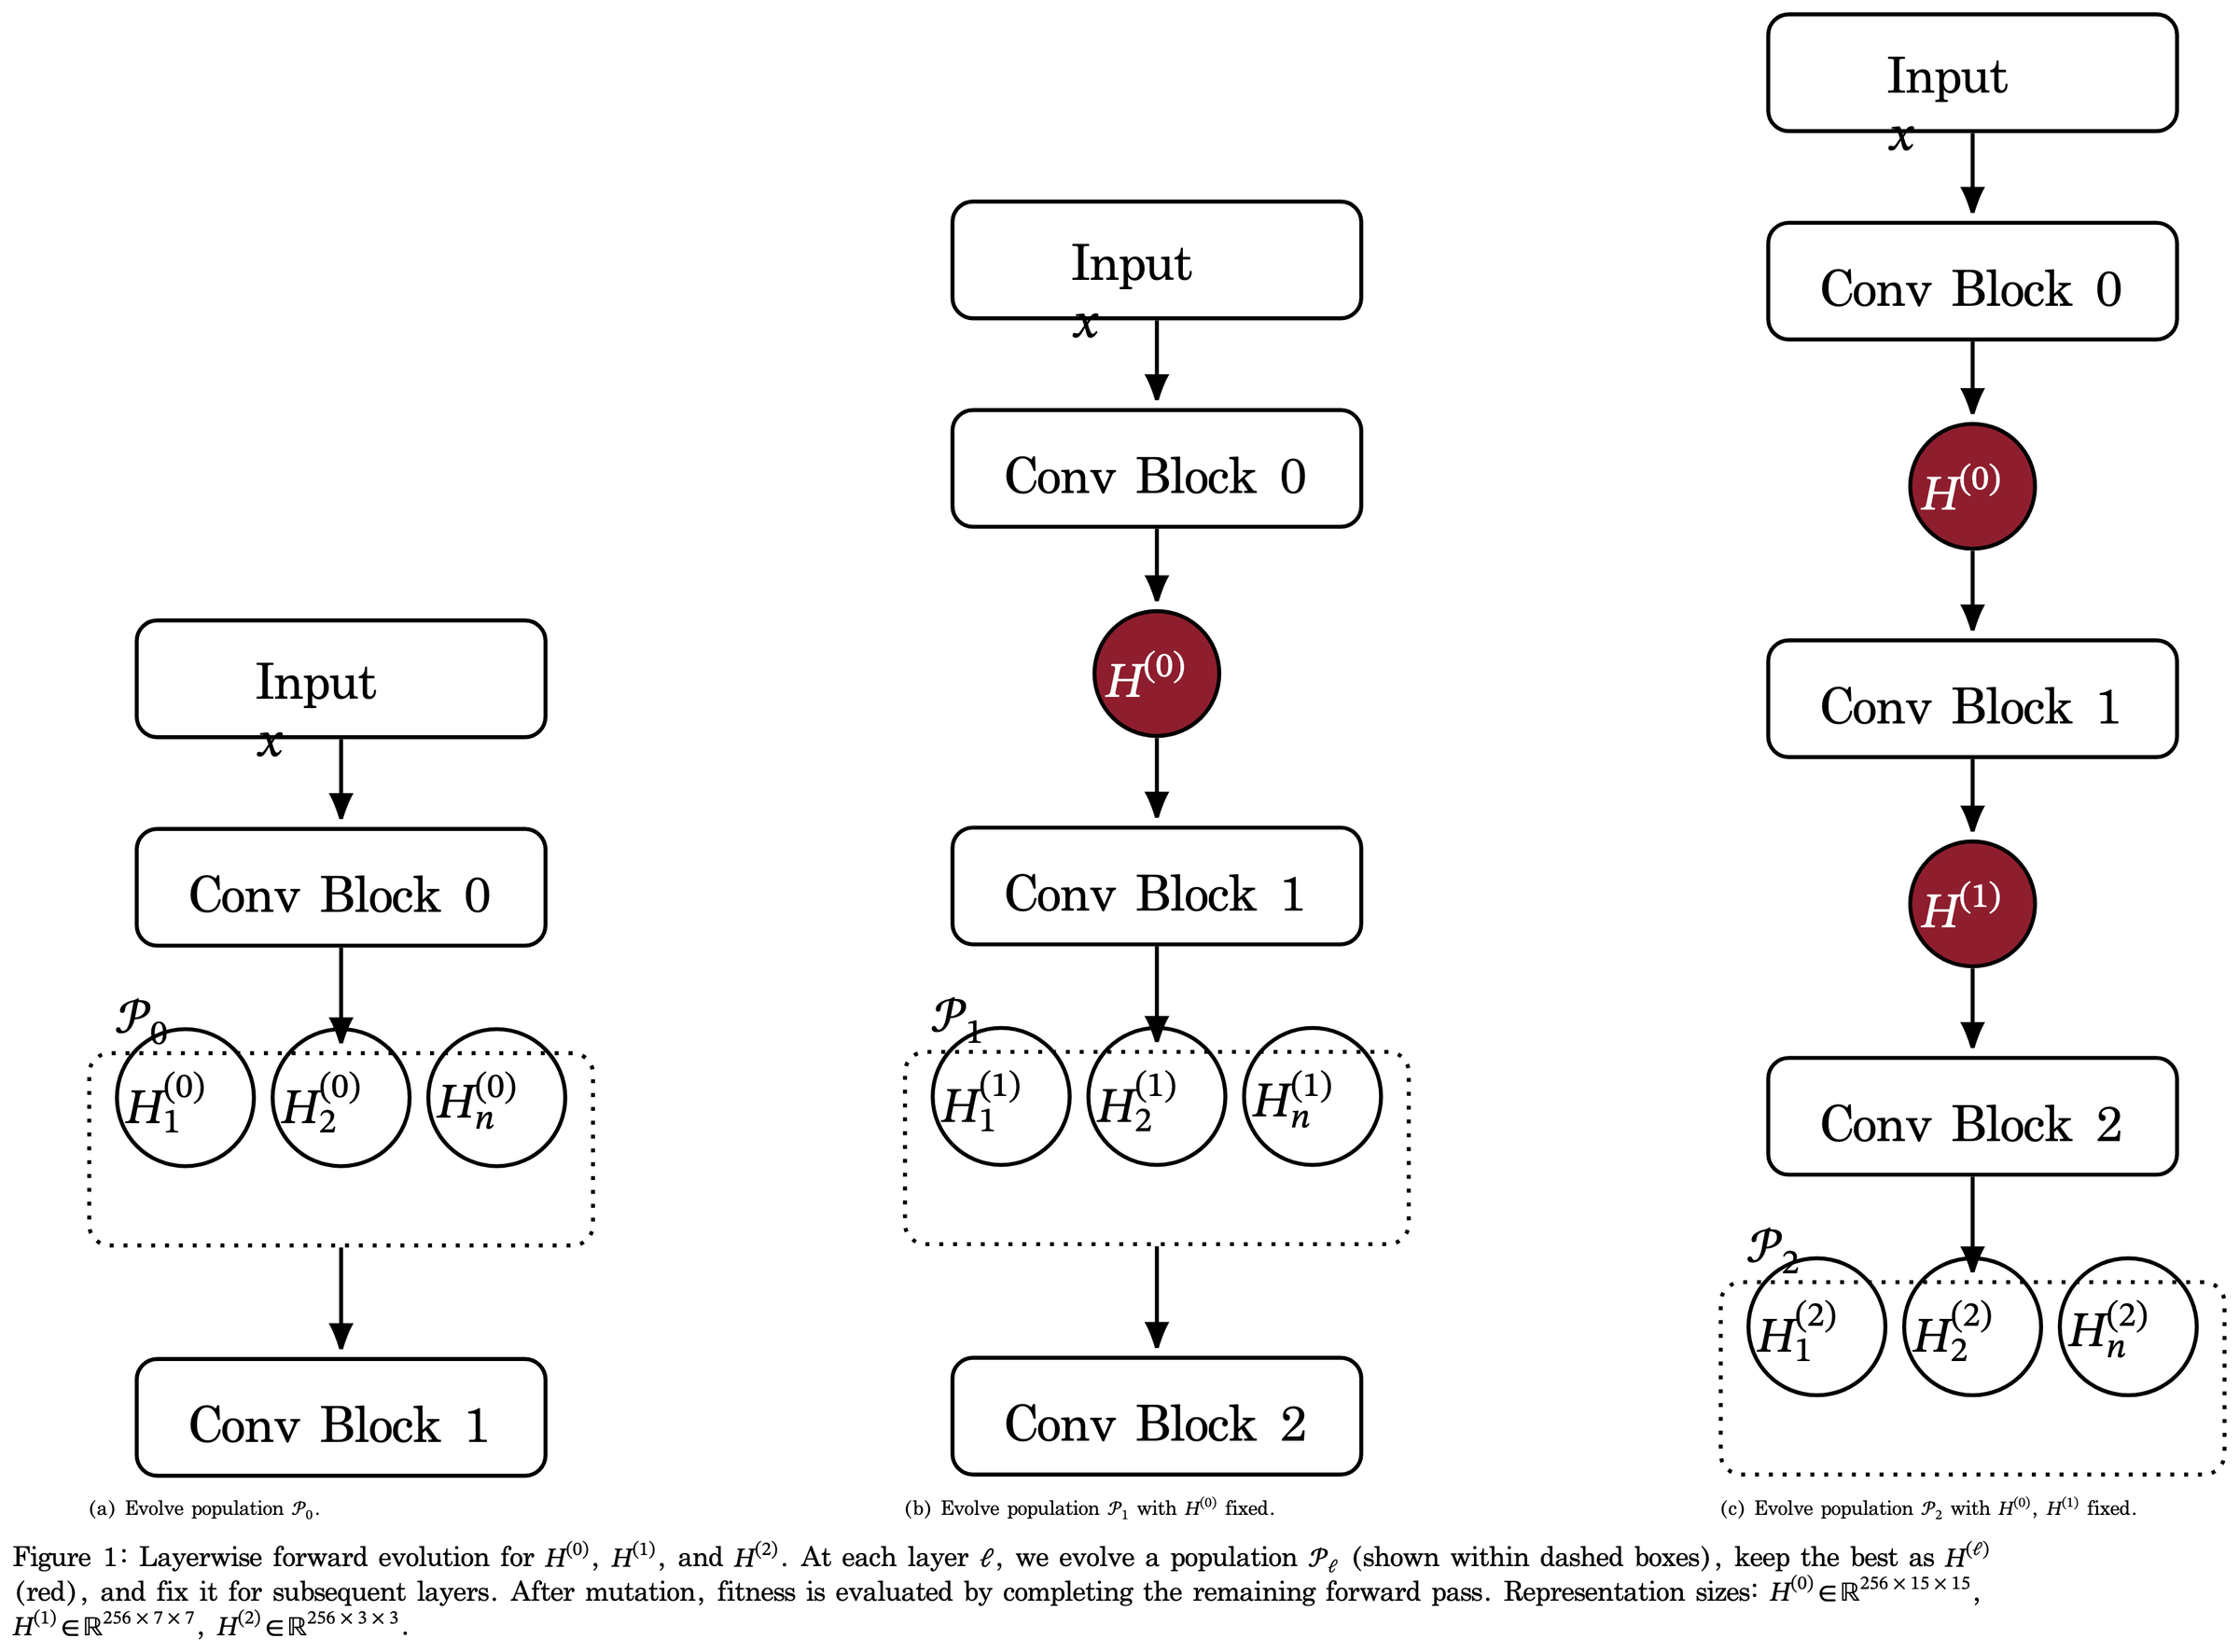
실험은 CIFAR-10/100용 3-블록 CNN(블록당 3×3 conv 2개 + BN + GELU, 블록 사이 2×2 max pool)과 선형 헤드로 한다. 탐색 지점은 세 conv 블록의 출력(, , )과 최종 logit, 총 개다. 그림 1이 보여 주듯 탐색은 층 순서대로 진행된다.
- 초기화: 입력에 채널별 노이즈를 더해 개의 후보를 만든다.
- 층별 진화: 층 을 진화시킬 때 이전 층 은 이미 진화된 값으로 고정하고, 만 바꾼 뒤 남은 네트워크를 순전파해 적합도(negative cross-entropy)를 잰다.
- 세대 교체: 배치의 이미지마다 독립적으로 top- 부모를 뽑고, 부모 유지 + 높은 변이 강도( 탐험 부스트)의 탐험 샘플 + 표준 변이 강도의 정제 샘플 로 다음 세대를 구성한다.
- 번식 연산자: 두 부모의 평균으로 crossover한 뒤 부모 활성값의 채널별 표준편차에 비례하는 가우시안 변이를 더한다. conv 층에서는 채널별 노이즈, 반복 3×3 average pooling으로 공간 평활화, 평균 0·분산 1 정규화를 적용한다. 저자들은 공간 평활화가 표현의 학습 가능성에, 정규화가 진화의 수렴에 결정적 이었다고 밝힌다.
눈여겨볼 점은 이 전체 과정에 역전파가 없다 는 것이다. 순전파와 적합도 비교만으로 중간 표현을 찾는다.
탐색은 컴퓨트와 함께 스케일하는가
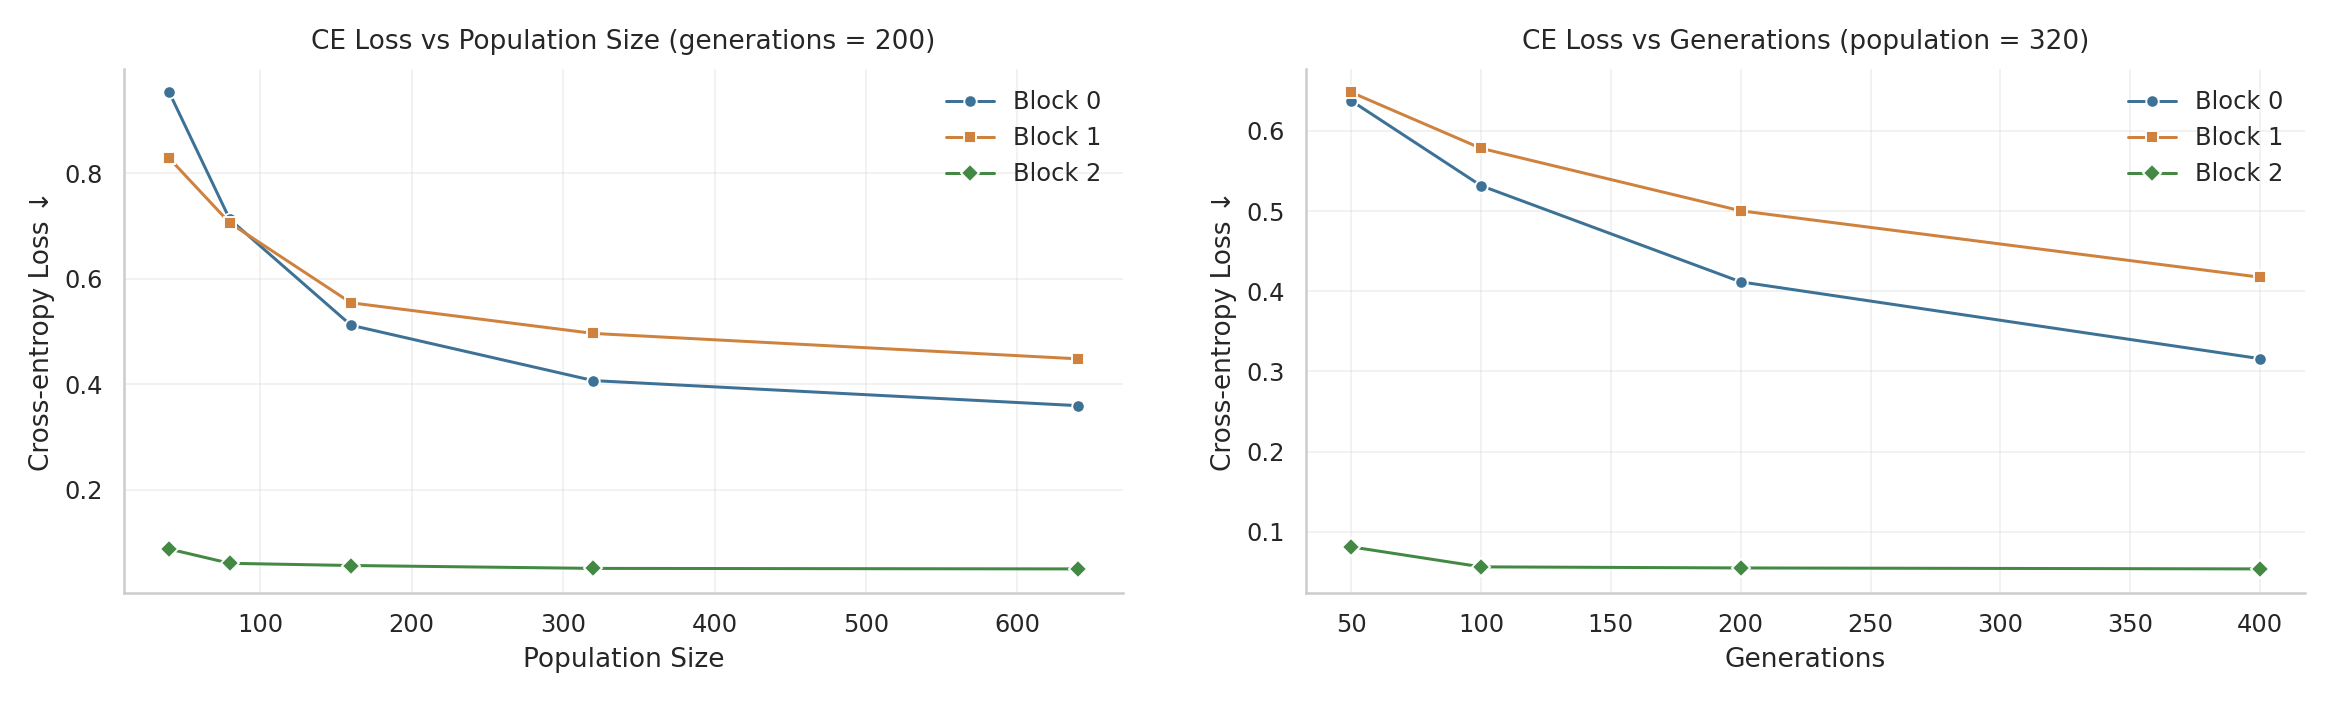
에세이의 주장이 맞으려면 탐색의 품질이 컴퓨트와 함께 올라가야 한다. CIFAR-100 학습 데이터 1000개에서 측정한 그림 2를 보면 population 크기와 세대 수 두 축 모두에서 loss가 내려간다. 예상대로 뒤쪽 층(Block 2)은 앞쪽 층보다 훨씬 쉽게 최적화된다. logit에 가까울수록 손실에 직접 영향을 주기 때문으로 보인다.
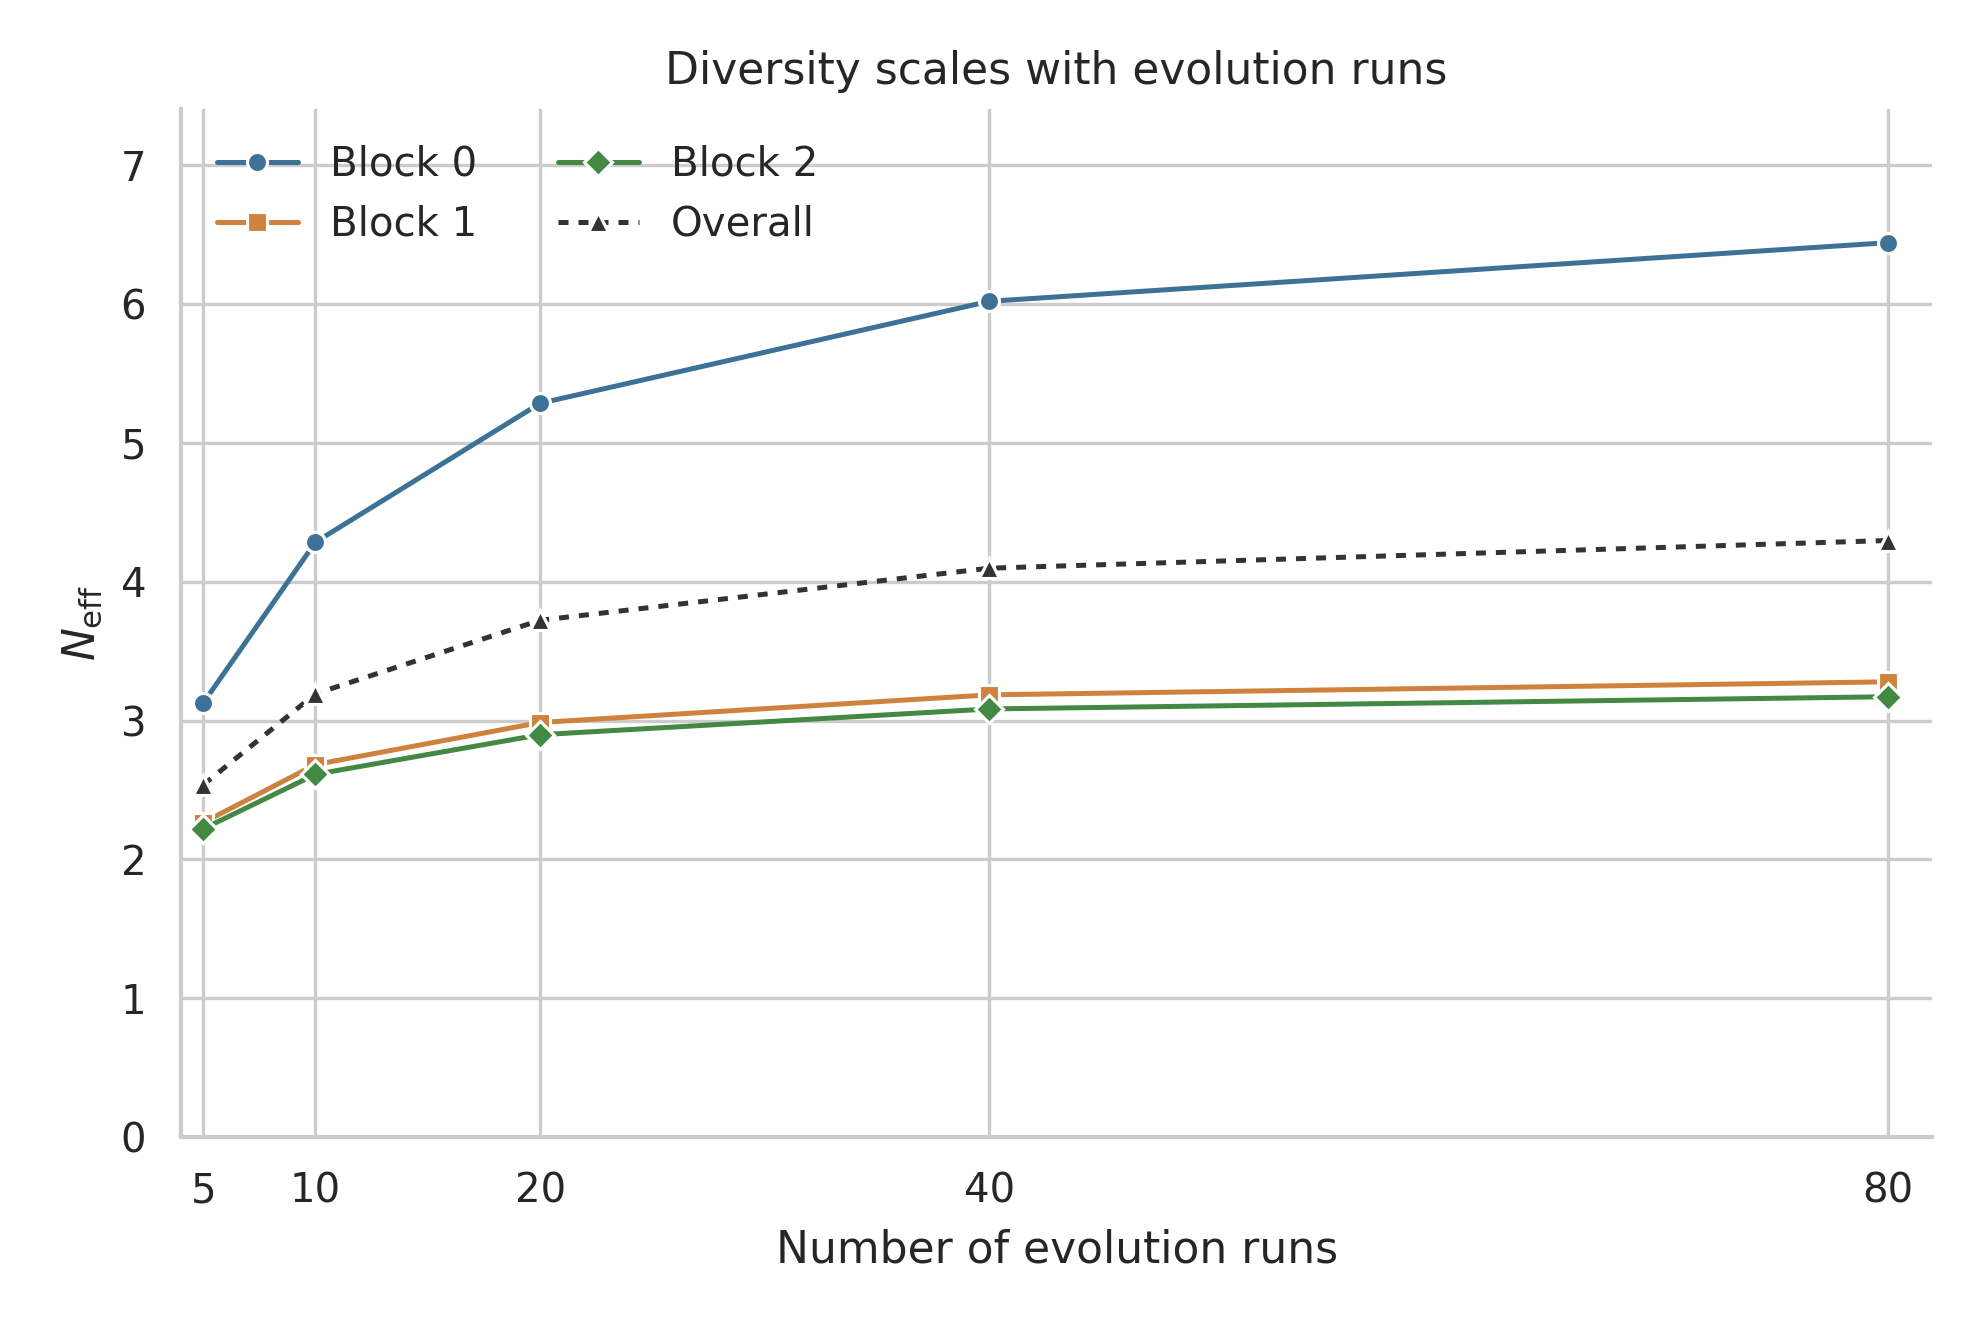
더 중요한 건 다양성 이다. 에세이의 가설은 "데이터와 일치하는 여러 모델"을 찾는 것이니, 탐색이 매번 같은 답만 내놓으면 의미가 없다. 저자들은 독립적인 탐색 실행을 여러 번 돌려 정답 확률이 0.5를 넘는 최선 후보를 모은 뒤, 코사인 유사도 Gram 행렬의 collision entropy로 유효 해 개수 를 계산한다.
는 "완전히 직교하는 해의 개수"에 해당하는 보수적인 다양성 추정치다. 그림 3에서 실행 수를 늘릴수록 가 꾸준히 증가하고, 표현 용량이 큰 앞쪽 블록에서 가장 가파르다. 탐색은 최적화와 다양성 모두 컴퓨트와 함께 스케일한다 는 것이 3절의 결론이다.
📊 학습: 탐색된 표현은 배울 수 있는가, 그리고 일반화하는가
표현을 찾는 것만으로는 부족하다. (i) 네트워크가 그 표현을 배울 수 있어야 하고, (ii) 배운 결과가 보지 못한 데이터에서 일반화해야 한다.
목적 함수
초기화된(학습 안 된) 네트워크로 학습 집합 전체에 대해 탐색을 한 번만 돌리고 최선의 표현 과 탐색된 logit의 softmax 를 캐시한다. 그다음 경사하강으로 다음을 최소화한다.
핵심은 , 즉 stop-gradient다. KL 항의 기울기는 헤드 파라미터 에만 흐르고, conv 본체 는 오직 탐색된 표현에 대한 MSE 회귀로만 학습된다. 분류 손실의 기울기가 본체로 역전파되는 일이 없으므로, 표준 backprop으로 붕괴할 여지를 차단한 설계다. 저자들도 이것이 target propagation과 닮았다고 인정하되, 타깃의 출처가 탐색이라는 점이 다르다고 말한다.
탐색된 표현은 고차원이고 층 사이 점프가 크기 때문에, 학습 시에는 블록당 conv 층을 2개에서 6개로 3배 늘렸다. 공정성을 위해 SGD 베이스라인도 2/4/6층 중 최고 성능을 보고한다.
결과
| 데이터 증강 없음 | MNIST | CIFAR-10 | CIFAR-100 |
|---|---|---|---|
| SGD | 99.1 ± 0.1 | 89.1 ± 0.3 | 62.3 ± 0.5 |
| Search-based Learning | 99.0 ± 0.1 | 88.3 ± 0.3 | 61.6 ± 0.2 |
| 데이터 증강 있음 | CIFAR-10 | CIFAR-100 |
|---|---|---|
| SGD | 93.0 ± 0.2 | 71.8 ± 0.4 |
| Search-based (Skip block 0) | 92.0 ± 0.1 | 69.2 ± 0.3 |
| Search-based (All layers) | 90.6 ± 0.3 | 66.5 ± 0.3 |
(테스트 정확도 %, 3회 평균 ± 표준편차)
증강 없이는 세 벤치마크 모두 SGD 대비 1% 이내 다. 증강을 쓰면 모든 층을 감독하는 버전은 몇 점 뒤처지지만, Block 0의 직접 감독을 빼고 뒤쪽 블록의 MSE에서 역전파된 기울기로 간접 학습하게 한 "Skip block 0" 버전은 CIFAR-10에서 1.0%, CIFAR-100에서 2.6% 차이로 좁혀진다. 앞쪽 층이 탐색 기반 학습에 가장 어렵다는 점은 그림 2, 3의 경향과도 일치한다.
탐색 컴퓨트를 늘리면 일반화도 좋아지는가
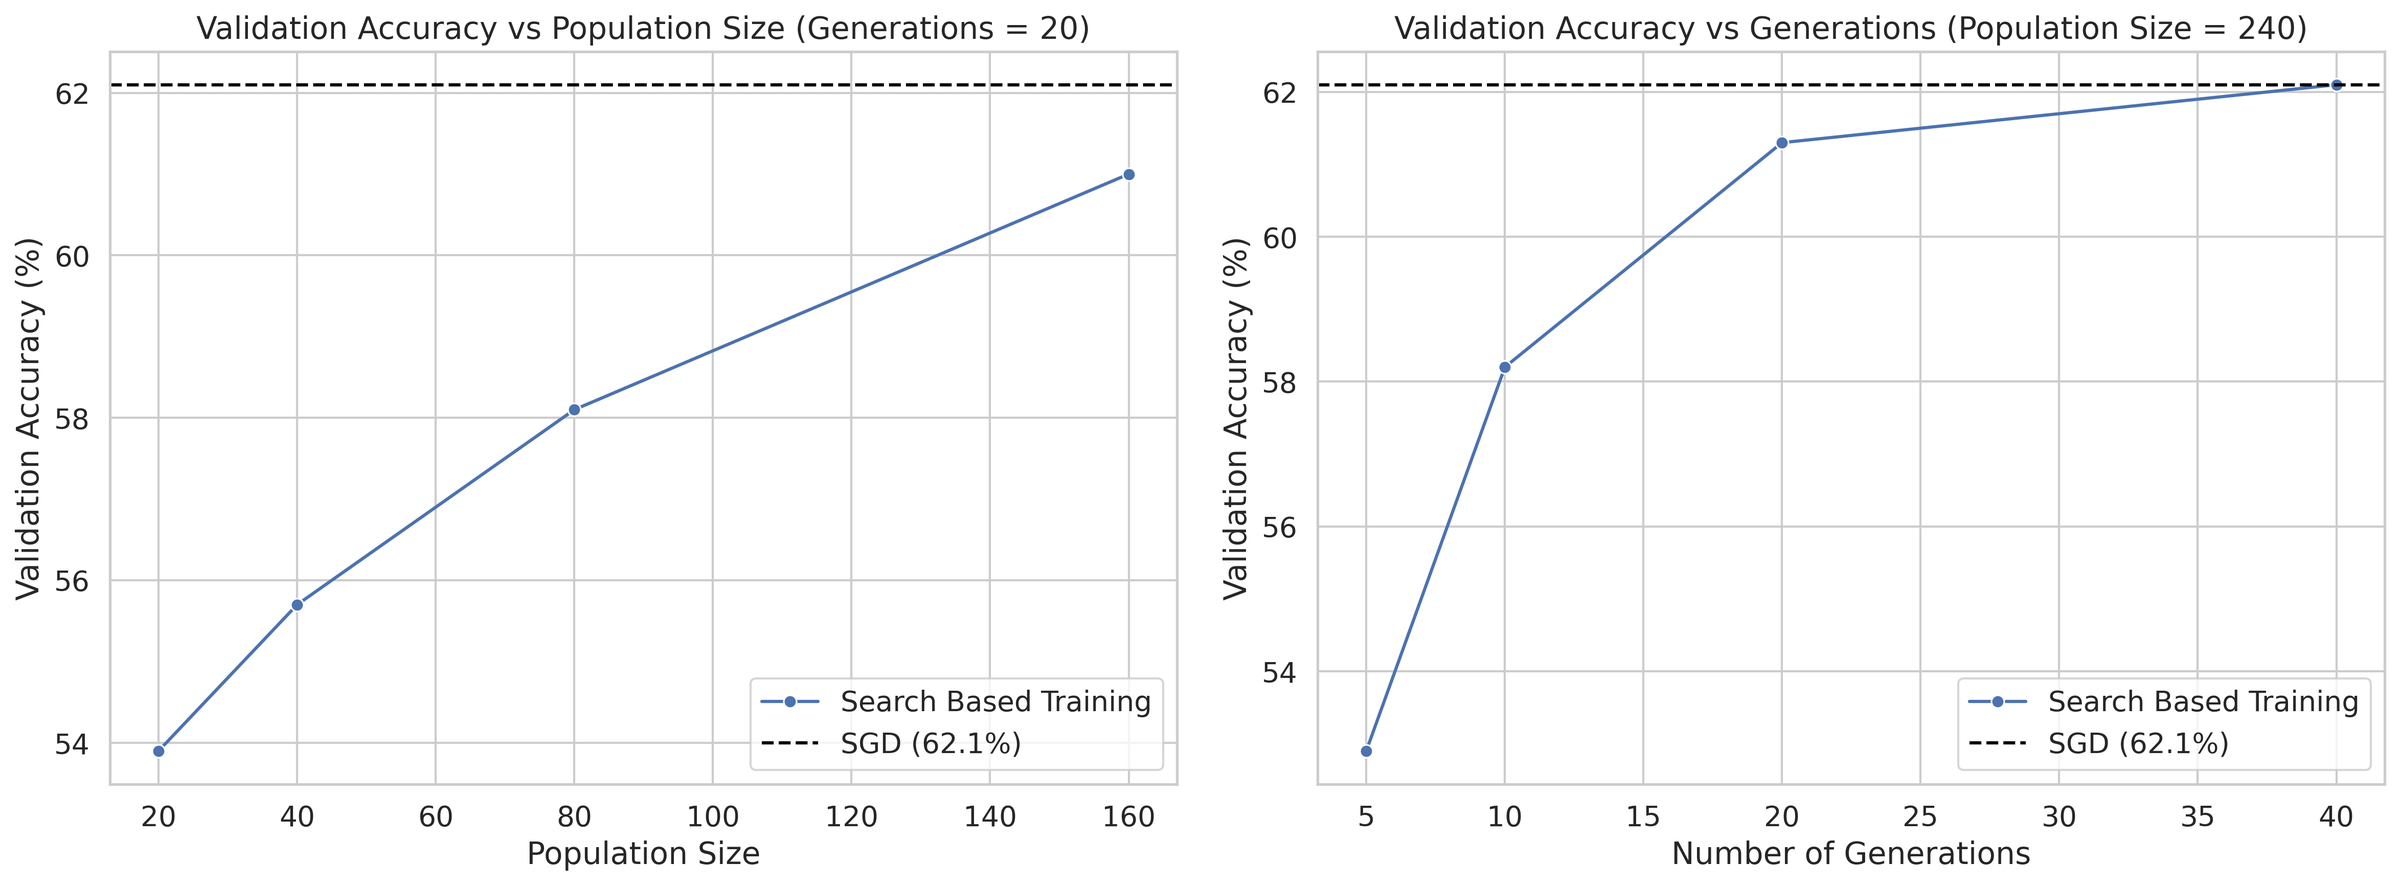
이 논문에서 에세이의 주장과 가장 직결되는 그림이다. 탐색 컴퓨트(population 또는 세대)를 늘려 더 좋은 표현을 캐시하고 그것으로 학습하면, 검증 정확도가 두 축 모두에서 올라간다. 세대를 40까지 늘린 설정은 SGD 62.1%와 같은 수준에 닿는다. 논문 초록은 "포화까지 탐색 컴퓨트에 따라 성능이 개선된다"고 요약한다. 데이터는 고정한 채 컴퓨트만으로 일반화가 올라가는 첫 증거인 셈이다.
탐색으로 배운 모델은 SGD 모델과 다른가
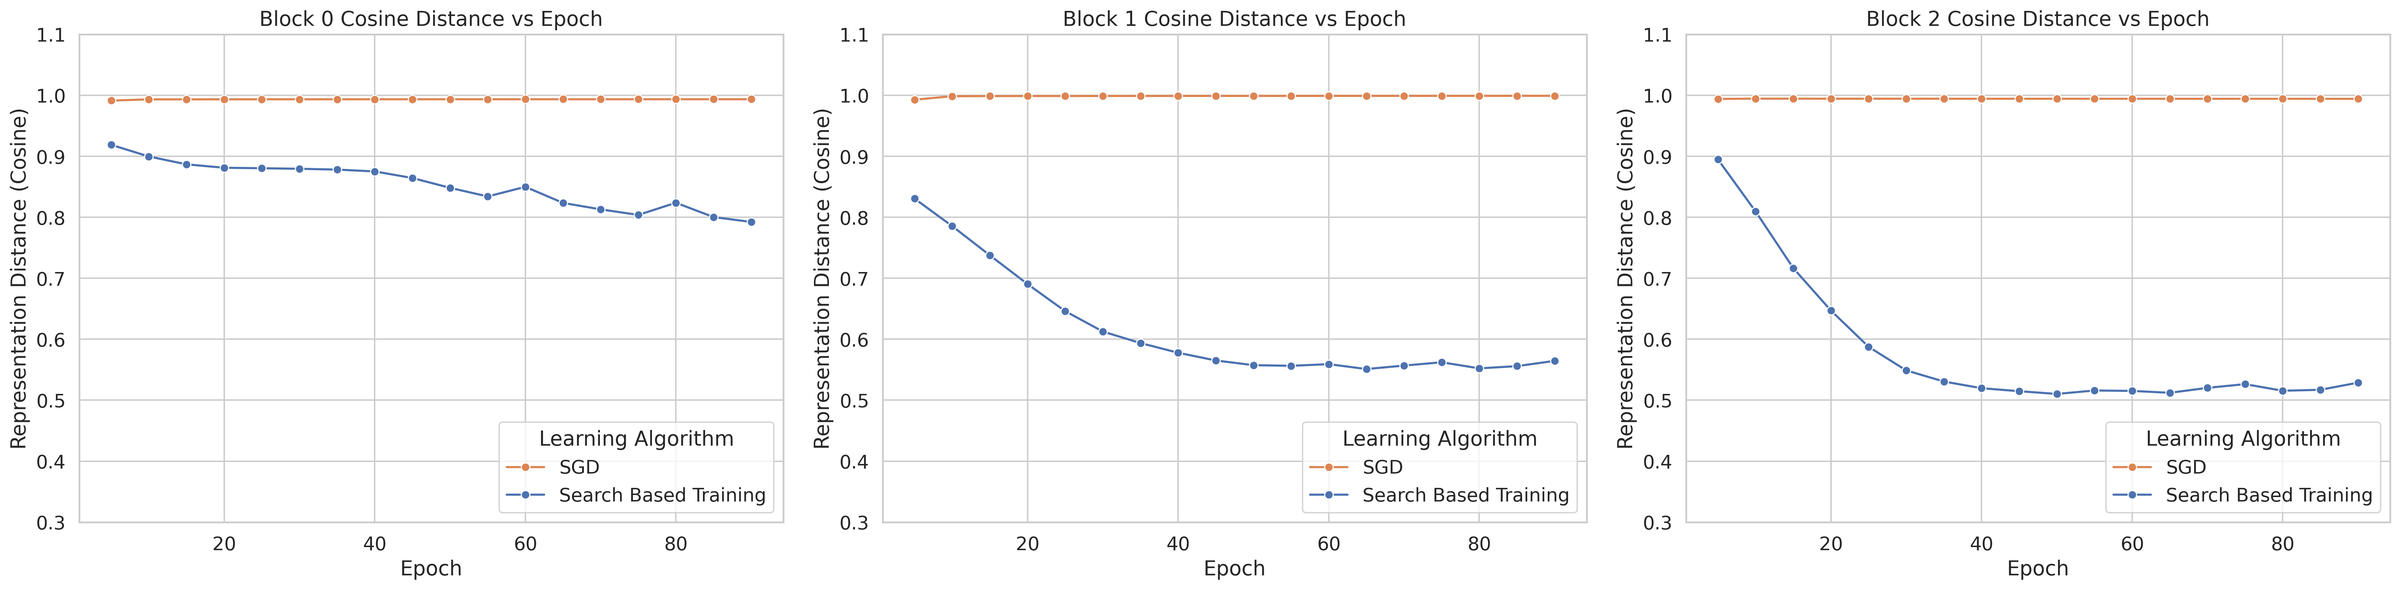
에세이의 궁극적 목표는 "다양한 모델"이다. 그래서 저자들은 탐색 기반으로 학습한 모델이 SGD 모델과 정말 다른지 확인한다. 파라미터 공간의 거리는 재기 어려우니, 모델이 만들어 내는 표현 과 탐색된 타깃 표현 사이의 코사인 거리를 학습 내내 측정했다.
세 블록 모두에서 SGD는 코사인 거리가 1.0 근처에 머문다. SGD가 수렴하는 표현 해는 탐색이 찾은 해와 거의 직교한다는 뜻이다. 반면 탐색 기반 학습은 거리가 꾸준히 내려가 감독이 제대로 작동함을 보인다. within-class / between-class collision entropy 궤적도 두 방법이 다르게 움직였고, 특히 Block 0에서 탐색 기반 학습이 클래스 간 분리를 더 뚜렷하게 만드는 경향이 있었다고 한다. 성능은 비슷해도 최적화 궤적과 도달하는 해가 질적으로 다르다 는 것이 4.5절의 메시지다.
🔍 왜 이것이 Dust의 prequel인가
세 문서를 나란히 놓으면 하나의 연구 프로그램이 보인다.
| The Generalization Problem (2025.8) | Decoupling Search & Learning (2025.9) | Dust (2026.10) | |
|---|---|---|---|
| 역할 | 가설 제시 | 개념 증명 | 스케일 도전 |
| 탐색 공간 | "데이터와 일치하는 모든 모델" | 중간 활성값(표현 공간) | 선형 레이어의 활성값(토큰별 노이즈) |
| 학습 방식 | 탐색 + 일반화 prior | 표현은 진화 탐색, 파라미터는 MSE 회귀 | 순전파 + 손실 감소 보상만으로 기울기 추정 |
| 대상 | 개념 | CNN, MNIST/CIFAR | GPT 스타일 트랜스포머 사전학습 |
| 스케일 축 | 컴퓨트 | population, 세대 | population(draw 수) |
공통된 뼈대는 이렇다. 파라미터 공간이 아니라 활성값 공간에서 탐색하고, 탐색 규모(population)를 컴퓨트로 키운다. Decoupling 논문은 "활성값 공간은 탐색이 가능하고, 거기서 찾은 표현은 학습 가능하다"를 CNN에서 보였고, Dust는 토큰마다 독립적으로 활성값을 흔드는 "가상 개체군"으로 트랜스포머 사전학습까지 밀어붙였다. Dust 글에서 다룬 "큰 모델이 오히려 population 효율이 좋다"는 발견도, 이 에세이가 언급한 과파라미터화 = 더 큰 탐색 공간 + 더 압축 가능한 해 라는 관점의 연장선에서 읽힌다.
차이도 분명하다. Decoupling은 탐색을 한 번 돌려 캐시한 뒤 경사하강으로 그 표현에 회귀 하는 2단계 구조이고, 손실 기울기는 여전히 MSE를 통해 conv 층 내부로 흐른다. Dust는 탐색 결과를 아예 기울기 추정치 로 바꿔 매 스텝 가중치를 갱신하므로 역전파가 완전히 사라진다. 에세이의 두 번째 축인 명시적 일반화 prior 는 두 논문 모두 아직 손대지 않았다. Decoupling 논문도 "다양한 표현이 다양한 모델 해로 어떻게 이어지는지는 더 연구가 필요하다"고 적고 있다.
💡 정리와 열린 질문
에세이의 주장을 세 줄로 요약하면 이렇다.
- 스케일링의 병목은 데이터다. 경사하강 기반 신경망은 데이터와 함께 스케일하고, 컴퓨트와는 간접적으로만 스케일한다.
- 최적의 학습 알고리즘은 탐색 + prior다. 데이터와 일치하는 모델을 탐색으로 찾고, 범용 일반화 prior로 고른다. 탐색은 컴퓨트와 함께 스케일하므로 일반화도 컴퓨트와 함께 스케일한다.
- 첫 걸음은 탐색과 학습의 분리다. 표현 공간에서 진화 탐색, 파라미터 공간에서 경사하강.
Decoupling 논문의 한계도 저자들 스스로 밝힌다. 여전히 SGD에 조금 못 미치고, 탐색과 학습이 서로를 개선하는 반복 루프가 아니라 일회성 탐색 + 캐시 구조다. 그리고 앞쪽 층의 표현은 탐색으로도, 학습으로도 가장 어렵다.
남는 질문은 더 근본적이다. 탐색으로 "데이터와 일치하는 다양한 모델"을 찾았다 치자. 그중 무엇을 고를 것인가? 에세이가 말하는 명시적이고 범용적인 일반화 prior는 아직 아무도 구현하지 못했고, 단순성 같은 고전적 후보는 파라미터 수가 아니라 압축 가능성으로 재야 한다는 교훈만 남긴 상태다. 탐색 쪽은 Decoupling → Dust로 빠르게 진전했지만, prior 쪽은 여전히 빈칸이다. Q Labs의 다음 논문이 그 빈칸을 건드릴지가 이 프로그램을 계속 지켜볼 이유다.
📚 참고
- 에세이 원문: The Generalization Problem (Samip Dahal, Akshay Vegesna, Q Labs Research, 2025.8)
- 동반 논문: Decoupling Search and Learning in Neural Net Training (Akshay Vegesna, Samip Dahal, arXiv 2509.10973, 2025.9)
- 후속 논문 리뷰: Dust: 역전파 없이 트랜스포머를 사전학습하다
- The Bitter Lesson: Richard Sutton, 2019
- No-free-lunch: Wolpert, The lack of a priori distinctions between learning algorithms (1996)
- 과파라미터화와 일반화: Wilson, Deep Learning is Not So Mysterious or Different (2025), Lotfi et al., Non-Vacuous Generalization Bounds for LLMs (2024)
- Solomonoff induction: Solomonoff, A formal theory of inductive inference (1964); Li & Vitányi, An Introduction to Kolmogorov Complexity (1997)
본 글의 그림은 원문에서 가져왔습니다. (에세이에는 그림이 없어 동반 논문 arXiv 2509.10973의 그림을 사용했습니다.)