플라톤적 표상 가설을 정리로: JEPA의 '좋은 뷰'가 모달리티를 회전 하나로 맞춘다
"플라톤적 표상을 만드는 지렛대는 스케일 그 자체가 아니라 양성 뷰(positive views)다."
2026년 10월 29일, Brown의 Randall Balestriero와 NYU의 Yann LeCun(둘 다 AMI Labs 소속)이 Proving and Improving the Platonic Representation Hypothesis with JEPAs 를 공개했다. 2024년 Huh et al.이 "모델이 커질수록 비전 모델과 언어 모델의 표상이 닮아간다"고 관찰한 플라톤적 표상 가설(PRH) 을 JEPA에 대해 정리(theorem) 로 바꾸고, 그 조건대로 학습하면 스케일을 훨씬 덜 쓰고도 더 잘 정렬된다는 것을 보인 논문이다. H-JEPA가 JEPA를 월드 모델로 쓰는 쪽이라면, 이 논문은 JEPA의 양성 쌍(positive pair)을 어떻게 고르느냐가 표상의 정체를 결정한다는 이론 쪽 이야기다.
원문: https://arxiv.org/abs/2610.39302 · 코드: github.com/galilai-group/prh-proof · 데모: huggingface.co/spaces/galilai-group/prh_demo
🤔 배경: 플라톤적 표상 가설, 그리고 왜 증명이 필요한가
Huh, Cheung, Wang, Isola (MIT, 2024) 의 PRH 논문은 서로 다른 아키텍처·목적함수·모달리티로 학습한 신경망들의 표상이 수렴하고 있다고 주장했다. 도구는 mutual k-NN이다. 같은 샘플 집합을 두 모델로 각각 임베딩하고, 각 샘플의 k-최근접 이웃 집합을 두 공간에서 구해 교집합 크기를 k로 나눠 평균한다. 아무것도 피팅하지 않으므로 두 공간의 축이 전혀 달라도 쓸 수 있다. 프로토콜은 WIT(Wikipedia 이미지-캡션) 1,024쌍에 k=10, 층별 특징 쌍 중 최대값이었고, 언어 모델 성능이 좋을수록 비전 모델과의 정렬이 오르는 추세를 보고했다. 수렴 압력으로는 다중 과제 스케일링, 용량, 단순성 편향을 제시하고, 종착점은 "현실을 생성하는 통계적 모델"일 것이라고 추측했다.
문제는 이것이 어디까지나 가설이라는 점이다. PRH 논문의 이론적 뒷받침은 이상화된 contrastive 학습기의 커널이 PMI로 수렴한다는 논증이고, 이후에도 deep linear network에 대한 증명 정도가 있을 뿐이다. 실제로 쓰는 자기지도 목적함수, 특히 JEPA에 대해서는 증명도, 언제 성립하는지에 대한 예측도, 따라서 정렬을 개선할 레시피도 없다. 그래서 지금까지는 모델과 데이터를 키우는 것만이 유일한 지렛대였다. 이 논문의 질문은 "서로 다른 모달리티에서 따로 학습한 모델이 증명 가능하게 같은 표상을 배우는 때는 언제인가"다.
🧠 핵심 아이디어: 정렬은 스케일이 아니라 '양성 쌍'이 결정한다
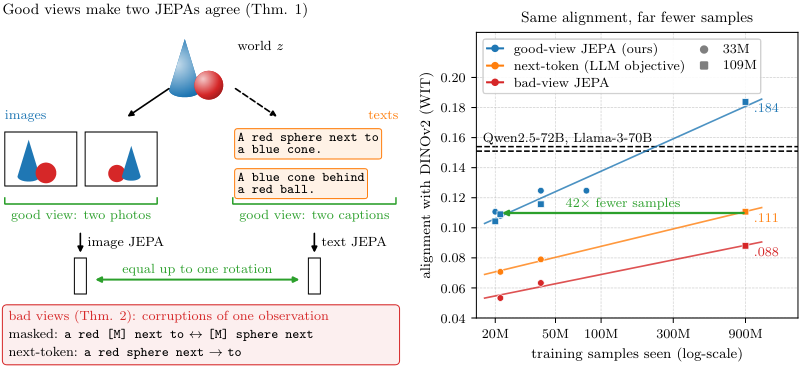
그림 1이 논문 전체를 요약한다. 논증은 짧다. JEPA는 양성 쌍(서로의 뷰라고 선언한 두 입력)의 임베딩을 가깝게 만들면서 collapse를 막는 항을 더한 목적함수이고, whitening 같은 2차 모멘트 anti-collapse를 쓰면 양성 쌍이 그리는 그래프의 스펙트럴 임베딩(Laplacian eigenmaps의 모집단 버전)을 배운다. 그런데 사진의 픽셀이든 캡션의 토큰이든, 렌더링이 세계 상태를 단사(injective)로 보내는 한 그것은 좌표계를 바꾼 것에 불과하다. 두 모달리티의 양성 쌍이 같은 세계 상태 쌍을 연결한다면 두 학습 문제는 다른 좌표계로 적은 같은 문제이고, 해는 회전 하나 차이다. 이것이 플라톤적 표상 정리다. 이미지와 텍스트에 특정한 것은 없어서 비디오·오디오·행동 등 어떤 모달리티 조합에도, 몇 개가 동시에 있어도 성립한다.
그러니 PRH는 결국 양성 뷰에 대한 진술이다. 저자들은 양성 쌍을 두 종류로 나눈다.
- Good view: 세계가 스스로 연결하는 두 관찰. 같은 장면의 두 사진, 같은 이미지에 붙은 두 캡션.
- Bad view: 한 관찰의 두 변형. 사진 하나의 두 크롭, 문장 하나의 두 마스킹.
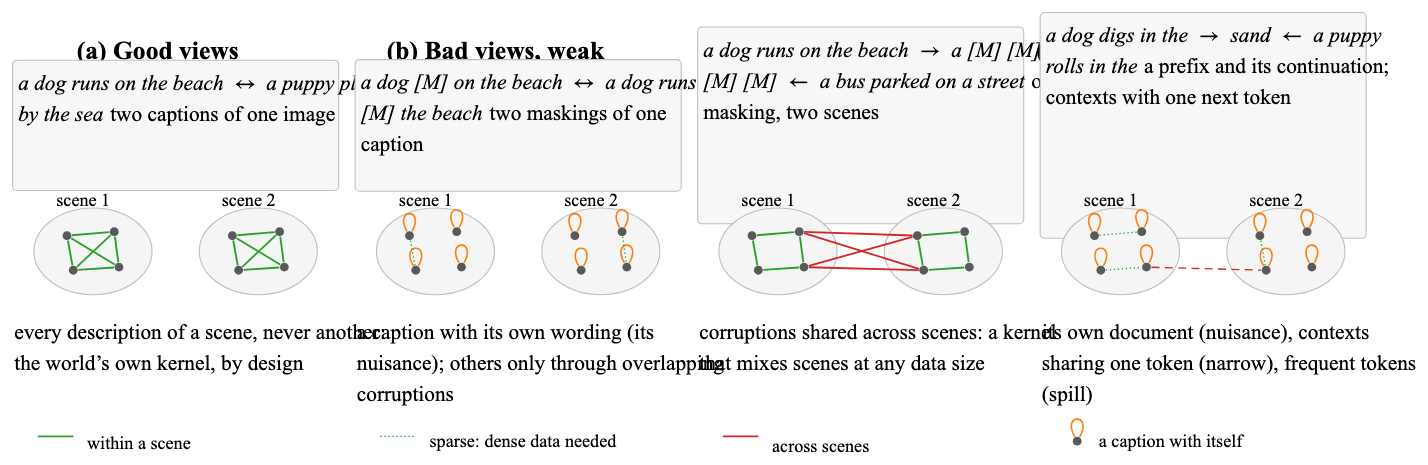
차이는 nuisance에서 온다. 캡션의 단어 선택, 사진의 시점은 그 모달리티 고유의 잡음이라 다른 모달리티의 어떤 회전으로도 맞출 수 없다. Bad view는 한 관찰의 변형이므로 nuisance를 공유하고, 인코더는 임베딩 차원 일부를 거기에 쓴다. Good view는 장면만 공유하므로 쓰지 않는다. 그리고 그림 3(d)처럼 next-token prediction은 bad-view JEPA다. 양성 쌍이 한 문서 안의 접두사와 연속이므로 그 문서의 문체를 공유하고, 세계 상태가 아니라 단어 겹침으로 텍스트를 연결한다. 언어 모델이 비전과 대부분 스케일을 통해서만 정렬되는 이유를 저자들은 이렇게 읽는다.
📐 정리와 증명 스케치
세계는 확률 을 가진 유한한 상태 집합 , 모달리티 은 단사 렌더링 로 세계를 본다. 모달리티 의 JEPA 인코더 는 양성 쌍 분포 위에서 다음을 최소화한다.
은 예측 항, 는 임베딩 분포에만 의존하는 anti-collapse 항이며 둘 다 회전 에 불변이다. 예측기는 항등 함수다(행동 조건부 예측기를 쓰는 월드 모델 JEPA는 이 분석의 범위 밖이다). 핵심 관찰은 단사 렌더링은 좌표만 바꾸므로 , 즉 세계 상태 위에 쓴 같은 목적함수라는 것이다.
정리 1 (플라톤적 표상 정리). 개 모달리티가 하나의 양성 쌍 분포 를 공유하고 의 최소해가 회전을 제외하고 유일하면, 세계의 임베딩 가 하나 존재해 모든 모달리티의 모든 최소해가 다음을 만족한다.
증명은 직접적이다. 모든 이 같은 를 최소화하기 때문이다. 무거운 가정은 "회전을 제외한 유일성"인데, 명제 1이 이를 채운다. 이고 가 임베딩을 whitening하며, 양성 쌍 그래프의 정규화 인접행렬 의 스펙트럼에 번째 뒤로 갭이 있으면, 최소해는 정확히 상위 개 고유벡터의 스펙트럴 임베딩 의 회전들뿐이다. LeJEPA의 SIGReg는 등방성 가우시안을 목표로 하므로 회전 불변이고 2차 모멘트도 같지만, 전체 분포 제약 아래의 유일성은 증명하지 않고 가정으로 남긴다고 명시한다.
실제로는 모달리티마다 양성 쌍이 다르다. 정리 2는 그 경우의 오정렬을 두 양으로 묶는다. 두 양성 그래프의 차이와 eigengap 이다.
무작위 유한 세계 300개에서 실측 오차는 모두 경계 아래, 최대 경계의 18%였다. 블록 버전으로 읽으면 큰 갭으로 분리된 선행 방향은 보호되고 스펙트럼 끝은 정렬될 필요가 없다는 힌트도 나온다.
Good/bad view의 차이는 정리 3과 명제 3이 형식화한다. 임베딩 중 세계 상태가 설명하는 비율(scene-explained fraction)을 라 하면, 두 whitened 인코더 사이의 최선의 회전 오차는 이상이다. nuisance에 쓴 차원은 어떤 회전으로도 돌려받을 수 없다. good-view JEPA는 을 배우지만, bad-view JEPA는 변형이 nuisance를 세계의 번째 방향보다 더 많이 보존하는 순간부터() 차원을 nuisance에 쓴다.
마지막으로 명제 4가 next-token prediction을 JEPA 형식으로 다시 쓴다. 선형 softmax 헤드의 손실은
문맥 인코더 , 토큰 테이블 , 내적 예측, 한 시퀀스 안에서 뽑은 양성 쌍 , 그리고 log-partition이 anti-collapse다. 다만 최적해는 아래 불변이라 는 회전이 아니라 가역 선형 변환까지만 식별되고 스펙트럴 JEPA도 아니다. 그래서 "next-token은 nuisance에 차원을 쓰고 비전과 덜 정렬된다"는 것은 따름정리가 아니라 검증할 예측이라고 저자들은 선을 긋는다.
📊 실험: 같은 텍스트, 같은 인코더, 뷰만 다르게
레시피는 하나다. 이미지 인코더(ViT-S/16)와 텍스트 인코더(12층 BERT, 폭 384, 33M)를 서로의 모달리티를 전혀 보지 않고 각각 LeJEPA 목적함수(SIGReg )로 따로 학습한다. 데이터는 Flickr30k Karpathy split, 학습 이미지 29k장에 캡션 5개씩. 텍스트 인코더는 양성 쌍만 다른 세 변종이다.
- Masked spans(bad-view JEPA): 한 캡션에서 8개 뷰, 각각 무작위 연속 구간으로 자르고(trimming) 토큰 15% 마스킹.
- Caption views(good-view JEPA): 8개 뷰를 같은 이미지의 서로 다른 캡션에서 뽑고 같은 방식으로 자르고 마스킹.
- Next-token prediction: 같은 BERT를 causal로 바꾸고 tied softmax 헤드로 학습.
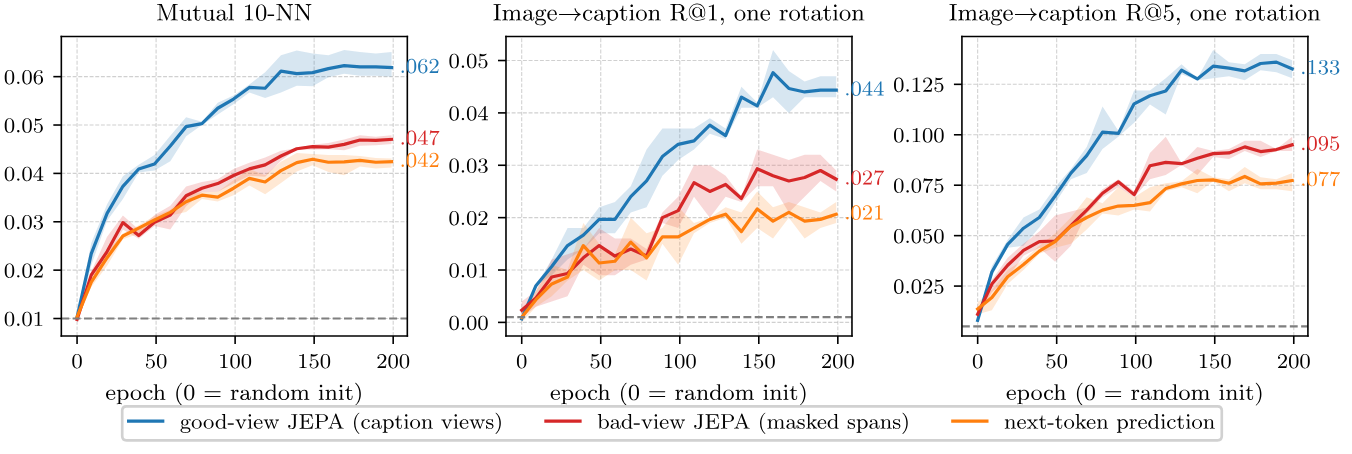
결과(Table 1, 3 seed 평균)는 예측대로다. mutual 10-NN은 good-view .062, bad-view .047, next-token .042(chance .01). 검증 쌍으로 직교 변환 하나만 맞춘 뒤 1,000개 테스트 캡션에서 검색하면 good-view JEPA는 R@1 .044로 chance(0.1%)의 44배이고, bad-view(.027)와 next-token(.021)은 거의 겹친다. 같은 이미지의 캡션 두 개를 이어 붙여 학습한 next-token도 .042→.043, R@1 .021→.023으로 거의 움직이지 않는다. 이득은 정보가 아니라 목적함수에서 온다. nuisance도 직접 쟀다. 이미지당 캡션 5개로 를 추정하면 에서 good-view .804, bad-view .655, next-token .608이고, 정리 3의 하한 12.6/22.1/25.1을 실측 오차 33.5/39.4/40.3이 순서대로 따른다.
노브를 하나씩 바꿔 보면(frozen DINOv2 상대 R@1) collapse하지 않은 모든 good-view 변종이 .18~.28에 떨어져 bad-view(.13)와 next-token(.12)을 훌쩍 넘었고, 가장 큰 변수는 trimming이었다. 캡션 전체를 뷰로 쓰면 정렬의 1/4을 잃는다(.246→.185). 두 설명이 공유하는 내용만 남기는 것이 trimming이기 때문이다. 마스킹·뷰 수·배치·폭·스케줄은 평균을 최대 .016 움직였다. 안정성은 별개라서 gradient clipping 없이는 36개 런 중 3개가 20~60 에폭 사이에 collapse했고, clipping을 켜면 대부분 해결된다.
이미지 쪽은 비디오(MSR-VTT)로 확인했다. 다른 프레임/다른 캡션이면 good, 한 프레임의 크롭/한 캡션의 구간이면 bad다. mutual 10-NN은 양쪽 good .067, 텍스트만 good .059, 이미지만 good .043, 둘 다 bad .039다. 반대로 크롭을 양성으로 쓰는 frozen DINOv2는 크롭으로 학습한 이미지 JEPA와 더 잘 맞는다(.144 vs .132). 정렬은 양성 쌍의 일치를 따라간다.
웹 텍스트로 스케일: 42배 적은 샘플, 109M이 72B를 넘다
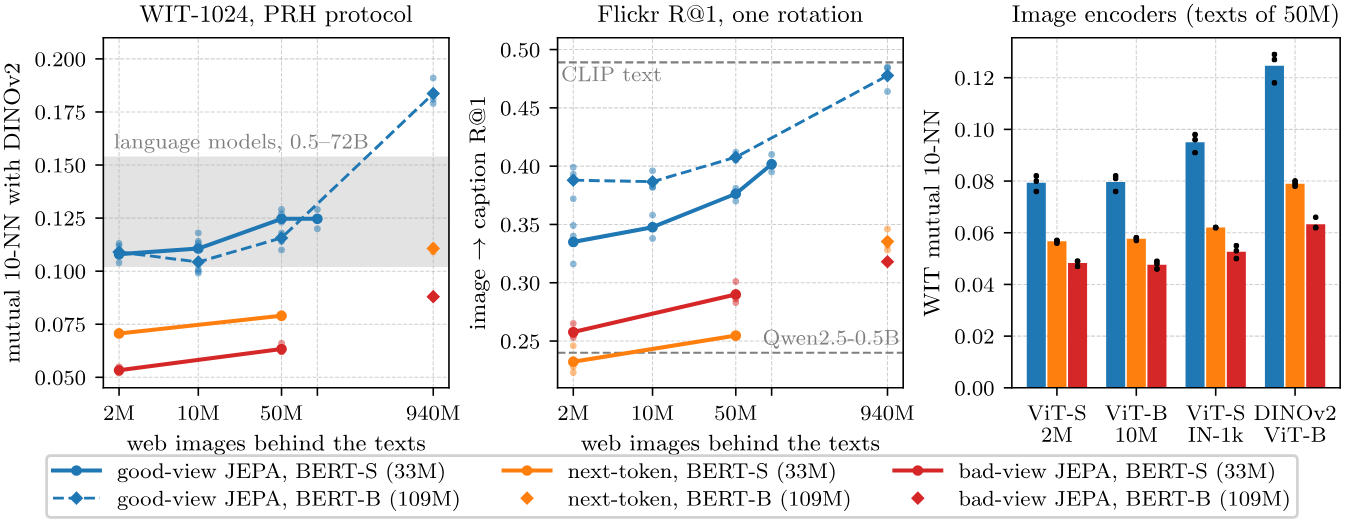
같은 33M 인코더를 Recap-DataComp 웹 이미지의 텍스트로 학습한다. 이미지마다 alt-text 하나와 이미지 캡셔너(LLaVA, LLaMA-3-8B 기반)가 쓴 recaption 두 개가 있고, 이 셋이 뷰다. 어떤 모델도 Flickr·COCO 캡션이나 WIT를 보지 않는다. WIT-1024에서 DINOv2 ViT-B와의 정렬은 Flickr 캡션 학습 시 .034에서 2.16M/10M/50M 이미지의 텍스트로 .108/.111/.125까지 오르고 100M에서 .125에 머문다. 이 33M 모델이 Qwen2.5-3B·7B(.125, .118)와 같은 수준이다. 같은 텍스트와 스텝으로 bad-view는 .053, next-token은 .071(2.16M 기준)에 그친다.
기사 제목이 된 42배는 이렇게 나온다. 같은 109M 인코더(BERT-B)를 같은 코퍼스로 학습했을 때 good-view JEPA는 21.6M 샘플(이미지 2.16M장의 텍스트)에서 WIT .109에 도달하고, next-token prediction은 900M 샘플(이미지 940M장의 텍스트)에서 .111에 도달한다. 샘플 수로 42배, good-view 샘플은 텍스트 셋을 읽으므로 토큰 수로는 14배, 고유 이미지 수로는 435배다. 단, 각 런은 자기 스케일의 레시피를 쓰고(lr ·배치 256 vs ·배치 2,048), next-token 쪽은 900M 이전 체크포인트를 채점하지 않았다고 적혀 있다. 같은 샘플 수에서 비교하면 격차가 더 커서, 33M 인코더 21.6M 샘플에서 .108 vs .071이다.
데이터와 모델을 함께 키운 결과가 Table 3이다. 109M BERT-B를 940M 이미지의 텍스트에서 900M 샘플로 학습한 세 모델과 언어 모델·텍스트 인코더를 PRH 프로토콜로 비교한다.
| 텍스트 인코더 | WIT 10-NN (DINOv2-B) | WIT CKA | WIT 10-NN (CLIP-H) | COCO 10-NN | Flickr R@1 |
|---|---|---|---|---|---|
| good-view JEPA (109M) | .184 | .507 | .230 | .161 | .478 |
| next-token (109M, 같은 텍스트) | .111 | – | .146 | – | .335 |
| bad-view JEPA (109M, 같은 텍스트) | .088 | – | .116 | – | .318 |
| Qwen2.5-72B | .154 | .418 | .210 | .108 | – |
| Llama-3-70B | .151 | .380 | .206 | .113 | – |
| CLIP B/32 text | .124 | .339 | .159 | .132 | .489 |
| all-mpnet-base-v2 | .118 | .390 | .159 | .156 | .481 |
116B 텍스트 토큰을 읽은 109M 인코더가 1518T 토큰으로 학습한 660배 큰 모델들을 넘는다. Qwen2.5는 7B32B에서 .118~.130, 72B에서 .154로 스케일에 따라 거의 늘지 않는다(부록 Table 16). 400M 쌍으로 학습한 CLIP 텍스트 인코더보다도 DINOv2와 더 잘 맞는다(CLIP 텍스트는 DINOv2가 아니라 CLIP 이미지 인코더에 맞춘 것이라는 단서가 붙는다). 저자들의 세 가지 단서도 옮긴다. SIGReg 가중치를 두 배로 둔 네 번째 seed는 .121에 그쳤고(4 seed 평균 .168), recaption을 쓴 캡셔너는 CLIP ViT-L/14로 이미지를 보며, WIT 캡션 1,024개 중 최소 43개가 Recap alt-text에 섞여 있다(제거해도 변화 .002 이하).
정렬의 스케일링 법칙
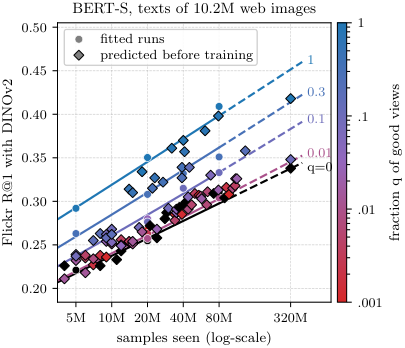
학습 아이템마다 확률 로 good view(이미지의 두 텍스트), 아니면 bad view(한 텍스트의 두 변형)를 뽑는 레시피로, 이미지 장의 텍스트에서 샘플을 학습했을 때 정렬은
를 따른다. 에 비례하는 bad-view 바닥에 good-view 항이 얹힌 꼴이다. 80M 샘플까지의 격자 45칸에 RMSE .007로 맞고, 학습 전에 무작위 85개 런을 예측했더니 RMSE .0093으로, 같은 런을 다른 seed로 돌렸을 때의 차이(.0096)와 같다. 샘플이 good view를 대체하는 정도는 으로 sublinear하고, 고유 이미지 수의 기여는 로 약하다. 다만 피팅 범위의 4배인 320M 샘플(이미지 31회 반복)에서는 good-view 런을 과대평가하고(q=1에서 예측 .455 vs 실측 .418), 지수가 잘 식별되지 않는 한 레시피의 경험적 요약이지 정리의 귀결은 아니라고 못 박는다.
회전 하나로 캡셔너 만들기
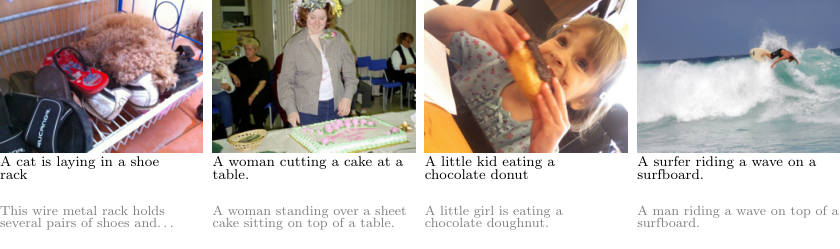
회전 하나로 공간이 겹친다면 따로 학습한 인코더를 합성할 수 있어야 한다. 캡션 디코더를 텍스트만으로 학습한다. causal transformer가 frozen good-view JEPA의 캡션 임베딩에서 그 캡션을 복원하되, 정렬 오차를 견디도록 가우시안 노이즈를 더한다. 이미지는 frozen DINOv2로 임베딩하고 회전을 적용한 뒤 디코딩한다. 이미지-캡션 쌍으로 맞춘 것은 회전뿐이다. 노이즈는 튜닝 대신 계산한다. 회전 후 평균 코사인이 이면 이고, 실제로 전이가 거기서 최고다. Flickr 테스트 1,000장에서 CIDEr .396(0~1 스케일; 무작위 회전의 9배), Flickr 쌍으로만 맞춘 회전이 COCO 5,000장에서 .668로 전이되며, Qwen2.5-1.5B를 텍스트로만 미세조정한 디코더와 DINOv2 ViT-g·DINOv3 ViT-L, 32개 샘플 합의를 쓰면 COCO CIDEr .838에 이른다. 같은 30k 쌍으로 자유로운 선형 맵이나 MLP를 학습하면 COCO에서 손해다(.635 vs .802). 회전은 공간을 돌릴 수만 있으니 새 이미지로 옮겨 가고, 자유로운 맵은 쌍에 과적합한다. 프레임 8개의 평균으로 MSR-VTT 클립에도 CIDEr .246을 낸다.
쌍이 하나도 없어도
쌍 없는 데이터의 1·2차 모멘트로는 회전을 못 찾지만(명제 2), 유한 세계의 기하는 찾을 수 있다. Schnaus et al.의 pair-free 방법(두 점구름의 클러스터를 맞추고 최적 수송으로 직교 맵을 다듬는)을 코드 그대로 돌렸다. COCO train2014의 겹치지 않는 두 반에서 한쪽은 이미지만, 다른 쪽은 캡션만 쓴다. 109M good-view JEPA는 FOSCTTM .018, 제로샷 CIFAR-10 86.0%, CIFAR-100 top-5 67.2%, ImageNet-100 top-5 64.4% 로, 그 논문이 21개 조합(DINOv3-7B, Qwen3-8B까지)에서 보고한 어떤 정확도(최대 82/62/56%)보다 높다. 동일 조건에서 재실행한 Qwen3-8B(47.6%)를 ImageNet-100에서 16.8점 앞서고, 같은 텍스트의 next-token 모델은 ImageNet-100 20.3%로 실패한다. 다만 400M 쌍으로 학습한 CLIP 텍스트 인코더(68.7%)는 여전히 더 좋다.
🔍 한계: 논문이 스스로 적은 것
이론의 범위. 정리는 유한 세계·단사 렌더링·일치하는 주변분포 위의 모집단 진술이다. 실제 모달리티는 손실이 있고(캡션은 사진의 일부만 본다), 유한 샘플 학습은 귀납 편향에 기댄다. 회전 유일성은 2차 모멘트 anti-collapse에 대해서만 증명됐고 LeJEPA의 전체 분포 제약은 가정으로 남았다. 어떤 실험도 정리 1의 가정을 정확히 만족하지 않는다. 이미지 쪽은 MSR-VTT를 빼면 크롭이 양성이라 저자들 정의로 bad-view JEPA이고, next-token에 대한 정리 3의 적용도 휴리스틱이다.
good view는 어디서 오는가. 가장 큰 단서다. 어떤 텍스트가 같은 장면을 묘사하는지 알아야 한다. Flickr·COCO는 사람이 쓴 캡션이 이미지별로 묶여 있지만, Recap-DataComp에서는 이미지당 세 텍스트 중 둘이 이미지 캡셔너가 생성한 합성 텍스트이고, 그 캡셔너의 비전 인코더는 CLIP ViT-L/14다. 이미지-텍스트 학습에서 증류된 정보가 텍스트에 들어 있는 셈이다. 캡셔너 없이 alt-text와 텍스트 전용 패러프레이즈만으로 good view를 만들면 WIT .060으로, recaption의 .107보다 훨씬 낮다. 따라서 언어 모델·CLIP과의 스케일 비교는 이 텍스트에 의존하고, 같은 텍스트 위에서 뷰끼리 비교한 결과만 그렇지 않다(그때도 good view가 bad view를 이긴다: .060 vs .055).
숫자의 의미. 42배는 학습 샘플 수 기준이지 연산량이나 비용이 아니다. good-view 샘플 하나는 텍스트 셋을 읽고, 두 런의 배치·학습률이 다르며, next-token 쪽은 중간 체크포인트를 채점하지 않았다. .184 vs .154는 이미지 인코더와의 이웃 구조 일치도이지 언어 능력이나 추론 능력이 아니다. 109M JEPA는 문장을 생성하지 못하는 인코더이고, 논문은 추론이나 다운스트림 성능에 대해 아무 주장도 하지 않는다. 캡셔너의 회전은 Flickr 쌍 30k개로 맞춘 것이라 "쌍을 전혀 안 쓴" 것은 pair-free 절뿐이다. 하이퍼파라미터는 good-view JEPA에 대해서만 튜닝됐다. 증명은 항등 예측기 JEPA에 관한 것이라 행동 조건부 JEPA 월드 모델에는 그대로 적용되지 않는다.
💡 정리
- PRH는 양성 뷰에 대한 진술이다. 단사 렌더링 아래 JEPA의 학습 문제는 세계 상태 위의 문제를 다른 좌표로 쓴 것이고, 모달리티들이 "어떤 세계 상태 쌍이 양성인가"에 합의하면 해는 회전 하나 차이다. 합의하지 못하면 오정렬은 양성 그래프의 차이와 스펙트럴 갭으로 묶인다.
- Bad view는 nuisance에 차원을 쓰고, next-token prediction은 bad-view JEPA다. 한 문서 안의 접두사-연속 쌍은 문체를 공유하므로 언어 모델은 단어 겹침으로 텍스트를 연결하고, 비전과는 스케일로 조금씩만 정렬된다.
- 같은 텍스트·같은 인코더에서 뷰만 바꾼 실험이 이를 확인한다. 42배 적은 샘플로 같은 정렬, 109M JEPA가 72B 언어 모델을 PRH 벤치마크에서 앞서고, 정렬은 scaling law로 예측되며, 회전 하나로 캡셔너가 되고, 그 회전은 쌍 없이도 찾을 수 있다.
H-JEPA가 "예측 가능한 것만 남기는" JEPA의 성질을 계층적 계획에 썼다면, 이 논문은 그 "무엇이 남는가"를 양성 쌍이 결정한다고 증명한다. 다만 이 결과는 표상의 정렬에 관한 것이다. Jev 글의 "모델이 결정을 잘 내리는가"와는 다른 축이고, 정렬된 표상이 과제 성능으로 이어지는지는 논문 바깥에 있다. 그럼에도 "스케일 대신 양성 쌍의 정의를 바꾸라"는 처방이 정리와 함께 왔다는 점에서, PRH 논의의 가장 구체적인 한 걸음으로 보인다.
📚 참고
- 논문: Proving and Improving the Platonic Representation Hypothesis with JEPAs (arXiv 2610.39302), Randall Balestriero, Yann LeCun, 2026
- 코드/데모: github.com/galilai-group/prh-proof, HF Space prh_demo
- 배경: The Platonic Representation Hypothesis (arXiv 2405.07987), Minyoung Huh, Brian Cheung, Tongzhou Wang, Phillip Isola, 2024
- LeJEPA / SIGReg: LeJEPA (arXiv 2511.08544), Balestriero & LeCun
- 계기 기사: AI타임스, "다른 AI가 같은 세상을 이해하는 조건 증명"
- 관련 글: H-JEPA: 잠재 공간을 층층이 쌓아 더 먼 미래를 계획하는 월드 모델
본 글의 그림은 원문에서 가져왔습니다.