Context Language Models: 컨텍스트를 파일처럼 직접 고치는 LLM
"컨텍스트는 LM의 핵심인데, 왜 정작 그 관리는 LM이 아니라 하네스가 할까?"
2026년 9월 29일, University of Washington과 Meta Superintelligence Labs(Rulin Shao, Nathan Lambert, Luke Zettlemoyer, Pang Wei Koh 등)가 Context Language Models (CLMs) 라는 논문을 냈다. 아이디어는 간단하다. 모델의 라이브 컨텍스트를 파일 하나로 미러링하고, 모델이 그 파일을 Bash로 아무 제한 없이 고칠 수 있게 하자. 그러면 "무엇을 남기고 무엇을 버릴지"를 사람이 설계한 하네스가 아니라 모델 스스로 결정하게 된다.
결과도 간단하지 않다. 학습 없이(zero-shot) 기존 모델에 적용하는 것만으로 BrowseComp-Plus에서 11.4% 더 높은 정확도를 21.5% 더 적은 FLOPs 로, 12시간짜리 EdgeBench에서 5% 높은 점수를 59% 적은 FLOPs 로 얻었다. 자연어 한 문장으로 전략을 바꾸고, 온라인 RL로 가중치에 녹이고, 서빙 엔진까지 공동 설계했다.
원문: https://arxiv.org/abs/2609.37725
🤔 배경: 컨텍스트 관리는 왜 LM의 능력이 아니었나
긴 작업을 하는 에이전트는 결국 컨텍스트 창을 넘친다. 그래서 지금까지는 하네스(harness) 가 그 문제를 대신 풀어 왔다. 저자들은 기존 접근을 두 갈래로 정리한다.
- 하네스가 정한 정책(harness-defined): Codex 스타일 요약(compaction), Cursor의 self-summarization처럼 정해진 길이에 도달하면 요약하거나 매 턴 압축하는 방식. 사람이 손으로 설계하거나(Cassano & Rush 2026, OpenAI 2026) 오프라인에서 에이전트가 최적화한다(Meta-Harness).
- 행동 기반(action-based): AutoCompact, Self-Compact(언제 압축할지 모델이 결정), Context-as-a-Tool(정해진 구간을 모델이 압축), ACM(오프로딩·검색 툴 추가), Sculptor(조각 선택) 등. 모델의 자율성은 점점 커졌지만 행동 공간은 여전히 사람이 정의한 몇 개의 툴에 묶여 있다.
RLM(Recursive Language Models)처럼 긴 입력을 REPL 변수로 두고 필요할 때 읽는 접근도 있지만, 이건 "무엇을 읽어올지"의 문제를 풀 뿐 이미 들어온 라이브 컨텍스트는 계속 append-only로 자란다.
논문의 입장은 Bitter Lesson이다. 사람이 설계한 압축 규칙은 사전 지식(prior)일 뿐이고, 모델에게 컨텍스트를 완전히 맡기면 그보다 나은 전략을 스스로 탐색하고 학습할 수 있다는 것. Dust 글에서 다룬 "backprop도 저컴퓨트 시대의 편향"이라는 주장과 같은 결의 논리다.
📐 핵심 아이디어: 컨텍스트 전이 함수를 모델에게 넘긴다
형식적으로 보면 차이는 한 줄이다. 표준 LM은 자기 출력을 컨텍스트 뒤에 붙이기만 한다.
CLM은 다음 컨텍스트 자체를 모델이 임의의 함수로 만들어낸다.
식 (2)는 기존의 모든 툴 기반 방법을 포함(subsume)한다. 차이는 그 함수들을 하네스가 미리 정의하느냐, 아니면 모델이 메타 능력으로서 스스로 정의하느냐다.
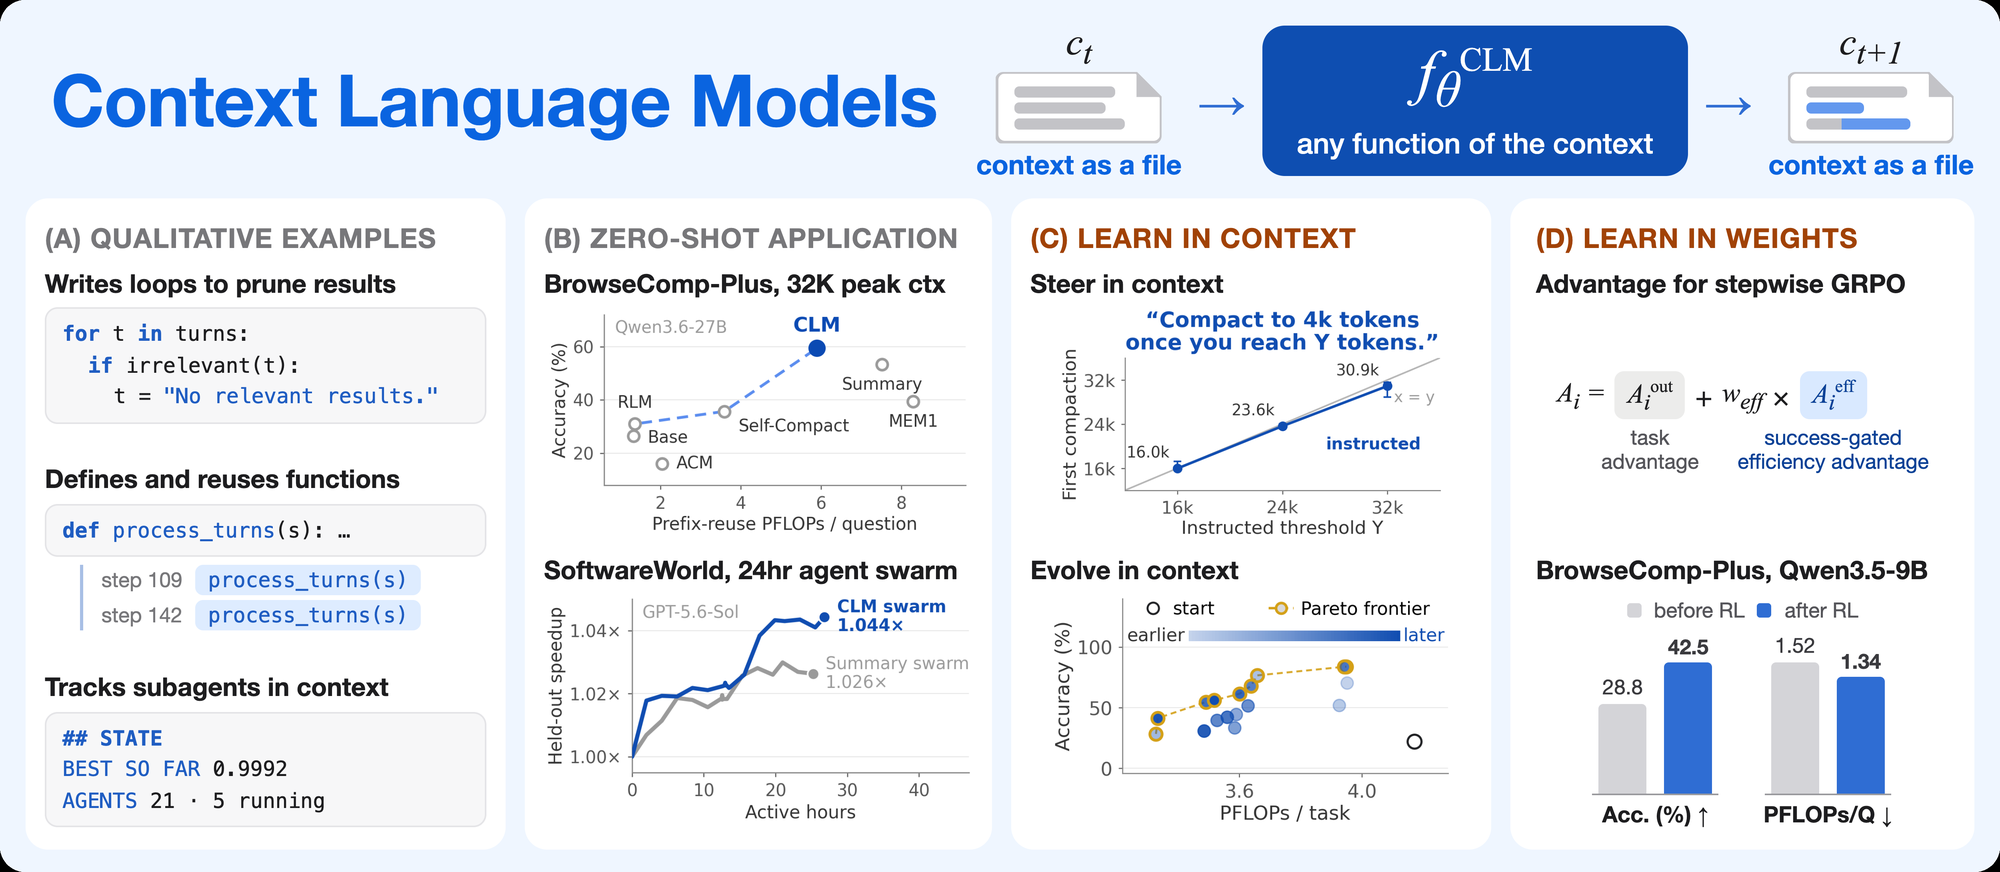
그림 1이 논문 전체를 요약한다. 왼쪽부터 (A) 모델이 자발적으로 만들어낸 컨텍스트 관리 행동, (B) 학습 없이 적용했을 때의 성능·비용, (C) 인-컨텍스트로 조종·진화시키기, (D) RL로 가중치에 학습시키기다.
구현: context as a file
구현은 놀랄 만큼 단순하다.
- LM의 라이브 컨텍스트를 편집 가능한 파일로 미러링하고, 그 경로를 시스템 프롬프트에 알려준다 (예:
/tmp/.live_ctx/LIVE_CTX_MAIN.txt). - 모델은 다른 파일을 다루듯 일반 Bash 명령으로 이 파일을 편집한다 (
sed, Python의re.sub, 루프 등). - 편집은 즉시 LM 서버의 컨텍스트와 동기화되어 다음 턴 생성에 반영된다.
- 편집하지 않으면 기본적으로 기존처럼 append된다.
멀티 에이전트로의 확장도 자연스럽다. 컨텍스트 파일 여러 개가 각자 LLM 서버와 동기화된 채로 공존하면 에이전트 스웜이고, 파일을 만들고 지우면 서브에이전트를 띄우고 종료하는 셈이다.
모델이 스스로 만들어낸 전략들
Section 5.1의 zero-shot 실험에서 수집한 행동들이 흥미롭다.
- 인-컨텍스트 스코어보드: Erdős 최소 중첩 문제에서 21개 서브에이전트를 오케스트레이션하며 163번의 in-place 편집으로 상태판을 갱신하면서 컨텍스트를 6~8K 토큰으로 유지했다.
- 새 역할(role) 발명:
[[CTX_TURN 4 role=notes]]처럼 기존 템플릿에 없던 "notes" 역할을 만들어 내부 메모를 둔다. - 루프로 정리: 과거의 "관련 없음" 검색 결과를 for 루프로 한 줄로 치환하고, 500자 넘는 관측은
[Searched: ...],[Retrieved doc ...]로 압축한다. - 헬퍼 함수 정의·재사용:
compact_turns라는 함수를 정의해 37번 재호출하며 진행 노트를 유지한다. - 기존 베이스라인의 장점 재현: 21K 토큰을 답과 관련된 요약으로 압축하거나, "아직 안 해본 아이디어" 목록을 우선순위와 함께 보존한다.
비용을 정직하게 재기: prefix-reuse FLOPs
여기서 한 가지 짚어야 할 점이 있다. 컨텍스트 중간을 고치면 서빙 엔진의 프리픽스 캐시가 깨진다. 첫 불일치 지점부터 뒤는 전부 다시 prefill해야 한다. CLM이 "컨텍스트가 짧아졌으니 싸다"고 주장하려면 이 재계산 비용을 포함해야 공정하다. 그래서 논문은 prefix-reuse FLOPs 를 정의한다.
Appendix C의 Qwen3.6-27B 예시를 보면 체감이 된다. 20K 프롬프트 + 500 토큰 응답에서 append만 하면 턴당 FLOPs인데, 컨텍스트 중간을 편집해 재사용 가능한 프리픽스가 10K로 줄면 , 맨 앞을 건드리면 FLOPs로 7.7배가 된다. 본문의 모든 비용 수치는 이 지표, 즉 편집의 페널티를 전부 포함한 값이다.
🔍 파일럿: 기존 전략이 어디서 무너지는가 (ContextBench)
저자들은 추론·지식 능력과 컨텍스트 관리 능력을 분리하기 위해 ContextBench 라는 진단 벤치마크를 만들었다. 네 가지 합성 과제로, 모든 입력은 유저 메시지로 "일단 컨텍스트에 들어온 뒤" 에이전트가 처리해야 한다. 하네스가 입구에서 잘라낼 수 없다.
| 과제 | 입력 스트림 | 측정하는 능력 |
|---|---|---|
| Needle Retention | 선택적 verbatim 보존 | |
| Sudoku Sketchpad | 16×16 보드에 턴마다 한 수씩 | 라이브 컨텍스트의 in-place 수정 |
| KV Store | 큰 값 저장·조회 | 오프로딩 & 검색 |
| Log Triage | 작업 로그 | 오프로딩 & 검색 |
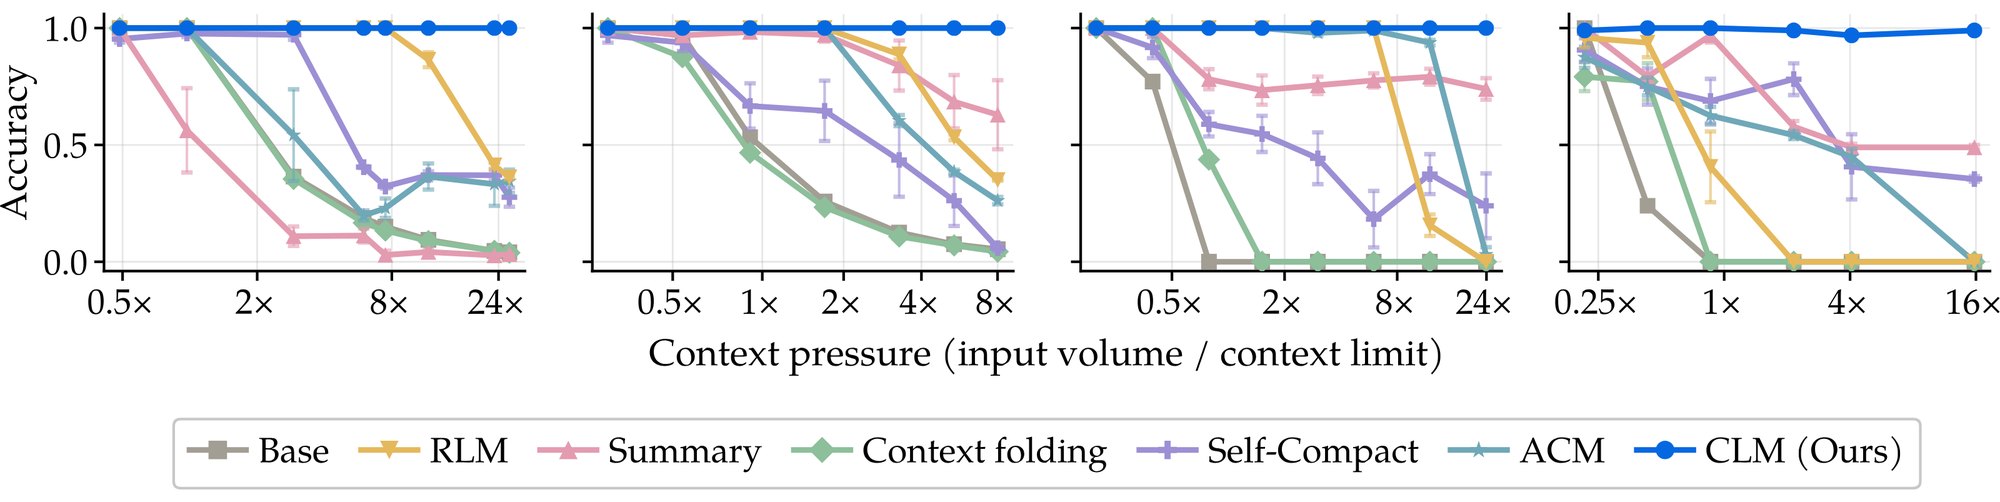
GPT-5.4, 32K 컨텍스트 한도에서 컨텍스트 압력(입력량 / 한도) 을 최대 24배까지 올린 결과가 그림 2다. 요약 기반 압축은 Needle Retention과 Sudoku에서 정보를 잃거나 환각하고, in-place 편집이 없는 방법은 유저가 한 수 둘 때마다 스도쿠 보드 전체를 다시 생성해야 하며, 일반 코딩 툴은 KV Store·Log Triage에서 정보를 파일로 내보낼 수는 있어도 라이브 컨텍스트에서 제때 퇴출(evict) 하지 못한다. 결과적으로 이렇게 단순한 과제에서도 기존 방법 중 완벽한 것은 없었고, CLM만 네 과제에서 거의 만점에 가깝게 버텼다.
📊 Zero-shot 결과: 더 적은 연산으로 더 높은 정확도
코딩·딥 리서치
Qwen3.6-27B, 32K 컨텍스트, 100턴 제한, Mini-SWE-Agent 백본을 공유한 채 MEM1, Self-Compact, ACM, RLM, Codex 스타일 Summary와 비교했다. 공정성을 위해 모든 방법은 학습 없이 평가했다.
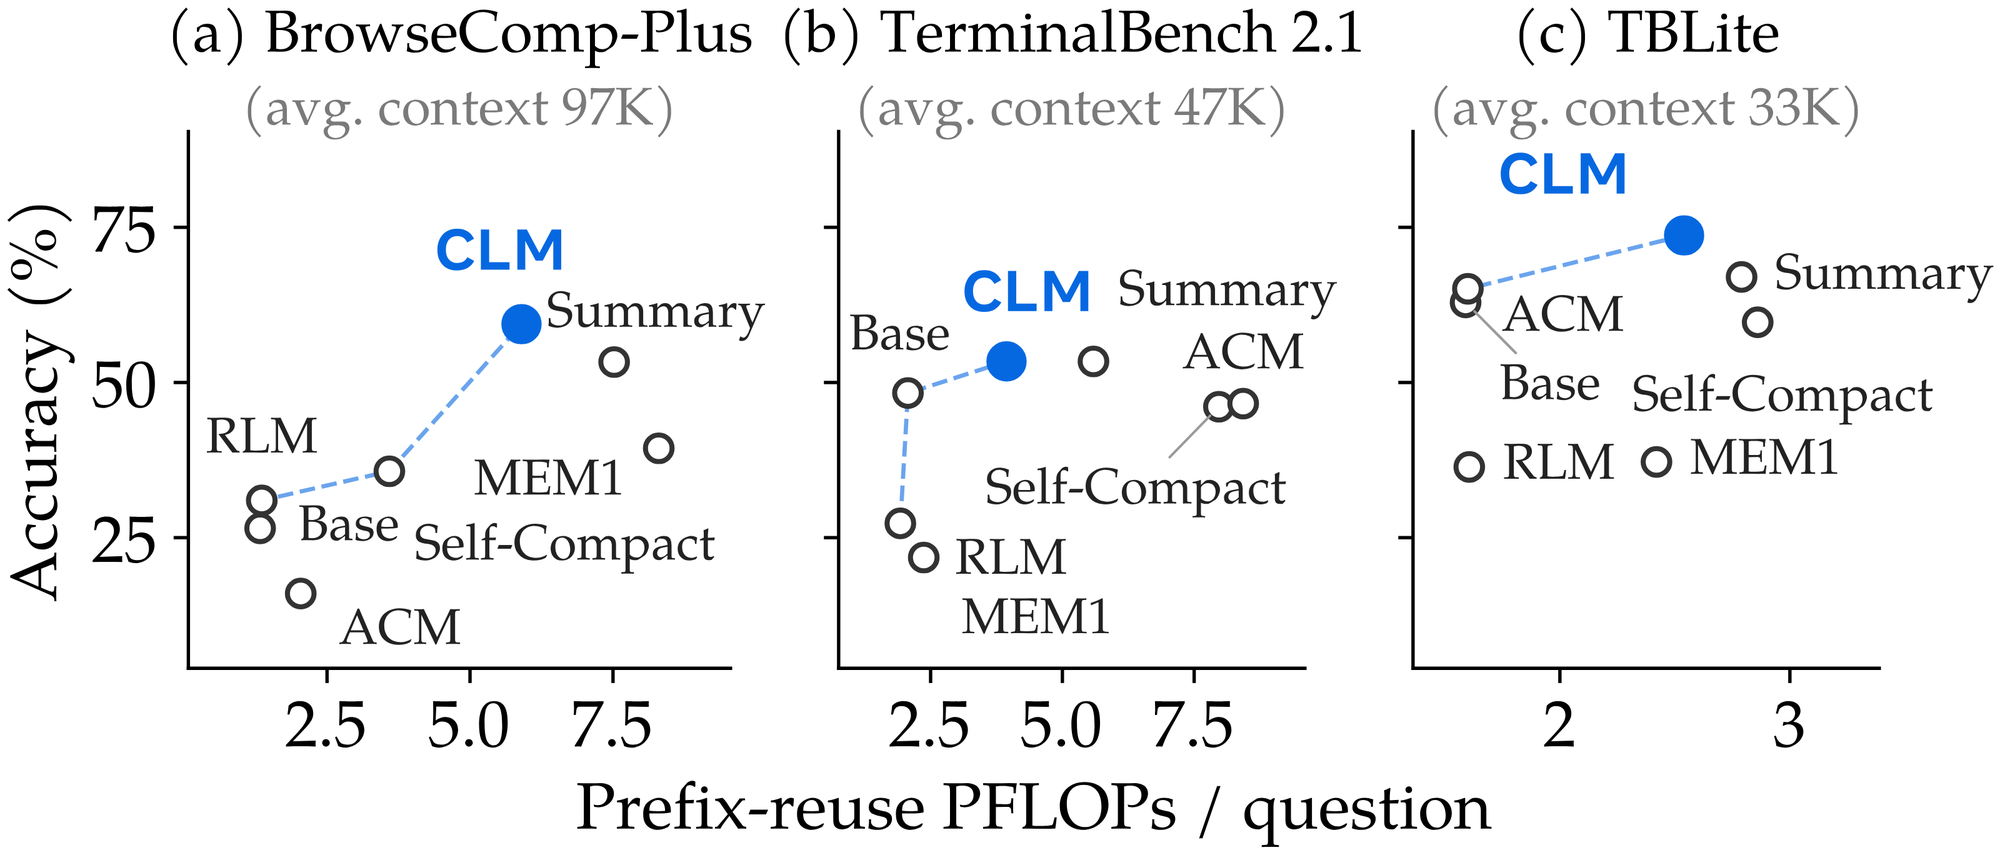
- BrowseComp-Plus: CLM 59.4%로 가장 강한 베이스라인인 Codex 스타일 Summary보다 11.4% (상대) 높고, Summary·MEM1보다 각각 21.5%, 28.9% 적은 prefix-reuse FLOPs.
- TerminalBench 2.1: Summary와 정확도는 같으면서 FLOPs는 70% 수준.
- TBLite: 73.7% vs 67.0%, FLOPs는 91%.
세 그래프 모두에서 CLM이 Pareto 프런티어에 올라 있다. 참고로 Appendix F에서는 작은 모델(Qwen3.5-9B)로도 BCP 39.9% vs Summary 37.7%로 앞서지만, 작은 모델은 컨텍스트를 덜 편집한다(TB2.1에서 과제당 1.4회 vs 27B의 2.6회). 편집할지 말지를 모델에 맡기는 방식이므로, 이득은 모델의 판단 능력에 비례해서 커진다는 점이 솔직하게 기록되어 있다.
오픈 디스커버리: 수학 최적화, 12시간 코드 최적화, 24시간 스웜
| 과제 | 비교 대상 | 결과 |
|---|---|---|
| 수학 최적화 4문제 (Claude 4.6 Sonnet) | OpenEvolve, OpenEvolve-Agent | Circle packing 2.618 vs 2.541, Heilbronn 0.03653 vs 0.03127 (+16.8%), 4문제 모두 최고 |
| EdgeBench-10, 12시간 (Qwen3.6-27B, 32K) | Codex 스타일 Summary | 44.6 @ 179 PFLOPs vs 42.3 @ 437 PFLOPs (59% 적은 연산) |
| EdgeBench-10 (Claude 4.6 Sonnet) | Summary | 51.0 vs 42.3 |
| Software World, 24시간+, 6개 저장소 스웜 (GPT-5.6-Sol, 272K) | Summary 스웜 | 같은 비용에서 다운스트림 속도 향상 65% 더 큼 (1.044x vs 1.026x) |
수학 최적화에서는 AlphaEvolve 스타일의 전용 진화 워크플로우에 진화 알고리즘을 인-컨텍스트 가이드로만 주고 나머지는 에이전트에 맡긴 CLM이 이겼다. 단일 저장소 EdgeBench에서는 서브에이전트가 큰 이득을 주지 않았지만(44.2 vs 44.6), 128K 예산에서는 서브에이전트 변형이 50.2로 가장 높았다.
💡 인-컨텍스트로 조종하고 진화시키기
CLM의 진짜 매력은 컨텍스트 관리가 모델의 행동이 되었다는 점이다. 행동이면 프롬프트로 바꿀 수 있고, 학습시킬 수도 있다. 수식으로는 지시문 를 조건으로 넣는 것뿐이다.
한 문장으로 전략 바꾸기
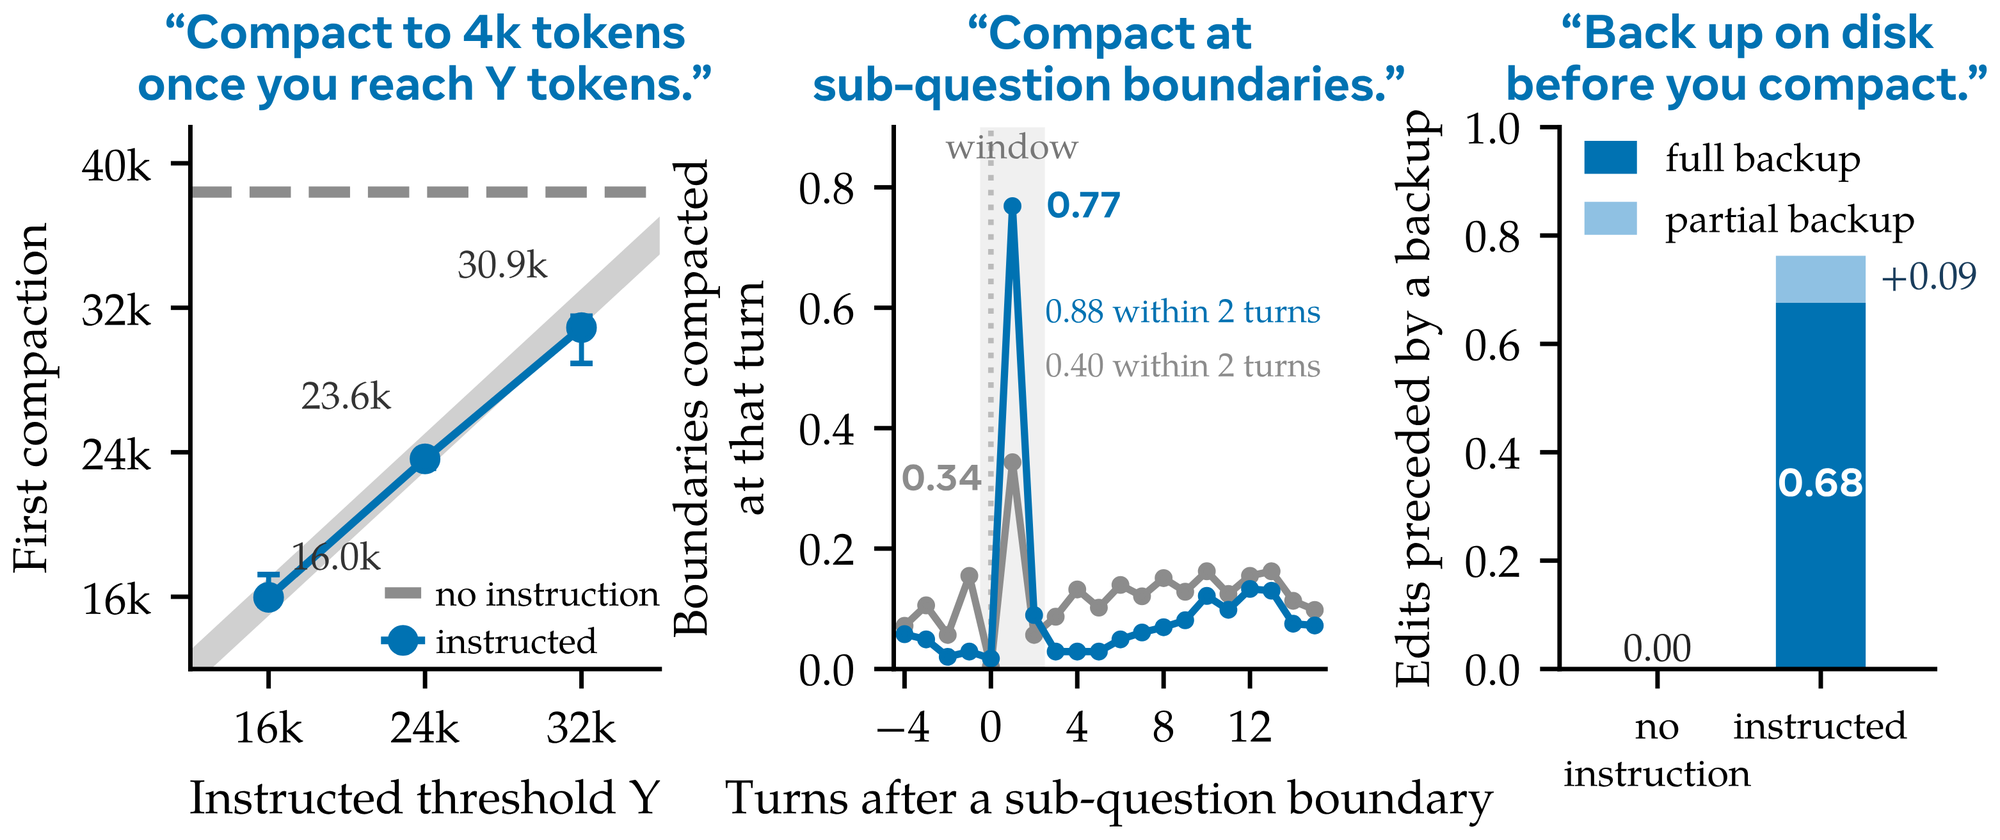
Claude 4.6 Sonnet + BrowseComp-Plus에서 과제 프롬프트 뒤에 딱 한 문장을 붙였다.
- "컨텍스트가 Y 토큰을 넘으면 즉시 약 4000 토큰으로 압축하라" → 첫 압축 시점의 중앙값이 Y=16K/24K/32K에서 각각 16.0K / 23.6K / 30.9K. 지시가 없으면 예산 끝(~38K)까지 간다.
- "서브태스크 경계에서만 압축하라" → 질문 경계 2턴 이내 압축률 0.40 → 0.88.
- "편집 전에 반드시 백업하라" → 전체 백업이 선행된 편집 비율 0.00 → 0.68 (부분 백업 +0.09).
하네스도, 가중치도 손대지 않았다. 기존 방식이라면 "압축 임계값"은 하네스의 설정값이었을 것이다.
스킬 문서를 진화시키기
지시문 를 최적화 변수로 보면, 궤적 보상 를 최대화하는 스킬 문서를 찾는 문제가 된다.
GEPA 스타일의 프롬프트 진화 루프를 돌린다. 매 라운드마다 학습 분할에서 롤아웃을 만들고, proposer 모델이 그 트레이스를 읽고 스킬 후보를 제안하고, 개발 분할에서 평가해 다음 라운드 스킬을 고른다. proposer가 더 강한 외부 모델이면 assisted evolution, 에이전트 자신이면 self-evolution 이다.
ContextBench(32K)에서 assisted evolution(에이전트 Qwen3.6-27B, proposer Claude Fable 5.1)은 아무 지시 없이 시작해 개발 분할 정확도를 Sudoku 45.3→65.8%, KV Store 22.3→83.8%, Log Triage 0.0→100.0% 로 끌어올렸다. 홀드아웃 테스트에서도 KV Store가 38.3→74.2%로 +35.9 포인트, 그것도 더 낮은 비용에서다. Self-evolution(Opus 5)은 이미 94~100%에서 출발하므로 주로 같은 정확도에서 비용을 줄이는 쪽으로 진화했다.
🧠 가중치에 학습시키기: success-gated efficiency advantage
인-컨텍스트 학습이 가능하면 RL도 가능하다. 다만 두 가지 기술적 문제가 있다.
첫째, 컨텍스트 편집은 궤적의 append-only 구조를 깬다. 최종 컨텍스트에는 초반 행동이 생성될 때의 입력이 남아 있지 않을 수 있다. 그래서 stepwise GRPO 를 쓴다. 프롬프트마다 완전한 궤적 그룹을 샘플링해 궤적 수준 결과 보상으로 표준 GRPO advantage를 계산하고, 그 값을 궤적을 구성하는 모든 세그먼트(모델 호출)에 똑같이 배정한다. 각 세그먼트는 자기 원래 입력 아래에서 학습된다.
둘째, 결과 보상만으로는 편집을 가르치기 약하다. 성공한 궤적에도 비효율적 편집이, 실패한 궤적에도 유용한 편집이 섞여 있다. 그렇다고 편집 횟수나 지운 양에 보상을 주면 중요한 정보를 버리거나 프리픽스 재사용을 망치는 쪽으로 reward hacking 이 생긴다. 해법이 success-gated efficiency advantage 다. 그룹 의 성공 궤적 집합 의 평균 prefix-reuse FLOPs를 라 하면
즉 성공한 궤적끼리만 비용으로 재정렬하고, 실패 궤적엔 효율 보너스를 주지 않는다(성공 궤적이 2개 미만이면 전부 0). 최종 advantage는 이고 실험에서는 를 컨텍스트 관리 토큰에 적용했다. 효율의 척도가 "길이"가 아니라 프리픽스 캐싱을 반영한 FLOPs 라는 점이 기존 success-conditioned 효율 보상(Arora & Zanette, DDCA)과 다른 부분이다.
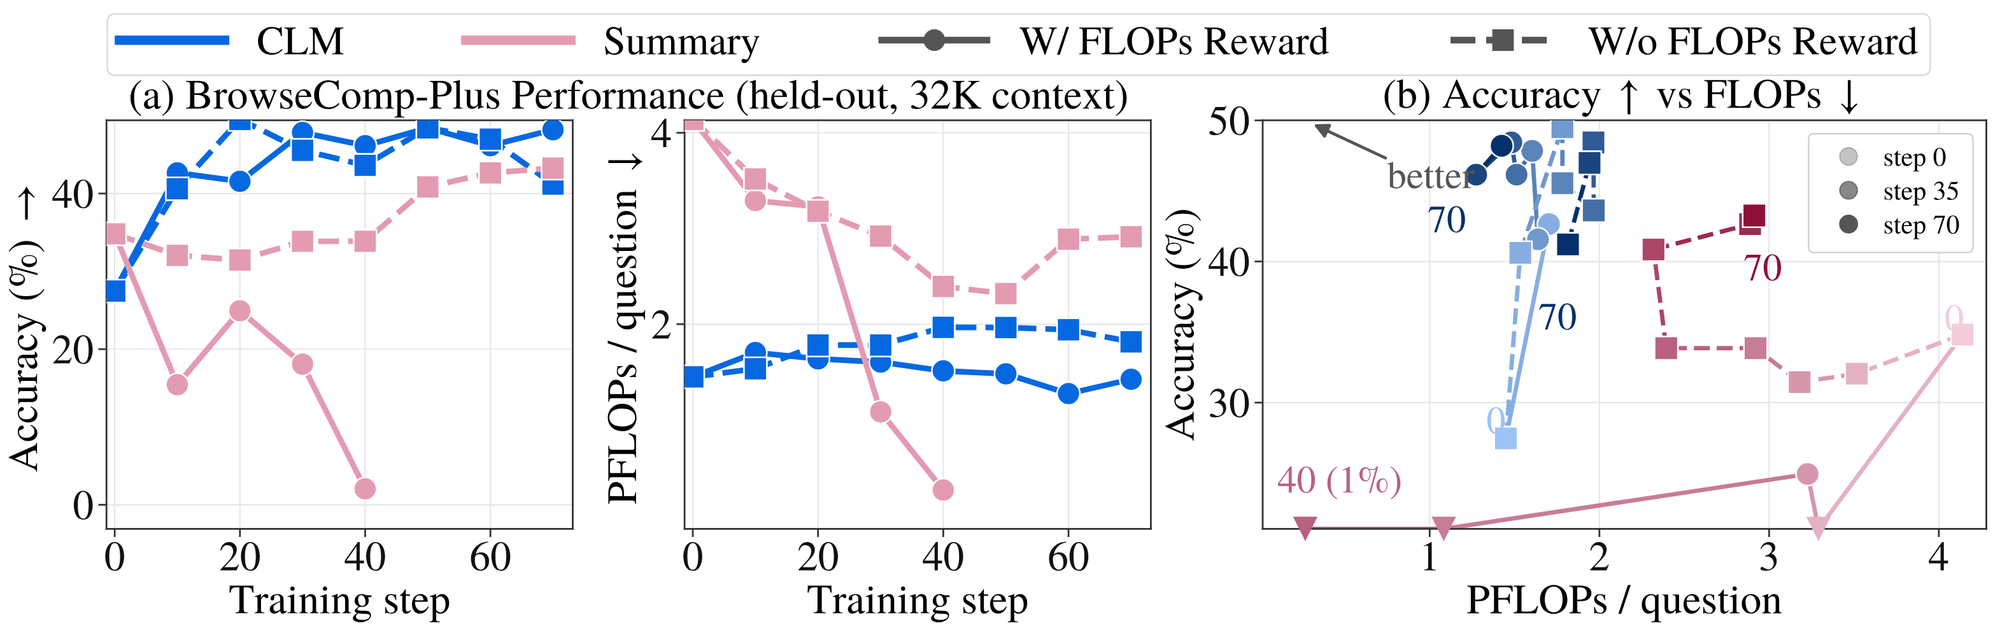
Qwen3.5-9B를 OpenResearcher 3,040개 프롬프트로 70 step 학습(step당 8 프롬프트 × 32 롤아웃, H200 64장)하고 BrowseComp-Plus 830문항에서 평가했다.
| 방법 | 정확도 (%) | PFLOPs / 질문 |
|---|---|---|
| Summary 하네스 | 34.7 → 42.1 | 4.01 → 2.19 |
| CLM | 28.8 → 42.5 | 1.52 → 1.34 |
학습 전에는 작은 모델의 컨텍스트 관리 능력이 부족해 CLM이 Summary보다 6포인트 낮았다. RL 후 13.7포인트(+47.6%) 올라 42.5% 로 같은 레시피로 학습한 Summary 하네스를 0.4포인트 앞서면서 FLOPs는 38.8% 적다. 그림 (a)에서 눈에 띄는 건 FLOPs 보상을 준 Summary 하네스가 step 40에서 정확도 2%로 붕괴한 것인데, 하네스 설정에 묶인 방식에서는 효율 신호가 쉽게 역효과를 내는 반면 CLM은 안정적으로 정확도와 효율을 동시에 개선했다.
⚙️ 서빙 공동 설계: Suffix Cache Reuse
프리픽스 캐시가 깨지는 비용을 다 포함하고도 CLM이 싸다는 건 확인했다. 그럼 그 비용을 아예 줄이면 어떨까?
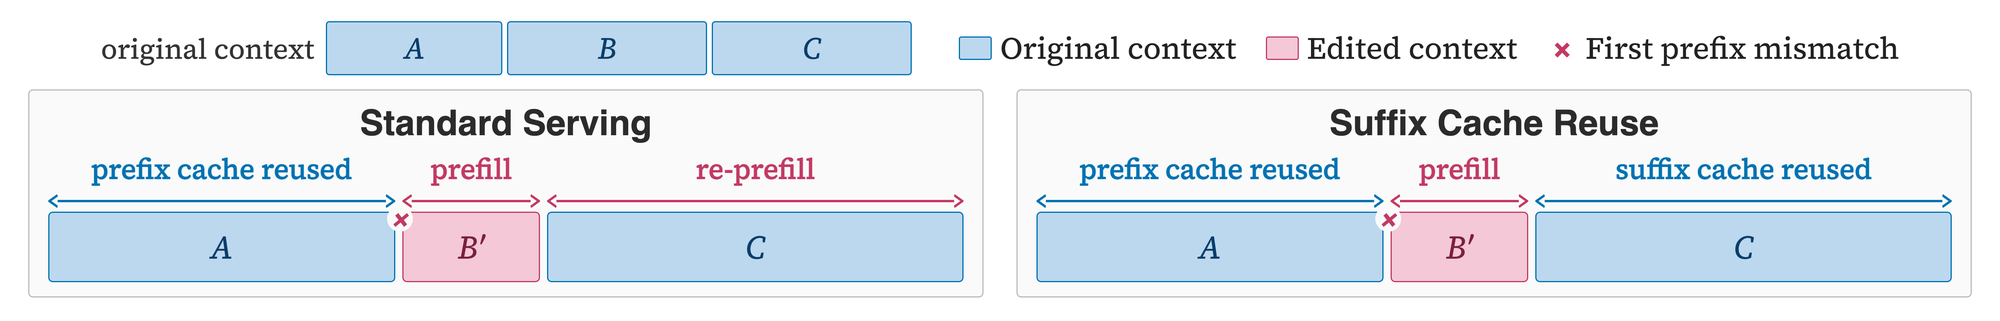
Suffix Cache Reuse (SCR) 는 편집 후 살아남은 토큰 의 캐시 상태를 그대로 재사용하고, 새로 삽입된 만 prefill한다. 의 KV 상태는 옛 프리픽스를 인코딩한 stale한 상태지만, 저자들은 이게 오히려 과거 정보를 더 풍부하게 담고 있어 경우에 따라 이득이라고 본다. Memento가 요약의 캐시 상태에 퇴출된 블록 정보가 남아 있음을 관찰한 것, PIE가 코드 편집 후 변하지 않은 suffix 캐시를 보존한 것과 같은 원리를 에이전트의 라이브 컨텍스트에 적용한 셈이다.
SGLang의 radix tree 프리픽스 캐시 위에 구현했고, Qwen3.6-27B처럼 full attention 16층 + Gated DeltaNet 48층이 섞인 하이브리드 모델(선형 어텐션은 토큰별 KV 대신 고정 크기 recurrent state를 가지므로 체크포인트 노드에서만 재개 가능)까지 확장했다. 결과는 BrowseComp-Plus에서 표준 SGLang 대비 65.0%의 FLOPs로 같은 정확도, 즉 서버 측 연산 35% 절감이다. 덤으로 SCR은 CLM 전용이 아니다. 채팅 엔드포인트가 이전 턴의 reasoning 토큰을 떼어낼 때 뒤의 토큰들이 모두 re-prefill되는 일반적인 낭비도 같은 메커니즘으로 줄인다.
이 블로그의 KV Cache 완전 정복 글에서 다룬 Prefix Caching의 "첫 불일치 이후는 전부 재계산"이라는 한계를 정확히 겨냥한 설계이고, Titans·Engram 글의 메모리 모듈이 가중치/아키텍처 안에 기억을 두는 접근이라면 CLM은 컨텍스트라는 텍스트 자체를 모델이 읽고 쓰는 메모리로 만드는 반대편 접근이라고 볼 수 있다.
🧭 정리, 한계, 열린 질문
정리하면
- 컨텍스트 관리를 하네스에서 모델로 옮기는 것만으로(zero-shot) 요약·압축·메모리 툴 기반 전략을 정확도와 비용 모두에서 앞섰다. 비용은 캐시 깨짐까지 포함한 prefix-reuse FLOPs 기준이다.
- 관리가 "행동"이 되자 자연어 한 문장으로 조종되고, 스킬 문서로 진화하고, success-gated efficiency advantage로 RL 학습이 가능해졌다.
- SCR로 서빙 측 비용도 35% 더 줄였다.
한계와 주의점
- 안전성: 모델이 자기 컨텍스트에 쓸 수 있다는 건 프롬프트 인젝션이나 스스로 만든 지시가 턴을 넘어 지속되는 새 채널이 생긴다는 뜻이다. 저자들도 요약에 무단 지시를 끼워 넣은 사례(OpenAI 2026b)를 들며 새 공격 표면에 대한 연구가 필요하다고 명시한다.
- 모델 의존성: 이득이 모델의 판단 능력에 비례한다. 9B 모델은 절반의 과제에서 아예 편집하지 않았다.
- 컨텍스트 길이 인식: Appendix G의 진단에 따르면 기존 LM들은 긴 컨텍스트에서 자기 토큰 수를 잘 추정하지 못하고 6.2K, 9.8K 같은 특정 값으로 뭉쳐 답한다(Claude 4.6 Sonnet은 과소 추정, GPT-5.4가 가장 정확). 지금은 툴 결과마다 현재 크기를 알려주는 환경 힌트에 기대고 있다.
- Software World, EdgeBench의 비교 대상은 주로 Codex 스타일 Summary 하나이고, 수학 최적화는 Claude 4.6 Sonnet 한 모델로만 평가됐다.
열린 질문은 논문 말미의 방향과 겹친다. RL을 더 크게 스케일했을 때 어떤 전략이 창발하는지, 그리고 기존 하네스의 압축·오프로딩 절차를 CLM 행동으로 번역해 가중치에 증류(harness-to-CLM) 할 수 있는지. 저자들의 표현을 빌리면 하네스는 "외부에서 개발된 절차적 기억"이고, 결국 모델이 흡수해야 할 대상이다. 코드는 github.com/facebookresearch/context-language-models 에 공개되어 있다.
📚 참고
- 원문: Context Language Models (Shao et al., arXiv 2609.37725, 2026.09) · HTML · Hugging Face Papers
- 코드: facebookresearch/context-language-models
- GEPA: Reflective prompt evolution can outperform reinforcement learning (Agrawal et al., ICLR 2026)
- Recursive Language Models (Zhang et al., 2025)
- SGLang: radix tree 기반 prefix caching (Zheng et al., 2024)
- BrowseComp-Plus (Chen et al., 2025), TerminalBench 2.1 (Merrill et al., 2026), EdgeBench (Zhu et al., 2026)
- 블로그 관련 글: KV Cache 완전 정복, Titans, Engram, Dust
본 글의 그림은 원문에서 가져왔습니다.