SparLeak: 공유 GPU에서 Sparse Attention이 사이드채널이 되는 이유
"어떤 토큰을 건너뛸지 모델이 '입력을 보고' 정하는 순간, 그 선택 자체가 비밀을 흘린다."
2026년 9월 말 arXiv에 올라온 SparLeak: Privacy Leakage from Sparse Attention in LLM Inference on Shared GPUs(Fahao Chen, Linkang Du, Jinhao Zhou, Peng Li, Zhou Su — 산둥대, 시안교통대, 와세다대)는 LLM 서빙 최적화와 보안의 교차점에 있는 논문이다. 요지는 간단하다. sparse attention은 중요한 토큰의 KV만 골라 읽는데, "무엇을 읽었는가"는 입력에 따라 달라지고, 그 읽기 흔적이 GPU의 공유 캐시와 TLB에 남는다. 같은 물리 GPU를 쓰는 다른 프로세스가 그 흔적을 측정하면, 사용자 쿼리의 속성(질병명, 나이대 등)과 LLM이 생성한 응답 토큰까지 꽤 높은 정확도로 복원할 수 있다는 것이다.
이 글은 공격 기법을 재현하기 위한 글이 아니라, 왜 이런 누출이 생기는지와 무엇을 조심해야 하는지를 이해하기 위한 리뷰다. 공격 세부 구현은 논문이 설명하는 수준에서만 다룬다.
원문: https://arxiv.org/abs/2609.38830
🤔 배경: sparse attention과 페이지 단위 KV 접근
긴 컨텍스트 추론에서 attention 비용은 시퀀스 길이에 제곱으로 늘어난다. 그래서 요즘 서빙 시스템(vLLM, SGLang 등)은 sparse attention을 적극 도입한다. 모든 프롬프트 토큰을 다 보는 대신, 현재 쿼리/출력 토큰과 관련이 높은 일부 토큰만 골라 attention을 계산하는 방식이다. 논문은 토큰 선택 방식을 세 부류로 나눈다.
- Activation 기반 saliency — 활성값이나 residual norm으로 중요 토큰을 추정
- Block 단위 scoring — 블록/페이지 단위로 근사 attention 점수를 매겨 높은 블록의 토큰만 유지
- 학습된 predictor — 가벼운 모델이 중요 토큰을 직접 예측
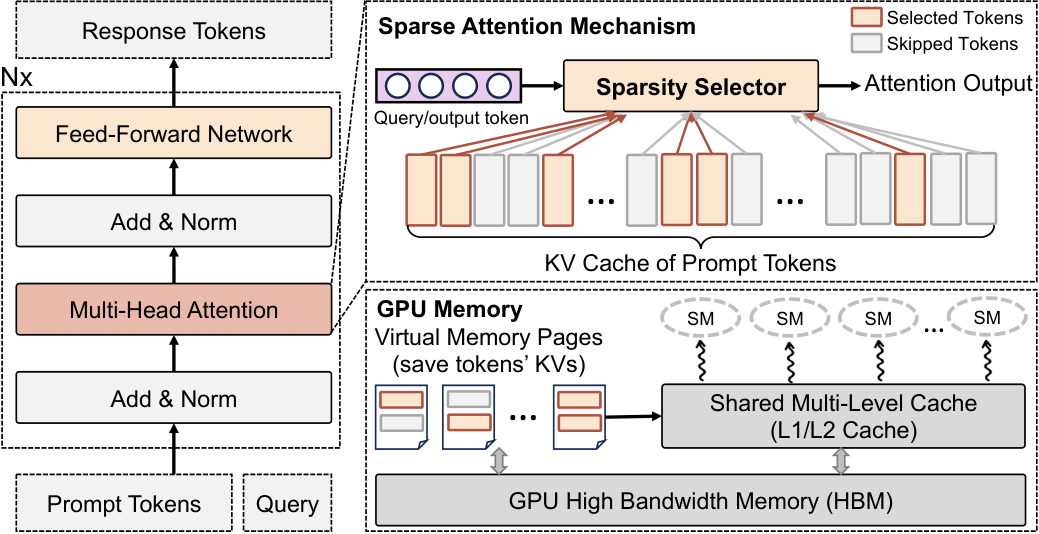
그림 1이 핵심 메커니즘이다. 선택된 토큰의 KV는 HBM에서 공유 캐시 계층(L1/L2)을 거쳐 SM으로 올라가고, 선택되지 않은 토큰은 페이지 접근 자체가 일어나지 않는다. 여기서 GPU 가상 메모리가 중요해진다. 현대 NVIDIA GPU는 64KB2MB 크기의 고정 페이지로 메모리를 관리하는데, 토큰 하나의 KV는 레이어당 보통 1030KB다. 즉 한 페이지에 여러 토큰의 KV가 같이 들어 있고, sparse attention의 토큰 선택은 결국 "어떤 페이지를 읽느냐"라는 페이지 단위 접근 패턴으로 하드웨어에 드러난다.
이 블로그에서 다룬 PagedAttention(vLLM), RadixAttention(SGLang), KV Cache 최적화 글이 모두 "KV를 페이지/블록 단위로 쪼개 효율적으로 관리하는" 이야기였다면, SparLeak은 그 페이지 단위 관리가 sparse attention과 결합할 때 생기는 보안적 부작용을 짚는 논문이라고 볼 수 있다.
🧠 핵심 관찰: SIMA — Sparsity-Induced Memory Access
논문은 이 현상을 SIMA(Sparsity-Induced Memory Access) 라고 이름 붙인다. 정리하면 이렇다.
- Dense attention은 모든 토큰의 KV를 균일하게 읽는다. 입력이 바뀌어도 접근 패턴은 같다.
- Sparse attention은 입력(쿼리, 그리고 지금까지 생성된 토큰)에 따라 다른 토큰을 고른다. 접근 패턴이 비밀에 의존한다.
- 그 접근은 GPU 내부에서 일어나 API로는 안 보이지만, 공유 L2 캐시와 TLB에 경합(contention) 을 일으킨다. 같은 GPU의 다른 프로세스는 자기 메모리 접근의 지연시간 변화로 이를 간접 관측할 수 있다.
저자들은 기존 LLM 사이드채널 연구(응답 시간, TTFT, 네트워크 패킷 길이, CPU 캐시의 임베딩 테이블 접근 등)와 비교해, SIMA가 모델 내재적(model-intrinsic) 이고 prefill과 decoding 두 단계 모두에 걸쳐 있으며, 아직 보고된 완화책이 없다는 점을 차별점으로 든다.
두 단계, 두 가지 흔적
LLM 추론은 prefill(프롬프트 전체를 병렬 처리)과 decoding(토큰을 하나씩 생성)으로 나뉜다. 두 단계에서 SIMA의 모양이 다르다.
- Prefill: 모든 쿼리 토큰이 동시에 프롬프트 토큰을 선택하므로, 페이지별 누적 접근 빈도 형태의 흔적이 남는다. 활성화는 심하게 편향되어 소수 토큰이 반복 선택되고, 레이어/헤드마다 보는 곳이 다르다.
- Decoding: 스텝마다 소수 토큰만 선택되므로, 페이지별 이진 접근 여부 , 가 스텝 마다 갱신된다.
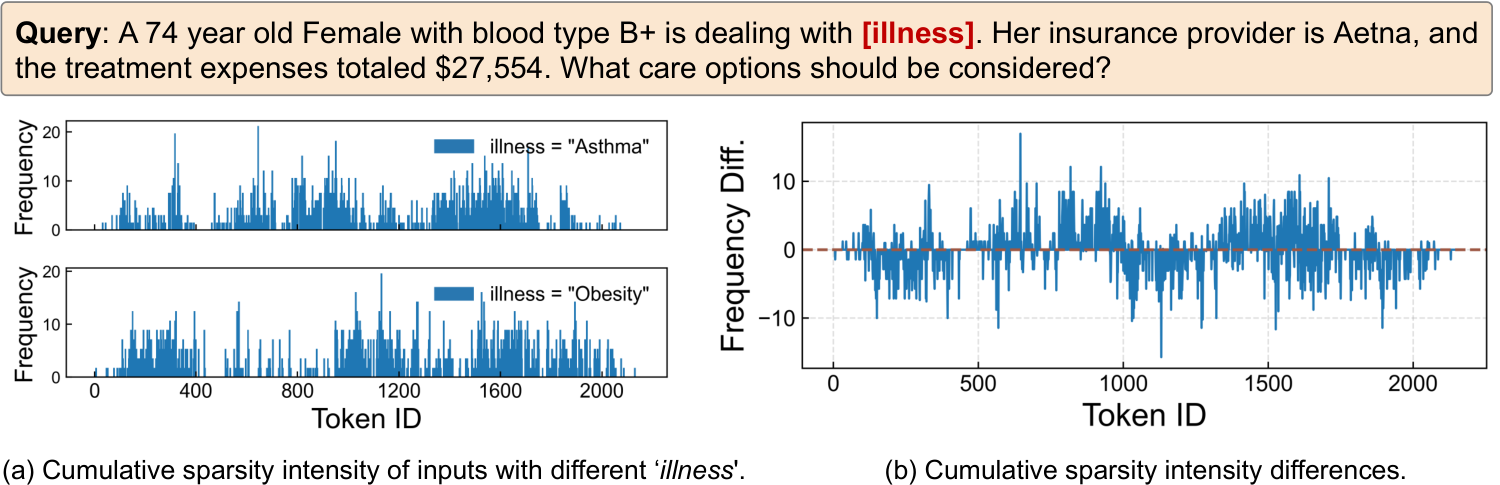
그림 3이 "왜 이것이 프라이버시 문제인가"를 보여준다. 동일한 시스템 프롬프트(헬스케어 데이터셋 기반, 약 2K 토큰)에 질병 항목 하나만 Asthma에서 Obesity로 바꿨는데, 프롬프트 어디를 반복해서 보는지가 눈에 띄게 달라진다. 반대로 decoding에서는 생성 토큰이 "his"냐 "health"냐에 따라, 심지어 "health"와 "healthy"처럼 비슷한 토큰끼리도 구분 가능한 패턴이 나온다고 한다. 선택이 현재 토큰뿐 아니라 지금까지의 생성 문맥에도 조건화되기 때문이다.
🔍 위협 모델: 같은 GPU에 올라탄 테넌트
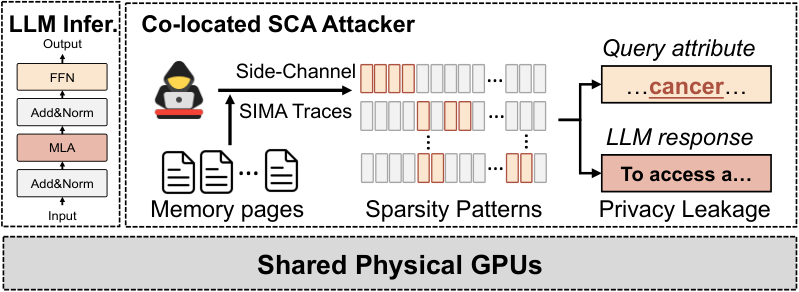
논문이 가정하는 상황은 다음과 같다.
- 피해자: 고정된 공개 시스템 프롬프트 템플릿(RAG/에이전트 앱에서 흔한 형태, 보통 prefix caching과 함께 쓰임) 위에 사용자 쿼리를 붙여 sparse attention으로 추론하는 서비스. 사용자 쿼리와 응답은 비공개.
- 공격자: 같은 물리 GPU에서 돌아가는 비특권 프로세스. 사용자 수준 CUDA 접근만 있으면 되고, 특권 카운터·드라이버 수정·피해자 메모리 접근은 필요 없다. 자기 프로브의 지연시간만 측정한다. 로컬 사용자가 공유 GPU에 CUDA 작업을 올리거나, 파티션되지 않은 GPU에 다른 테넌트의 작업이 함께 스케줄되는 경우가 해당한다.
- 공격자가 못 하는 것: GPU 스케줄링이나 실행 타이밍 제어. 피해자 KV 내용이나 정확한 주소를 읽는 것.
중요한 전제는 고정 템플릿 + 고정 모델/런타임 설정이다. 서비스가 장기 실행 모델 프로세스로 프롬프트 쪽 KV 페이지를 요청 간에 재사용하기 때문에, 공격자가 오프라인에서 "어떤 프로브가 어떤 페이지와 경합하는가"를 보정해 두면 이를 반복 사용할 수 있다는 논리다. prefix caching이 성능엔 좋지만, 여기선 페이지 배치를 안정화시켜 공격자에게도 유리하게 작용하는 셈이다.
📐 공격 파이프라인: 세 단계
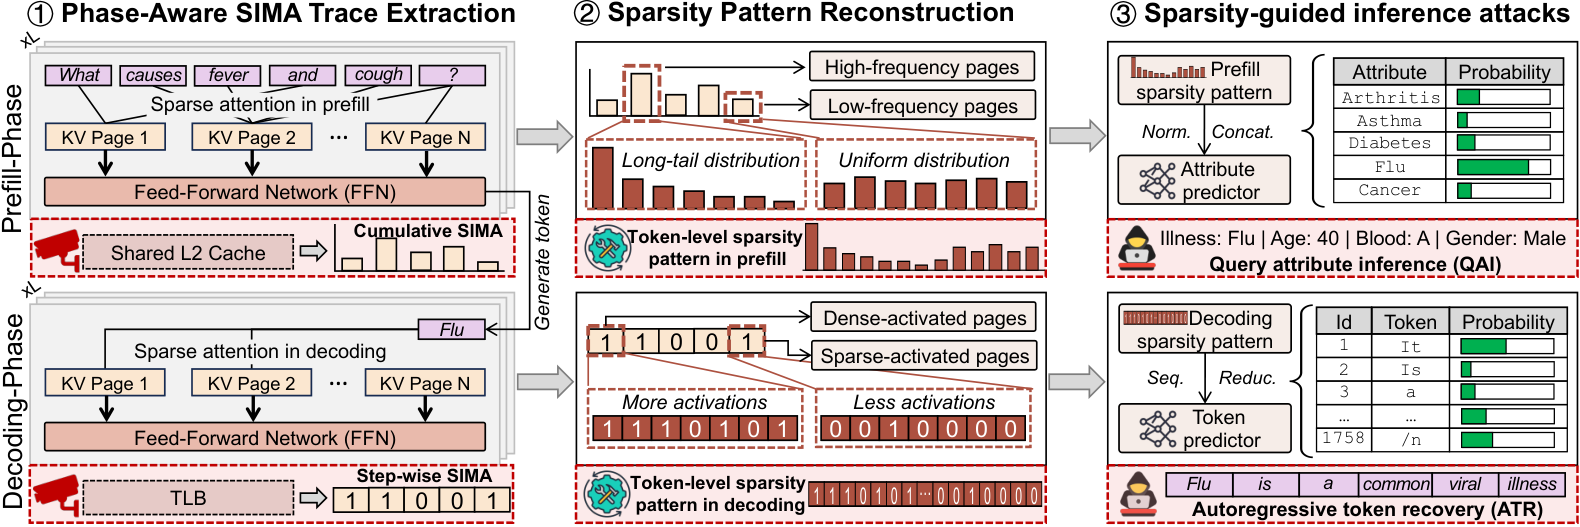
1단계 — 단계 인식 SIMA 추출
공격자는 먼저 피해자가 prefill 중인지 decoding 중인지 구분한다. prefill은 짧고 밀도 높은 GEMM 커널 폭발, decoding은 토큰마다 반복되는 준주기적 패턴이라 커널 시간 밀도 같은 프록시나 캐시/TLB 흔적의 주기성만으로도 경계를 찾을 수 있다고 한다.
- Prefill은 공유 L2 캐시 경합을 이용한다. 프롬프트 KV 페이지가 자주 읽힐수록 공격자가 미리 올려 둔 프로브 캐시 라인이 더 많이 쫓겨나므로(eviction footprint), 이를 누적하면 페이지별 상대적 접근 빈도 가 나온다. 논문은 이를 Invalidate+Compare 프리미티브라고 부른다.
- Decoding은 GPU TLB 경합을 이용한다. 피해자 페이지 와 같은 TLB 세트에 충돌하는 자기 페이지 를 골라 두고, 한 decoding 스텝 길이에 맞춘 윈도 마다 의 주소 변환 지연을 재측정한다. 지연이 임계값을 넘으면 . 스텝 정렬이 어긋나는 문제는 인접 윈도 다수결로 보정한다(Evict+Reload).
두 프리미티브 모두 선행 GPU 사이드채널 연구의 기법을 가져온 것이고, 이 논문의 기여는 그것을 sparse attention의 두 단계에 맞게 조합한 데 있다.
2단계 — 페이지에서 토큰으로 재구성
페이지 하나에 토큰 여러 개가 들어 있으니 관측은 거칠다. 저자들은 정확 복원 대신 통계적 규칙성을 이용한다.
- Prefill: 누적 빈도가 높은 페이지일수록 내부 토큰 활성이 소수 토큰에 쏠린 long-tail 분포이고, 낮은 페이지는 평평한 분포라는 상관을 관측했다(논문 그림 10, 10토큰/페이지 기준 27번째 vs 156번째 페이지 예시). 페이지 빈도를 "얼마나 쏠리게 만들지"의 제어 신호로 써서 토큰 수준 프로파일을 생성한다.
- Decoding: 주변 페이지가 밀집 활성된 영역은 페이지 안에도 여러 토큰이 활성, 드문 영역은 소수 토큰만 활성이라는 공간 지역성을 이용한다.
3단계 — sparsity 패턴 기반 추론
재구성된 토큰 수준 프로파일을 모든 레이어/헤드에 걸쳐 이어 붙여 가벼운 MLP 분류기에 넣는다.
- QAI(Query Attribute Inference): 쿼리 길이 등 전역 스케일을 정규화한 뒤 질병·나이·혈액형 같은 속성을 분류.
- ATR(Autoregressive Token Recovery): 스텝별 프로파일에 이전 스텝 정보를 누적한 피처를 더해 토큰 분류. 전체 어휘가 아니라 오프라인 프로파일링 코퍼스에서 만든 과제별 후보 토큰 집합 안에서 예측한다.
분류기는 공격자가 자기 쿼리로 오프라인 프로파일링해 학습한다. 모델 체크포인트와 sparse attention 구성이 공개라면 복제본으로 ground-truth 패턴을 모으고, 공개가 아니라면 선택 쿼리를 실제 서비스에 던지면서 같은 GPU에서 흔적을 수집하는 "target-interactive profiling"을 쓴다.
📊 실험 결과
설정: LongChat-7B, LLaMA3-8B, Qwen3-8B × 세 종류 sparse attention(Activation, Block, Learning) × 세 데이터셋(Healthcare, Financial QA, Legal QA). NVIDIA L20(48GB), CUDA 11.8, PyTorch 2.6.0. 지표는 prefill 공격 성공률 PASR(속성 예측 정확도)과 decoding 공격 성공률 DASR(응답당 올바르게 복원된 토큰 비율의 평균).
결과는 네 가지 조건으로 나눠 보고한다. O(T)는 토큰 수준 ground-truth를 그대로 쓴 oracle, O(P+R)은 oracle 페이지 패턴을 재구성한 것, R(P)는 실제 측정한 페이지 수준 흔적을 재구성 없이 쓴 것, R(P+R)이 실제 end-to-end 공격이다.
| 항목 | 수치 |
|---|---|
| 평균 PASR (end-to-end) | 모든 데이터셋에서 91% 초과, 초록 기준 평균 90.9% |
| 평균 DASR (end-to-end) | 84.6%~89.4%, 모든 설정에서 80% 초과, 초록 기준 평균 87.3% |
| 토큰 수준 oracle 대비 손실 | 약 2.5%p |
| 속성별 PASR | Gender(Healthcare) 약 97.9%, Entity(Financial QA) 약 87.3% |
| sparse attention 종류별 PASR | Activation 약 86.4% < Block < Learned predictor 약 95.5% |
| 모델별 평균 PASR | LongChat-7B 90.6%, LLaMA3-8B 89.4%, Qwen3-8B 92.7% |
Table 2의 LLaMA3-8B 질병(60클래스) 예를 보면 흐름이 선명하다. Activation 기준 O(T) 86.9 → O(P+R) 84.5 → R(P) 67.1 → R(P+R) 84.1. 재구성 없이 실제 페이지 흔적만 쓰면 60~70%대로 떨어지지만, 재구성을 붙이면 oracle에 거의 근접한다.
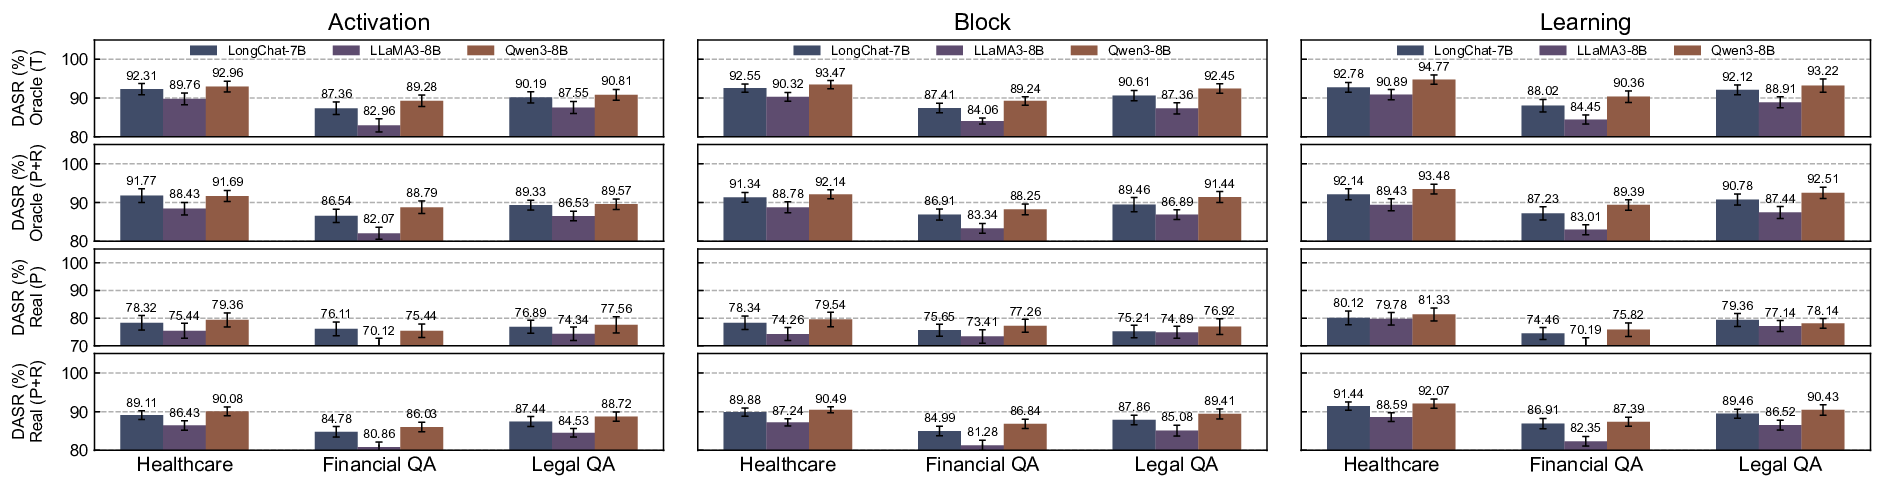
그림 5의 DASR도 같은 구조다. Financial QA가 일관되게 낮은 건 금융 응답의 어휘 다양성과 구조 복잡성 때문이라고 저자들은 해석한다. Learned predictor가 가장 잘 뚫리는 것은 직관적으로도 말이 된다. sparsity 추정이 정확할수록 "어떤 토큰이 중요한가"가 더 선명하게 메모리 접근에 새겨진다.
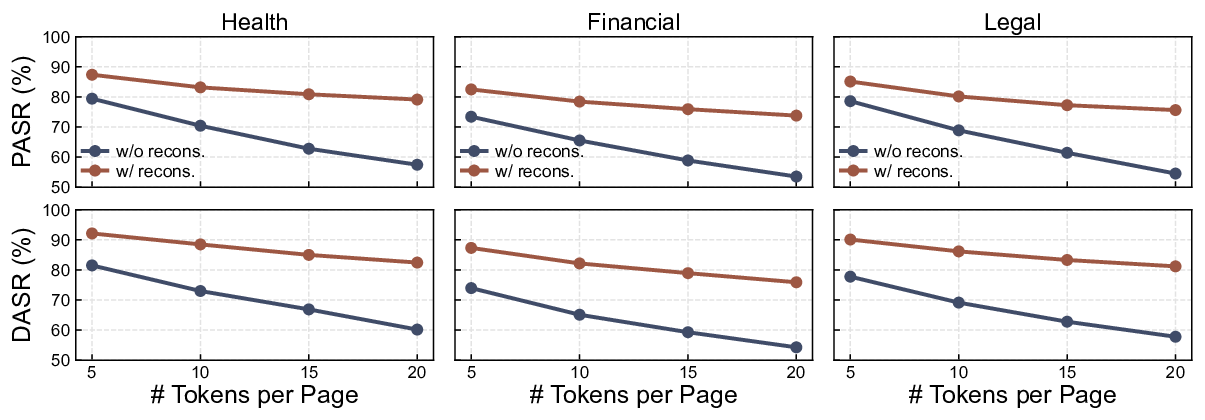
그림 6은 페이지 크기 ablation이다. 페이지가 커질수록(토큰이 더 많이 묶일수록) 정보가 뭉개져 재구성 없는 공격은 급격히 약해진다. Healthcare PASR은 20토큰/페이지에서 57.45%까지 떨어진다. 반면 재구성을 적용하면 완만하게만 감소한다. 뒤집어 보면 페이지 크기를 키우는 것만으로는 방어가 되지 않는다는 뜻이기도 하다.
실용성 수치
- 오프라인 프로파일링 비용: QAI는 모델당 5,000 쿼리, 약 0.8
1.1시간. ATR은 응답 길이에 비례해 2,0003,000 샘플에 12.7~19.5시간. 분류기 학습 비용은 무시할 수준이며 동일 설정에서 재사용 가능. - 모델/sparsity 설정 비공개 시(target-interactive profiling): 평균 PASR 90.97%, DASR 86.65%로 최대 1.28/1.54%p만 하락.
- 은닉성: 스파이 프로세스가 피해자 추론 지연을 prefill 1
3%, decoding 46%, 최악 8% 미만만 늘린다. 서빙 환경의 일상적 지연 변동에 묻히는 수준이다.
🛡️ 방어: 무엇이 되고 무엇이 안 되나
논문이 직접 실험한 완화책은 하나다. 중요도 기준으로 선택된 토큰의 A%를 입력과 무관한 랜덤 토큰으로 교체해 sparsity 패턴의 안정성을 깨는 방식이다(Financial QA 기준).
| 모델 | Baseline ASR / ROUGE | 10% | 20% | 30% |
|---|---|---|---|---|
| LongChat-7B | 89.45 / 0.43 | 85.41 / 0.38 | 82.09 / 0.32 | 76.17 / 0.21 |
| LLaMA3-8B | 90.12 / 0.48 | 84.92 / 0.35 | 79.85 / 0.24 | 72.68 / 0.16 |
| Qwen3-8B | 91.23 / 0.42 | 87.28 / 0.37 | 81.13 / 0.35 | 75.98 / 0.26 |
(ASR은 PASR과 DASR의 평균)
결과가 썩 반갑지 않다. 30% 교체해도 ASR은 70%대에 머무는데, LLaMA3-8B의 ROUGE는 0.48에서 0.16으로 무너진다. 누출은 조금 줄고 품질은 크게 깎이는 트레이드오프다. 랜덤성이 "어디를 안 보는가"까지 숨겨 주지는 못하기 때문으로 보인다.
그 외에 논문이 정성적으로 언급하는 방향은 다음과 같다.
- 고해상도 타이머, 모니터링 인터페이스(예: 비특권 Nsight 접근), 메모리 관리 프리미티브 제한 → 흔적 해상도를 낮추지만 비밀 의존 접근 자체는 남는다.
- 고정/페이지 패딩된 접근 스케줄, 더미 KV 접근 → 입력 의존성을 줄이지만 sparse attention의 효율 이점을 깎는다.
- 테넌트 격리, 캐시/TLB 파티셔닝 → 교차 테넌트 관측 자체를 막지만 런타임/하드웨어 지원이 필요하다.
- 반복 프로빙이나 비정상적 캐시/TLB 활동 탐지 → 보완책으로 가능.
운영 관점에서 가장 현실적인 메시지는 이것이다. 민감한 데이터를 다루는 sparse attention 서빙을 파티션되지 않은 공유 GPU에 올리지 말 것. 특히 공개 템플릿 + prefix caching 구성은 공격자의 오프라인 보정을 쉽게 만든다. MIG 같은 하드웨어 파티셔닝이나 전용 GPU 할당은 이 논문의 위협 모델(동일 물리 GPU, 비파티션) 자체를 무력화한다.
💡 정리와 열린 질문
SparLeak이 말하는 바를 한 줄로 줄이면, "입력에 따라 계산량을 줄이는 모든 최적화는 입력에 대한 정보를 어딘가에 흘린다" 는 오래된 보안 교훈이 LLM 서빙 스택에도 그대로 적용된다는 것이다. Sparse attention, 그리고 그것을 효율적으로 만드는 페이지 단위 KV 관리는 성능을 위한 선택이지만, 동시에 비밀 의존적 메모리 접근이라는 사이드채널 표면을 만든다.
몇 가지 유념할 점과 열린 질문:
- 위협 모델의 전제가 강하다. 고정 공개 템플릿, 고정 모델/런타임, 장기 실행 프로세스, 비파티션 공유 GPU가 모두 필요하다. 템플릿이 자주 바뀌거나 페이지 배치가 요청마다 달라지는 환경에서 보정이 얼마나 유지되는지는 논문 범위 밖이다.
- 단일 GPU(L20)에서의 평가다. 다른 GPU 세대, 다중 GPU 텐서 병렬, MIG 환경에서의 결과는 보고되지 않았다.
- ATR은 과제별 후보 토큰 집합 안에서 분류한다. 저자들은 보충 자료에서 이득이 SIMA에서 오는지 후보 집합 제한에서 오는지 검증했다고 하지만, 본문에서는 수치를 확인할 수 없었다.
- 품질을 유지하면서 누출을 줄이는 저비용 방어는 미해결 과제로 남겨 두었다. 입력 의존 선택을 유지하면서 접근 패턴만 균일화하는 방법(예: 선택 토큰과 무관하게 페이지는 항상 읽되 계산만 건너뛰기)이 효율과 어떻게 타협할 수 있을지는 흥미로운 후속 주제다.
PagedAttention과 RadixAttention 글에서 "페이지를 어떻게 잘 나누고 재사용할까"를 이야기했다면, 이제 "그 페이지를 누가 읽었는지 옆 테넌트가 알 수 있다"는 질문도 설계 체크리스트에 올려야 할 때로 보인다.
📚 참고
- Fahao Chen, Linkang Du, Jinhao Zhou, Peng Li, Zhou Su. SparLeak: Privacy Leakage from Sparse Attention in LLM Inference on Shared GPUs. arXiv:2609.38830, 2026. https://arxiv.org/abs/2609.38830 / HTML
- Kwon et al. Efficient Memory Management for Large Language Model Serving with PagedAttention. SOSP 2023. (vLLM)
- Zheng et al. SGLang: Efficient Execution of Structured Language Model Programs. 2024. (RadixAttention)
- 논문이 비교한 기존 LLM 사이드채널 연구: Time Will Tell (Zhang et al., 2024), PromptPeek (Wu et al., 2025), InputSnatch (Zheng et al., 2024), Whisper Leak (McDonald and Or, 2025), Spill The Beans (Adiletta and Sunar, 2025) 등
본 글의 그림은 원문에서 가져왔습니다.