vLLM 분해하기: Prefill/Decode 분리와 GPU 없는 프론트엔드 실습 가이드
"
vllm serve하나는 서로 아무 상관없는 세 가지 일을 한 프로세스에서 한다. 그걸 잘라내면 무엇을 얻고, 무엇을 잃는가?"
2026년 9월 29일, IBM Research의 Martin Hickey가 vLLM 공식 블로그에 "Taking vLLM Apart: A Practical Guide to Disaggregated Serving" 을 올렸다. 제목 그대로 vLLM을 "분해"하는 실습 가이드다. Prefill과 Decode를 왜 나누는지에 대한 개념은 이 블로그의 선행 글 Prefill-Decode 분리(PD Disaggregation): LLM 서빙의 새로운 표준에서 이미 다뤘으니, 이 글에서는 반복하지 않는다. 대신 "그래서 vLLM에서 실제로 어떻게 켜는가" 에 집중한다. 어떤 명령으로 띄우고, 무엇이 오가고, 어느 상황에서 이득이 있고 없는지를 원문의 측정 수치와 함께 정리한다.
원문: https://blog.vllm.ai/blog/2026-09-29-disaggregated-serving-guide
이 글의 모든 예시는 vLLM v0.30.0 이상을 전제로 한다.
🤔 한 프로세스가 하는 세 가지 일
vllm serve 를 그냥 띄우면 한 프로세스가 공통점이 거의 없는 세 종류의 일을 떠안는다.
- Prefill: 프롬프트 전체를 한 번에 읽는다. 연산 한계(compute-bound)이고 TTFT를 결정한다.
- Decode: 토큰을 하나씩 뽑는다. 가중치를 메모리에서 얼마나 빨리 읽느냐가 한계(bandwidth-bound)이고 ITL(inter-token latency)을 결정한다.
- CPU 잡일: 챗 템플릿 적용, 토크나이즈/디토크나이즈, reasoning 파싱, tool call 파싱. 전부 순수 CPU 작업인데 가속기 때문에 빌린 박스 위에서 돈다.
긴 프롬프트 하나가 들어오면 응답 중이던 수십 개 스트림이 그 prefill이 끝날 때까지 전부 끊긴다. 동시성이 올라가는 순간 보이는 그 스파이크가 바로 이것이다. 세 번째 일은 더 조용해서 놓치기 쉽지만, GPU 노드의 CPU 프로파일에 토크나이저가 잡힌다면 그것도 분리 대상이다.
🧠 vLLM이 제공하는 "자르는 지점"
vLLM에는 작업을 쪼갤 수 있는 지점이 여럿 있고, 서로 조합할 수 있다.
Prefill / Decode 분리. 두 인스턴스 사이를 오가는 건 KV 캐시다. 크기가 만만치 않다. 원문 수치로 Llama-3.1-70B BF16은 토큰당 320 KiB, 10k 토큰 프롬프트면 decode에 약 3 GB를 넘긴다. 400 Gb/s 회선에서 오버헤드 없이도 약 65 ms이고, 이 시간은 고스란히 TTFT에 얹힌다. 이걸 옮기는 게 KV connector이고 보통 RDMA 위에서 돈다. 현재 업스트림에 NIXL, LMCache, Mooncake, FlexKV, AMD MoRI-IO 등 열 개 넘는 커넥터와, 이들을 체이닝하는 MultiConnector가 있다.
프론트엔드 분리. 프론트엔드가 GPU 박스에서 완전히 빠진다. /render 가 OpenAI 요청을 토큰 ID로 바꾸고, 엔진은 token-in / token-out으로만 돌고, /derender 가 출력 토큰 ID를 content / reasoning / tool_calls 가 분리된 OpenAI 응답으로 되돌린다. 마지막 /derender 구간이 최근에야 들어와서 왕복이 완성됐다.
그 외에 멀티모달용 encoder 분리, MoE에서 attention과 FFN을 나누는 AFD 플러그인도 같은 아이디어를 모델의 다른 지점에 적용한 것이다. P/D 자체도 이제 Mamba 상태 전송을 포함해 hybrid SSM 모델까지 커버한다.
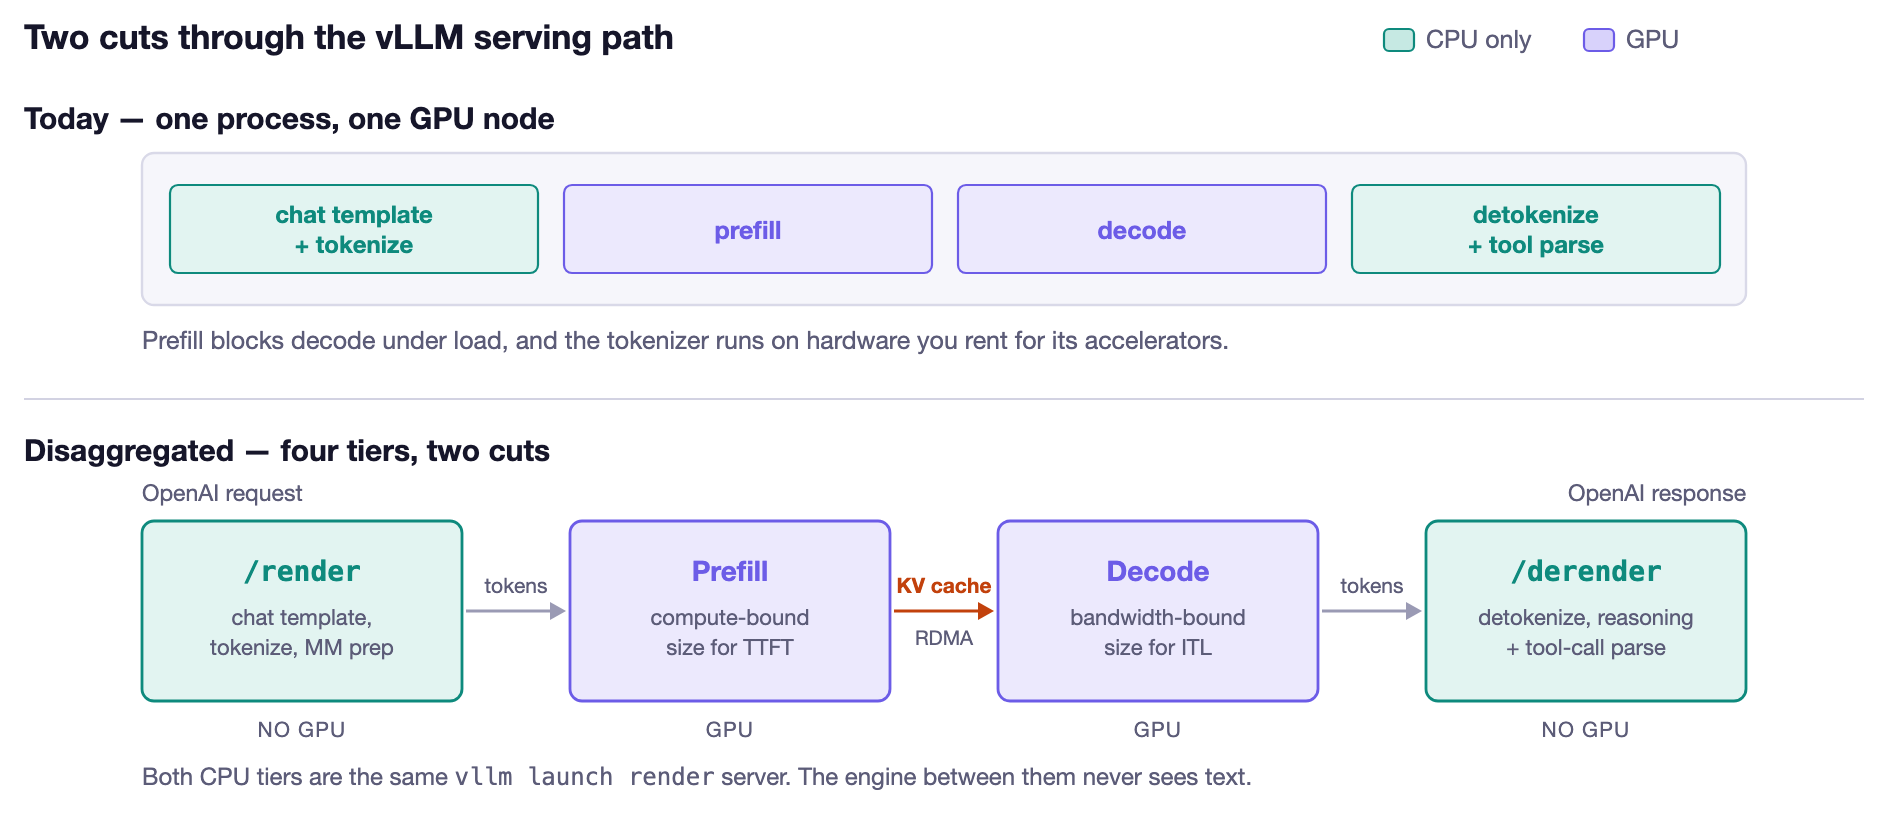
그림 1이 이 글 전체의 지도다. 위쪽은 오늘의 vllm serve, 아래쪽은 두 번 자른 결과다. 티어는 넷이지만 서버는 셋인데, /render 와 /derender 를 한 vllm launch render 서버가 같이 처리하기 때문이다. 가운데 GPU 엔진 두 개는 텍스트를 한 번도 보지 않는다.
📊 무엇을 얻고 무엇을 잃는가: 측정 수치
원문이 분명히 선을 긋는 지점이 있다. P/D의 세일즈 포인트는 최대 처리량이 아니다. 지연 목표가 없다면 같은 GPU를 prefill 풀과 decode 풀로 나눈다고 초당 토큰이 더 나오지 않는다. 얻는 건 goodput, 즉 TTFT와 ITL 목표를 둘 다 지키면서 버틸 수 있는 요청률이다. 그리고 티어별로 병렬화를 따로 잡을 수 있다(prefill은 TP 위주, decode는 배치 위주). Chunked prefill로도 어느 정도 가능하지만 청크 크기가 트래픽에 따라 달라져 계속 재튜닝해야 한다.
측정 환경은 꽤 소박하다. NVIDIA L40S 2장(48 GB, PCIe, NVLink 없음) 한 박스, Qwen2.5-7B-Instruct, 약 8k 토큰 프롬프트, 256 출력 토큰, 요청률당 Poisson 도착 100건, prefix caching 끔. Collocated는 vllm serve --data-parallel-size 2 하나, P/D는 prefiller 1 + decoder 1을 NIXL로 연결하고 예제 프록시 뒤에 둔 구성이다. 같은 GPU 두 장이다.
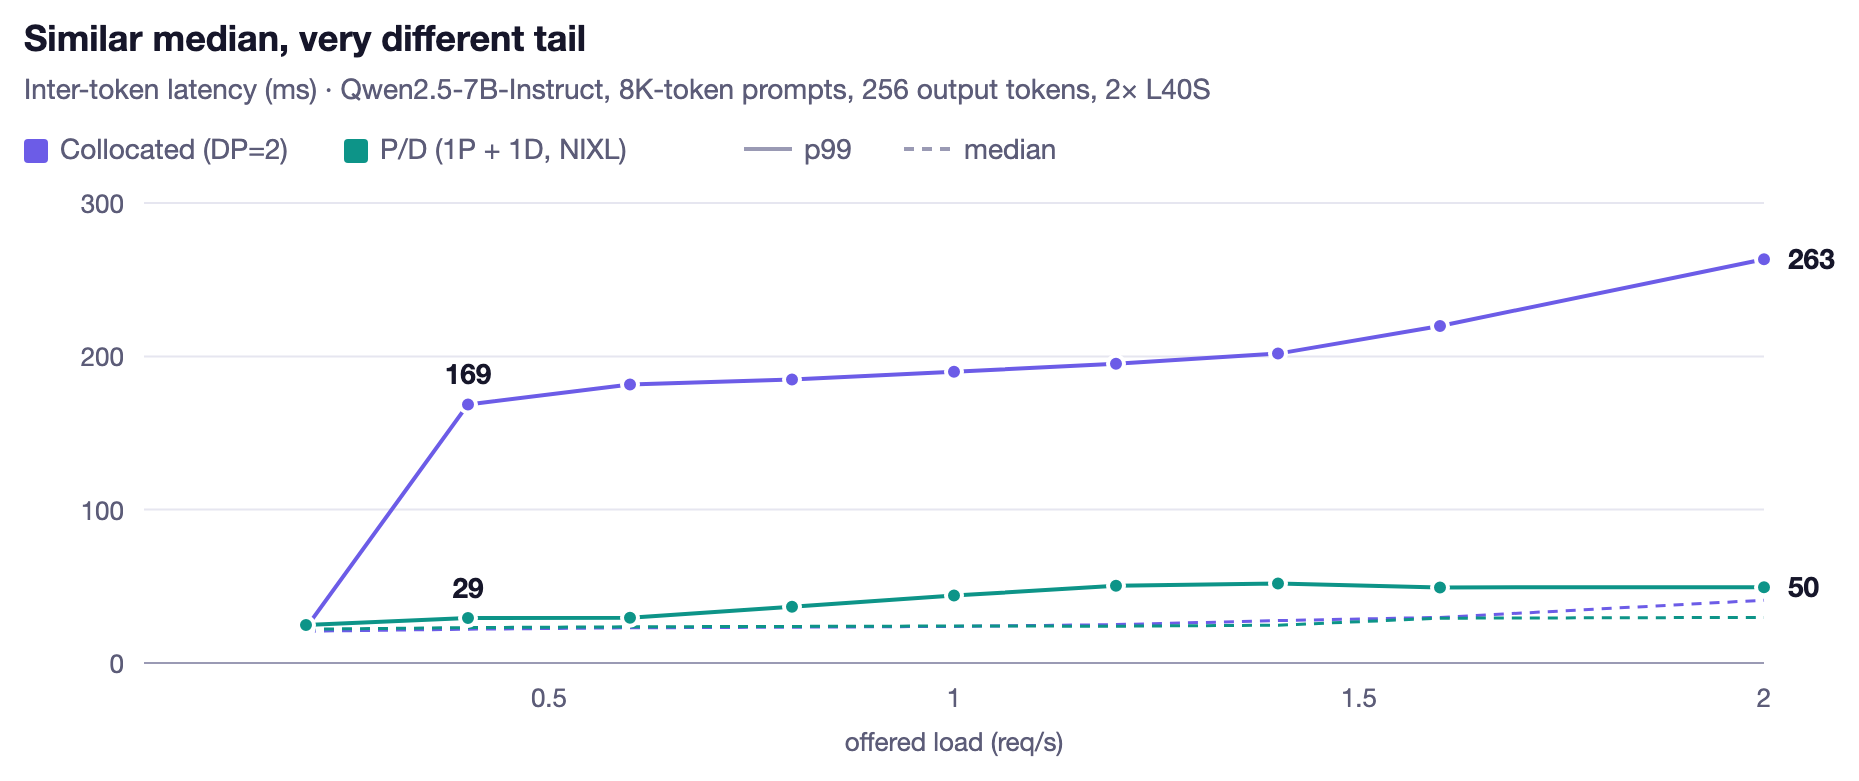
그림 2의 제목이 결론이다. "median은 비슷한데 tail은 완전히 다르다." 1 req/s까지 두 구성의 median ITL은 2124 ms로 같다. 그런데 0.4 req/s에서 collocated p99가 169 ms로 튀는 동안 P/D는 29 ms에 머물고, 2 req/s까지 가도 52 ms를 넘지 않는다. 0.40.6 req/s 구간에서 collocated p99는 P/D의 약 6배다. 8k 토큰 prefill이 decode 중인 GPU에 떨어져 그 GPU의 모든 스트림을 멈춰 세우는 것이고, P/D는 그 일을 decode GPU에서 아예 치워버린다.
전송이 빠른 환경에서는 goodput도 올라간다. 원문이 인용한 외부 수치 두 가지.
- AMD MoRI-IO 단일 노드 벤치마크: MI300X 8-GPU 노드 한 대, Qwen3-235B-A22B-FP8, 8 req/s. TTFT 1 s + ITL 50 ms 목표를 100건 중 73건이 충족, collocated는 30건. 같은 하드웨어에서 goodput 약 2.4배.
- llm-d P/D 가이드: H200 16장, gpt-oss-120b. aggregated 복제본 대비 평균 E2E 지연 약 59% 감소, P95 67% 감소.
첫 토큰은 항상 전송 비용을 낸다
여기서부터가 이 글의 정직한 부분이다. 위 결과는 KV 캐시가 빠르게 움직인다는 가정(노드 간 InfiniBand/RoCE RDMA, 노드 내 NVLink 또는 GPU P2P) 위에 서 있다. 원문의 테스트 박스에는 둘 다 없었다. L40S 두 장은 P2P 복사가 안 되고(nvidia-smi topo -p2p r 이 NS 를 찍는다), 8k 프롬프트당 약 470 MB의 KV 캐시(Qwen2.5-7B는 토큰당 56 KiB)가 decode에 닿는 데 약 1.3초가 걸렸다. 그 결과 0.2 req/s에서 P/D median TTFT는 2.2 s, collocated는 0.7 s. ITL tail은 평평했지만 2 s TTFT 목표는 모든 요청률에서 놓쳤다.
1.3초는 대역폭만으로 설명이 안 된다. 호스트 메모리를 거쳐도 PCIe 4.0이면 수십 ms면 끝날 양이다. 대부분은 복사 주변의 오버헤드이고, 그중 하나가 decode가 자기 forward step 사이에 폴링할 때만 전송 완료를 알아챈다는 점이다.
그래서 원문의 첫 번째 조언은 이것이다. 다른 벤치마크를 돌리기 전에 전송부터 확인하라. 한 박스라면 nvidia-smi topo -p2p r 이 prefill/decode GPU 사이에 OK 를 찍어야 한다. 그다음 긴 프롬프트를 한 번에 하나씩 몇 개 보내고 decode의 KV Transfer 메트릭 라인을 읽는다. Avg xfer time 이 수백 ms라면 그걸 먼저 고쳐야 한다.
CPU 티어는 싸다
반대로 렌더 티어의 비용은 거의 없다. 같은 박스에서 Qwen2.5-7B의 9k 토큰 챗 프롬프트를 템플릿 적용 + 토크나이즈하는 데 약 15 ms CPU. 기본 설정 렌더 서버 하나가 코어 하나 남짓으로 73 req/s까지 받았다. Collocated의 tail이 무너지던 0.4 req/s에서 렌더링은 코어 하나의 1% 미만이다.
대가는 명확하다. 서비스가 하나에서 서너 개로 늘고, KV 전송이라는 새로운 실패 모드가 생긴다. 원문의 상황별 권고를 표로 옮기면 이렇다.
| 상황 | 권고 |
|---|---|
| 운영 부하에서 ITL p99가 SLO를 놓친다 | 분리하라. 이게 주 사용 사례다. |
| 긴 프롬프트 + 높은 동시성 | KV 전송이 빠르다면 분리. prefill 간섭이 가장 심한 경우. |
| 컨텍스트가 커지는 챗/에이전트 루프 | 양방향 전송과 함께 분리. KV 오프로딩이나 LMCache/Mooncake 같은 공유 KV 캐시와 조합. |
| GPU 노드 CPU 프로파일에 템플릿/토크나이즈/파싱이 보인다 | 렌더 티어만 떼어내라. |
| TTFT가 가장 빡빡한 제약 | collocated 유지 또는 먼저 측정. 전송이 모든 첫 토큰에 얹힌다. |
| KV 전송이 느리다 | 고치거나 collocated 유지. 패브릭도 확인할 것(잘못 설정된 네트워크는 collective도 느리게 한다). |
| 낮거나 버스티하거나 지연에 둔감한 트래픽 | collocated 유지. |
🔧 Prefill/Decode 분리 띄우기
예시는 빨리 로드되는 Qwen3-0.6B를 쓴다. 배선 확인용이지 P/D 이득을 보여주기엔 너무 작으니, 벤치마크는 더 큰 모델로 해야 한다. 프로세스는 셋이다. prefiller, decoder, proxy.
# Prefiller on GPU 0
CUDA_VISIBLE_DEVICES=0 UCX_NET_DEVICES=all VLLM_NIXL_SIDE_CHANNEL_PORT=5600 \
vllm serve Qwen/Qwen3-0.6B --port 8100 \
  --kv-transfer-config '{"kv_connector":"NixlConnector","kv_role":"kv_producer"}'

# Decoder on GPU 1
CUDA_VISIBLE_DEVICES=1 UCX_NET_DEVICES=all VLLM_NIXL_SIDE_CHANNEL_PORT=5601 \
vllm serve Qwen/Qwen3-0.6B --port 8200 \
  --kv-transfer-config '{"kv_connector":"NixlConnector","kv_role":"kv_consumer"}'

# Proxy
python tests/v1/kv_connector/nixl_integration/toy_proxy_server.py --port 8192 \
  --prefiller-hosts localhost --prefiller-ports 8100 \
  --decoder-hosts localhost --decoder-ports 8200
핵심은 --kv-transfer-config 한 줄이다. 커넥터는 NixlConnector, 역할은 kv_producer(prefill) 또는 kv_consumer(decode). 둘을 묶는 건 프록시다. 요청마다 프록시는 먼저 prefill을 max_tokens=1 과 kv_transfer_params: {"do_remote_decode": true} 로 호출한다. Prefill은 KV 캐시를 계산하고 블록을 쥔 채로 그 블록을 가리키는 kv_transfer_params 를 돌려준다. 프록시는 원래 요청에 그 파라미터를 붙여 decode로 넘기고, decode는 생성 전에 NIXL로 블록을 끌어온다. 클라이언트는 8192 포트만 보면 되고, 여느 OpenAI 엔드포인트와 똑같이 보인다.
tests/ 아래의 프록시는 개발용 예제다. 프로덕션은 llm-d나 Dynamo를 보라는 게 원문의 입장이다.
일찍 알아둘 설정 셋.
VLLM_NIXL_SIDE_CHANNEL_PORT: 한 호스트의 워커마다 유일해야 한다.kv_lease_duration(kv_connector_extra_config안, 기본 30s): prefiller가 decoder가 가져갈 때까지 블록을 얼마나 붙들고 있을지. 부하가 걸리면 이 타임아웃을 튜닝하게 된다.kv_load_failure_policy: 전송 실패 시 동작. 기본fail은 요청을 에러 처리,recompute는 decode가 빠진 KV를 직접 다시 계산한다. 느리지만 요청은 살아남는다.
작은 공짜 이득: 토큰 ID 재사용
/v1/chat/completions 로 P/D를 돌린다면 prefill 단계에서 이미 토크나이즈했으니 decode가 또 할 필요가 없다. Prefill에 return_token_ids 를 요청하고 그 ID를 kv_transfer_params 로 decode에 넘기면 된다. 프록시가 하는 2단계 호출과 같고, 토큰 ID만 새로 추가된 부분이다.
from openai import OpenAI

MODEL = "Qwen/Qwen3-0.6B"
messages = [{"role": "user", "content": "What is 17 * 23?"}]

prefill_client = OpenAI(base_url="http://localhost:8100/v1", api_key="EMPTY")
decode_client = OpenAI(base_url="http://localhost:8200/v1", api_key="EMPTY")

prefill = prefill_client.chat.completions.create(model=MODEL, messages=messages, max_tokens=1,
    extra_body={"return_token_ids": True, "kv_transfer_params": {"do_remote_decode": True}})

# prefill's kv_transfer_params point decode at its blocks; add the token IDs on top
decode = decode_client.chat.completions.create(model=MODEL, messages=messages, stream=True,
    extra_body={"kv_transfer_params": {**prefill.kv_transfer_params,
                                       "prompt_token_ids": prefill.prompt_token_ids}})
멀티턴: 대화를 다시 계산하지 마라
표준 P/D는 캐시를 한 방향으로만 옮긴다. 챗이나 에이전트 루프에서는 이게 낭비다. 2턴째에 decode는 방금 생성한 답변의 KV를 들고 있지만 prefill은 그걸 계산한 적이 없어서 다시 계산한다. 양쪽 인스턴스에 bidirectional_kv_xfer 를 켜면 prefill이 그 블록을 decode에서 되돌려 받고 새 토큰만 계산한다. 어느 블록이 어느 대화 것인지는 클라이언트가 보내는 conversation_id 로 프록시가 추적한다.
reasoning 모델에는 경고가 하나 붙는다. decode의 블록에는 생성한 thinking 트레이스가 포함돼 있다. 다음 턴 프롬프트가 그걸 빼버리면(Qwen3 챗 템플릿은 기본적으로 그렇게 한다) prefill의 프롬프트와 decode의 블록이 어긋나서 느린 출력이 아니라 틀린 출력이 나온다. 현재 vLLM에는 이 불일치를 잡는 장치가 없으니(#43094) 켜기 전에 챗 템플릿부터 확인해야 한다.
🖥️ GPU 없는 프론트엔드 띄우기
엔진이 토큰 ID만 받고 토큰 ID만 내놓으면, 챗 템플릿도 파서도 필요 없어지고 호출자가 토큰 ID를 직접 본다. 라우터가 요청을 렌더한 뒤 실제 프롬프트 토큰 기준으로 prefix cache 히트를 보고 복제본을 고를 수 있고, RL/평가 파이프라인은 모델이 실제로 본 ID를 정확히 받는다(디코딩된 텍스트는 항상 같은 토큰으로 재토크나이즈되지 않는다). 멀티모달 전처리도 렌더 티어로 옮겨가는데, 처리된 텐서가 원본 이미지보다 훨씬 클 수 있으니 요청 크기 제한은 그에 맞춰 잡아야 한다.
서버는 둘이다. GPU 없는 렌더 티어와 토큰만 말하는 엔진. 파서는 derender가 도는 렌더 서버 쪽에 둔다.
vllm launch render Qwen/Qwen3-0.6B --port 8100 \
  --reasoning-parser qwen3 --enable-auto-tool-choice --tool-call-parser hermes
vllm serve Qwen/Qwen3-0.6B --tokens-only --port 8200
이 두 모드는 scale-out 엔드포인트를 항상 노출한다. 일반 vllm serve 에서는 기본 꺼져 있으니, 보통 OpenAI 트래픽도 받는 서버에 /render, /derender, /inference/v1/generate 를 열고 싶다면 --enable-scale-out 을 붙인다.
호출은 render → generate → derender 세 홉이다.
import httpx

MODEL = "Qwen/Qwen3-0.6B"
RENDER = "http://localhost:8100"  # vllm launch render
ENGINE = "http://localhost:8200"  # vllm serve --tokens-only

chat_request = {
    "model": MODEL,
    "messages": [{"role": "user", "content": "What is 17 * 23?"}],
    "max_tokens": 2048,
}

with httpx.Client(timeout=60.0) as client:
    # 1. request -> token IDs (no GPU)
    generate_request = client.post(f"{RENDER}/v1/chat/completions/render", json=chat_request).json()

    # 2. token IDs -> token IDs (GPU)
    generate_response = client.post(f"{ENGINE}/inference/v1/generate", json=generate_request).json()

    # 3. token IDs -> ChatCompletionResponse (no GPU)
    response = client.post(f"{RENDER}/v1/chat/completions/derender", json={
        "model": MODEL,
        "generate_response": generate_response,
        "prompt_tokens": len(generate_request["token_ids"]),
        "chat_request": chat_request,
    }).json()

message = response["choices"][0]["message"]
print(message["reasoning"], message["content"], sep="\n---\n")
chat_request 를 derender에 다시 넘기는 게 중요하다. 파서가 원래 컨텍스트(tools, tool_choice, include_reasoning)를 알아야 일반 vllm serve 와 같은 content / reasoning / tool_calls 분리를 만든다. 파서가 설정된 모델에서 이걸 빼먹으면 <tool_call> 마크업이 content로 새는 조용한 폴백 대신 400 에러가 난다.
스트리밍
두 엔드포인트 모두 stream: true 를 받는다. /render 는 돌려주는 요청에 stream을 유지하므로 generate도 스트리밍되고, 각 generate 청크가 따로 derender를 거친다.
import json

chat_request = {**chat_request, "stream": True}

with httpx.Client(timeout=60.0) as client:
    generate_request = client.post(f"{RENDER}/v1/chat/completions/render", json=chat_request).json()
    prompt_token_ids = generate_request["token_ids"]

    stream_state = None  # one per choice index if n > 1
    with client.stream("POST", f"{ENGINE}/inference/v1/generate", json=generate_request) as stream:
        for line in stream.iter_lines():
            if not line.startswith("data: ") or line == "data: [DONE]":
                continue
            derendered = client.post(f"{RENDER}/v1/chat/completions/derender", json={
                "stream": True,
                "model": MODEL,
                "generate_chunk": json.loads(line[len("data: "):]),
                "stream_state": stream_state,
                "prompt_tokens": len(prompt_token_ids),
                "prompt_token_ids": prompt_token_ids,
                "chat_request": chat_request,
            }).json()
            stream_state = derendered["stream_state"]
            for choice in derendered["chunk"]["choices"]:
                print(choice["delta"].get("content") or "", end="", flush=True)
첫 호출에 stream_state 는 null 로 보내고, 이후에는 직전 응답이 준 값을 그대로 되돌려 보낸다. chat_request 와 prompt_token_ids 가 매 청크에 따라가는 이유는 서버가 호출 사이에 아무것도 저장하지 않기 때문이다. 덕분에 어떤 렌더 복제본이든 어떤 청크든 처리할 수 있지만, 파서가 끼면 여기가 비용의 출처가 된다(아래 "남은 과제").
렌더 티어 배포
렌더 티어는 스트리밍 중에도 요청별 상태를 들고 있지 않으니, 여느 stateless 웹 서비스처럼 로드밸런서 뒤에 복제본을 두고 GPU 풀과 무관하게 CPU 기준으로 스케일하면 된다. 다만 두 가지는 챙겨야 한다.
- 설정 일치. render, derender, 엔진이 모델, 토크나이저, 챗 템플릿, 파서 플래그(
--chat-template,--default-chat-template-kwargs,--reasoning-parser,--tool-call-parser,--enable-auto-tool-choice)에 대해 합의해야 한다. 불일치는 에러를 내지 않는다. 그냥vllm serve와 다른 content / reasoning / tool_calls 분리가 나올 뿐이다. - 스레드 풀 크기. 템플릿, 토크나이즈, 멀티모달 전처리, 스트리밍 파서 재생은 모두
--renderer-num-workers(기본 1)로 정한 워커에서 돈다. 단순 렌더링은 싸지만(9k 토큰 15 ms), reasoning/tool-calling 모델을 파서로 스트리밍하면 훨씬 비싸진다. 동시 파싱 스트림 수에 맞춰 워커를 늘리거나 복제본을 추가해야 한다.
🔗 두 분리를 합치기
그림 1의 아래쪽 구성, 즉 4 티어 3 서버다. 아직 업스트림에서 4홉을 대신 돌려주는 건 없지만, /inference/v1/generate 가 /v1/chat/completions 와 똑같이 kv_transfer_params 를 받으니 조각은 맞물린다.
# Render and derender, no GPU
vllm launch render Qwen/Qwen3-0.6B --port 8000 \
  --reasoning-parser qwen3 --enable-auto-tool-choice --tool-call-parser hermes

# Prefill on GPU 0
CUDA_VISIBLE_DEVICES=0 UCX_NET_DEVICES=all VLLM_NIXL_SIDE_CHANNEL_PORT=5600 \
vllm serve Qwen/Qwen3-0.6B --tokens-only --port 8100 \
  --kv-transfer-config '{"kv_connector":"NixlConnector","kv_role":"kv_producer"}'

# Decode on GPU 1
CUDA_VISIBLE_DEVICES=1 UCX_NET_DEVICES=all VLLM_NIXL_SIDE_CHANNEL_PORT=5601 \
vllm serve Qwen/Qwen3-0.6B --tokens-only --port 8200 \
  --kv-transfer-config '{"kv_connector":"NixlConnector","kv_role":"kv_consumer"}'
이제 render와 derender 사이에서 프록시 역할은 내 코드가 한다.
import httpx

MODEL = "Qwen/Qwen3-0.6B"
RENDER, PREFILL, DECODE = "http://localhost:8000", "http://localhost:8100", "http://localhost:8200"

chat_request = {
    "model": MODEL,
    "messages": [{"role": "user", "content": "What is 17 * 23?"}],
    "max_tokens": 2048,
}

with httpx.Client(timeout=60.0) as client:
    # 1. Render: request -> token IDs (no GPU)
    generate_request = client.post(f"{RENDER}/v1/chat/completions/render", json=chat_request).json()

    # 2. Prefill: compute the KV cache, generate one token, hold the blocks
    prefill_response = client.post(f"{PREFILL}/inference/v1/generate", json={
        **generate_request,
        "sampling_params": {**generate_request["sampling_params"], "max_tokens": 1},
        "kv_transfer_params": {"do_remote_decode": True},
    }).json()

    # 3. Decode: pull prefill's blocks over NIXL, then generate
    generate_response = client.post(f"{DECODE}/inference/v1/generate", json={
        **generate_request,
        "kv_transfer_params": prefill_response["kv_transfer_params"],
    }).json()

    # 4. Derender: token IDs -> ChatCompletionResponse (no GPU)
    response = client.post(f"{RENDER}/v1/chat/completions/derender", json={
        "model": MODEL,
        "generate_response": generate_response,
        "prompt_tokens": len(generate_request["token_ids"]),
        "chat_request": chat_request,
    }).json()

message = response["choices"][0]["message"]
print(message["reasoning"], message["content"], sep="\n---\n")
2단계는 프록시와 같은 트릭이다. 토큰 예산 1 + do_remote_decode 로 prefill이 KV 캐시를 계산하고 블록을 쥔다. 3단계는 prefill이 돌려준 kv_transfer_params 를 decode에 넘긴다. 예제 프록시는 /v1/completions 와 /v1/chat/completions 만 다루므로, 프로덕션에서 이 오케스트레이션은 직접 짜거나 llm-d / Dynamo에 맡겨야 한다. 렌더러 문서도 그 둘을 의도된 호출자로 명시하고 있다.
🏭 누가 실제로 돌리고 있나
- llm-d: vLLM 네이티브 remote prefill/decode와 NIXL KV 전송을 사용. 라우터와 EPP 스케줄러가 prefill/decode 엔드포인트를 고르고 KV 핸드오프를 조율한다.
- NVIDIA Dynamo: Kubernetes 위에서 vLLM을 aggregated/disaggregated 모드로 운영, 자체 라우터와 플래너 포함.
- KServe: llm-d 위에 구축된
LLMInferenceService로 노출. - vLLM production stack(Helm), AIBrix(컨트롤 플레인).
- 커넥터 쪽은 Moonshot Mooncake, LMCache, AMD MoRI-IO 가 모두 업스트림에 있다. decode가 커넥터 뒤에 있으니 decode가 vLLM일 필요도 없다. TileRT 는 vLLM prefill에 자체 지연 최적화 decode 엔진을 붙인다.
선행 글에서 SGLang 쪽 P/D 명령을 소개했는데, vLLM 쪽 생태계는 "엔진은 vLLM, 오케스트레이션은 llm-d/Dynamo"로 역할이 나뉘는 모양새다.
⚠️ 남은 과제
원문이 숨기지 않는 미해결 지점들이다.
파서를 낀 스트리밍 derender가 비싸다. reasoning/tool 파서는 직렬화할 수 없는 상태를 들고 있어서, 청크마다 파서를 새로 만들고 토큰 히스토리를 처음부터 재생한다. 전송이 청크당 O(n), 재생이 청크당 O(n) 파싱 호출, 거기에 Hermes나 DeepSeek-R1 같은 파서의 parse_delta 가 누적 텍스트를 다시 스캔하니 긴 생성에서 O(n³) 문자 작업이 된다. 수천 토큰 reasoning 출력 벤치마크에서 같은 부하 기준 in-process 대비 약 9배의 CPU, E2E p50 +15% 가 측정됐다. 캐싱 레이어가 예정돼 있고(#57571), 그전까지는 워커 1개짜리 렌더 티어가 동시 파싱 스트림에서 포화되니 위에서 말한 대로 사이징해야 한다.
긴 프롬프트가 회선을 지배한다. 파서 경로는 청크마다 prompt_token_ids 전체를 다시 보낸다. 100k 토큰 프롬프트에 1k 토큰 출력이면 요청 본문의 약 99%가 프롬프트다. 파서 없는 단순 디토크나이즈에는 이 문제가 없다.
작은 정합성 갭. 배치 derender가 tool call을 파싱하고도 finish_reason: "tool_calls" 를 항상 돌려주지 않고(#47931에서 수정 중), 파서의 tool call ID 대신 자체 ID를 만든다. 토크나이저 없는 엔진의 logprobs는 "token_id:N" 플레이스홀더 문자열로 온다(#57574가 정수 ID 반환을 제안).
열린 설계 질문. /inference/v1/generate 가 세 번째 홉이 필요 없는 호출자를 위해 텍스트나 derender된 출력을 바로 돌려줘야 하는가(#56851). 우산 RFC는 #42729, #47161, #22817, #34407이다.
💡 어디서 시작할까
GPU 두 장이 있다면 위의 NIXL 예제를 7B급 모델로 돌려보라. Qwen3-0.6B는 prefill이 너무 빨라서 decode를 거의 방해하지 않으니 P/D가 고칠 게 없다. 전송부터 확인한 다음, 8192 프록시와 같은 GPU 두 장의 collocated vllm serve --data-parallel-size 2 를 같은 벤치마크로 때려서 p99 ITL, TTFT, goodput을 비교한다. collocated p99 ITL이 무너질 때까지 --request-rate 를 올린다. 테스트 박스에서 8k 프롬프트 기준 그 지점은 0.4 req/s였다. 요청률을 바꿔가며 --seed 를 재사용한다면 모든 서버를 --no-enable-prefix-caching 으로 띄워야 한다. 안 그러면 뒤쪽 요청률에서 캐시된 프롬프트가 재생되어, 측정하려던 prefill 간섭을 캐시 히트가 가려버린다.
vllm bench serve --model Qwen/Qwen2.5-7B-Instruct --port 8192 \
  --dataset-name random --random-input-len 8192 --random-output-len 256 --ignore-eos \
  --request-rate 0.4 --num-prompts 100 \
  --percentile-metrics ttft,tpot,itl --metric-percentiles 50,99 \
  --goodput ttft:2000 tpot:30
챗이나 에이전트를 서빙한다면 bidirectional_kv_xfer 를 켜고 1턴이 아니라 5턴째 TTFT를 재라. 이미 Kubernetes 위라면 프록시를 직접 만들기보다 llm-d나 Dynamo에서 시작하라. reasoning/tool-calling 모델을 스트리밍 derender로 돌린다면 렌더 티어를 사이징하기 전에 먼저 벤치마크하라. 가장 놀랄 가능성이 높은 부분이 거기다.
📝 정리
이 가이드가 선행 개념 글과 다른 점은 숫자의 정직함이다. P/D는 ITL tail을 확실히 눌러준다(0.4 req/s에서 p99 169 ms → 29 ms). 하지만 전송이 느린 박스에서는 TTFT가 세 배(0.7 s → 2.2 s)로 늘어 SLO를 전부 놓친다. 분리의 이득은 KV 전송 속도가 결정하고, 그 전송은 네트워크 대역폭보다 복사 주변의 오버헤드에 더 좌우된다. 한편 GPU 없는 렌더 티어는 거의 공짜에 가깝지만, 파서를 낀 스트리밍만은 현재 구조상 비싸다.
결국 체크리스트는 단순하다. 전송 확인 → 7B급 모델로 collocated와 비교 → tail이 무너지는 요청률 찾기 → 그 수치로 분리 여부 결정. "분리는 새로운 표준"이라는 말보다, 이 순서가 더 실용적인 결론이다.
📚 참고
- 원문: Taking vLLM Apart: A Practical Guide to Disaggregated Serving (Martin Hickey, IBM Research, 2026-09-29)
- 선행 글: Prefill-Decode 분리(PD Disaggregation): LLM 서빙의 새로운 표준
- vLLM 문서: Disaggregated Prefilling · NixlConnector · Renderer · Derenderer
- llm-d P/D disaggregation guide / NVIDIA Dynamo
- 관련 vLLM 블로그: PD Serving of Qwen3.8-2.4T (2026-09-21), vLLM x AgentX (2026-09-08)
본 글의 그림은 원문에서 가져왔습니다.