긴 문서 OCR의 두 갈래: Unlimited OCR Works의 상수 메모리와 Xiaomi-OCR-0의 소형 문서 VLM
"현존하는 어떤 모델도 열 페이지를 한 번의 forward pass로 읽지 못한다. for-loop는 엔지니어링 우회일 뿐, AGI를 향한 한 걸음이 아니다." — Unlimited OCR Works 1절
2026년 6월 22일 바이두가 Unlimited OCR Works: Welcome the Era of One-shot Long-horizon Parsing(arXiv 2606.23050)을, 9월 28일 샤오미 SeerRay 팀이 Xiaomi-OCR-0 Technical Report(arXiv 2609.36136)를 공개했다. 두 논문은 같은 벤치마크(OmniDocBench)를 쓰지만 민 방향이 정반대다. 바이두는 디코더의 어텐션 구조를 바꿔 "얼마나 긴 문서를 한 번에 읽을 수 있는가"를, 샤오미는 데이터와 학습 레시피를 바꿔 "0.8B 모델이 한 페이지를 얼마나 정확히 읽는가"를 밀었다. 이 글은 MinerU2.5 리뷰의 후속편이다. MinerU2.5가 "해상도를 어디에 쓸 것인가"를 분리해 1.2B로 90점 벽을 넘은 지 1년 만에, 문서 파싱 VLM이 어디까지 왔는지 두 논문으로 읽는다.
코드와 가중치는 둘 다 공개돼 있다. Unlimited OCR은 github.com/baidu/Unlimited-OCR(MIT, 2026년 11월 초 기준 약 3만 스타)과 Hugging Face baidu/Unlimited-OCR, Xiaomi-OCR-0는 github.com/xiaomi-research/Xiaomi-OCR-0(Apache-2.0, 약 770 스타)과 xiaomi-research/Xiaomi-OCR-0(베이스 Qwen/Qwen3.5-0.8B-Base)이다. 바이두 저장소는 10월 27일 후속작 Unlimited OCR 2(arXiv 2610.39308)로 갈아탔고, 1.0 코드는 UnlimitedOCR1.0 브랜치에 남아 있다.
원문: https://arxiv.org/abs/2606.23050 · https://arxiv.org/abs/2609.36136
🤔 배경: 긴 문서는 왜 VLM OCR을 무너뜨리는가
end-to-end OCR VLM은 페이지 이미지를 비전 토큰으로 바꿔 LLM 디코더에 넣고, 텍스트·수식·표를 자기회귀로 뱉는다. 문서가 길어지면 두 곳에서 동시에 터진다.
입력 쪽, 토큰 예산. 네이티브 해상도 인코더는 페이지당 수천 토큰을 만든다. DeepSeek-OCR의 DeepEncoder는 SAM-ViT(윈도 어텐션)와 CLIP-ViT(전역 어텐션) 사이에 16배 압축을 넣어 1024×1024 페이지를 256토큰으로 줄였는데, Unlimited OCR 저자들은 이 압축률이 멀티페이지의 전제 조건이라고 본다. 그래도 수십 페이지면 prefill이 수천~1만 토큰이다.
출력 쪽, KV 캐시. 바이두 논문의 계산을 옮기면, 비전 토큰 하나가 텍스트 토큰 약 10개로 풀린다고 가정할 때 1만 비전 토큰(1024×1024 기준 20~30페이지)은 10만 토큰 이상의 출력을 요구한다. 표준 멀티헤드 어텐션(MHA)의 KV 캐시는 로 출력 길이 에 비례해 자라고, 어텐션 계산도 매 스텝 전체 캐시를 읽는다. 그래서 모든 기존 모델은 페이지마다 메모리를 비우는 for-loop로 돌고, 페이지 간 문맥(표가 다음 페이지로 이어지는 경우 등)은 외부 스케줄러가 꿰맨다.
샤오미 논문은 이 문제를 정면으로 다루지 않는다. 대신 다른 병목을 짚는다. 컴팩트 OCR VLM의 성능은 감독 데이터의 질과 양에 달려 있는데 텍스트·표·수식·읽기 순서는 검증 절차가 제각각이고, 모델이 만든 그럴듯한 라벨은 오류를 숨긴다는 것이다. 두 논문을 나란히 두면 "길이"와 "정확도"라는 두 축이 보인다.
🧠 Unlimited OCR Works: 사람은 책을 베낄 때 앞 페이지를 다시 읽지 않는다
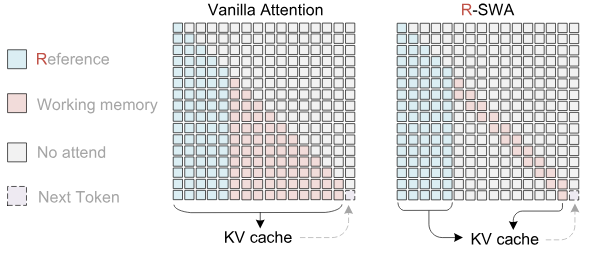
출발점은 관찰이다. 사람이 책을 필사할 때 보는 것은 세 가지뿐이다. 원본, 방금 쓴 몇 글자, 다음에 쓸 글자. 이미 옮긴 수백 줄을 다시 훑지 않는다. 저자들은 이것이 표준 full attention도, 선형 어텐션도 아니라고 짚는다. full attention은 전체 이력을 매번 보고, 선형 어텐션은 비전 토큰까지 순환 상태로 접어 넣어 시각 특징을 점점 흐리게 만든다.
그래서 제안하는 것이 **Reference Sliding Window Attention(R-SWA)**이다. 토큰 가 볼 수 있는 집합은
이다. 는 비전 토큰과 프롬프트로 이루어진 참조 구간(길이 , 한 번의 추론 안에서 고정)이고, 는 직전 개 출력 토큰(기본 128)의 인과적 슬라이딩 윈도다. 소프트맥스는 이 집합 위에서만 계산한다. 비전 토큰은 상태 전이에 참여하지 않고 한 번 인코딩된 채 정적으로 남는다. 저자들이 "vanilla SWA 대비 시각 토큰의 충실도를 보존한다"고 쓴 대목이 이것이다.
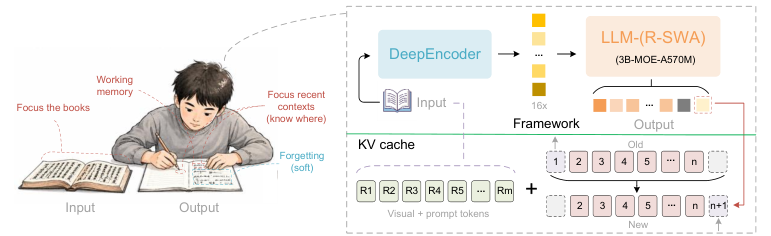
상수 메모리의 정확한 메커니즘. KV 캐시는 용량 의 큐다. 참조 구간 은 그대로 두고, 출력 구간은 새 토큰이 생길 때마다 번째, 즉 윈도에서 가장 오래된 출력 토큰의 KV를 버린다. 따라서 토큰을 생성한 뒤 캐시 크기는
으로 상한이 있고, MHA 대비 비율 는 에서 이다. "무제한"이라는 이름은 여기서 나온다. 출력이 아무리 길어도 메모리와 스텝당 계산량이 늘지 않는다. 다만 뒤에서 보듯 prefill 길이 은 그대로 남는다.
구조는 DeepSeek-OCR를 그대로 가져왔다. DeepEncoder + 3B(활성 0.5B) MoE 디코더이고, 디코더의 모든 어텐션 층을 R-SWA로 바꿨다. 해상도 모드는 다섯 중 둘만 남겼다. 멀티페이지용 "Base"(1024×1024, 256토큰)와 단일 페이지용 "Gundam"(동적 해상도)이다.
학습. DeepSeek-OCR 체크포인트에서 이어서 학습했다. 데이터는 약 200만 문서 OCR 샘플(단일:멀티페이지 = 9:1)로, 단일 페이지는 PaddleOCR로 블록 좌표(01000 정규화)와 내용을 붙여 라벨링했고, 멀티페이지 약 20만 샘플은 단일 페이지를 250장 이어 붙여 <page> 구분자로 합성했다. 모든 데이터를 32K 길이로 패킹하고, 8×16 A800에서 전역 배치 256으로 4,000스텝, DeepEncoder는 동결하고 LLM만 학습했다(AdamW, lr 1e-4, 코사인, DeepEP EP=4, Megatron-LM). 추론은 Transformers와 SGLang에 R-SWA용 KV 관리를 구현했다.
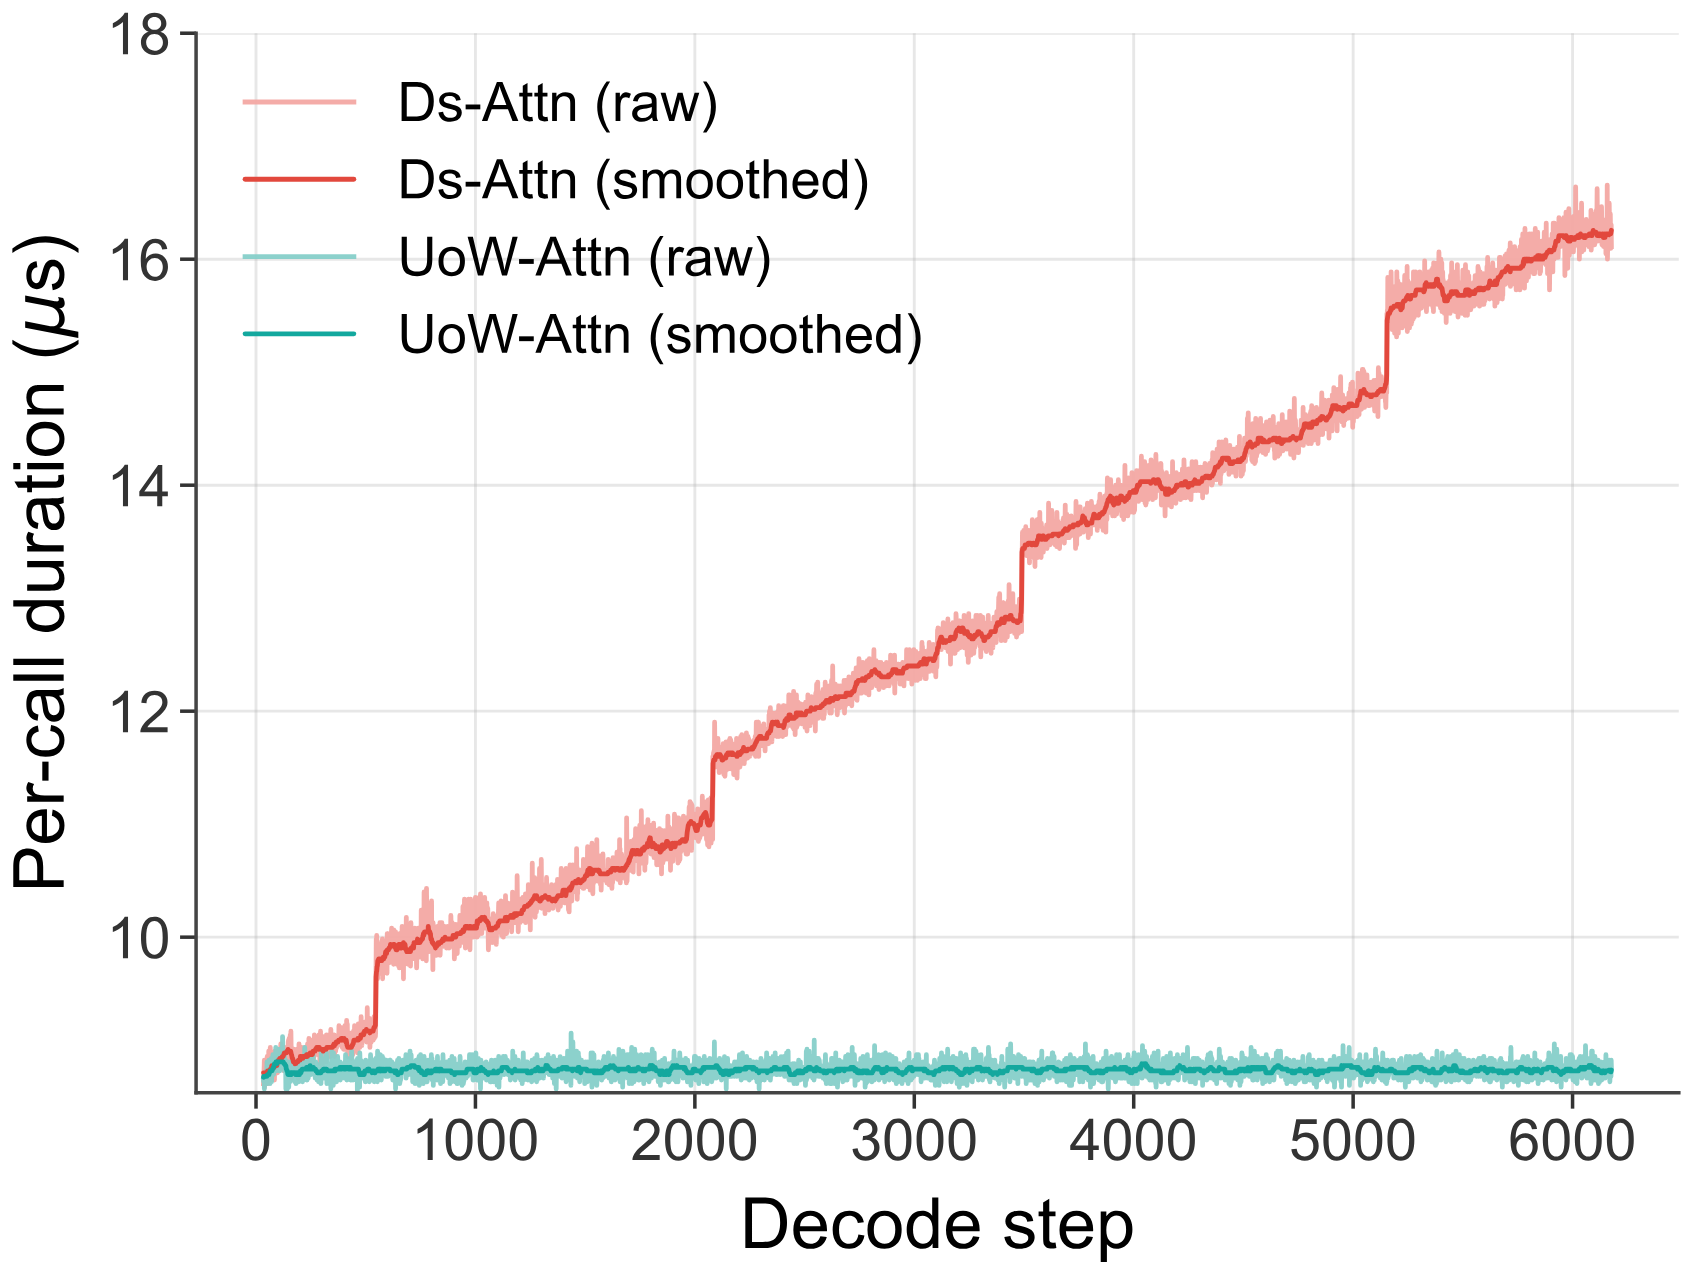
커널 수준에서 보면 그림 3이 전부다. DeepSeek-OCR의 어텐션 커널은 스텝마다 느려지고 KV 길이가 정렬 경계를 넘을 때마다 뛰는데, R-SWA는 평평하다. 저자들은 GPU 메모리도 같은 패턴(선형 증가 대 고정)이라고 적었다.
📊 Unlimited OCR 결과: 단일 페이지에서 손실 없음, 40페이지에서 edit 0.11
OmniDocBench v1.5에서 베이스라인 DeepSeek-OCR와 직접 비교하면 전 지표가 좋아졌다.
| 모델 (v1.5) | 크기 | Overall ↑ | Text Edit ↓ | Formula CDM ↑ | Table TEDS ↑ | Read Order ↓ |
|---|---|---|---|---|---|---|
| DeepSeek-OCR | 3B-A0.5B | 87.01 | 0.073 | 83.37 | 84.97 | 0.086 |
| DeepSeek-OCR 2 | 3B-A0.5B | 89.17 | 0.049 | 86.85 | 85.60 | 0.060 |
| Unlimited-OCR | 3B-A0.5B | 93.23 | 0.038 | 92.61 | 90.93 | 0.045 |
v1.6에서는 93.92로 Qianfan-OCR(93.90), Logics-Parsing-v2(93.33), FireRed-OCR(93.26)을 근소하게 앞서 저자들이 "end-to-end SOTA"라고 쓴다. 저자들의 해석은 두 가지다. R-SWA가 모델을 조밀한 OCR 과제에 더 집중시키고, 윈도 128 안으로도 이력이 인과적으로 흘러 들어와 "지금 어디까지 읽었는지"를 잃지 않는다는 것. 9개 문서 유형별(Table 2)로도 DeepSeek-OCR 대비 전 항목 개선이고, DeepSeek-OCR 2와 비교하면 텍스트·읽기 순서 각각 9개 중 7개에서 앞선다.
속도는 OmniDocBench에서 5,580 TPS(512 동시) 대 DeepSeek-OCR 4,951로 12.7% 빠르고, prefill 10으로 고정한 이론 상한(Table 4)에서는 출력 6,144토큰에서 DeepSeek-OCR 5,823 대 Unlimited OCR 7,848로 35% 차이가 난다. 출력이 길수록 격차가 벌어지는 구조다.
핵심인 멀티페이지 결과는 자체 테스트셋(소설·문서·논문을 페이지 수로 나눔, 분류당 10권 이상)이다.
| 페이지 수 | 2 | 5 | 10 | 15 | 20 | 40+ |
|---|---|---|---|---|---|---|
| Distinct-35 ↑ | 99.87% | 99.98% | 99.83% | 99.99% | 99.89% | 96.90% |
| Edit Distance ↓ | 0.0362 | 0.0452 | 0.0526 | 0.0787 | 0.0572 | 0.1069 |
Distinct-n은 생성 텍스트의 고유 n-gram 비율로, 반복 루프에 빠졌는지 보는 지표다. 40페이지 이상에서도 edit 0.11, Distinct-35 97%다. 저자들은 반복 오류가 난 사례를 보면 대부분 Base 모드(1024×1024)에서 작은 글씨가 안 보이는 경우였고, R-SWA가 길이 때문에 방향을 잃은 것은 아니라고 쓴다.
🛠️ Xiaomi-OCR-0: 0.8B에 1억 7천만 샘플을 붓는 데이터 엔진
Xiaomi-OCR-0는 Qwen3.5-0.8B에서 출발한 0.8B 단일 모델로, 문서 파싱(Markdown, 표는 OTSL→HTML, 수식은 LaTeX)과 OCR 중심 이해(OCR-VQA, 키 정보 추출 KIE)를 하나의 지시 인터페이스로 처리한다. 중요한 전제가 하나 있다. OmniDocBench v1.6·Real5·Wild의 주요 수치는 2단계 추론이다. PP-DocLayoutV3가 영역을 검출하고, Xiaomi-OCR-0가 crop을 읽고, 페이지로 조립한다. 보고된 0.8B에 외부 레이아웃 검출기는 포함되지 않는다. README도 인쇄된 정형 문서는 영역 모드, 손글씨·서예·고서·비정형 레이아웃은 전체 페이지 모드를 권한다.
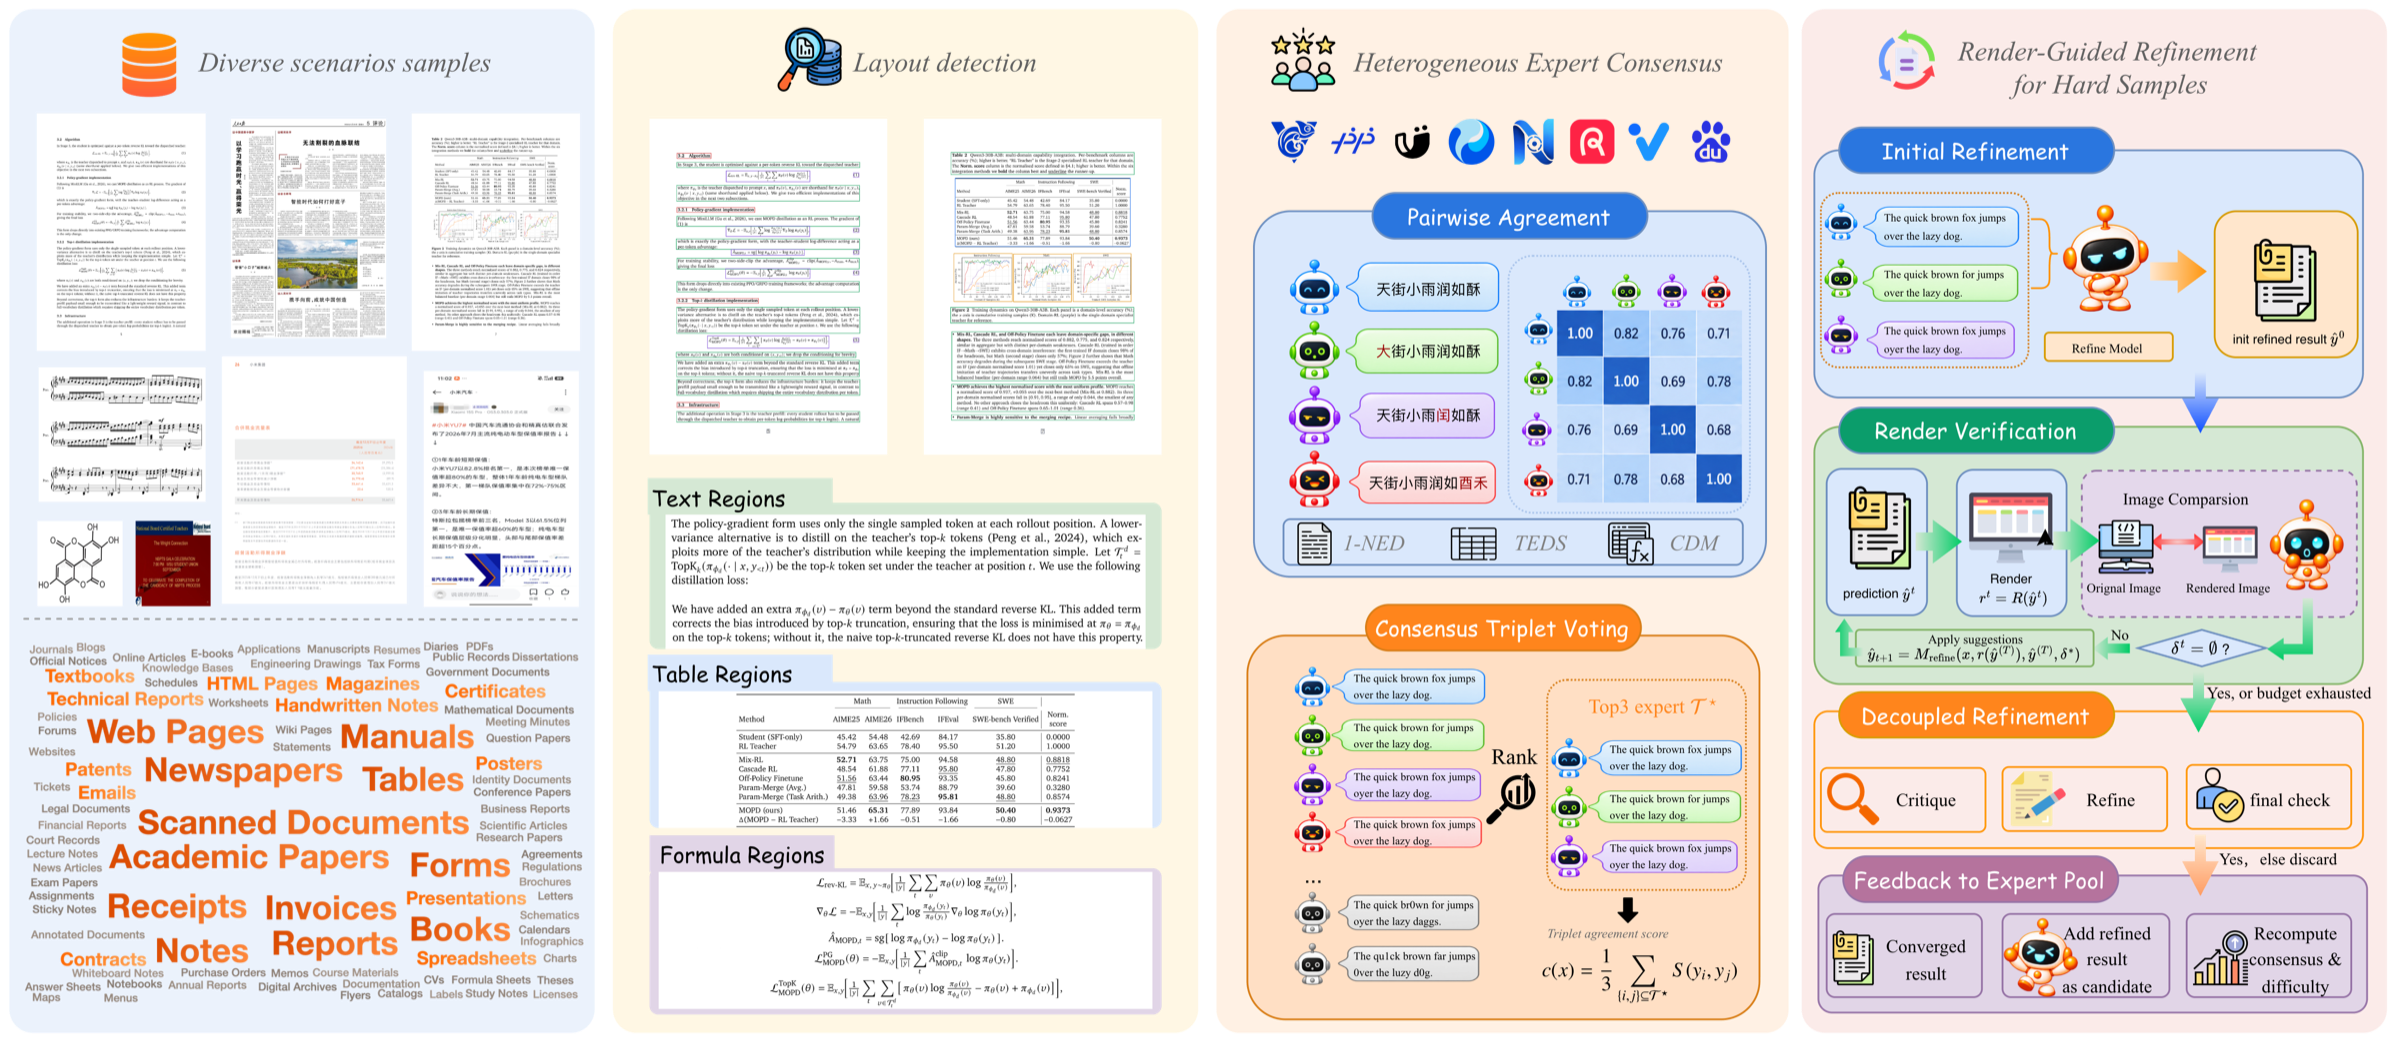
데이터 엔진이 논문의 절반이다. 약 1억 7천만 샘플 코퍼스를 자동으로 만드는 세 부품이다.
- Ensemble Triplet Consensus(ETC). PP-DocLayoutV3로 자른 텍스트·표·수식 영역마다 8개 전문가 모델(PaddleOCR-VL-1.6, MinerU2.5-Pro, GLM-OCR, dots.ocr, HunyuanOCR-1.5, TeleOCR, OvisOCR2, Qianfan-OCR)이 독립 예측을 낸다. 쌍별 유사도는 텍스트 , 표 TEDS, 수식 CDM이다. 풀 전체와의 평균 일치도 상위 3개를 삼중조로 뽑고, 그 안에서 다른 둘과 가장 가까운 medoid를 의사 라벨로 삼는다. 삼중조 평균 일치도 면 바로 채택, 0.6~0.9와 0.6 미만은 다음 단계로 보낸다. MinerU2.5-Pro의 CMCV와 달리 타깃 모델이 풀에 있을 필요가 없다는 것이 저자들의 차별점이다.
- Render-Guided Refine-and-Judge. 풀 밖의 Qwen3.5-122B-A10B가 가장 일치하는 두 예측을 참고해 초안을 만들고, HTML(텍스트·표) 또는 LaTeX(수식)로 렌더링해 원본 이미지와 비교하며 최대 3라운드 수정한다. 수렴하지 않으면 이력을 통째로 넣는 critique-refine-verify를 한 번 더 돈다. 고친 결과는 후보 하나로 풀에 추가되어 ETC를 다시 돌고, 다시 고일치 구간에 들어온 것만 코퍼스에 들어간다. 못 푼 영역은 보류하고 일부만 사람이 본다.
- 샘플 마이닝과 합성. 전문가 일치도 , 모델 자기일관성 (같은 입력을 여러 번 샘플링했을 때의 일치도), Qwen3-VL-Embedding + K-Means 클러스터를 조합해 CPT용 광범위 혼합과 RL용 난이도 혼합을 만든다. 일치도는 높은데 자기일관성이 낮은 샘플이 하드 케이스 후보다. 합성은 커버리지 부족(긴 표, 병합 셀, 서예·희귀 글리프)을 메우는 쪽과, 진단된 실패 패턴을 보존한 변형을 만드는 쪽 두 모드로, 에이전트가 레시피를 짜고 검증 세트는 문서 단위로 분리해 두었다.
학습 레시피는 3단계다. (1) Q-Mask 프레임워크의 텍스트 앵커링 사전학습. TextAnchor-26M에 자체 파싱 데이터를 더해 next-token 손실과 공간 마스크 손실(Dice+CE)을 함께 최적화한다. (2) OCR 중심 계속 사전학습(CPT). 마스크 디코더는 떼고 베이스 모델의 MTP 헤드는 유지한다. (3) Mix-RL. DAPO 스타일(토큰 수준 집계, clip-higher, 동적 샘플링, KL 항 없음) GRPO로 파싱과 이해를 한 풀에서 돌린다. 보상은 과제별이다. 영역 샘플은 edit 유사도/TEDS/CDM, 전체 페이지는 MGAM으로 요소를 정렬한 뒤 모달리티별 글자 비중으로 가중합, KIE는 JSON 유효성 검사 후 필드 edit 유사도, VQA는 ANLS, 형식 위반이나 길이 초과는 0이다.
📊 Xiaomi-OCR-0 결과: 벤치마크와 세 가지 Takeaway
| 벤치마크 | Xiaomi-OCR-0 | 비교 1위 또는 차점 |
|---|---|---|
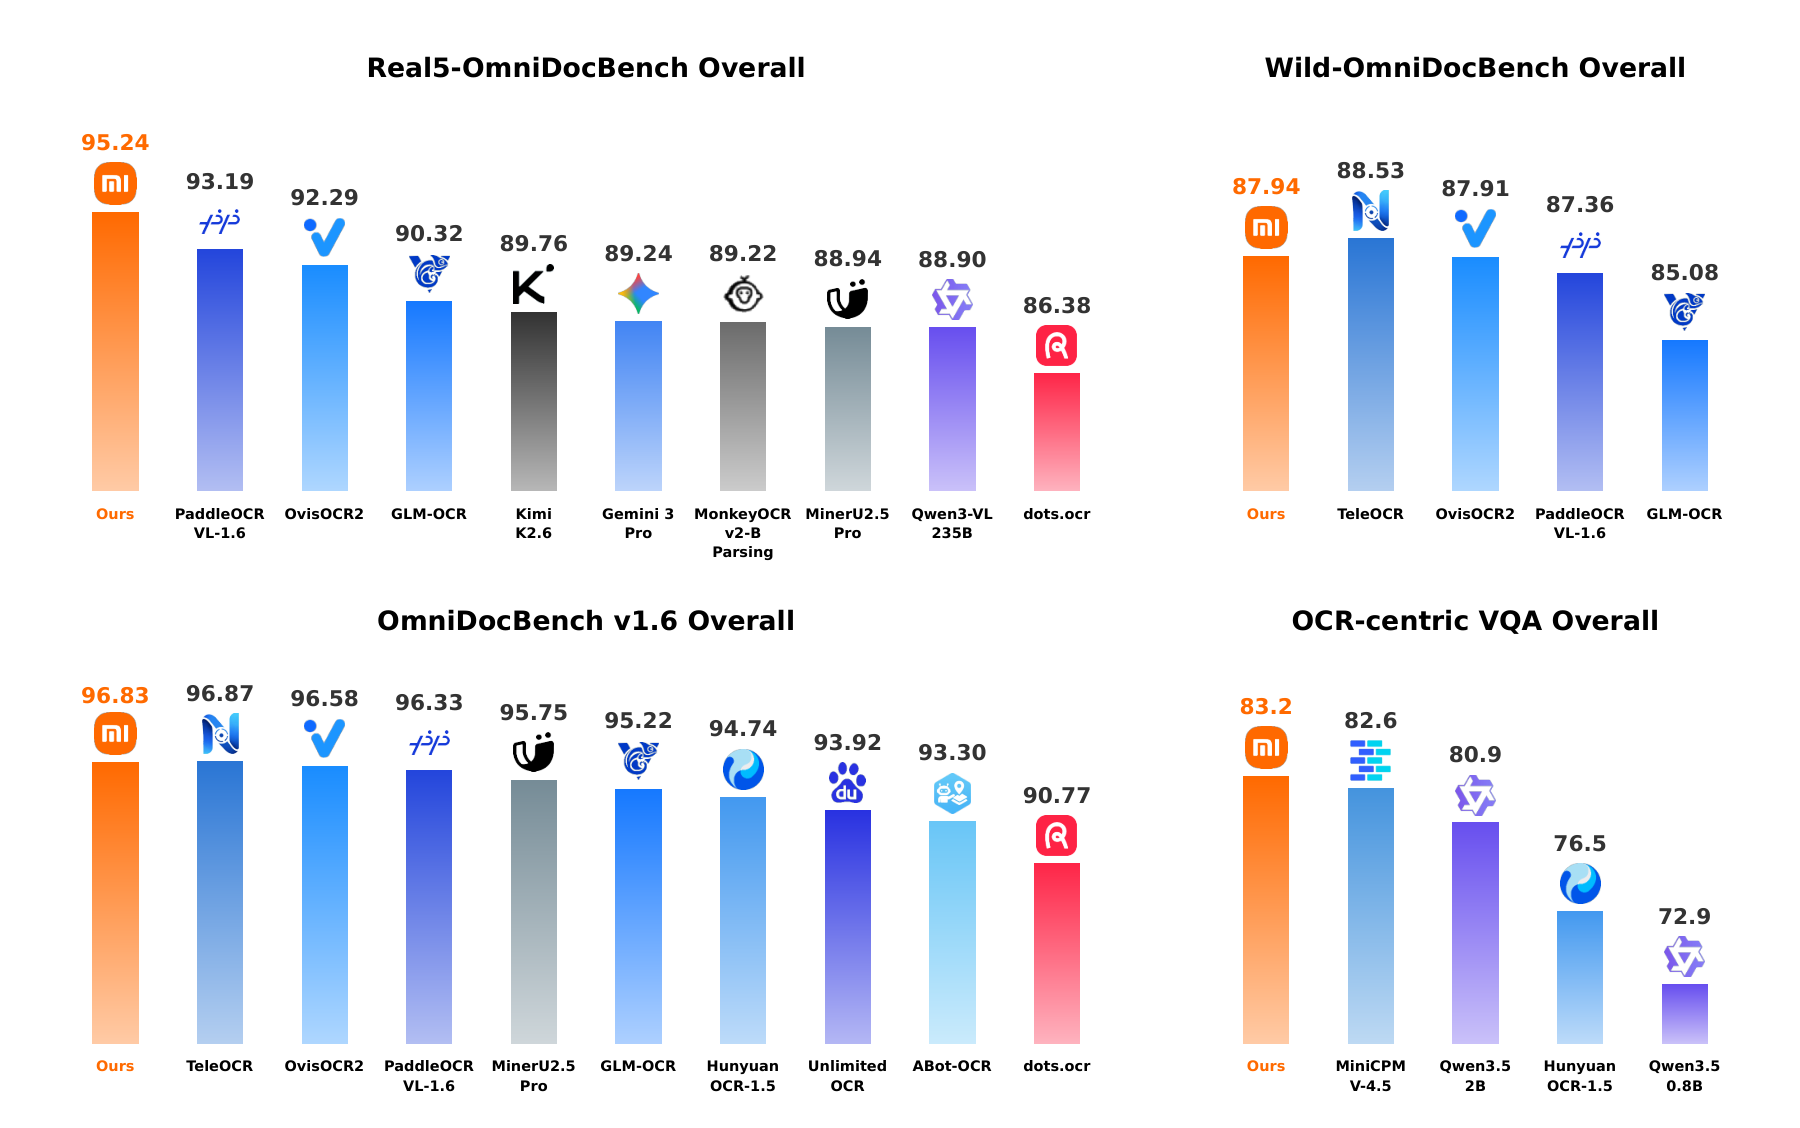
| OmniDocBench v1.6 Overall | 96.83 (Text 0.031, CDM 98.50, TEDS 95.11, RO 0.122) | TeleOCR 96.87 (1.2B) |
| Real5-OmniDocBench Overall | 95.24 (5개 조건 모두 1위) | PaddleOCR-VL-1.6 93.19 |
| Wild-OmniDocBench Overall | 87.94 (RO 0.1931로 최저) | TeleOCR 88.53 |
| PubTabNet TEDS | 92.27 | Infinity-Parser-7B 91.82 |
| UniMER-Test Overall | 97.84 | Qwen3.5-A17B 97.80 |
| Chronicles-OCR 성숙 서체 평균 | 0.73 | HunyuanOCR-1.5 0.79, Seed2.0 Pro 0.72 |
| OCR-VQA 5종 평균 | 83.2 | Qwen3.5-4B 84.9, Qwen3.5-2B 80.9 |
| 자체 KIE 정확도 | 59.09% | Qwen3.5-2B 51.60% |
v1.6에서 TeleOCR에 0.04점 뒤지지만 수식 CDM 98.50은 표 안에서 최고다. 저자들은 이를 데이터 엔진이 CDM 기반 합의와 렌더 교정을 썼기 때문일 수 있다고, 즉 주석 방식이 모델의 강점 분포를 정한다고 스스로 적는다. Real5(OmniDocBench v1.5 페이지를 스캔·휨·화면 촬영·조명·기울임으로 재촬영한 6,775장)에서는 2위와 2.05점, 휨 조건에서 2.98점 차이다. 반면 VQA는 4B 범용 모델에 1.7점 뒤지고, KIE의 주소 추출(45.93%)과 송장(65.00%, Qwen3.5-2B는 77.00%)은 저자들도 미해결로 남겨 두었다.
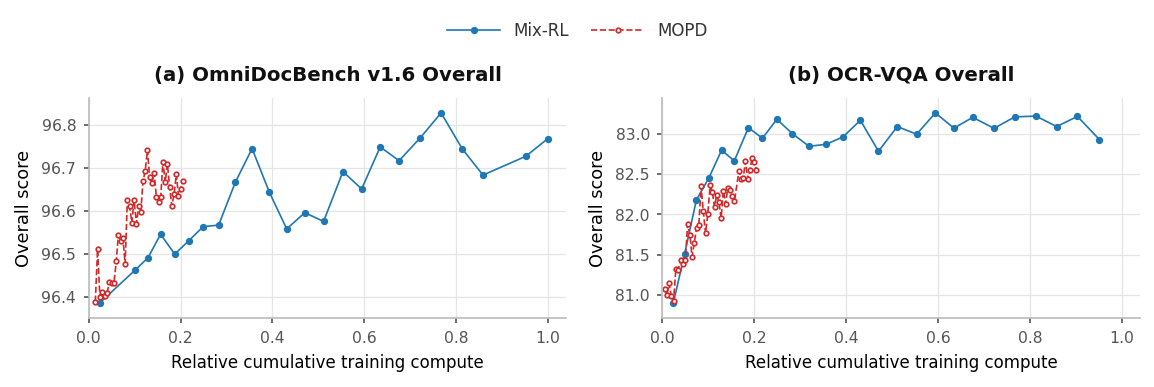
분석 절의 세 결론이 수치로 뒷받침된다. 첫째, 이해 데이터는 파싱이 익은 뒤에야 도움이 된다. 파싱 데이터 9%만 쓴 초기 단계에 OCR-VQA를 섞으면 Overall 93.594→93.264(−0.33)로 전 지표가 나빠지지만, 29% 단계에서는 94.941→95.580(+0.64), 50% 단계에서도 소폭 플러스다. 둘째, 용량은 파싱보다 이해에서 더 필요하다. 같은 과제 데이터로 학습한 4B 전용 교사와 0.8B Mix-RL 학생의 차이가 파싱에서는 0.15점(96.97 대 96.83), 이해에서는 4.9점(88.1 대 83.2)이다. 셋째, 다중 교사 on-policy 증류(MOPD)는 적은 계산으로 96.74에 빨리 닿지만, 더 길게 돌린 Mix-RL이 96.83과 83.2로 둘 다 높다. 그림 6에서 MOPD는 점수가 흔들리기 시작한 지점에서 중단했다.
🔍 세 모델 나란히 놓기: MinerU2.5 · Unlimited OCR · Xiaomi-OCR-0
세 논문이 각자 보고한 숫자만 모은 표다. OmniDocBench 버전이 다르면 비교하면 안 된다. 특히 읽기 순서 edit는 v1.5와 v1.6의 값 범위가 다르다(Unlimited OCR 자체가 v1.5에서 0.045, v1.6에서 0.129).
| MinerU2.5 (2025.09) | Unlimited OCR (2026.06) | Xiaomi-OCR-0 (2026.09) | |
|---|---|---|---|
| 파라미터 | 1.2B | 3B MoE, 활성 0.5B | 0.8B + 외부 PP-DocLayoutV3 |
| 베이스 | 자체 (Qwen2-Instruct 0.5B + NaViT) | DeepSeek-OCR | Qwen3.5-0.8B |
| 추론 구조 | 2단계(썸네일 레이아웃 → crop 인식) | end-to-end, 멀티페이지 one-shot | 2단계(외부 검출 → crop 인식), 전체 페이지 모드도 지원 |
| 핵심 기여 | 해상도 분리, IMIC 데이터 엔진 | R-SWA, 상수 KV 캐시 | ETC+렌더 검증 데이터 엔진, Mix-RL |
| 학습 데이터 | 자체 데이터 엔진 | 약 200만 샘플(멀티페이지 20만 합성) | 약 1억 7천만 샘플 |
| OmniDocBench v1.5 Overall | 90.67 | 93.23 | 보고 없음 |
| OmniDocBench v1.6 Overall | 보고 없음 | 93.92 | 96.83 |
| 긴 문서 | 페이지 단위 | 40+페이지 edit 0.107 | 보고 없음 |
| 이해(VQA/KIE) | 없음 | 없음 | VQA 83.2, KIE 59.09% |
| 라이선스 | AGPL-3.0(HF 모델 카드 기준) | MIT | Apache-2.0 |
읽을 때 두 가지를 겹쳐 보면 재미있다. 첫째, Xiaomi 논문의 Table 1에는 Unlimited OCR(93.92)과 MinerU2.5-Pro(95.75)가 함께 올라 있고, Table 2에는 MinerU2.5가 Real5에서 85.61, Chronicles-OCR 고서체에서는 Unlimited OCR가 0.21로 전문 모델 중 최하위다. 즉 **R-SWA로 얻은 단일 페이지 점수는 "DeepSeek-OCR 계열 안에서의 SOTA"**이고, 데이터를 쏟아부은 0.8B 모델들과는 3점 차이가 난다. 둘째, 샤오미의 2단계 추론은 MinerU2.5가 1년 전 보여준 "레이아웃은 따로, 인식은 crop에서"의 연장선이다. 차이는 MinerU2.5가 레이아웃을 같은 VLM의 1단계로 흡수한 반면 샤오미는 PaddleOCR 생태계의 외부 검출기를 그대로 쓴다는 점이다.
🧐 비판적으로 읽기
"Unlimited"는 아직 아니다. 저자들이 7절에 먼저 적었다. 출력 쪽 캐시는 상수지만 prefill 은 페이지 수에 비례하고, 학습 길이가 32K라 그 안에서만 돈다. 페이지당 256토큰이면 32K 컨텍스트에 100페이지가 간신히 들어가고, 그 전에 출력 10만 토큰이 32K를 넘는다. 실제 Table 3도 40+페이지에서 멈춘다. 후속작 Unlimited OCR 2(10월 27일 공개, arXiv 2610.39308)가 참조 토큰 쪽도 고정 용량(512)으로 희소화하는 SR-SWA로 이 문제를 겨냥하고 백 페이지 벤치마크 MarathonDocBench를 냈는데, 이 글의 범위 밖이다.
멀티페이지 벤치마크가 자체 제작이다. 2~40+페이지 테스트셋은 "소설·문서·논문, 분류당 10권 이상"이라는 설명이 전부이고 공개 여부도 논문에 없다. 지표도 Distinct-n과 edit distance뿐이라 표·수식·읽기 순서가 페이지를 넘어갈 때 어떻게 되는지는 모른다. 멀티페이지 학습 데이터가 단일 페이지를 이어 붙인 합성이라는 점도, 페이지 간 문맥을 실제로 쓰는지 아니면 그냥 연속 파싱인지 구분하기 어렵게 만든다.
R-SWA 윈도 128의 ablation이 없다. 단일 페이지에서 "손실 없음"은 베이스라인 대비 개선으로 보였지만, 윈도 폭을 바꿨을 때, 또는 같은 데이터로 full attention을 계속 학습했을 때와의 비교가 없다. 6.22점 개선 중 얼마가 R-SWA이고 얼마가 200만 샘플 추가 학습인지 분리되지 않는다.
Xiaomi-OCR-0의 0.8B는 시스템 크기가 아니다. 주요 점수는 PP-DocLayoutV3를 붙인 2단계이고, end-to-end 전체 페이지 모드의 OmniDocBench 수치는 논문 본문에 없다(저장소의 evaluation_pipeline이 e2e 모드도 제공한다고는 적혀 있다). 또 전문가 풀에 비교 대상 모델들이 들어 있어, 의사 라벨의 상한이 그 모델들의 합의에 묶인다. 저자들이 수식 강점을 데이터 엔진의 편향으로 해석한 것은 솔직하지만, 같은 논리로 약점도 전문가 풀에서 왔을 수 있다.
KIE와 멀티페이지는 각각 자체 벤치마크다. 샤오미의 KIE 1,655장(신분증·여권·항공권·주소)은 공개되지 않았고, 비교군도 Qwen3.5와 GLM-OCR, dots.ocr 넷뿐이다. Real5와 Wild는 공개 벤치마크지만 둘 다 2026년 등장한 것이라 비교 모델이 최신 소형 OCR VLM에 치우친다.
두 논문은 서로를 보완하지만 합쳐지지 않았다. Xiaomi-OCR-0는 긴 문서를 다루지 않고(README의 SGLang 예시는 컨텍스트 16K), Unlimited OCR은 이해 과제가 없다. R-SWA는 디코더 어텐션 교체라 원리상 어떤 OCR VLM에도 붙일 수 있는데, 0.8B급 고정확도 모델에 붙였을 때도 "손실 없음"이 유지되는지는 열린 질문이다.
💡 정리
Unlimited OCR Works는 "디코더의 KV 캐시를 상수로 묶어도 OCR은 망가지지 않는다"를 보였다. 비전 토큰은 정적 참조로 남기고 출력 윈도 128만 밀고 가는 R-SWA는 사람이 책을 베끼는 방식과 닮았고, 그 결과 커널 시간이 평평해지며 40페이지를 한 번에 읽는다. Xiaomi-OCR-0는 "0.8B에 좋은 라벨 1억 7천만 개와 검증 가능한 보상을 주면 1.2B급 모델과 겨룬다"를 보였고, 이해 데이터가 파싱에 도움이 되려면 파싱이 먼저 익어야 한다는 커리큘럼 단서를 남겼다.
MinerU2.5가 "해상도를 어디에 쓸 것인가"를 물었다면, 두 논문은 각각 "출력 길이를 어떻게 잊을 것인가"와 "라벨을 어떻게 믿을 것인가"를 묻는다. 긴 문서 하나를 표·수식·읽기 순서까지 보존하며 끝까지 읽는 모델은 아직 셋 중 어디에도 없다. 그 자리는 R-SWA 계열의 어텐션과 샤오미식 데이터 엔진이 한 모델에서 만나야 채워질 것으로 보인다.
📚 참고
- Unlimited OCR Works: arXiv:2606.23050 · 코드 github.com/baidu/Unlimited-OCR · 모델 baidu/Unlimited-OCR
- Unlimited OCR Works 2: arXiv:2610.39308
- Xiaomi-OCR-0 Technical Report: arXiv:2609.36136 · 코드 github.com/xiaomi-research/Xiaomi-OCR-0 · 모델 xiaomi-research/Xiaomi-OCR-0
- DeepSeek-OCR: arXiv:2510.18234
- MinerU2.5: arXiv:2509.22186 · 이 블로그의 MinerU2.5 리뷰
- OmniDocBench: arXiv:2412.07626
본 글의 그림은 원문에서 가져왔습니다.