Dust: 역전파 없이 트랜스포머를 사전학습하다
"딥러닝은 40년 동안 backprop 위에서만 돌아갔다. 컴퓨트가 넘쳐나는 시대에도 그래야 할까?"
2026년 10월, Q Labs(Samip Dahal, Bishwas Mandal, Serdar Gülbahar, Akshay Vegesna)가 꽤 도발적인 논문을 냈다. 제목부터 직설적이다. Dust: Pretraining Transformers Without Backpropagation. 역전파(backpropagation) 없이, 오직 순전파와 노이즈, 그리고 "손실이 얼마나 줄었나"라는 보상만으로 GPT 스타일 트랜스포머를 처음부터(from scratch) 학습시켰다는 내용이다.
파인튜닝 수준에서 역전파 없는 학습(MeZO 등)은 이미 보고된 적이 있지만, 사전학습(pretraining) 에서 backprop과 맞먹는 zeroth-order 방법은 이번이 처음이라고 저자들은 주장한다. 더 놀라운 건, population을 충분히 키우면 일부 설정에서 backprop보다 낮은 loss 에 도달한다는 점이다.
원문: https://qlabs.sh/research/dust
🤔 왜 backprop을 버리려 할까?
1986년 Rumelhart, Hinton, Williams 이후 신경망 학습은 사실상 backprop 하나였다. 아키텍처, 옵티마이저, 심지어 GPU 하드웨어까지 전부 backprop을 중심으로 공진화해 왔다.
그런데 backprop에는 두 가지 전제가 깔려 있다.
- 미분 가능해야 한다. 네트워크가 end-to-end로 미분 가능하지 않으면 쓸 수 없다.
- 1차 기울기만 준다. 손실 지형(loss landscape)의 곡률 같은 고차 정보는 보지 못한다.
저자들은 여기서 Bitter Lesson 을 꺼낸다. 사람의 지식(귀납 편향)을 넣은 방법은 초반엔 효율적이지만, 컴퓨트가 충분해지면 범용적인 탐색(search) 기반 방법이 결국 이긴다는 교훈이다. AlphaGo Zero가 인간 기보로 부트스트랩한 버전을 결국 추월한 것처럼, "미분 가능성 + backprop"도 저컴퓨트 시대의 편향일 뿐일 수 있다는 것이다.
그래서 이 논문의 목표는 명확하다. 분석적 구조(chain rule)에 덜 의존하고, 무식한 계산(brute-force search)에 더 의존하는 학습 알고리즘을 만들어, 가장 어려운 과제인 트랜스포머 사전학습에서 backprop과 겨뤄 보는 것.
🧠 핵심 아이디어: 가중치가 아니라 활성값을 흔든다
기존 ES의 병목: population
Evolution Strategies(ES)는 가중치에 노이즈를 더한 복사본을 여러 개(population) 만들어 각각 평가하고, 잘한 복사본 쪽으로 가중치를 옮기는 방식이다. 문제는 population 하나당 forward pass 하나가 필요하다는 것. 최신 방법인 EGGROLL은 low-rank 섭동으로 복사본 생성 비용을 줄였지만, 여전히 배치의 시퀀스 하나가 population 하나다. population을 키우려면 forward pass를 그만큼 더 돌려야 한다.
Dust의 해법: 가상 개체군(virtual population)
Dust는 가중치 공간을 아예 건너뛴다. 대신 각 선형 레이어의 출력(활성값)에, 토큰마다 독립적으로 가우시안 노이즈를 더한다.
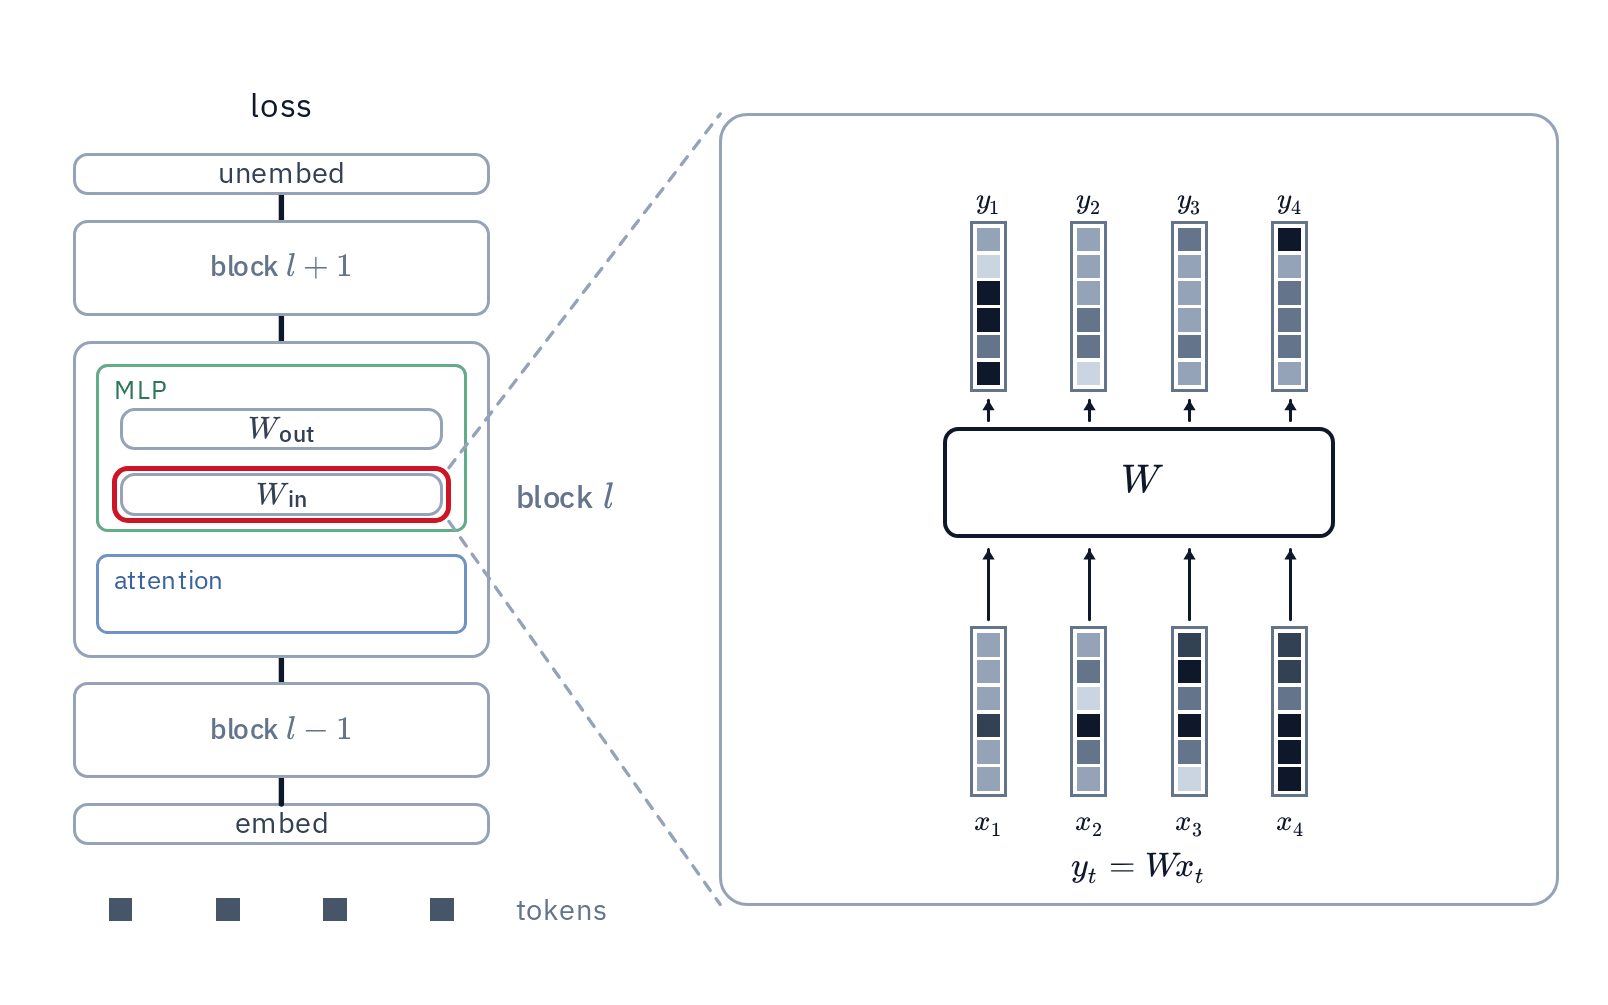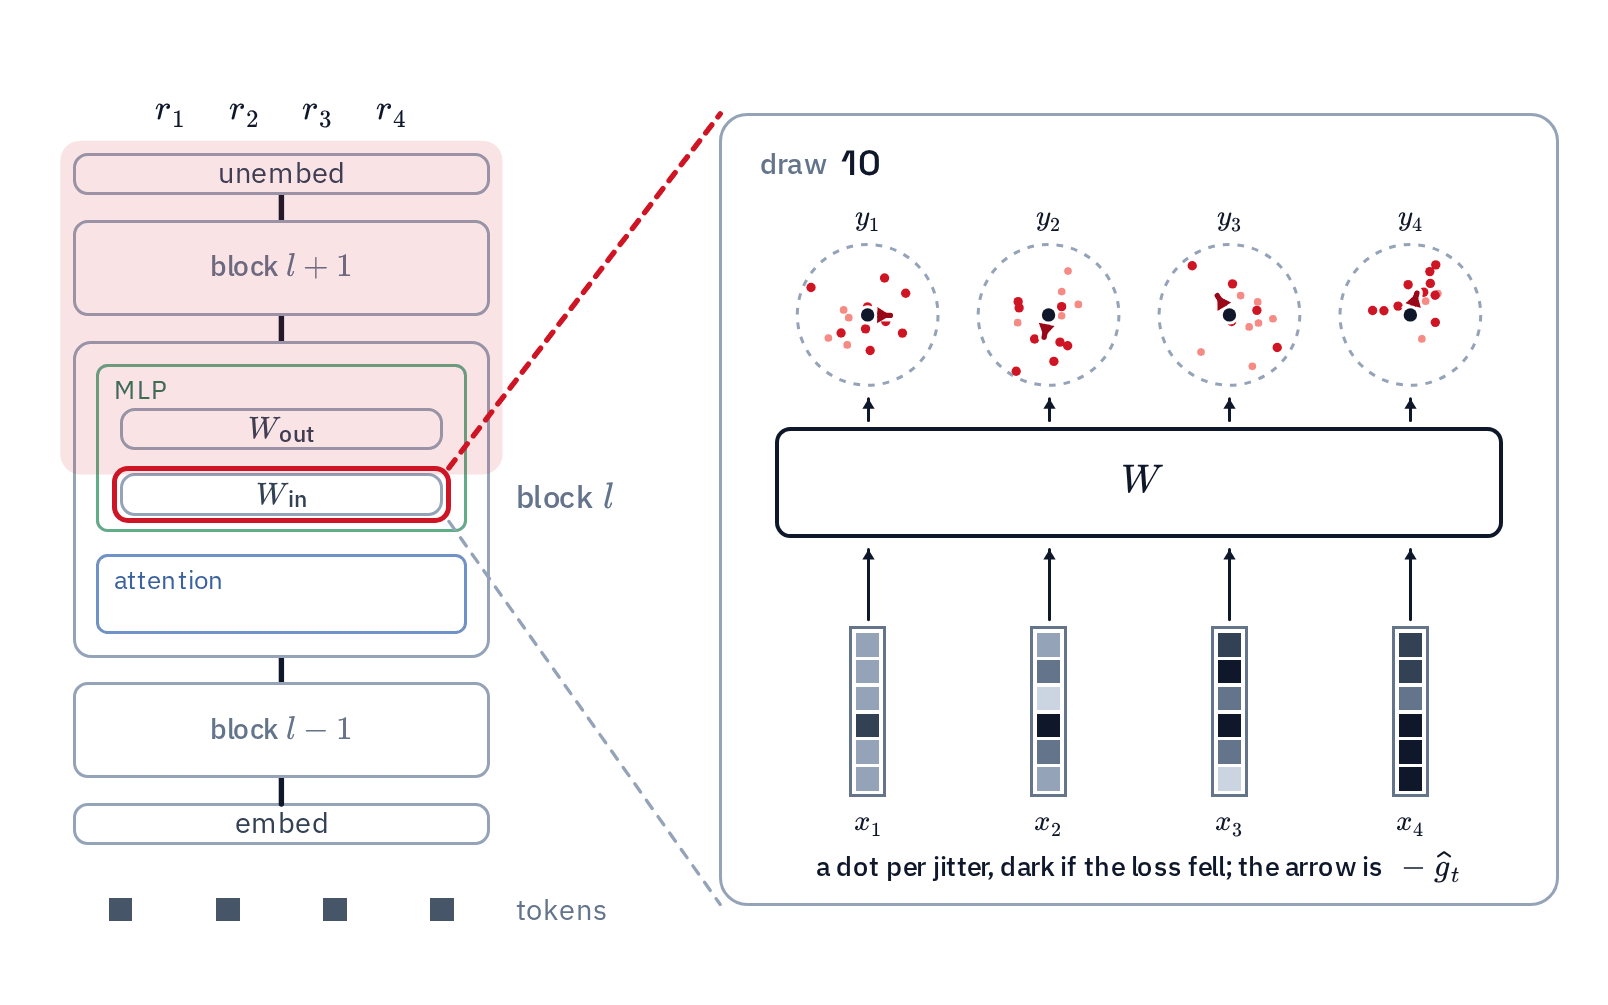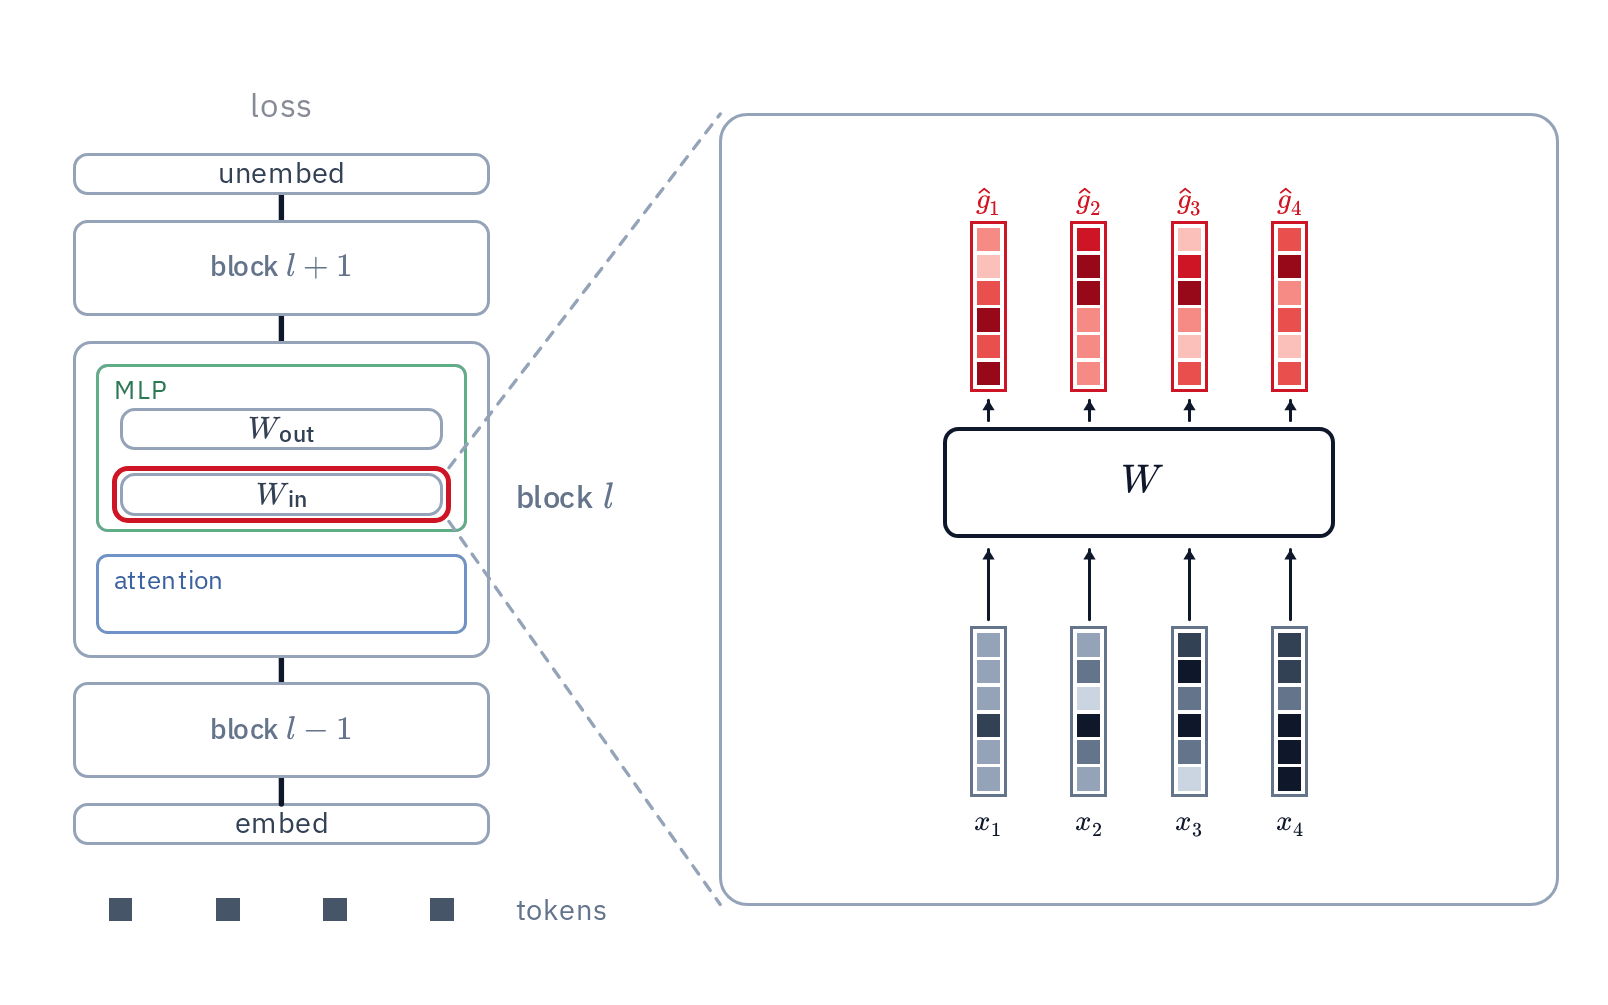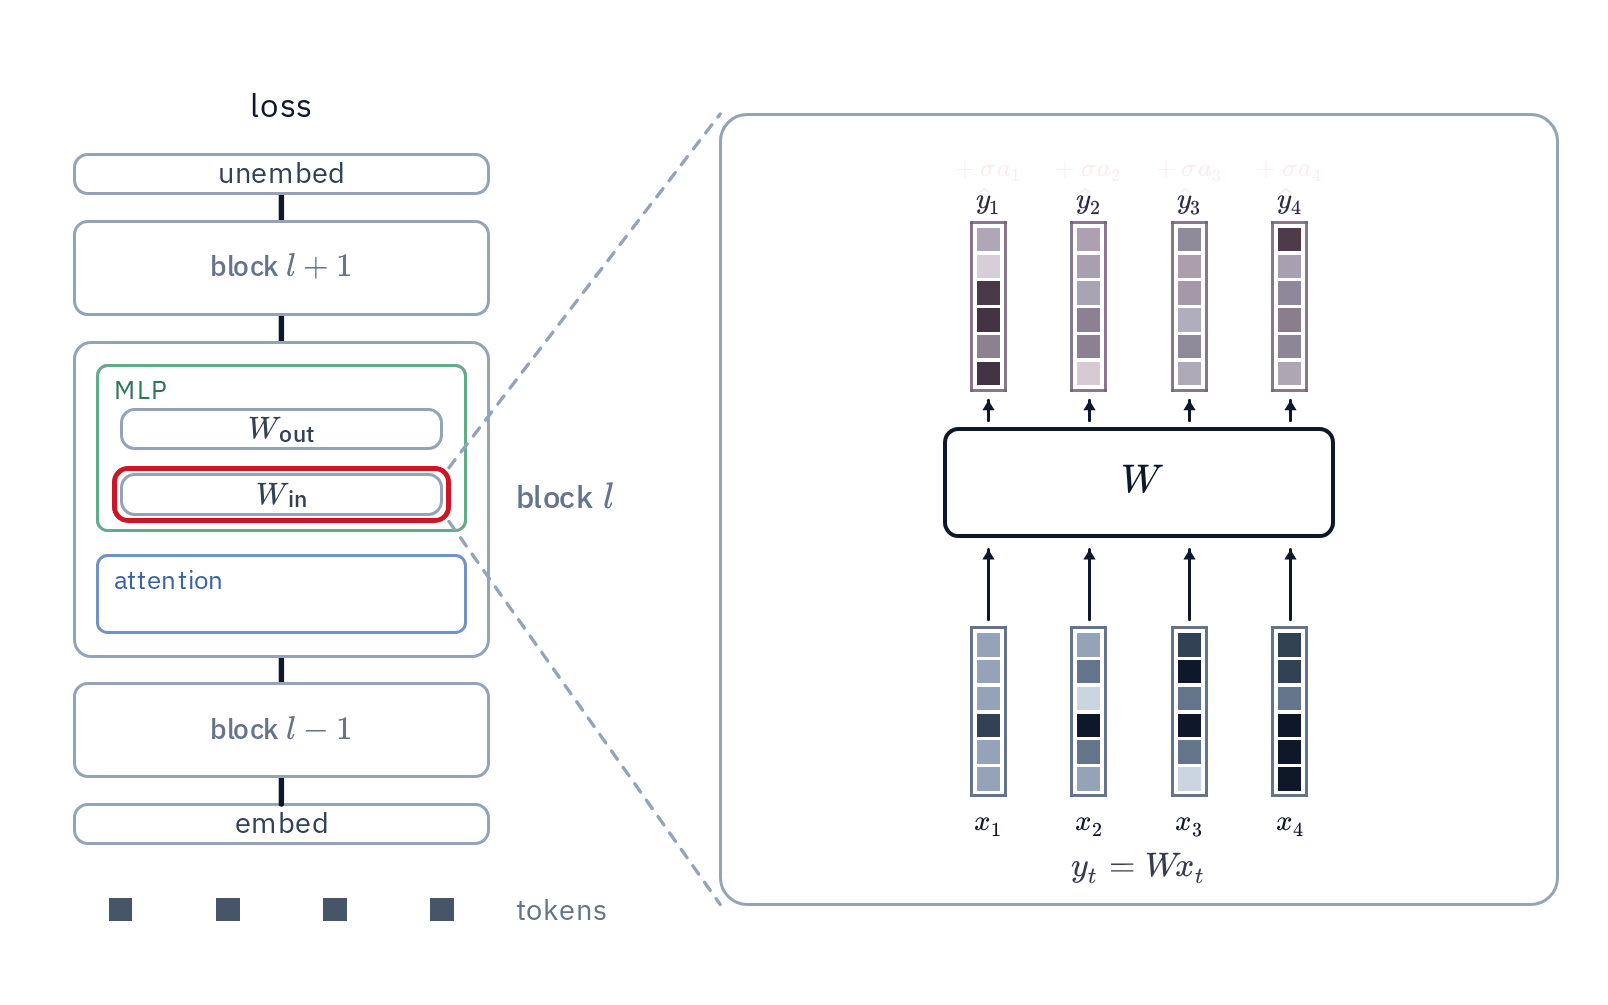
어떤 토큰 에서 활성값에 노이즈를 더하면, 그 토큰 입장에서는 마치 그 레이어의 가중치에 low-rank 섭동이 가해진 것과 똑같이 동작한다. 그런데 실제로 가중치를 건드린 적은 없다. 즉, 토큰 하나가 population 멤버 하나가 되는 셈이다.
트랜스포머 시퀀스 하나에 토큰이 수천 개 있으니, forward pass 한 번으로 시퀀스당 수천 명의 "가상 개체"를 동시에 평가하는 꼴이다. 저자들은 이걸 EGGROLL이 쓰는 배치 축에 직교하는, 토큰 축을 따라 생긴 새로운 population 이라고 표현한다. 현대 트랜스포머에서는 forward 한 번당 가중치 공간 ES보다 최소 3자릿수 더 큰 population 을 평가하게 된다.
참고로 활성값에 노이즈를 주는 것 자체는 1990년대 node perturbation이라는 오래된 아이디어다. Dust의 기여는 이를 토큰 단위 독립 섭동 + 토큰 단위 보상으로 트랜스포머에 맞게 재구성하고, 실제로 사전학습이 되게 만든 것이다.
📐 신용 할당(credit assignment): 보상에서 기울기까지
수식은 생각보다 단순하다. 선형 레이어 의 출력에 노이즈를 더한다.
forward를 돌린 뒤, 각 토큰 에서 중심화된 손실 감소량 를 계산한다. (는 섭동된 손실, 는 같은 배치 안 여러 draw의 평균 섭동 손실)
토큰 의 노이즈가 받는 보상은 자기 토큰의 손실 감소량에 더해, attention을 통해 영향을 미친 이후 토큰들의 손실 감소량을 감쇠율 로 할인해 합한 값이다.
이제 번의 draw에 대해 보상 가중 노이즈를 평균내면, 그게 바로 레이어 출력에서의 오차 추정치 가 된다.
그리고 이 출력 오차와 레이어 입력의 외적을 토큰에 대해 합하면 가중치 기울기다.
여기서 눈여겨볼 점이 있다. backprop도 정확히 같은 외적을 만든다. 유일한 차이는 출력 오차 를 어디서 얻느냐다. backprop은 chain rule에서, Dust는 population 평균에서 얻는다. 그래서 Dust를 "backprop의 backward pass만 탐색으로 갈아끼운 것"이라고 이해해도 크게 틀리지 않다.
draw 수가 늘어날수록 기울기 성분은 선형으로 쌓이고 오차 성분은 제곱근으로만 쌓이므로, population이 커지면 추정치는 점점 깨끗해진다.
간섭(interference) 줄이기
현실에서는 population이 무한하지 않다. 여러 레이어, 여러 토큰을 같은 forward에서 동시에 흔들면 한 토큰의 보상에 다른 섭동의 효과가 섞여 들어온다. 저자들은 세 가지 장치로 이를 줄인다.
- 레이어 타입별로 별도 forward. 블록마다, 레이어 타입마다 따로 흔들고 각자 노이즈 스케일을 가진다. clean forward는 캐시되어 있어서 블록 을 흔드는 draw는 이후 블록만 다시 계산하면 된다.
- attention 내부(Q, K, V, gate)는 따로 처리. 이들의 섭동은 토큰 손실에 거의 안 잡힌다. 대신 attention 출력에서 추정된 오차 와 섭동으로 인한 출력 변화 의 정렬도 로 보상한다.
- LM head는 캐시된 logit 위에서 직접 흔든다. cross-entropy만 다시 계산하고 어휘의 일부 슬랩만 보기 때문에 forward 비용의 극히 일부로 훨씬 큰 population을 돌릴 수 있다.
하이퍼파라미터(레이어별 노이즈 스케일, , population 배분)는 작은 토큰 예산으로 grid search 하거나, backprop 기울기와의 코사인 유사도를 최대화 하는 방식으로 학습 없이 튜닝한다. 튜닝 결과는 대체로 토큰 예산과 population에 걸쳐 일반화되었고, 예상대로 K, V, gate처럼 이후 토큰이 읽어가는 레이어만 을 가졌다.
📊 실험 결과: backprop과 어깨를 나란히
설정
- GPT 스타일 트랜스포머, FineWeb, 4096 BPE 토크나이저
- 배치 16k 토큰(2048 토큰 시퀀스 8개), 1 epoch, SGD + momentum
- 기본 모델은 8 layer, width 512
- 비교군: backprop, EGGROLL-Transformer(가중치 공간 ES), 모두 같은 프로토콜 + 3 seed
- population: Dust는 draw 수, EGGROLL은 forward pass 수로 센다. population 256부터는 Dust가 EGGROLL보다 컴퓨트를 덜 쓰므로 EGGROLL에 유리한 비교다.
학습 곡선
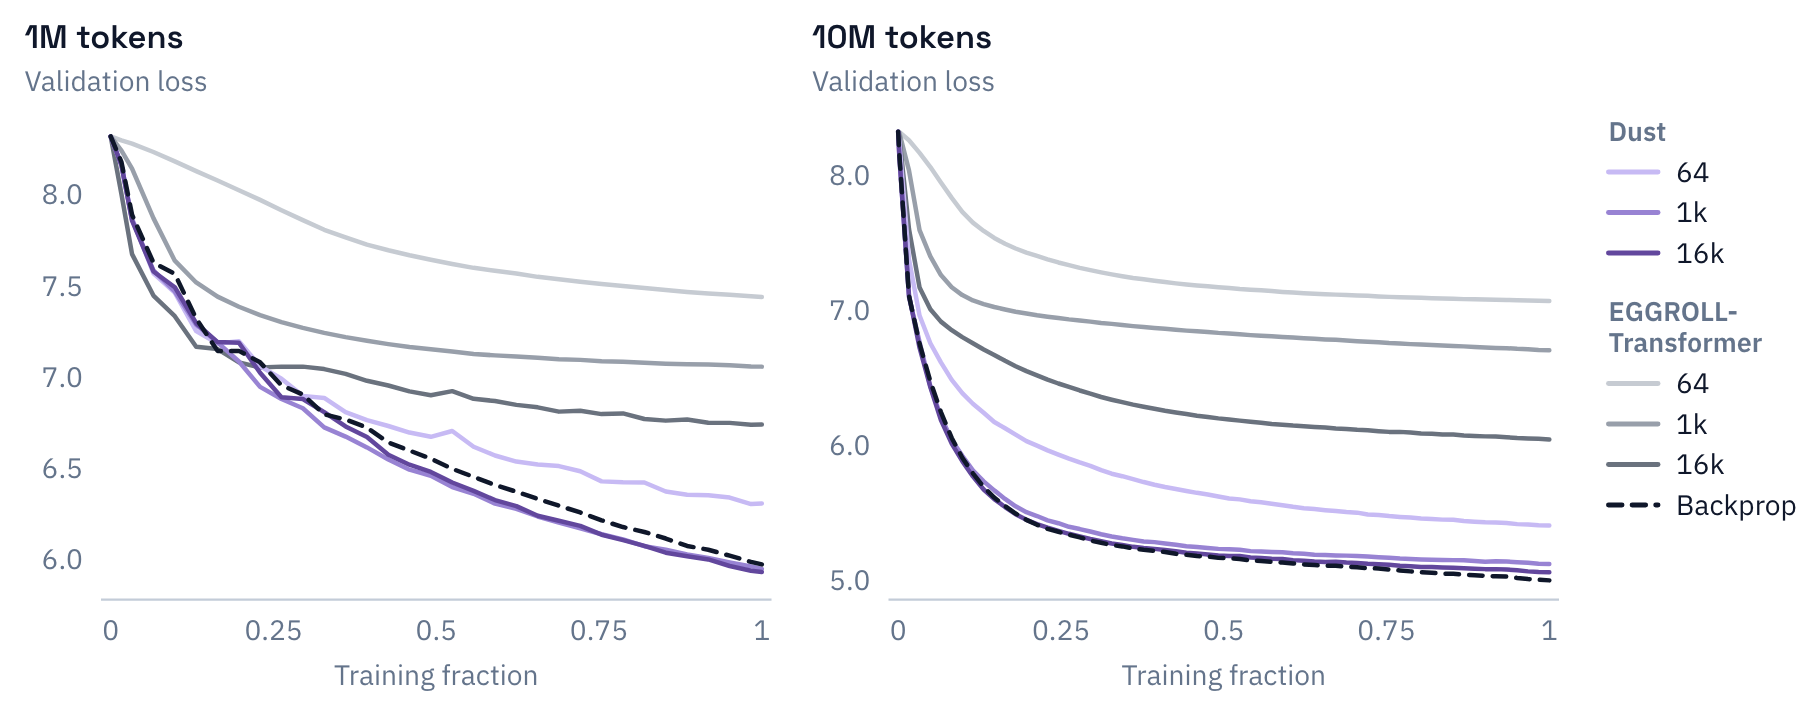
Dust 1k, 16k draw 곡선은 학습 내내 backprop 곡선에 바짝 붙어 간다. 반면 EGGROLL은 population을 16k까지 올려도 Dust의 64 draw조차 따라잡지 못한다.
토큰 예산 × population 스윕
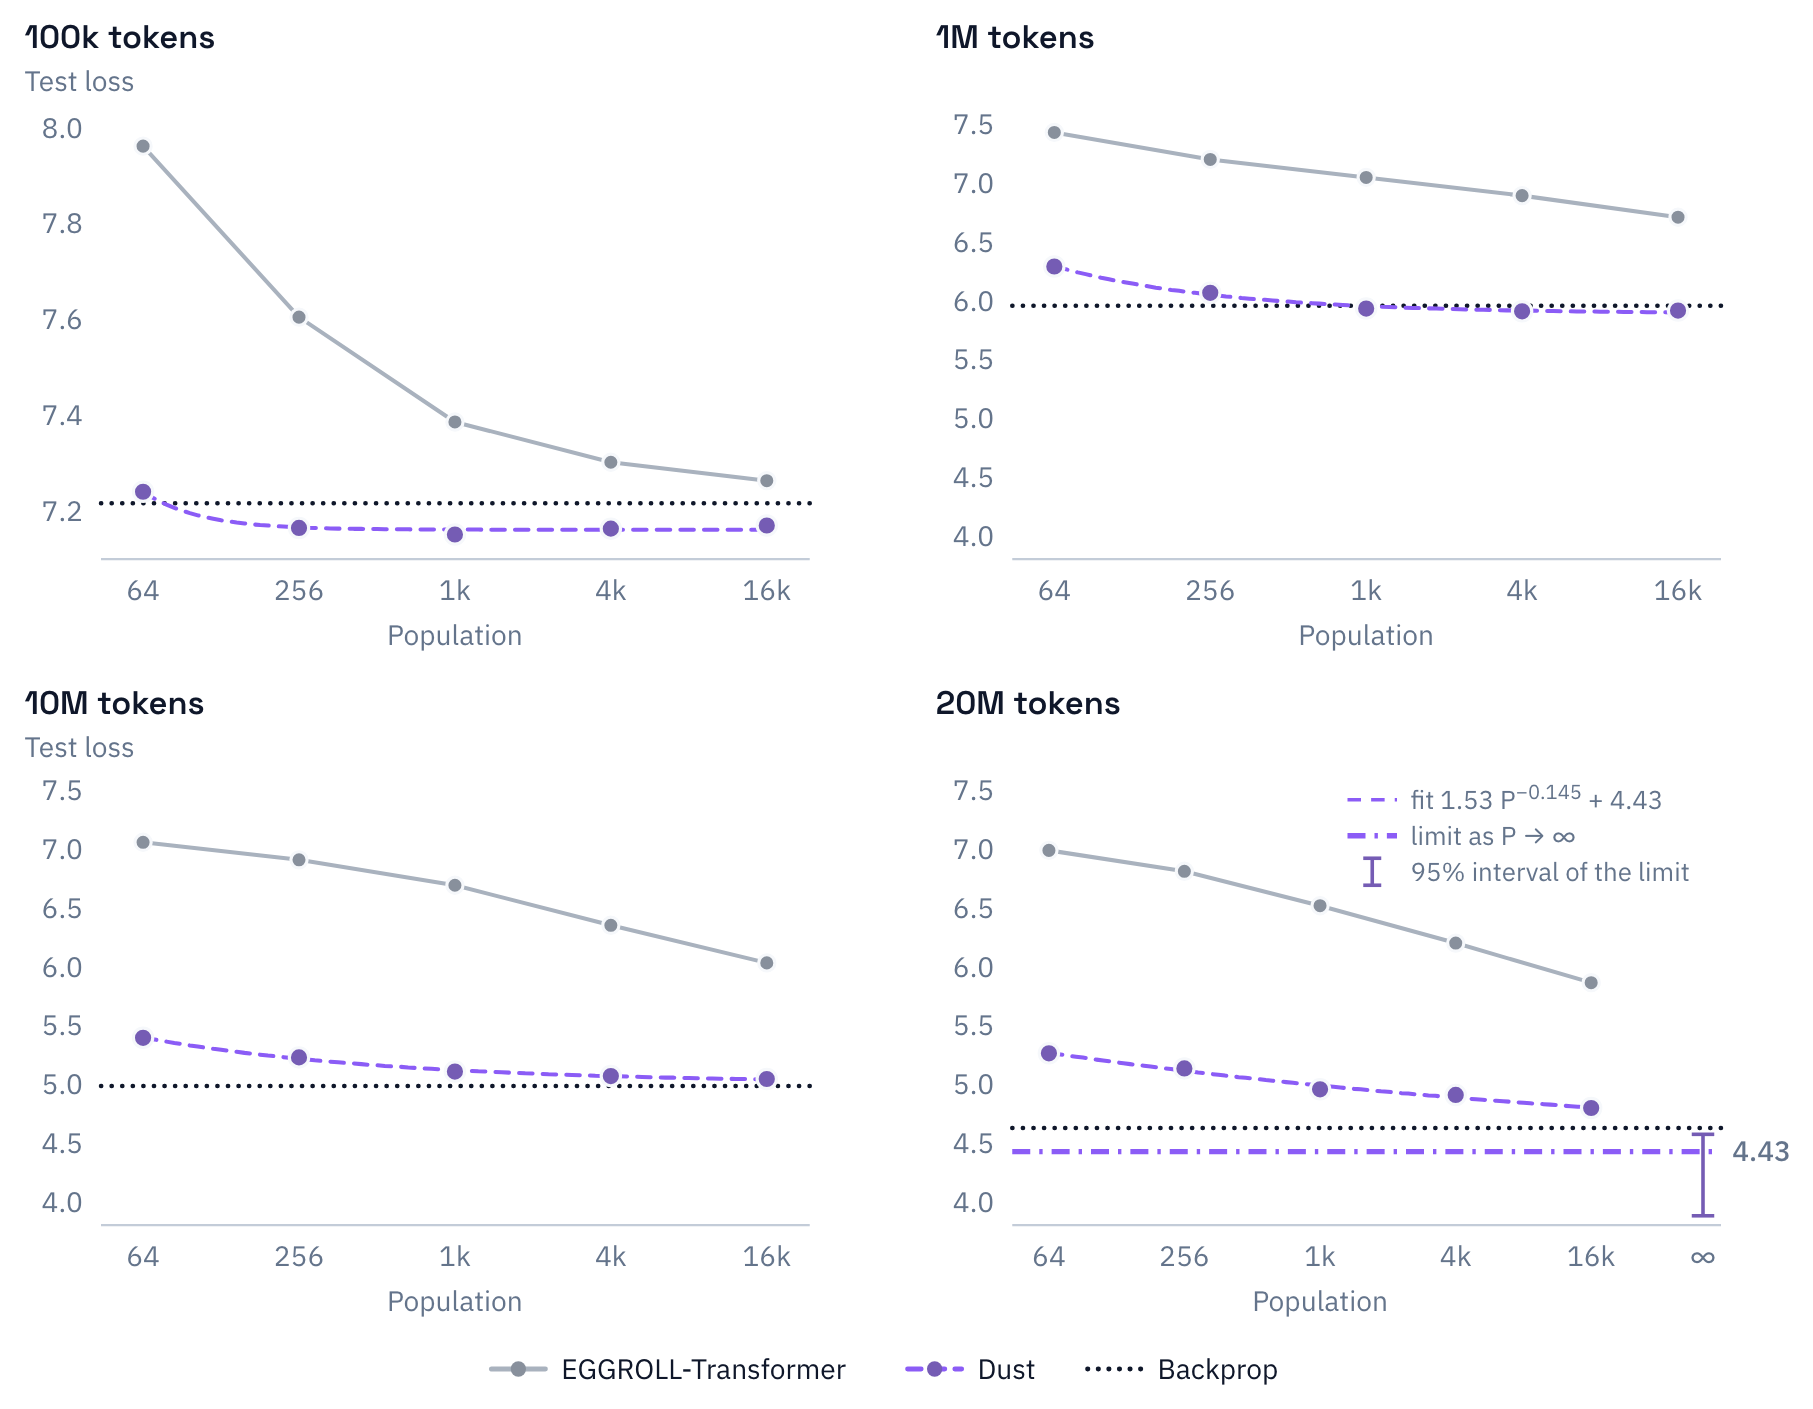
- 100k, 1M 토큰: 수백~1천 draw부터 Dust가 backprop 아래로 내려간다.
- 10M 토큰: 사다리가 평평해졌고 피팅된 극한이 backprop 바로 위에 놓인다.
- 20M 토큰: 16k draw에서도 아직 내려가는 중. power-law 피팅 극한은 4.43(95% 구간 3.89~4.58)으로 backprop 4.63보다 낮지만, 저자들도 "측정된 극한이라기보다 격차가 계속 좁혀진다는 증거" 정도로 조심스럽게 읽는다.
EGGROLL 쪽은 처참하다. 256배 큰 population(16k)으로도 Dust 64 draw에 못 미친다. 외삽해 보면 Dust의 최소 population을 따라잡는 데 수천약 배의 population이 필요하다는 계산이다. TL;DR의 "배 더 효율적"이라는 주장이 여기서 나온다.
Adam에서도 통할까?
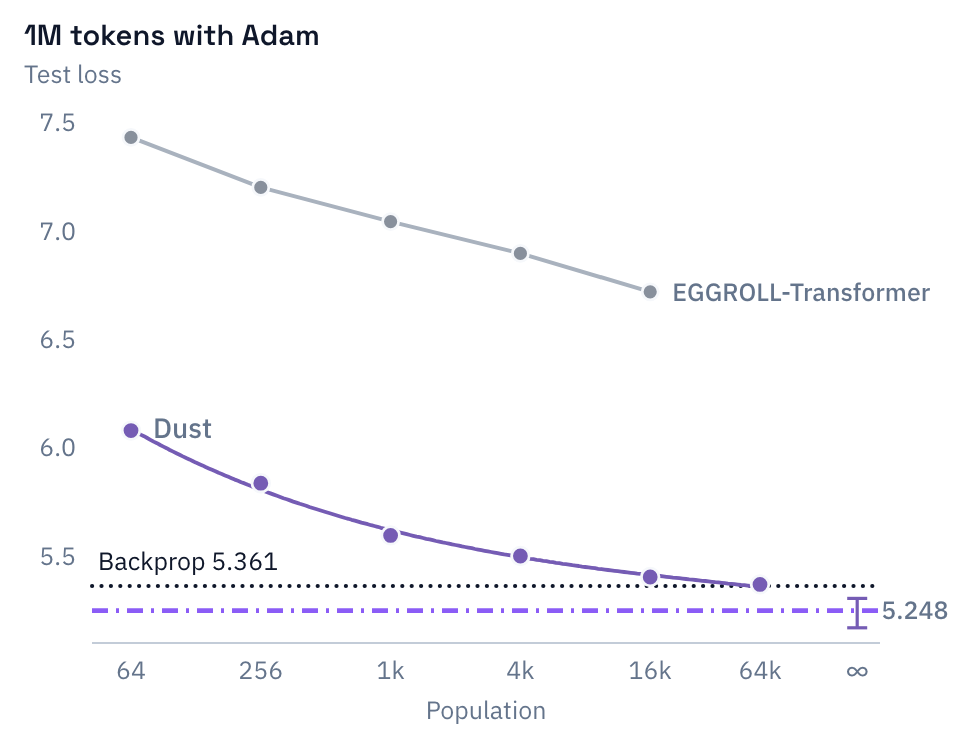
현대 옵티마이저는 전부 backprop 기울기에 맞춰 설계되었다. 그런데도 Adam을 붙이자 Dust와 backprop 둘 다 개선되고 사다리 모양은 그대로였다. 피팅 극한 5.248(구간 5.17~5.30)은 backprop 5.361보다 낮다. 흥미롭게도 EGGROLL은 Adam에서 거의 아무것도 얻지 못했다. 저자들은 Dust에 맞춰 옵티마이저를 공진화시키면 추가 이득이 있을 것으로 본다.
🔍 고차원 탐색에 대한 두 가지 반직관적 발견
1. 큰 모델이 오히려 population 효율이 좋다
통념은 이렇다. "zeroth-order 방법은 forward 한 번에 스칼라 하나만 돌려주니, 차원이 커질수록 분산이 폭발해서 큰 네트워크는 못 훈련한다." 저자들은 이를 2M, 7M, 38M, 243M 파라미터(120배 범위)의 네 모델로 10M 토큰에서 직접 검증했다.
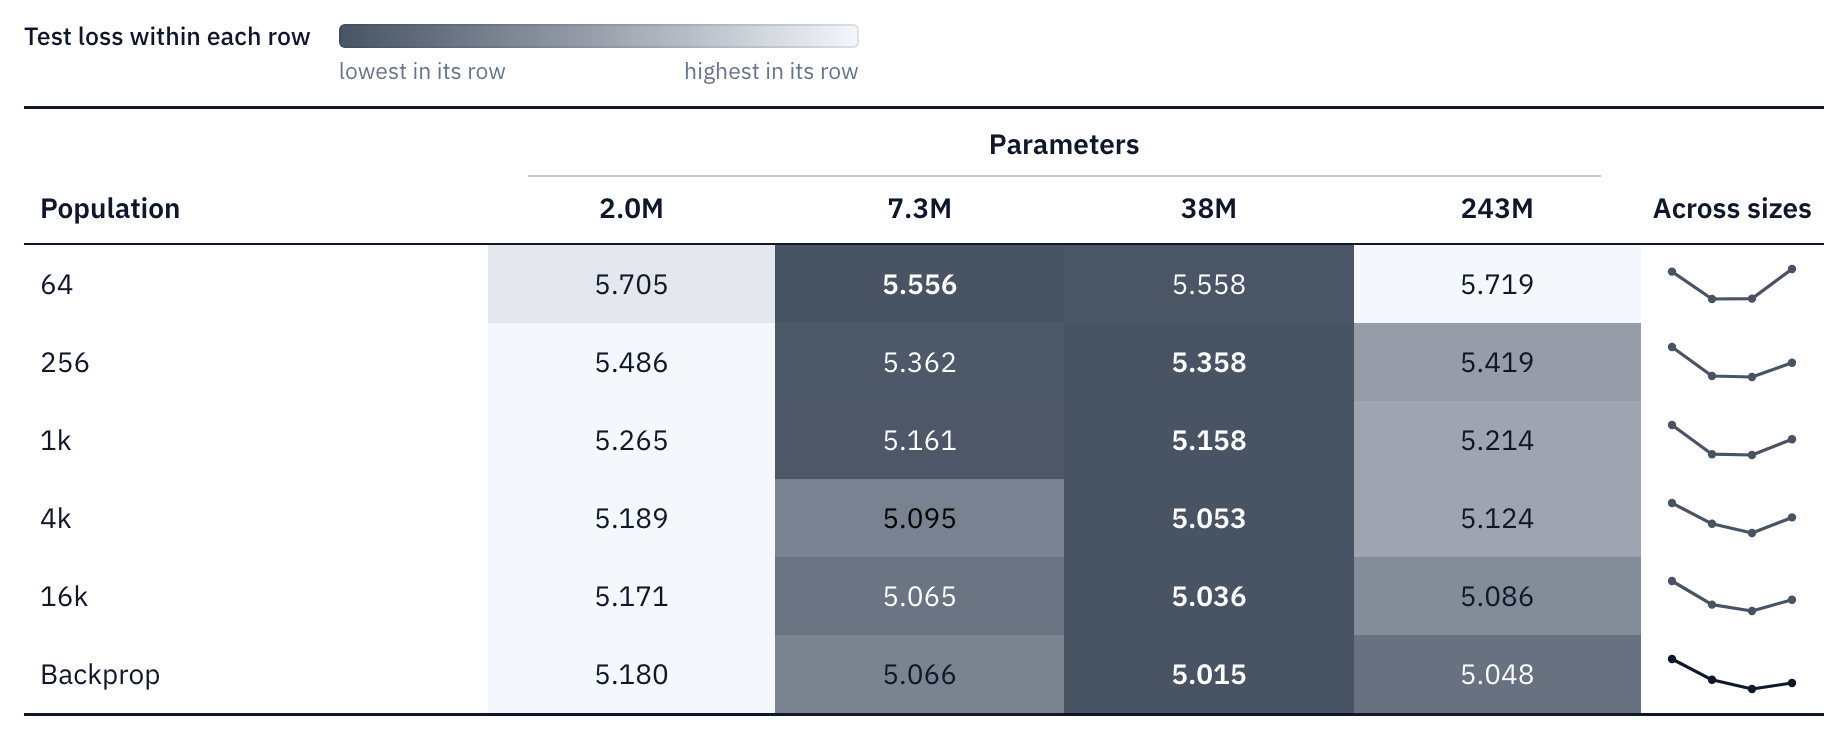
결과는 통념과 반대였다.
- population 256 이상에서는 2M → 7M → 38M 순으로 loss가 떨어진다. 243M은 38M보다 약간만 나쁘다.
- 가장 작은 population 64에서도 120배 큰 모델이 비슷한 수준을 낸다.
- 작은 모델은 일찍 포화되지만 큰 모델은 population을 늘릴수록 계속 좋아진다. 1k draw 이후 38M, 243M 모델의 추가 이득은 2M, 7M보다 약 30% 크다.
저자들의 해석이 재미있다. 모델 크기를 탐색 공간의 크기와 기하(geometry) 로 봐야 한다는 것. 큰 모델은 탐색할 공간이 넓어 큰 population을 활용할 수 있고, 동시에 손실 지형이 더 잘 조건화되어 있어 작은 population에서도 탐색이 더 잘 먹힐 수 있다는 것이다. 과적합이나 분산 문제로만 읽어 온 overparameterization에 대한 새로운 관점이다.
2. backprop과 닮은 기울기가 "저절로" 나타난다
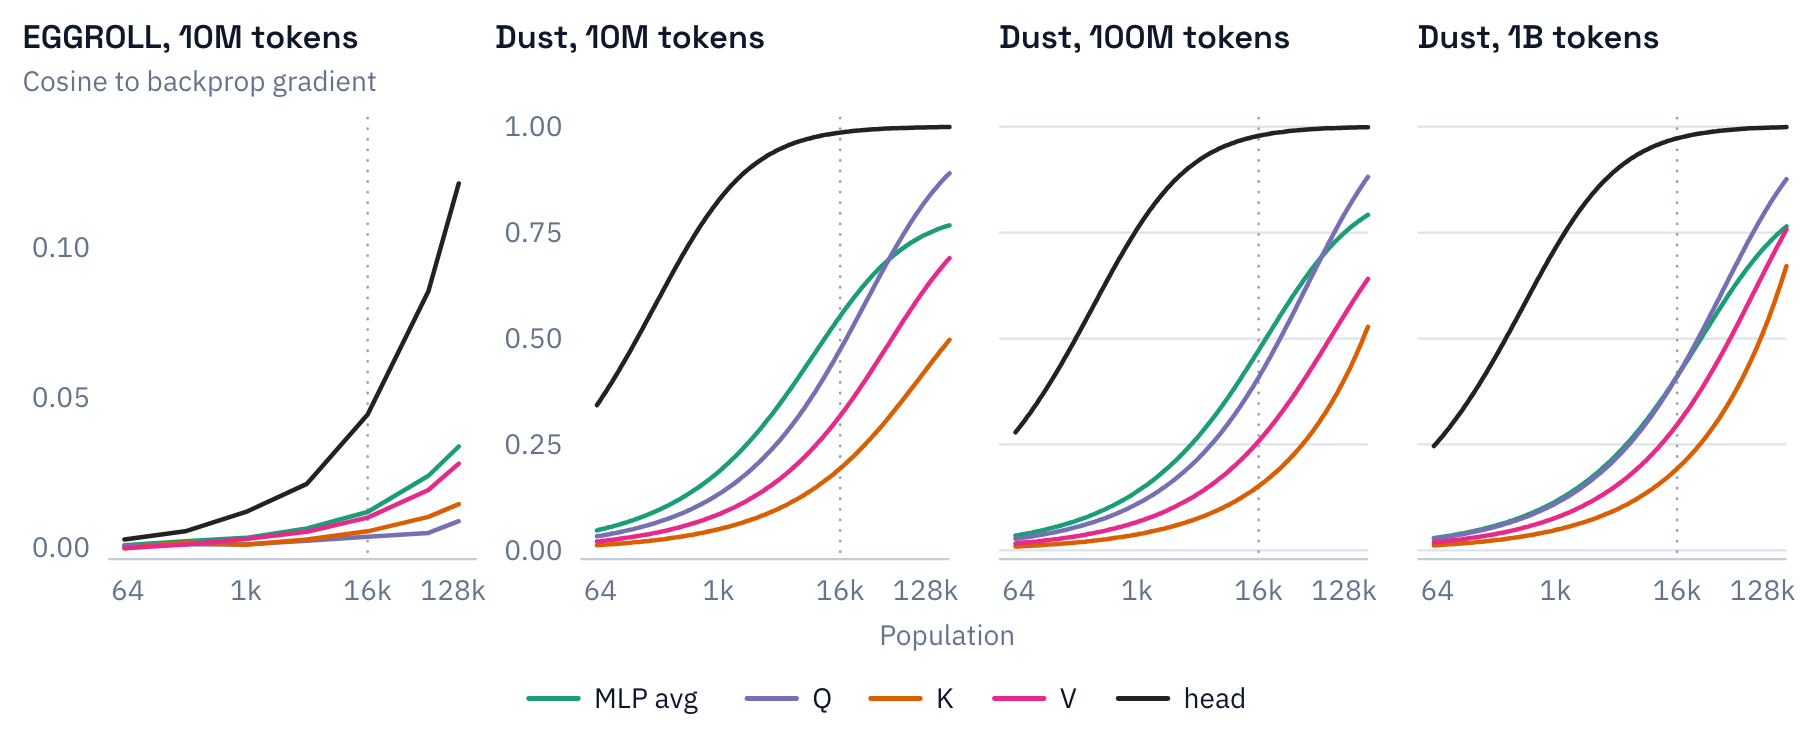
backprop으로 학습한 체크포인트(10M, 100M, 1B 토큰) 위에서 Dust의 추정 기울기와 진짜 backprop 기울기의 코사인 유사도를 쟀다. 결과는 레이어 타입마다 2-파라미터 법칙
으로 RMSE 0.06 이하로 깔끔하게 맞는다. chain rule에 대한 정보는 전혀 넣지 않았는데, population만 키우면 backprop 방향의 기울기가 자연스럽게 떠오른다. EGGROLL은 같은 forward pass 수에서 128k까지 가도 head를 제외하면 코사인 0.05 미만이다. 3.2절에서 EGGROLL이 왜 학습이 안 됐는지 설명해 주는 대목이다.
더 중요한 건 토큰 수가 100배 늘어도 코사인이 거의 변하지 않는다는 점이다. 3절에서는 토큰이 늘수록 backprop을 따라잡는 데 필요한 population이 커졌는데, 충분히 큰 population에서는 이 요구량이 더 이상 늘지 않을 가능성이 있다는 뜻이다. 스케일링에 긍정적인 신호다.
그리고 저자들은 코사인이 1로 수렴하지 않는 것을 오히려 좋은 성질이라고 본다. backprop과 비슷한 방향을 가리키되 정확히 같지는 않으니 최적화 궤적이 달라지고, 실험에서는 그 궤적이 때로 backprop보다 좋았기 때문이다.
💡 정리와 남은 질문
Dust의 기여를 한 줄씩 요약하면 이렇다.
- 트랜스포머 사전학습에서 backprop과 경쟁 가능한 최초의 zeroth-order 방법. 큰 population에서는 여러 설정에서 backprop을 넘어선다.
- 가중치 공간 ES보다 ~배 효율적. 토큰 축을 따라 생기는 가상 개체군 덕분이다.
- 큰 모델이 더 population 효율적이다. overparameterization을 "더 큰 탐색 공간"으로 보는 새로운 관점.
- 기울기 정렬이 1B 토큰까지 유지된다. 스케일링 가능성에 대한 희망적 신호.
저자들이 스스로 밝힌 한계도 분명하다. 컴퓨트 효율은 이 논문의 목표가 아니었다. backprop과 비슷한 loss에 도달하려면 수천~수만 draw가 필요하고, 그건 현재 컴퓨트 수준에서 backprop을 대체하기엔 몇 자릿수 부족하다.
하지만 흥미로운 열린 질문들이 남아 있다.
- Dust가 손실 지형을 암묵적으로 탐색하면서 고차 곡률을 잡아 평평한 영역으로 끌려가는 건지. 큰 population에서 backprop을 넘는 결과가 그 힌트지만 메커니즘은 아직 불명확하다.
- end-to-end 미분 가능성이 필요 없으니 아키텍처 탐색 공간이 열린다. 외부 프로그램을 루프 안에 둔 네트워크나, BPTT가 잘 못 다루는 looped/recurrent 트랜스포머를 학습시킬 수 있을지.
- 활성값 공간에 추론이 산다는 mechanistic interpretability 결과를 감안하면, 이 방식은 잠재 추론(latent reasoning)에 대한 탐색으로 학습을 재해석하는 길이 될 수도 있다.
40년 된 backprop 독점이 당장 깨질 것 같지는 않다. 하지만 "컴퓨트가 충분하면 탐색이 이긴다"는 Bitter Lesson이 학습 알고리즘 자체에도 적용되는지 묻는 첫 진지한 실험이라는 점에서, 이 논문은 충분히 읽어볼 가치가 있다.
📚 참고
- 원문: Dust: Pretraining Transformers Without Backpropagation (Q Labs Research, 2026.10)
- EGGROLL: Evolution strategies at the hyperscale (Sarkar et al., 2025)
- MeZO: Fine-tuning language models with just forward passes (Malladi et al., 2023)
- Node perturbation: Werfel, Xie, Seung (2003); Widrow & Lehr (1990)
- The Bitter Lesson: Richard Sutton, 2019
본 글의 모든 그림은 원문에서 가져왔습니다.