MinerU2.5: 1.2B 파라미터로 문서 파싱 SOTA를 낸 '분리형' VLM
"문서 이미지의 대부분은 여백이다. 그 여백까지 고해상도 토큰으로 바꿔 LLM에 넣을 이유가 있을까?"
2025년 9월, 상하이 AI 연구소(OpenDataLab)가 MinerU2.5: A Decoupled Vision-Language Model for Efficient High-Resolution Document Parsing(arXiv 2509.22186)을 공개했다. 핵심 주장은 단순하다. 1.2B짜리 작은 VLM 하나로 Gemini-2.5 Pro, Qwen2.5-VL-72B 같은 범용 모델과 dots.ocr, MonkeyOCR 같은 전용 모델을 OmniDocBench에서 모두 앞질렀고, 그러면서 처리 속도는 전용 모델 대비 4~7배 빠르다는 것이다.
비결은 모델 크기가 아니라 "무엇을 어느 해상도로 보게 할 것인가"를 분리한 설계다. 레이아웃은 작은 썸네일에서, 내용은 원본 해상도의 crop에서 읽는다. 이 글에서는 그 2단계 구조와 학습 레시피, 벤치마크 수치, 그리고 현재 README 기준 실행 방법까지 정리한다.
이 블로그의 arxiv-graph 프로젝트는 arXiv 논문의 제목과 초록만으로 지식 그래프를 만들었는데, 본문 PDF까지 그래프에 넣으려면 결국 표·수식·읽기 순서를 깨지 않는 파서가 필요하고, MinerU2.5는 정확히 그 자리를 노리는 모델이다.
원문: https://arxiv.org/abs/2509.22186
🤔 배경: 파이프라인과 end-to-end VLM, 둘 다 불편하다
문서 이미지는 자연 이미지와 다르다. 해상도가 훨씬 높고, 내용이 빽빽하며, 구조(다단, 표, 수식, 머리글/바닥글)가 복잡하다. 저자들은 기존 접근을 두 갈래로 나누고 각각의 약점을 짚는다.
- 파이프라인 방식 (Marker, PP-StructureV3, 기존 MinerU2-pipeline 등): 레이아웃 검출 → 읽기 순서 → 텍스트/수식/표 인식을 각각 전용 모델이 처리한다. 해석 가능하지만 모듈 간 오류 전파가 있고, 모델이 여러 개라 유지보수가 번거롭다.
- end-to-end VLM 방식 (GOT, olmOCR, dots.ocr 등): 한 모델이 페이지를 통째로 읽는다. 의미 모델링은 강하지만 긴 문서에서 환각이 잦고, 네이티브 해상도 입력은 비전 토큰 수가 폭증해 비용이 든다. 특히 문서의 넓은 여백이 토큰 낭비의 주범이다.
중간 지대로 Dolphin, MonkeyOCR 같은 다단계 VLM이 있지만, Dolphin은 Swin 기반 고정 해상도라 극단적 종횡비의 crop이 왜곡되고, MonkeyOCR은 단계마다 다른 모델을 쓴다. 단일 모델 + 네이티브 해상도 + 다단계를 동시에 만족시키는 것이 MinerU2.5의 목표다.
🧠 핵심 아이디어: 레이아웃은 작게, 내용은 원본 해상도로
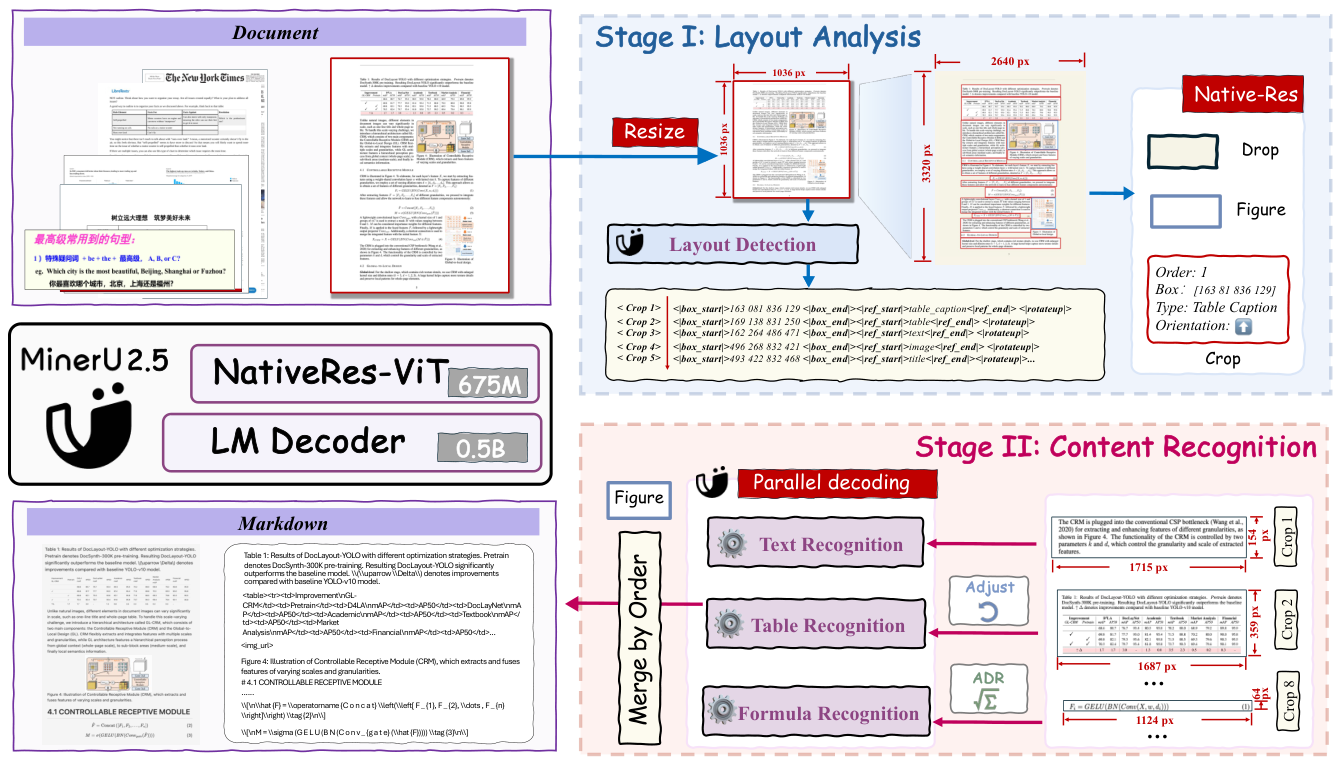
구조는 Qwen2-VL 계열의 전형적인 VLM이다. 세 부품으로 되어 있다.
- 비전 인코더: Qwen2-VL에서 초기화한 675M NaViT. 동적 해상도와 2D-RoPE를 지원해 다양한 크기·종횡비의 입력을 받는다. Qwen2.5-VL의 윈도우 어텐션은 문서 파싱 성능을 떨어뜨려서 일부러 쓰지 않았다고 한다.
- 패치 머저: 인접 2×2 비전 토큰을 pixel-unshuffle로 묶어 LLM에 넘긴다.
- 언어 모델: 0.5B Qwen2-Instruct. 문서 파싱은 LLM 규모에 덜 의존한다는 판단이다. 다양한 crop 해상도에 대응하도록 1D-RoPE를 M-RoPE로 교체했다.
진짜 핵심은 모델이 아니라 추론 전략이다.
Stage I: 레이아웃 분석 (저해상도 전역)
입력 페이지를 1036×1036 썸네일로 균일하게 리사이즈한 뒤 "Layout Detection:" 프롬프트로 모든 요소의 위치(bbox), 클래스, 회전 각도, 읽기 순서를 한 번의 추론으로 뽑는다. 너무 작으면 디테일이 사라지고, 너무 크면 NaViT의 제곱 복잡도가 터지므로 이 크기를 골랐다. 원본 종횡비를 유지하는 것보다 고정 정사각형이 bbox 위치가 안정적이고 학습도 효율적이었다고 한다.
기존 레이아웃 검출이 "객체 검출"로 끝나고 읽기 순서를 뒤쪽 모듈로 미루던 것과 달리, 네 속성을 멀티태스크로 동시에 예측하는 것이 차이점이다. 회전된 표 같은 요소도 이 단계에서 해결된다.
Stage II: 콘텐츠 인식 (고해상도 지역)
Stage I이 찾은 bbox로 원본 고해상도 이미지에서 영역을 잘라내고, 각 crop을 "Text Recognition:", "Table Recognition:", "Formula Recognition:" 프롬프트로 읽는다. crop은 네이티브 해상도로 넣되 상한을 픽셀로 둔다. 너무 작은 crop의 디테일 손실도, 너무 큰 crop의 낭비도 피하는 선이다. 그림(figure)은 인식 대상에서 제외하고 bbox만 남긴다.
이렇게 하면 여백 토큰이 사라지니 계산량이 한 자릿수 줄고, 각 crop이 독립 요청이라 병렬 디코딩이 가능하며, 레이아웃과 인식을 따로 최적화·반복할 수 있다. 환각이 줄어드는 것도 저자들이 강조하는 부수 효과다.
📐 학습 레시피와 데이터 엔진
3단계 커리큘럼
| Stage-0a | Stage-0b | Stage-1 | Stage-2 | |
|---|---|---|---|---|
| 데이터 | 이미지 캡션 558K | VQA 665K | Layout&OCR 6.9M | Layout&OCR 630K |
| 학습 대상 | MLP 어댑터만 | 전체 | 전체 | 전체 |
| 시퀀스 길이 | 4096 | 4096 | 8192 | 16384 |
| 에폭 | 1 | 1 | 2 | 3 |
- Stage 0 (모달리티 정렬): LLaVA-Pretrain/Instruct 계열 데이터로 일반 VLM 정렬을 먼저 한다. 이 단계를 건너뛰면 레이아웃·인식 모두 손실이 높아지고 성능이 눈에 띄게 떨어졌다고 한다.
- Stage 1 (문서 파싱 사전학습): 에폭당 6.9M 샘플 — 레이아웃 2.3M, 텍스트 블록 2.4M, 수식 1.1M, 표 1.1M. 이 체크포인트가 이후 하드 케이스 채굴기로도 쓰인다.
- Stage 2 (파인튜닝): 에폭당 630K — 레이아웃 43K, 텍스트 300K, 수식 147K, 표 140K. 어려운 사례를 사람이 교정한 고품질 데이터가 중심이다.
Stage 1·2에는 스케일/왜곡/회전, 워터마크/그림자/스캔라인 같은 배경 변환, 밝기/조명 변환, 블러/침식 등 증강이 들어간다(레이아웃 샘플에는 공간 변환 제외).
IMIC: 추론 일관성으로 하드 케이스 찾기
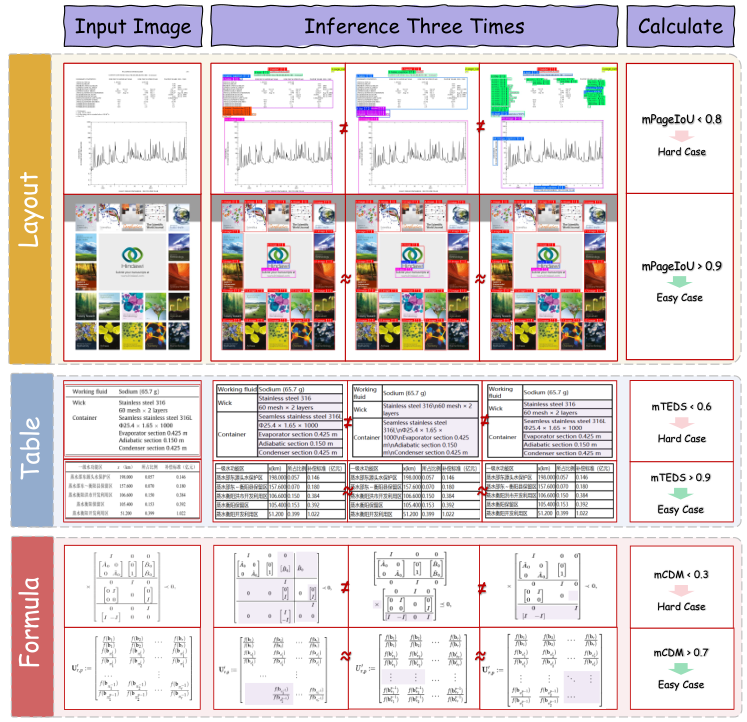
데이터 엔진의 가장 재미있는 부분이 IMIC(Iterative Mining via Inference Consistency) 다. 라벨 없는 대규모 문서 풀에서 "모델이 아직 못 푸는 것"만 골라 사람 주석을 집중시키는 방법이다.
아이디어는 간단하다. 샘플링을 켜고 같은 입력을 여러 번 추론했을 때, 모델이 잘 배운 샘플은 결과가 일관되고, 결정 경계 근처의 샘플은 결과가 흔들린다. 그 흔들림을 과제별 지표로 잰다. 레이아웃은 PageIoU, 표는 TEDS, 수식은 CDM. 일치도가 임계값 아래면 하드 케이스로 분류해 Gemini-2.5 Pro 같은 모델로 사전 주석을 달고 사람이 교정한다.
사전학습 데이터는 MinerU2 파이프라인으로 1차 주석을 만든 뒤 텍스트는 Qwen2.5-VL-72B, 수식은 자체 재학습한 UniMERNet, 표는 자체 표 모델로 정제했다. 중국어·영어 균형, 문서 유형별 층화 샘플링, 요소별 클래스 균형도 큐레이션 단계에서 맞춘다.
레이아웃 평가 지표 PageIoU
레이아웃 검출을 mAP로 재면 문단 단위 GT에 대해 줄 단위로 정확히 잡은 예측이 오히려 점수를 덜 받는 모순이 생긴다. 저자들은 페이지 픽셀 단위 커버리지 맵으로 겹침을 재는 PageIoU를 제안한다.
은 페이지의 비배경 영역, 는 픽셀 를 덮는 예측 bbox 개수다. 논문의 예시에서 문단을 뭉뚱그린 예측은 Recall@IoU0.5가 1.0이지만 PageIoU는 0.78, 줄 단위로 정확한 예측은 Recall@IoU0.5가 0.6이지만 PageIoU는 0.97이 나온다. IMIC의 레이아웃 일관성 지표로도 이 PageIoU가 쓰인다.
🔍 수식과 표: 과제를 다시 정의하다
수식 — ADR(원자 분해 후 재조립)
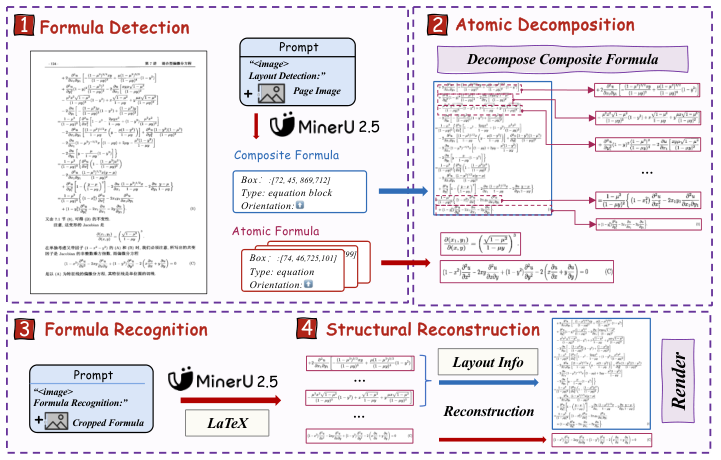
긴 다단 수식에서 VLM이 구조 환각을 일으키는 원인을 저자들은 "모든 수식을 한 덩어리로 취급하기 때문"으로 본다. 그래서 수식을 둘로 나눈다. 분수나 행렬처럼 더 쪼갤 수 없는 원자 수식(atomic) 과, 등호 정렬된 다단 유도식처럼 원자 수식이 세로로 쌓인 복합 수식(compound) 이다.
ADR(Atomic Decomposition & Recombination) 은 복합 수식을 줄 단위 원자 수식으로 쪼개 각각 LaTeX로 바꾼 뒤, 레이아웃 단계의 위치 정보로 align 같은 환경에 다시 끼워 넣는다. 레이아웃 분석기와 인식기 역할을 모두 같은 MinerU2.5 모델이 프롬프트만 바꿔 수행한다는 점이 깔끔하다.
표 — HTML 대신 OTSL
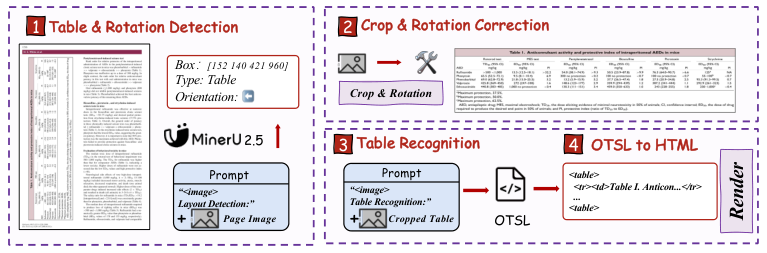
VLM이 표를 HTML로 바로 뱉게 하면 두 가지가 문제다. HTML 문법은 시각 구조와 직접 대응하지 않아 모델이 암묵적으로 배워야 하고, 토큰 중복이 심해 큰 표에서 시퀀스가 너무 길어진다. MinerU2.5는 IBM이 제안한 OTSL(Optimized Table-Structure Language) 을 생성 타깃으로 쓴다. 표의 2D 격자에 직접 대응하는 최소 표현이라 구조 토큰이 28개 이상에서 5개로 줄고 평균 시퀀스 길이가 약 50% 짧아진다. 마지막에 OTSL→HTML 변환은 단순 규칙이다. 회전된 표는 Stage I의 회전 각도 예측으로 먼저 바로잡는다.
레이아웃 태그 체계도 손봤다. 머리글/바닥글/페이지 번호/주석 같은 페이지 여백 요소를 버리지 않고 보존하고(RAG에 중요하다는 설명), 코드·알고리즘·참고문헌·리스트를 별도 클래스로 분리했으며, 수식은 equation과 equation_block으로 나눈다.
📊 실험 결과
OmniDocBench: 1.2B가 90점 벽을 넘다
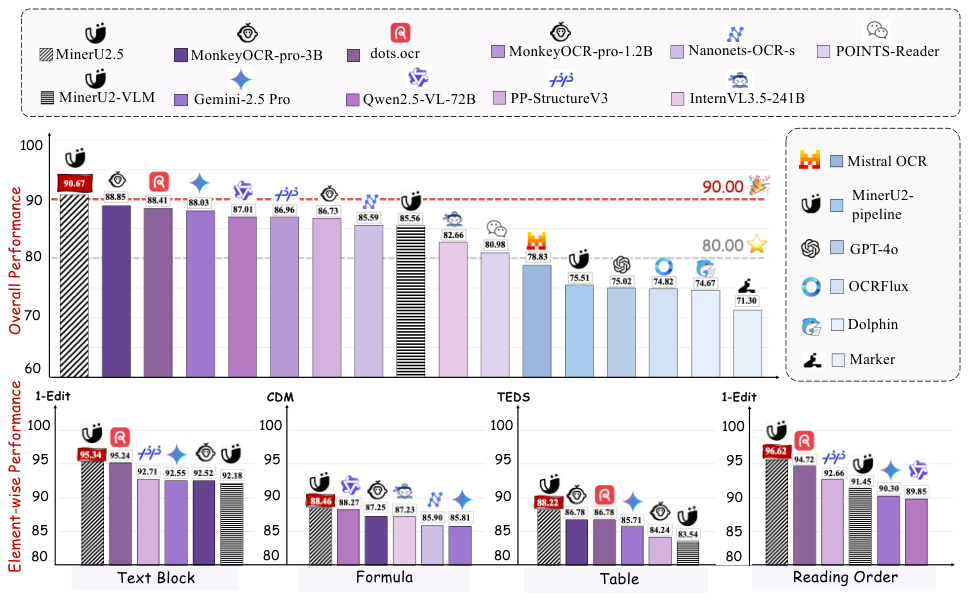
OmniDocBench(1,355페이지, 9개 문서 유형, 페이지당 평균 1,100토큰 이상) 결과다. Overall은 으로 계산한다.
| 모델 | 파라미터 | Overall ↑ | Text Edit ↓ | Formula CDM ↑ | Table TEDS ↑ | Read Order Edit ↓ |
|---|---|---|---|---|---|---|
| PP-StructureV3 | - | 86.73 | 0.073 | 85.79 | 81.68 | 0.073 |
| Qwen2.5-VL-72B | 72B | 87.02 | 0.094 | 88.27 | 82.15 | 0.102 |
| Gemini-2.5 Pro | - | 88.03 | 0.075 | 85.82 | 85.71 | 0.097 |
| MinerU2-VLM | 0.9B | 85.56 | 0.078 | 80.95 | 83.54 | 0.086 |
| MonkeyOCR-pro-3B | 3.7B | 88.85 | 0.075 | 87.25 | 86.78 | 0.128 |
| dots.ocr | 3B | 88.41 | 0.048 | 83.22 | 86.78 | 0.053 |
| MinerU2.5 | 1.2B | 90.67 | 0.047 | 88.46 | 88.22 | 0.044 |
(Table 5 일부. 전체 표에는 Marker, GPT-4o, InternVL3.5-241B, Dolphin, olmOCR-7B, Nanonets-OCR-s 등도 있다.)
Overall 90.67로 2위 MonkeyOCR-pro-3B보다 1.82점, dots.ocr보다 2.26점 높다. 텍스트 edit distance는 dots.ocr(0.048)과 사실상 동률이고, 수식·표·읽기 순서는 모두 1위다. 특히 읽기 순서 edit distance 0.044는 Stage I에서 순서를 함께 예측하는 설계의 효과로 보인다.
문서 유형별 텍스트 edit distance(Table 6)에서는 9개 유형 중 6개에서 1~2위다. 교과서 0.0499(dots.ocr 0.0788), 신문 0.0540으로 1위, 재무보고서(0.0104)와 슬라이드(0.0294)는 2위다. 다만 손글씨 노트는 0.1161로 dots.ocr(0.1116)에 뒤진다.
다른 벤치마크
- olmOCR-bench: Overall 75.2로 dots.ocr(73.6)보다 1.6점 높다. arXiv Math 76.6(Qwen2.5-VL-72B 72.2), Old Scans Math 54.6, Long Tiny Text 83.5. 단, 표(TA)는 84.9로 dots.ocr(88.3)에, Old Scans(OS)는 33.7로 olmOCR(43.9)에 뒤진다.
- Ocean-OCR bench (영/중 각 100장 고밀도 OCR): 영어 edit distance 0.033, F1 0.945로 1위. 중국어는 F1 0.965, Precision 0.966으로 1위지만 edit distance(0.082)와 BLEU(0.817)는 Ocean-OCR(0.062, 0.912)에 뒤진다. 같은 표에 SmolDocling도 있는데 중국어 edit distance가 0.878로 사실상 중국어를 못 읽는다.
- 레이아웃(PageIoU): OmniDocBench, D4LA, DocLayNet 세 벤치마크 모두 zero-shot Full Page F1에서 1위(95.9 / 90.2 / 94.6). 비교군은 LayoutLMv3, DocLayout-YOLO, PP-StructureV3.
- 표 인식(Table 10): FinTabNet TEDS 95.97(2위 MiniCPM-V 4.5 85.41)로 압도적이고, OCRBench v2 87.13, 자체 벤치마크 71.48(Gemini-2.5 Pro 69.72). PubTabNet은 학습 데이터의 20%만 쓰고도 TEDS 89.07로 dots.ocr(90.65)에 이은 2위. CC-OCR은 Gemini-2.5 Pro, Qwen2.5-VL-72B에 이은 3위.
- 수식 인식(Table 11, CDM): HWE 94.4, SCE 96.4, LaTeX-80MM(행렬) 90.6, Fuzzy Math 92.6, Complex 82.2. 손글씨·행렬·복잡 수식에서 강하고, CPE(96.6)와 SPE(98.4)는 전용 모델 UniMERNet/PP-Formula(98.2 / 99.2)에 뒤진다.
처리 속도
| 모델 | 파라미터 | 백엔드 | GPU | Tokens/s | Pages/s |
|---|---|---|---|---|---|
| dots.ocr | 3.0B | vLLM | A100 80G | 311.06 | 0.28 |
| MonkeyOCR-pro-3B | 3.7B | vLLM | A100 80G | 520.16 | 0.47 |
| MonkeyOCR-pro-1.2B | 1.9B | vLLM | A100 80G | 589.76 | 0.53 |
| Nanonets-OCR-s | 3.7B | vLLM | A100 80G | 605.92 | 0.55 |
| MinerU2-VLM | 0.9B | SGLang | A100 80G | 3091.23 | 2.84 |
| MinerU2.5 | 1.2B | vLLM | RTX 4090 48G | 1875.82 | 1.70 |
| MinerU2.5 | 1.2B | vLLM | A100 80G | 2337.25 | 2.12 |
| MinerU2.5 | 1.2B | vLLM | H200 141G | 4938.31 | 4.47 |
A100 기준 2.12 pages/s로 MonkeyOCR-pro-3B의 약 4배, dots.ocr의 약 7배다. 배포 최적화 없이도 0.95 pages/s가 나왔다고 한다. 최적화 내용은 vLLM 위에 비동기 배치 제출, Stage I/II를 독립 태스크로 분리해 결과가 나오는 대로 다음 단계 시작, 그리고 Stage I이 검출한 요소 타입에 따라 Stage II의 frequency_penalty/presence_penalty를 동적으로 조절하는 것(문단은 높게, 표는 낮게 — 표의 정당한 반복 구조를 벌하지 않기 위해)이다. 참고로 이전 버전 MinerU2-VLM이 더 빠른데, 이는 0.9B에 SGLang 백엔드라는 조건 차이가 있고 정확도는 5점 이상 낮다.
💡 정리, 한계, 열린 질문
MinerU2.5가 보여준 것은 "문서 파싱에서는 해상도를 어디에 쓰느냐가 파라미터 수보다 중요하다"는 점이다. 전역 구조는 1036×1036이면 충분하고, 고해상도는 실제로 글자가 있는 crop에만 쓰면 된다. 여기에 과제 재정의(ADR, OTSL, 멀티태스크 레이아웃)와 IMIC 기반 데이터 엔진이 얹혀 1.2B로 72B·상용 모델을 넘었다.
한계도 보인다.
- 원문에 ablation이 없다. 썸네일 크기, crop 상한, Stage 0 유무 등이 "체계적 분석으로 결정했다"고만 되어 있고 수치 비교는 실리지 않았다. 2단계 분리 자체의 기여와 데이터 엔진의 기여를 분리해 보기 어렵다.
- Stage I 오류는 복구되지 않는다. 레이아웃이 틀리면 Stage II는 그 crop만 본다. 파이프라인 방식의 오류 전파 문제가 구조적으로는 남아 있는 셈이다. 손글씨 노트와 오래된 스캔에서 상대적으로 약한 것이 이와 관련 있을지는 논문에서 확인되지 않는다.
- 비교 조건이 완전히 같지는 않다. 속도 표의 MinerU2-VLM은 SGLang, 나머지는 vLLM이고, olmOCR-bench의 일부 수치는 타 보고서에서 가져왔다.
- 그림(figure)은 bbox만 남기고 내용을 읽지 않는다. 차트·이미지 설명이 필요한 용도라면 후속 버전(MinerU2.5-Pro)을 봐야 한다.
그래도 RAG용 코퍼스나 LLM 사전학습 데이터처럼 대량의 PDF를 구조 보존하며 빠르게 텍스트로 바꿔야 하는 용도에서는, 현재 공개 모델 가운데 가장 실용적인 선택지 중 하나로 보인다.
🛠️ 직접 돌려보기
GitHub README(2026년 10월 기준)는 MinerU 4.0 을 안내하고 있다. 논문의 모델(opendatalab/MinerU2.5-2509-1.2B)은 이후 MinerU2.5-Pro로 업데이트되었고, 4.0에서는 백엔드 대신 tier(flash/basic/standard/advanced)로 품질을 고른다. changelog 기준으로 basic은 파이프라인, standard는 하이브리드, advanced는 VLM 전용에 해당한다. Python은 >=3.10,<3.15.
pip install uv
uv venv .mineru --python 3.12
source .mineru/bin/activate          # Windows: .\.mineru\Scripts\Activate.ps1

uv pip install -U "mineru>=4.0,<5"   # NVIDIA GPU면 "mineru[full]>=4.0,<5"
mineru-kit parse document.pdf -o document.md --tier standard
mineru-kit webui                      # Gradio WebUI
기본 설치는 소형 모델을 ONNX CPU로, VLM을 llama.cpp(Vulkan)로 돌리며 macOS Apple Silicon은 기본 패키지가 곧 최적 구성이다. 에이전트에서 쓰려면 문서 라이브러리 서버를 띄운 뒤 mineru parse document.pdf --json으로 파싱하고(기본 첫 10페이지), 반환된 doc:{id}/tier:{tier}/page:{n} 로케이터로 mineru read를 이어가면 된다.
mineru server start
mineru parse "paper.pdf" --tier standard --json
mineru read "doc:ab12cd3/tier:standard/page:1" --json
📚 참고
- 원문: MinerU2.5: A Decoupled Vision-Language Model for Efficient High-Resolution Document Parsing (Niu et al., OpenDataLab / Shanghai AI Lab, 2025.09) · HTML 버전
- 코드: github.com/opendatalab/MinerU · 모델: opendatalab/MinerU2.5-2509-1.2B
- OmniDocBench: arXiv 2412.07626
- OTSL: Lysak et al., Optimized Table Tokenization for Table Structure Recognition (IBM, 2023)
- 관련 글: arxiv-graph: arXiv 논문 지식 그래프 자동 구축기
본 글의 그림은 원문에서 가져왔습니다.