우리가 놓친 딥페이크: 잘못된 위협을 쫓은 10년과, 폰 사진을 가짜로 찍는 탐지기들
"우리는 오지 않은 위협을 위해 탐지기를 만들었다."
이 블로그의 딥페이크 시리즈는 2025년에 다섯 편을 쓰고 멈춰 있었다. 오디오-비주얼 딥페이크 탐지 서베이부터 ICCV 2025의 DeepShield까지, 그 글들의 공통 관심사는 "어떻게 하면 탐지기의 AUC를 더 올리고 cross-dataset 일반화를 더 끌어올릴까"였다. 좋은 질문이었지만, 2026년에 나온 두 편의 논문은 그 질문 자체를 흔든다.
첫 번째는 Vector Institute의 Shaina Raza가 쓴 포지션 페이퍼 "The Deepfakes We Missed: We Built Detectors for a Threat That Didn't Arrive" (arXiv 2605.12075, 2026.05)다. 요지는 제목 그대로다. 분야 전체가 20172019년에 물려받은 "유명인 얼굴 교체 영상이 선거를 뒤흔든다"는 위협 모델을 좇았는데, 20222026년에 실제로 대규모 피해를 낸 것은 또래가 만든 비동의 성적 이미지(NCII), 가족과 재무 담당자를 노린 음성 복제 사기, 정서 조작 사기였다는 것이다.
두 번째는 독일 Stralsund 대학과 Offenburg 대학(IMLA)의 Achim von Stryk, Janis Keuper가 쓴 감사(audit) 연구 "LAION-Mobile: Evaluating Deepfake Detectors On One Million Smartphone Photos" (arXiv 2609.11134, 2026.09)다. 탐지기 논문들이 보고하는 AUC 0.99라는 숫자가, 실제 스마트폰 사진 앞에서 어떻게 무너지는지를 약 100만 장 규모로 측정했다.
하나는 "무엇을 탐지해야 하는가"를, 다른 하나는 "지금 있는 탐지기가 진짜 사진에서조차 믿을 만한가"를 묻는다. 두 글을 묶어 읽으면 2025년의 성능 경쟁이 어떤 전제 위에 있었는지가 꽤 선명하게 보인다.
원문: The Deepfakes We Missed · LAION-Mobile
🤔 배경: 2017년에 고정된 위협 모델
Raza의 논문은 먼저 "분야가 어떤 위협을 준비했는가"를 고고학적으로 추적한다. 현대 딥페이크 탐지 문헌의 출발점은 2017년 말 Reddit의 "deepfakes" 계정이 유명인 얼굴을 바꿔 붙인 영상을 올린 사건이다. 이 사건이 용어와 기술 패러다임(알아볼 수 있는 인물의 face-swap 영상)을 동시에 고정했고, 그 위에 두 줄기가 세워졌다. 기술 쪽에서는 FaceForensics++(2019)가 "조작된 영상을 모아 이진 분류 과제로 푼다"는 벤치마크 템플릿을 만들었고 Celeb-DF, DFDC가 이를 확장했다. 정책 쪽에서는 Chesney와 Citron의 2019년 California Law Review 논문이 딥페이크를 프라이버시·민주주의·국가안보 위협으로 틀 지웠다. 두 줄기는 서로를 강화했다. 벤치마크가 "무엇이 딥페이크인가"를 정의했고, 정책 프레임이 "왜 중요한가"를 정의했다.
이후 벤치마크(DeeperForensics, DF40, Diff-Face, GenFace 등)는 생성기와 난이도를 늘렸지만 "공인의 얼굴 영상을 사후에 이진 분류한다"는 틀은 건드리지 않았다. 그 결과 두 종류의 콘텐츠가 체계적으로 빠졌다. 동급생·동료 같은 비공인 사이에서 만들어지고 유통되는 또래 생성(peer-generated) 콘텐츠, 그리고 공개 플랫폼이 아니라 암호화 메신저나 폐쇄 그룹을 통해 퍼지는 사적 채널 콘텐츠다.
📊 실증 1: 연구 분포 vs 피해 분포
논문의 핵심은 두 분포를 나란히 놓는 것이다. 한쪽은 논문 수로 잰 연구 노력, 다른 쪽은 사건·피해자·금전 손실로 잰 실제 피해다.
연구 쪽. 저자는 2017~2025년 주요 ML·비전·신호처리·멀티미디어 학회(CVPR, AAAI, Interspeech, IEEE TIFS 등)와 고인용 arXiv 프리프린트에서 3,124편을 긁어 438편의 탐지 논문 코퍼스를 만들고, 각 논문을 위협 범주로 분류했다. 범주는 다섯 개다.
| 범주 | 내용 |
|---|---|
| T1 | 공인 face-swap / talking-head 영상 |
| T2 | 또래 생성 NCII |
| T3 | 오디오 / 음성 복제 |
| T4 | 실시간 / 라이브 스트림 |
| T5 | 메시징 계층 / 또래 간 유통 |
438편 중 49편(11.2%)은 서베이, 출처 증명(provenance), 워터마킹처럼 특정 위협 대상이 없는 "Other"다. 나머지 389편 가운데 276편(71.0%)이 T1이다. T3가 111편(28.5%)으로 뒤를 잇지만, 저자에 따르면 이 대부분은 녹음된 발화에 대한 ASVspoof식 오프라인 안티스푸핑이지, 통화 중 실시간으로 경고를 내는 소비자 사기 설정이 아니다. 나머지 세 범주는 합쳐서 다섯 편이 안 된다. T2 1편(2025), T5 1편(2023), T4 0편.
벤치마크도 같은 모양이다. 널리 인용되는 벤치마크 13개를 같은 기준으로 분류하면 10개가 공인 얼굴·talking-head 영상, 3개가 오디오 또는 오디오-비주얼(FakeAVCeleb, LAV-DF, AV-Deepfake1M)이고, 또래 생성 NCII와 실시간 조건을 다루는 벤치마크는 0개다. 저자는 이 벤치마크 분포가 논문 분포와 "비슷한" 것이 아니라 논문 분포를 "만든다"고 본다. 방법은 존재하는 벤치마크 위에서 학습되고 평가되므로, T2/T4/T5 벤치마크가 없다는 것은 그 방향의 기여를 분야가 인식할 수 없다는 구조적 제약이 된다.
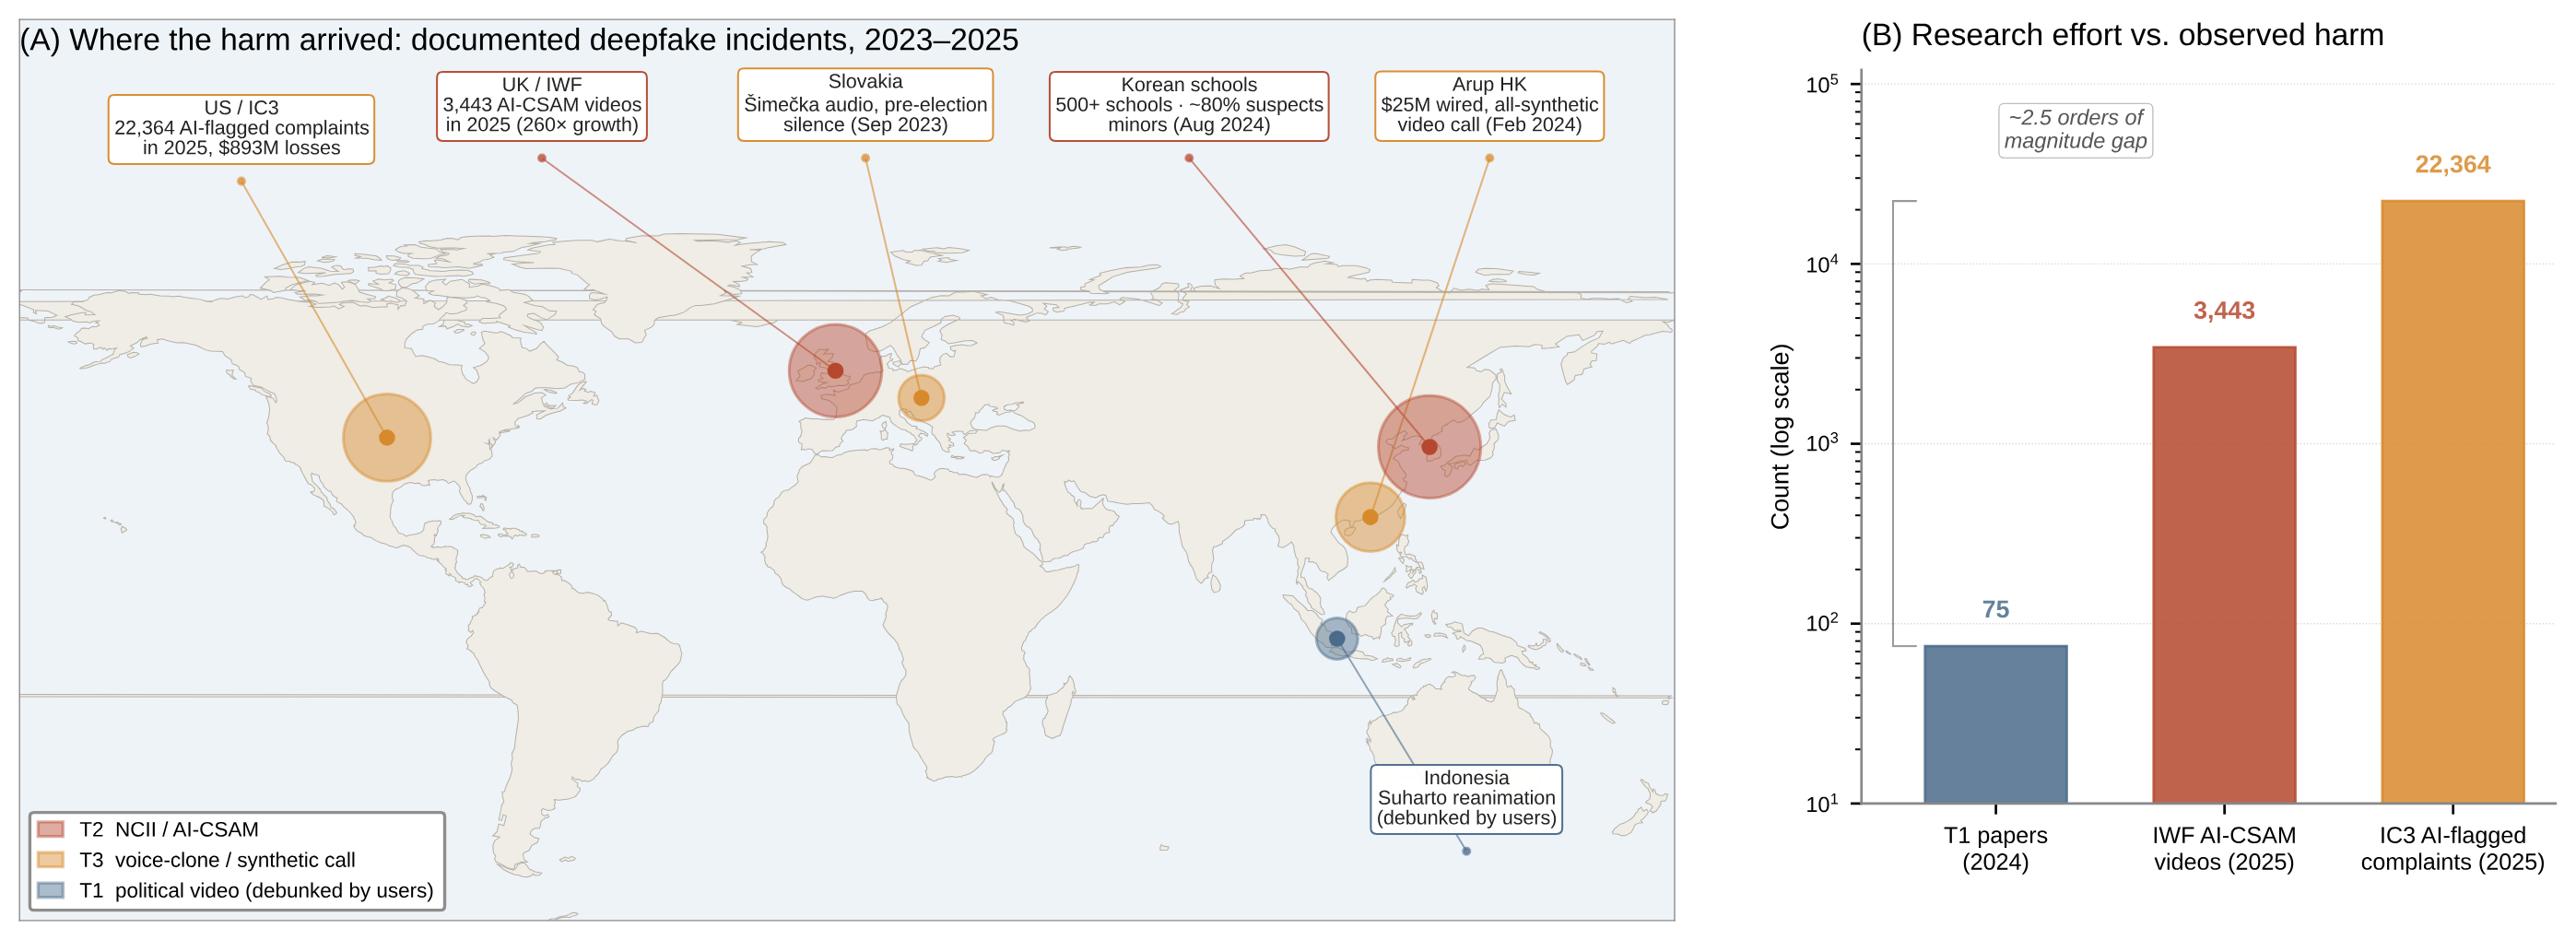
피해 쪽. 위 그림은 논문의 Figure 1이다. 왼쪽 지도는 피해가 실제로 "어디에, 어떤 형태로" 도착했는지를 보여주고, 오른쪽은 그 규모를 T1 논문 수와 같은 로그 축에 올린다. 저자가 종합한 피해 출처는 FBI IC3 연례 보고서, 영국 Internet Watch Foundation(IWF)의 AI 생성 CSAM 모니터링, AI Incident Database, 학술 피해자 설문, 주요 언론이 보도한 사건 등 다섯 가지다. 어느 하나도 완전하지 않고 보고 편향도 있지만, 저자는 "방향과 대략적 크기"를 세우는 데는 충분하다고 본다.
- 또래 생성 NCII. IWF가 평가한 AI 생성 CSAM 영상은 2024년 13건에서 2025년 3,443건으로 260배 늘었고, 이미지·영상 합계는 8,029건이다. 2024년 8월 한국의 학교 딥페이크 사건은 500개 이상 학교, 수천 명의 피해자가 연루됐고 확인된 용의자의 80% 이상이 미성년이었다. 유포는 주로 텔레그램류 암호화 그룹 채팅으로 이뤄졌다. 저자는 이것이 피해자 수 기준 최대 범주인데도 코퍼스의 1% 미만만 다룬다고 지적한다.
- 음성 복제·실시간 합성 신원 사기. IC3는 합성 미디어 관련 사기의 급증과 수십억 달러 규모의 손실을 기록하고 있다. 2024년 Arup 사건(화상회의 참가자 전원이 합성 아바타였고 재무 직원이 2,500만 달러를 송금)이 가장 많이 보도됐지만, 건수로는 가족을 노린 조부모 사기·납치 몸값 사기가 더 많다. 공격 표면은 전화망 위의 대화형 오디오이고, 오프라인 분석이 불가능한 지연 제약이 붙는다.
- 공인 정치 영상. 2024년 미국·인도·인도네시아·영국·EU 선거에서 합성 정치 영상이 결과를 바꿨다고 사후 포렌식으로 판정된 사례는 없다. 사건은 있었다(인도네시아 수하르토 재현 영상 등). 하지만 팩트체커가 기록한 사례들은 압도적으로 기자와 일반 사용자가 잡아냈지, 배포된 ML 탐지기가 잡은 게 아니다. 가장 자주 거론되는 반례인 2023년 9월 슬로바키아 Šimečka 녹음은 영상이 아니라 **오디오(T3)**다.
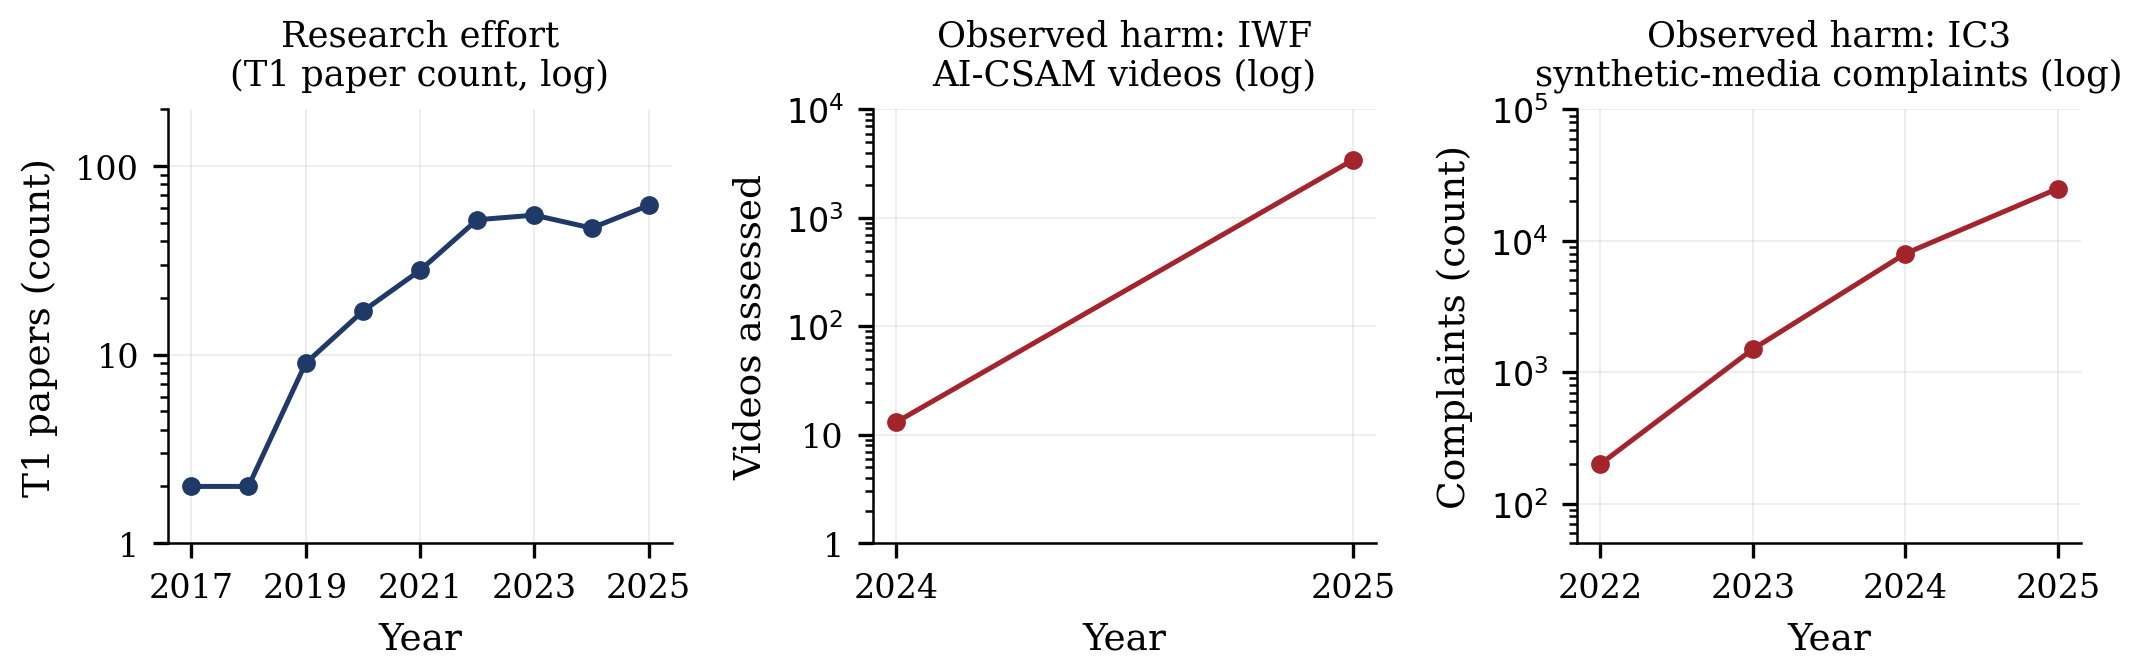
논문의 Figure 4는 이 괴리가 한 해의 우연이 아님을 보여준다. T1 논문 수는 2017~2018년 기준선 대비 약 30배로 "선형 밴드" 안에서 늘었지만, IWF 지표는 한 해 만에 260배, IC3 신고는 보고 기간 동안 한 자릿수 이상 자릿수가 뛰었다. 저자는 두 가지를 덧붙인다. 첫째, 격차는 좁혀지는 게 아니라 벌어지고 있다. 둘째, 측정 편향은 이 결론을 약화시키지 않는다. 암호화 채널의 NCII나 BEC 통계에 흡수된 음성 사기처럼 과소 집계되는 쪽은 피해 범주이지, 분야가 준비한 범주가 아니기 때문이다.
🧠 왜 고쳐지지 않는가: 세 가지 안정화 요인
이 괴리는 몇 년 전부터 보였는데도 연구는 움직이지 않았다. 저자는 세 요인이 서로를 떠받치는 평형 상태라고 진단한다.
- 벤치마크 상속 = 출판 중력. 연구자에게 벤치마크는 데이터가 아니라 "출판 가독성"의 원천이다. FF++, Celeb-DF, DFDC에서 평가한 방법은 비교군·지표·주장 구조가 암묵적으로 갖춰진 채 심사에 들어가지만, 음성 사기 통화나 접근 제한된 또래 생성 이미지로 평가한 방법은 평가 설계를 처음부터 정당화해야 한다. 2025년의 대학원생에게 공인 딥페이크 탐지는 기본값으로 읽히고, 실시간 통화 음성 복제 탐지는 상당한 오버헤드를 치른 뒤에야 읽힌다.
- 데이터셋 윤리의 비대칭. 피해가 큰 범주일수록 표준 연구 파이프라인이 막혀 있다. NCII 코퍼스는 공유할 수 없고, AI 생성 CSAM은 아예 수집할 수 없으며, 음성 사기 녹음은 통신사와 수사기관이 갖고 있다. 다루기 쉬운 정도가 피해 크기와 정반대로 간다.
- 언론·정책 현저성이 분야의 입력 신호. 국가 원수의 조작 영상 한 건은 국제 보도와 청문회, 펀딩 공고를 만들지만, NCII와 음성 사기는 건당 보도가 거의 없이 IC3·IWF의 연간 요약 보고서로 뭉뚱그려진다. 분야는 건당 신호를 따라가고, 그 비율은 총피해 비율과 뒤집혀 있다.
💡 제안: 비어 있는 세 범주를 위한 연구 아젠다
저자는 "재조정하라"는 결론 대신 세 가지 구체적 아젠다를 제시한다. 공통점은 사후 이진 분류라는 상속된 평가 틀을 버린다는 것이다.
- 아젠다 I: 통신망용 실시간 음성 복제 탐지. 대화형 오디오에서 합성 확률을 "대화 중 경고 예산" 안에 스트리밍으로 추정하고, 전화 코덱·대역 제한·패킷 손실 은닉 같은 채널 열화에 견디며, "이 목소리가 그 사람이 맞는가"라는 화자 조건부 검증(speaker-conditional)을 얹어야 한다. 깨끗한 스튜디오 녹음이 아니라 실제 전화 채널과 결정 지연 지표를 포함한 벤치마크가 필요한데, 저자에 따르면 아직 없다.
- 아젠다 II: 온디바이스·프라이버시 보존 NCII 탐지. 피해자는 동의된 참조 이미지 몇 장과 걸러야 할 후보 집합을 가진다. 이는 신원 무관 탐지와 완전한 신원 등록 사이의 few-shot 문제다. 후보 이미지가 피해자나 플랫폼의 신뢰 경계를 벗어나지 않아야 하므로 연합·온디바이스·암호학적 방법이 필요하고, 결과는 StopNCII.org의 해시 매칭, 플랫폼 T&S API, 핫라인 같은 기존 피해자 지원 인프라에 꽂혀야 한다. "코퍼스를 큐레이션해 공개하고 방법을 모집한다"는 템플릿은 적용되지 않으므로 연합 평가(가중치는 이동하고 데이터는 이동하지 않음), 파트너 내부 평가, 성인 참가자 동의 하의 합성 피해자 평가 같은 대안을 제시한다.
- 아젠다 III: 메시징 계층 방어. 한국 사건처럼 생성 품질이나 탐지기 정교함이 아니라 유통이 규정하는 범주다. 암호화 전에 기기에서 돌아가는 소형 탐지 모델(증류·양자화), 플랫폼 재인코딩에 견디는 출처 신호, 재업로드 빈도·그룹 간 전파 같은 그래프 신호가 열린 문제다.
논문은 반론도 정면으로 다룬다. "가장 어려운 생성기(고품질 공인 영상)를 잡으면 나머지는 따라온다"는 역량 과잉 통합론에는, 공인 범주 내부의 cross-dataset 일반화조차 크게 떨어지는데 범주 간(영상→오디오, 공인→사인, 오프라인→실시간) 전이 증거는 코퍼스에 사실상 없다고 답한다(Appendix E). "탐지는 지는 게임이니 C2PA 같은 출처 증명으로 가자"는 provenance 우선론에는, 출처 증명은 "이 미디어가 인증된 출처에서 나왔나"에는 답하지만 "지금 내 전화의 음성이 내 딸인가"에는 답하지 못한다고 반박한다. 가장 강한 반론인 "정치 딥페이크 재앙이 아직 안 왔을 뿐"에 대해서는, 2028년이 2024년과 다를 수 있음을 인정하면서도 미래 피해에 대한 예방이 현재 피해의 방치를 정당화하지는 않는다고 선을 긋는다.
🔍 실증 2: LAION-Mobile, 100만 장의 폰 사진으로 탐지기를 감사하다
Raza의 논문이 "무엇을 탐지할 것인가"를 흔든다면, LAION-Mobile은 T1 틀 안에서조차 지금의 탐지기가 배포 가능한지를 묻는다. 출발점은 Keuper & Keuper의 ICML 2026 포지션 페이퍼("we need to re-think the concept of 'real' images", arXiv 2509.21864)다. 오늘날 사진의 90% 이상은 스마트폰으로 찍히는데, 스마트폰은 멀티프레임 융합, 노이즈·모션블러 억제, HDR 합성 같은 신경망 기반 ISP로 사진을 "기록"하기보다 "생성"한다. 그렇다면 "생성된 것"을 찾도록 학습된 탐지기가 평범한 폰 사진을 가짜로 찍을 위험이 있다는 것이다. 이 주장은 그동안 소규모 증명 실험으로만 검증됐고, LAION-Mobile은 그 규모 문제를 풀러 나섰다.
데이터: re-LAION-5B에서 스마트폰 사진만 증류하기
저자들은 2024년에 안전 검토를 거쳐 재공개된 re-LAION-5B에서 출발해 (i) 1024×1024 이상 고해상도 부분집합, (ii) EXIF가 있는 것, (iii) EXIF Make가 36개 스마트폰 제조사 중 하나인 것으로 좁힌다. 지각 해시·URL 중복 제거와 제조사 균형 샘플링 후 1,035,208개의 고유 ID가 남는다. EXIF는 편집 소프트웨어가 써넣을 수도 있으므로 캡션 정규식(일러스트, 로고, 스크린샷 등 69,407장), 종횡비(max/min > 1.9인 스크린샷형), EXIF 완전성(초점거리·조리개·노출·ISO가 모두 없는 것) 세 필터의 합집합 99,809장을 추가로 버려 935,399장의 정제 풀을 만든다.
구성은 Apple 68.0%, Samsung 22.5%, Huawei 6.1%, Xiaomi 2.6% 순이고, 가장 많은 기종은 iPhone 6(7.9%), 6s, 7, 5s, 4S, 5다. 즉 2011~2017년의 신경망 ISP 이전 기기가 다수다. 평가는 제조사 균형 랜덤 10,000개 ID를 받아 9,171장이 살아 있고(약 8% URL 소실), 유효 점수가 나온 9,115장에서 이뤄진다. 확산 모델 재구성이 비싼 DIRE만 738장이다. 중요한 정의 하나: 이 논문에서 "진짜"란 온디바이스 ISP 처리 여부와 무관하게 물리적 장면을 카메라로 찍은 것이다. Smart HDR이나 야간 모드 사진도 진짜이며, 이를 가짜로 찍는 탐지기는 틀린 것이다.
탐지기와 프로토콜
감사 대상은 세 계열 12개다. (i) 업샘플링 스펙트럼 지문 계열 CNNDetection, NPR, Tiny-LaDeDa, (ii) CLIP 특징 선형 프로브 계열 UnivFD, CLIP-Raising-the-Bar, IAPL, Effort, (iii) 재구성 오차·표현 불변성 계열 DIRE, AEROBLADE, RIGID(그리고 백본을 DINOv3로 바꾼 저자들의 변형), 여기에 DCT 대역 선택과 ConvNeXt-XXL을 섞은 AIDE. 모두 원 논문의 체크포인트를 그대로 쓴다. 평가 영역은 세 가지다. 원 논문의 ForenSynths(구현 검증용), NTIRE 2026 챌린지 shard 0(현대 AI 생성 혼합, 실제 3,610 / 가짜 6,390), 그리고 LAION-Mobile(진짜만 있으므로 오탐률만 측정).
구현이 맞는지부터 확인한다. 생성기별 표가 있는 세 탐지기는 ProGAN 행을 AUC 0.001 이내로 재현했고, 25개 셀 중 18개(72%)가 0.05 이내다. 파이프라인은 정상이라는 뜻이다.
결과 1: 현대 AI 콘텐츠에서는 아무도 0.624를 넘지 못한다
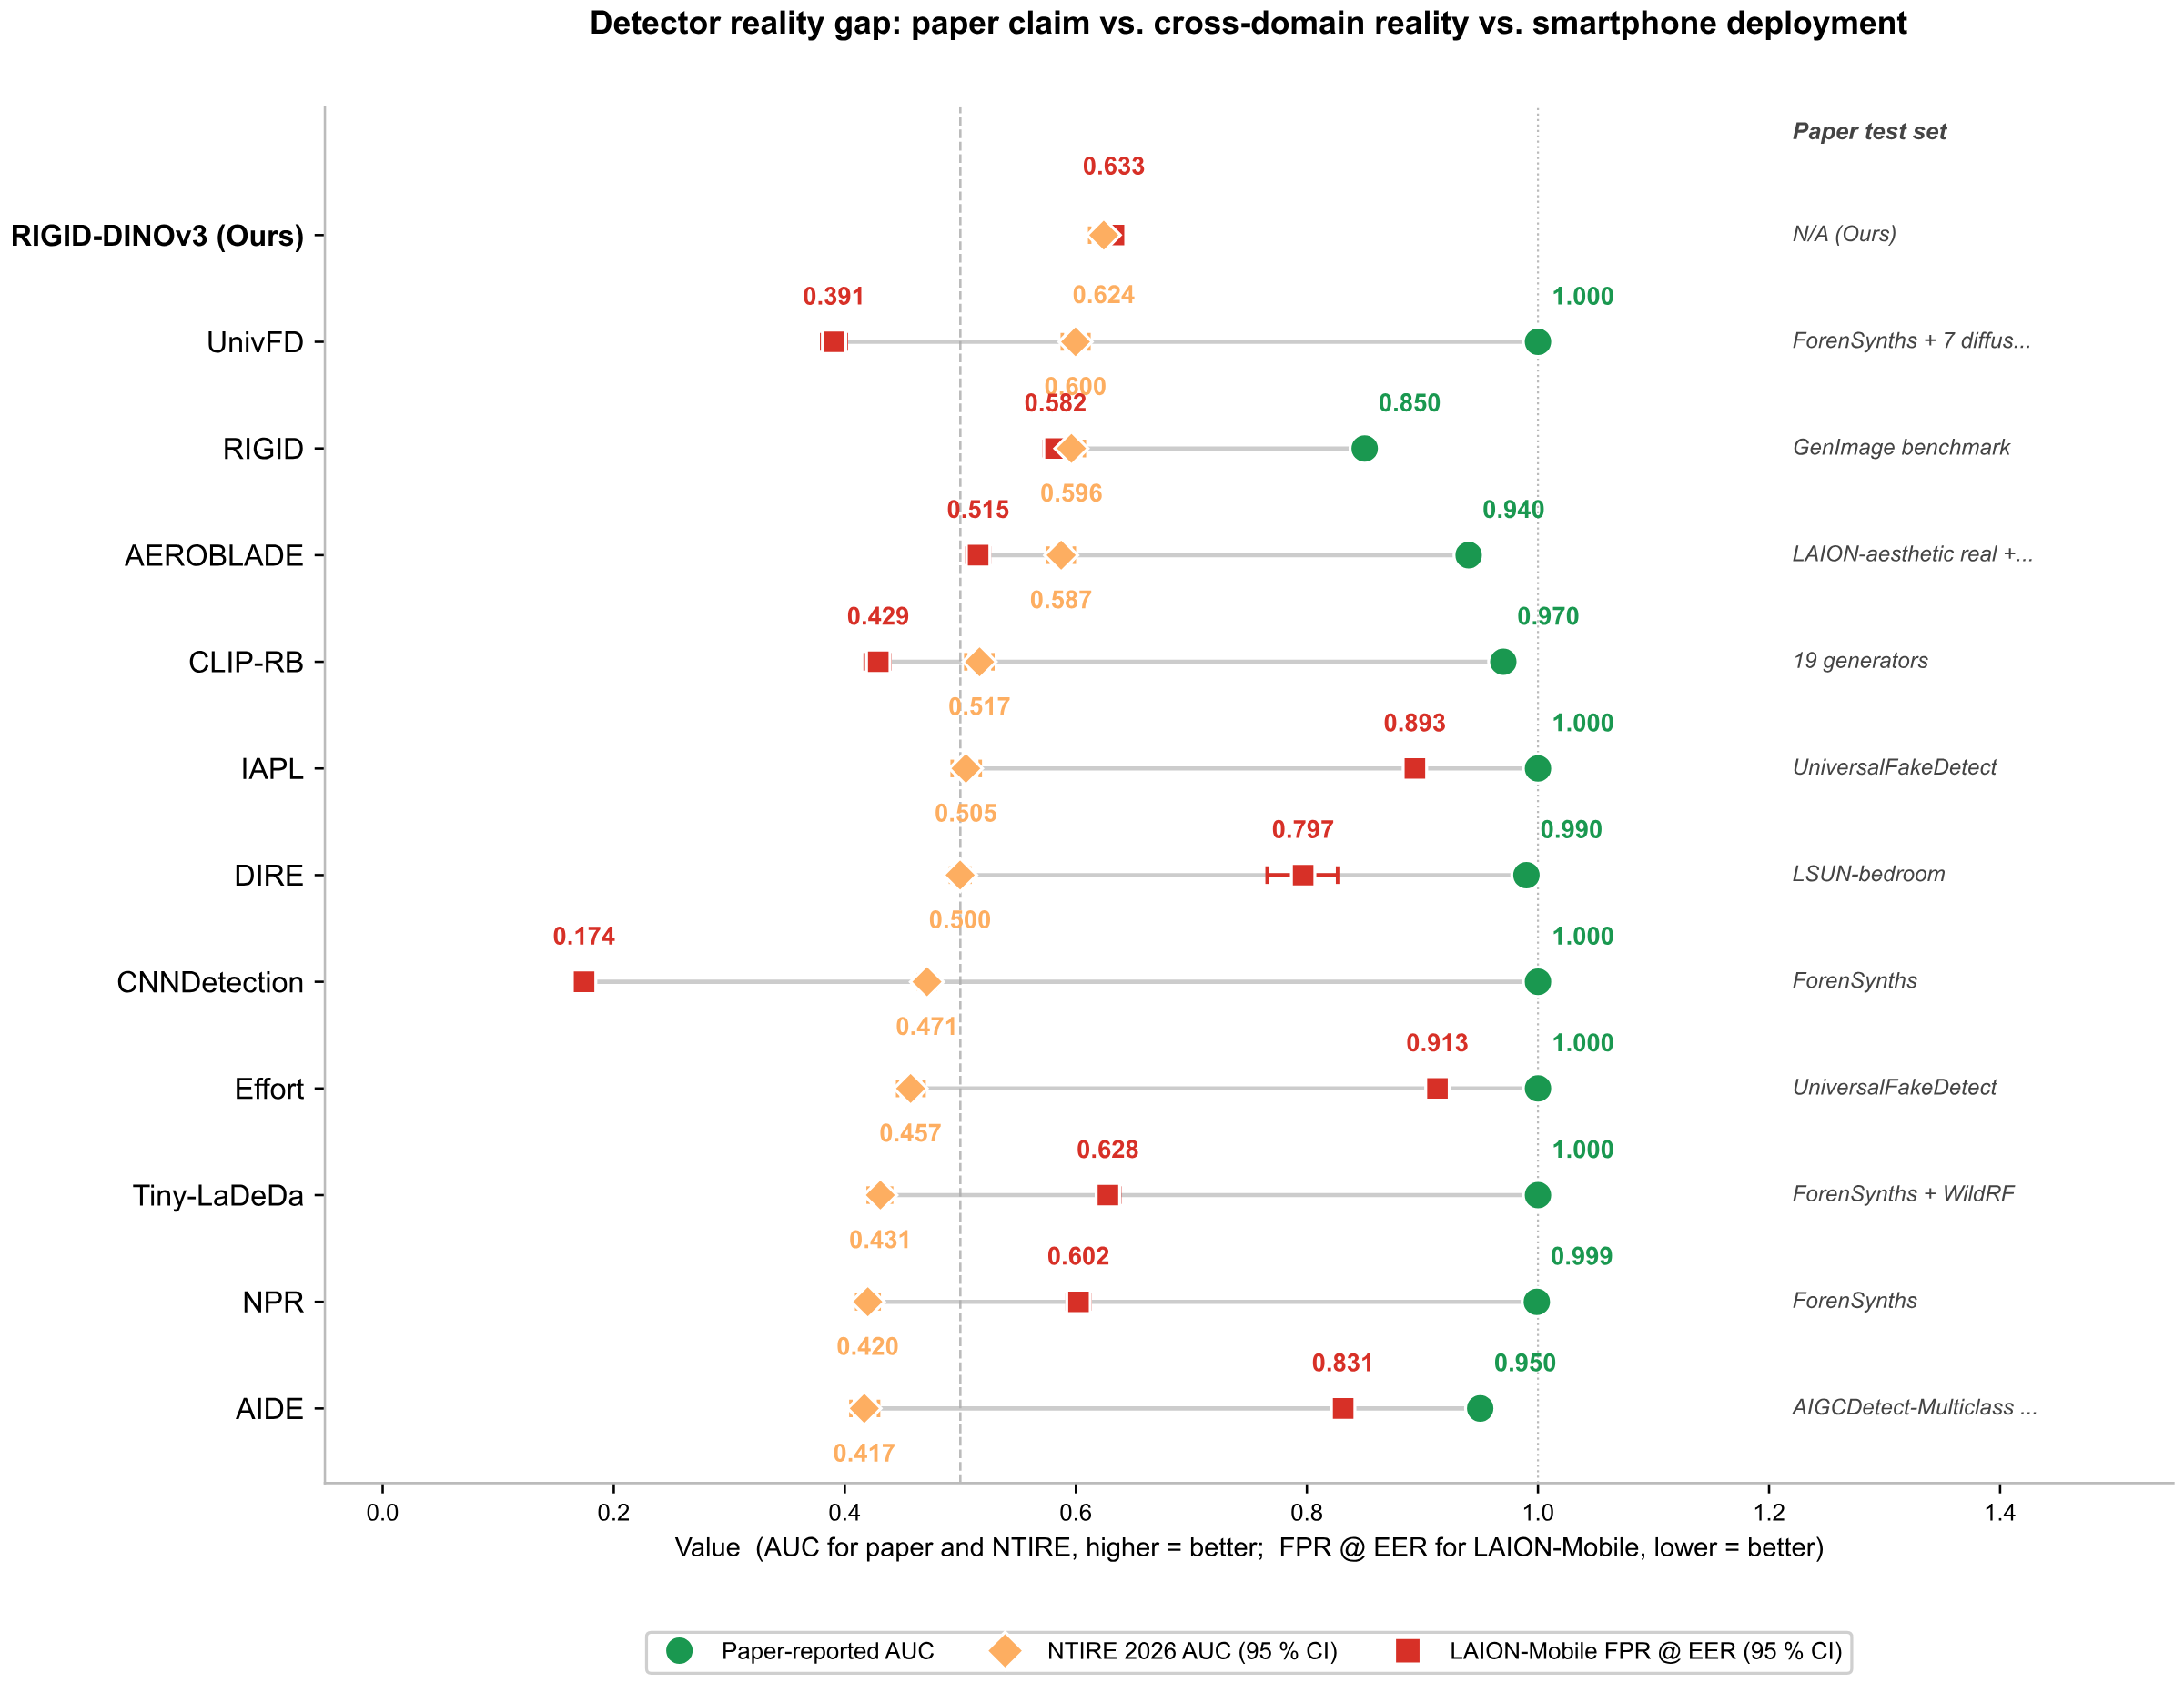
위 그림은 논문의 Figure 1이다. 초록(논문 주장)과 주황(NTIRE 현실) 사이의 간격이 "reality gap"이다. NTIRE 2026에서 AUC는 0.42~0.62 범위이고 95% 부트스트랩 CI는 약 ±0.01이다. 열두 개 중 다섯 개만 통계적으로 우연보다 높고, 두 개는 우연과 구분되지 않으며, 나머지 다섯 개는 CI가 0.5 아래에 있다. 즉 현대 콘텐츠에서 점수 순서가 뒤집혔다. 최고인 RIGID-DINOv3조차 0.624로 우연을 0.12밖에 못 넘는다. 고정 오탐 예산으로 보면 더 가혹하다. 5% FPR에서 TPR 13.5%, 1% FPR에서 3.8%를 넘는 탐지기가 없다.
| 탐지기 | 논문 AUC | NTIRE AUC | LAION-Mobile FPR @ τ(ProGAN-ISP) | LAION-Mobile FPR @ τ(NTIRE) |
|---|---|---|---|---|
| RIGID-DINOv3 | – | 0.624 | 0.977 | 0.633 |
| UnivFD | 1.000 | 0.600 | 0.002 | 0.391 |
| RIGID | 0.850 | 0.596 | 0.979 | 0.582 |
| AEROBLADE | 0.940 | 0.587 | 0.946 | 0.515 |
| CLIP-RB | 0.970 | 0.517 | 0.061 | 0.429 |
| IAPL | 1.000 | 0.505 | 0.021 | 0.893 |
| DIRE | 0.990 | 0.500 | 0.797 | 0.797 |
| CNNDetection | 1.000 | 0.471 | 0.105 | 0.174 |
| Effort | 1.000 | 0.457 | 0.036 | 0.913 |
| Tiny-LaDeDa | 1.000 | 0.431 | 0.384 | 0.628 |
| NPR | 0.999 | 0.420 | 0.466 | 0.602 |
| AIDE | 0.950 | 0.417 | 0.446 | 0.831 |
(논문 Table 4에서 발췌. NTIRE AUC 내림차순.)
결과 2: 오탐률은 탐지기의 속성이 아니라 보정의 속성이다
이 논문에서 가장 재미있는 부분이다. 기본 임계값 τ=0.5에서의 오탐률은 쓸모가 없다. 어떤 탐지기는 0.0%, DIRE는 98.1%인데, 이는 편향된 탐지기가 입력과 무관하게 "진짜"만 내뱉기 때문이다. 공정한 방법은 각 탐지기의 EER 임계값에서 재는 것인데, 어떤 2-클래스 집합에서 EER을 맞추느냐가 답을 결정한다. 2019년대 GAN 분포(ProGAN-ISP)에서 보정하면 여러 탐지기가 11% 이하, UnivFD는 0.2%로 배포 가능해 보인다. 그런데 똑같은 기준을 현대 NTIRE 콘텐츠에서 다시 맞추면 전부 **17~91%**로 올라간다. 저자들은 이를 calibration drift라고 부른다. 안전해 보이던 동작점은 지금 배포된 탐지기가 볼 일 없는 2019년 분포에 맞춰진 것이었다.
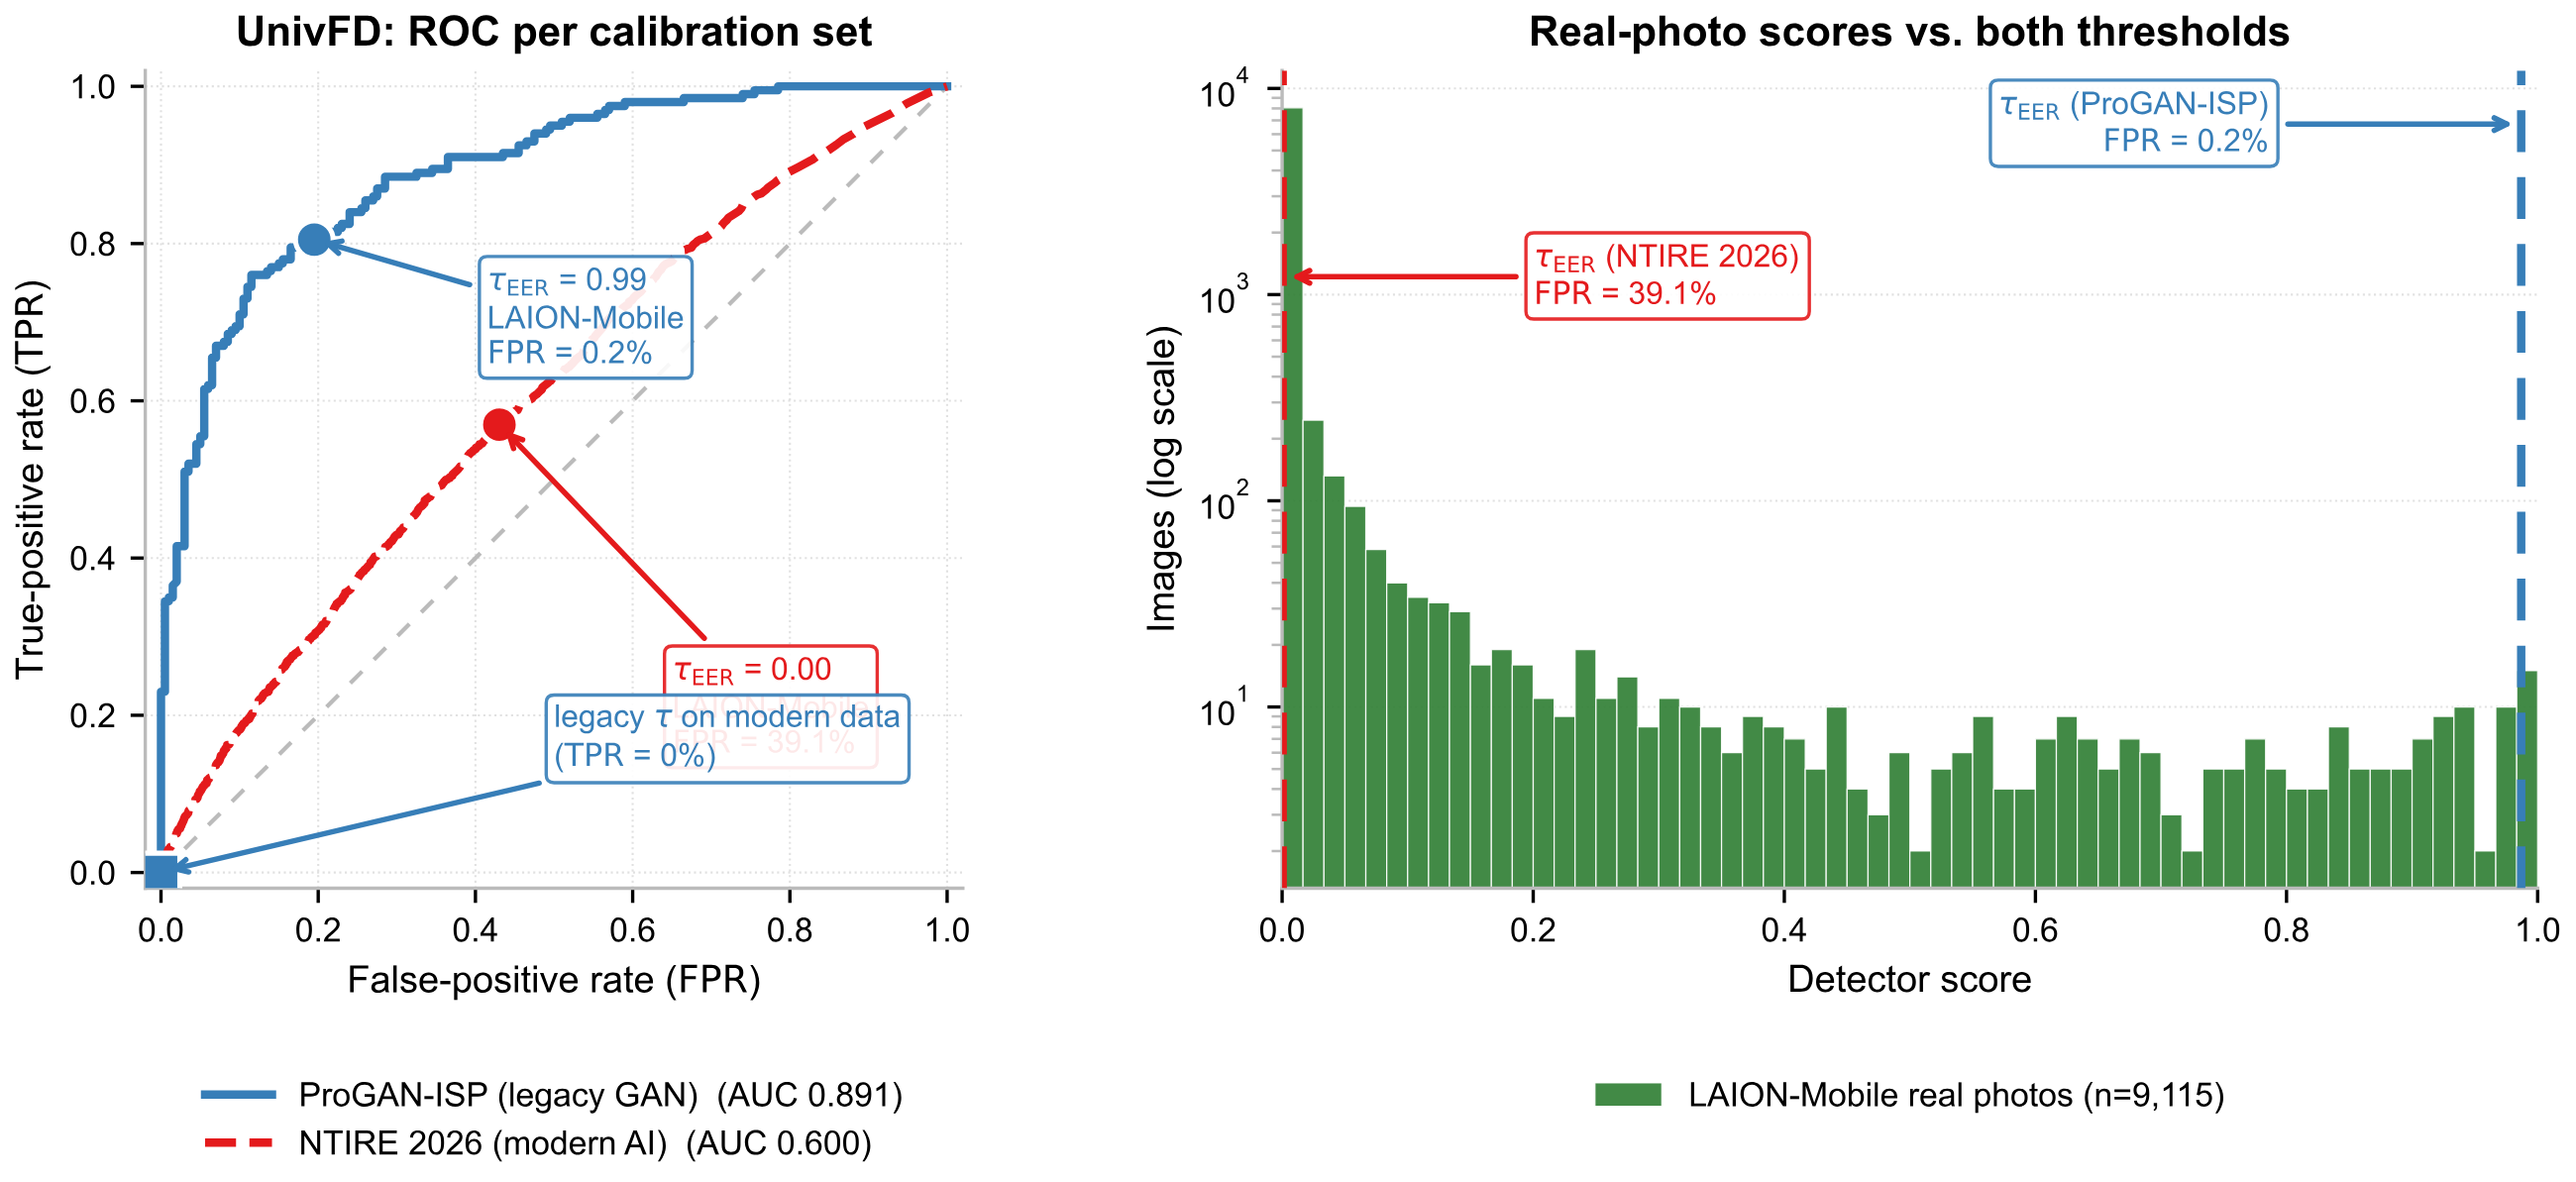
Figure 8은 최선의 경우인 UnivFD로 이를 보여준다. 두 개의 "방어 가능한" 보정이 점수 범위의 양 끝(0.99와 0.00)에 앉아 있고, 같은 사진에 대해 0.2%와 39.1%라는 오탐률을 낸다. 레거시 임계값을 현대 곡선에 투영하면 사실상 아무것도 탐지하지 못한다. 그리고 AUC는 임계값과 무관하므로, NTIRE AUC의 CI가 0.5 아래인 다섯 탐지기는 어떤 임계값을 골라도 구제되지 않는다. 결론: 현대 보정 임계값에서 "NTIRE AUC가 높고 LAION-Mobile 오탐이 낮은" 배포 가능 사분면에 있는 탐지기는 하나도 없다. 가장 근접한 UnivFD도 39.1%를 찍고, 20% 아래인 유일한 탐지기(CNNDetection, 17.4%)는 NTIRE에서 우연 이하다. 우연을 넘는 다섯 탐지기만 보면 현대 보정 후 진짜 폰 사진의 39~63%를 가짜로 찍는다.
같은 패턴은 통제된 실험실 촬영 세트(Google HDR+, SIDD, MIDD)에서도 반복되므로 LAION 특유의 인공물이 아니다. 노출 삼각형(ISO, 조리개, 노출 시간)이 98% 채워져 있어 조도별로도 나눠봤는데, 12개 중 10개는 조도 밴드 간 변화가 8%포인트 미만이다(예외는 극저조도에서 24.6포인트 오르는 AIDE와 12.0포인트의 NPR). 오탐을 만드는 건 장면의 밝기가 아니라 처리 파이프라인과 탐지기의 학습 분포라는 뜻이다.
결과 3: 정작 "현대 ISP" 가설은 아직 시험되지 않았다
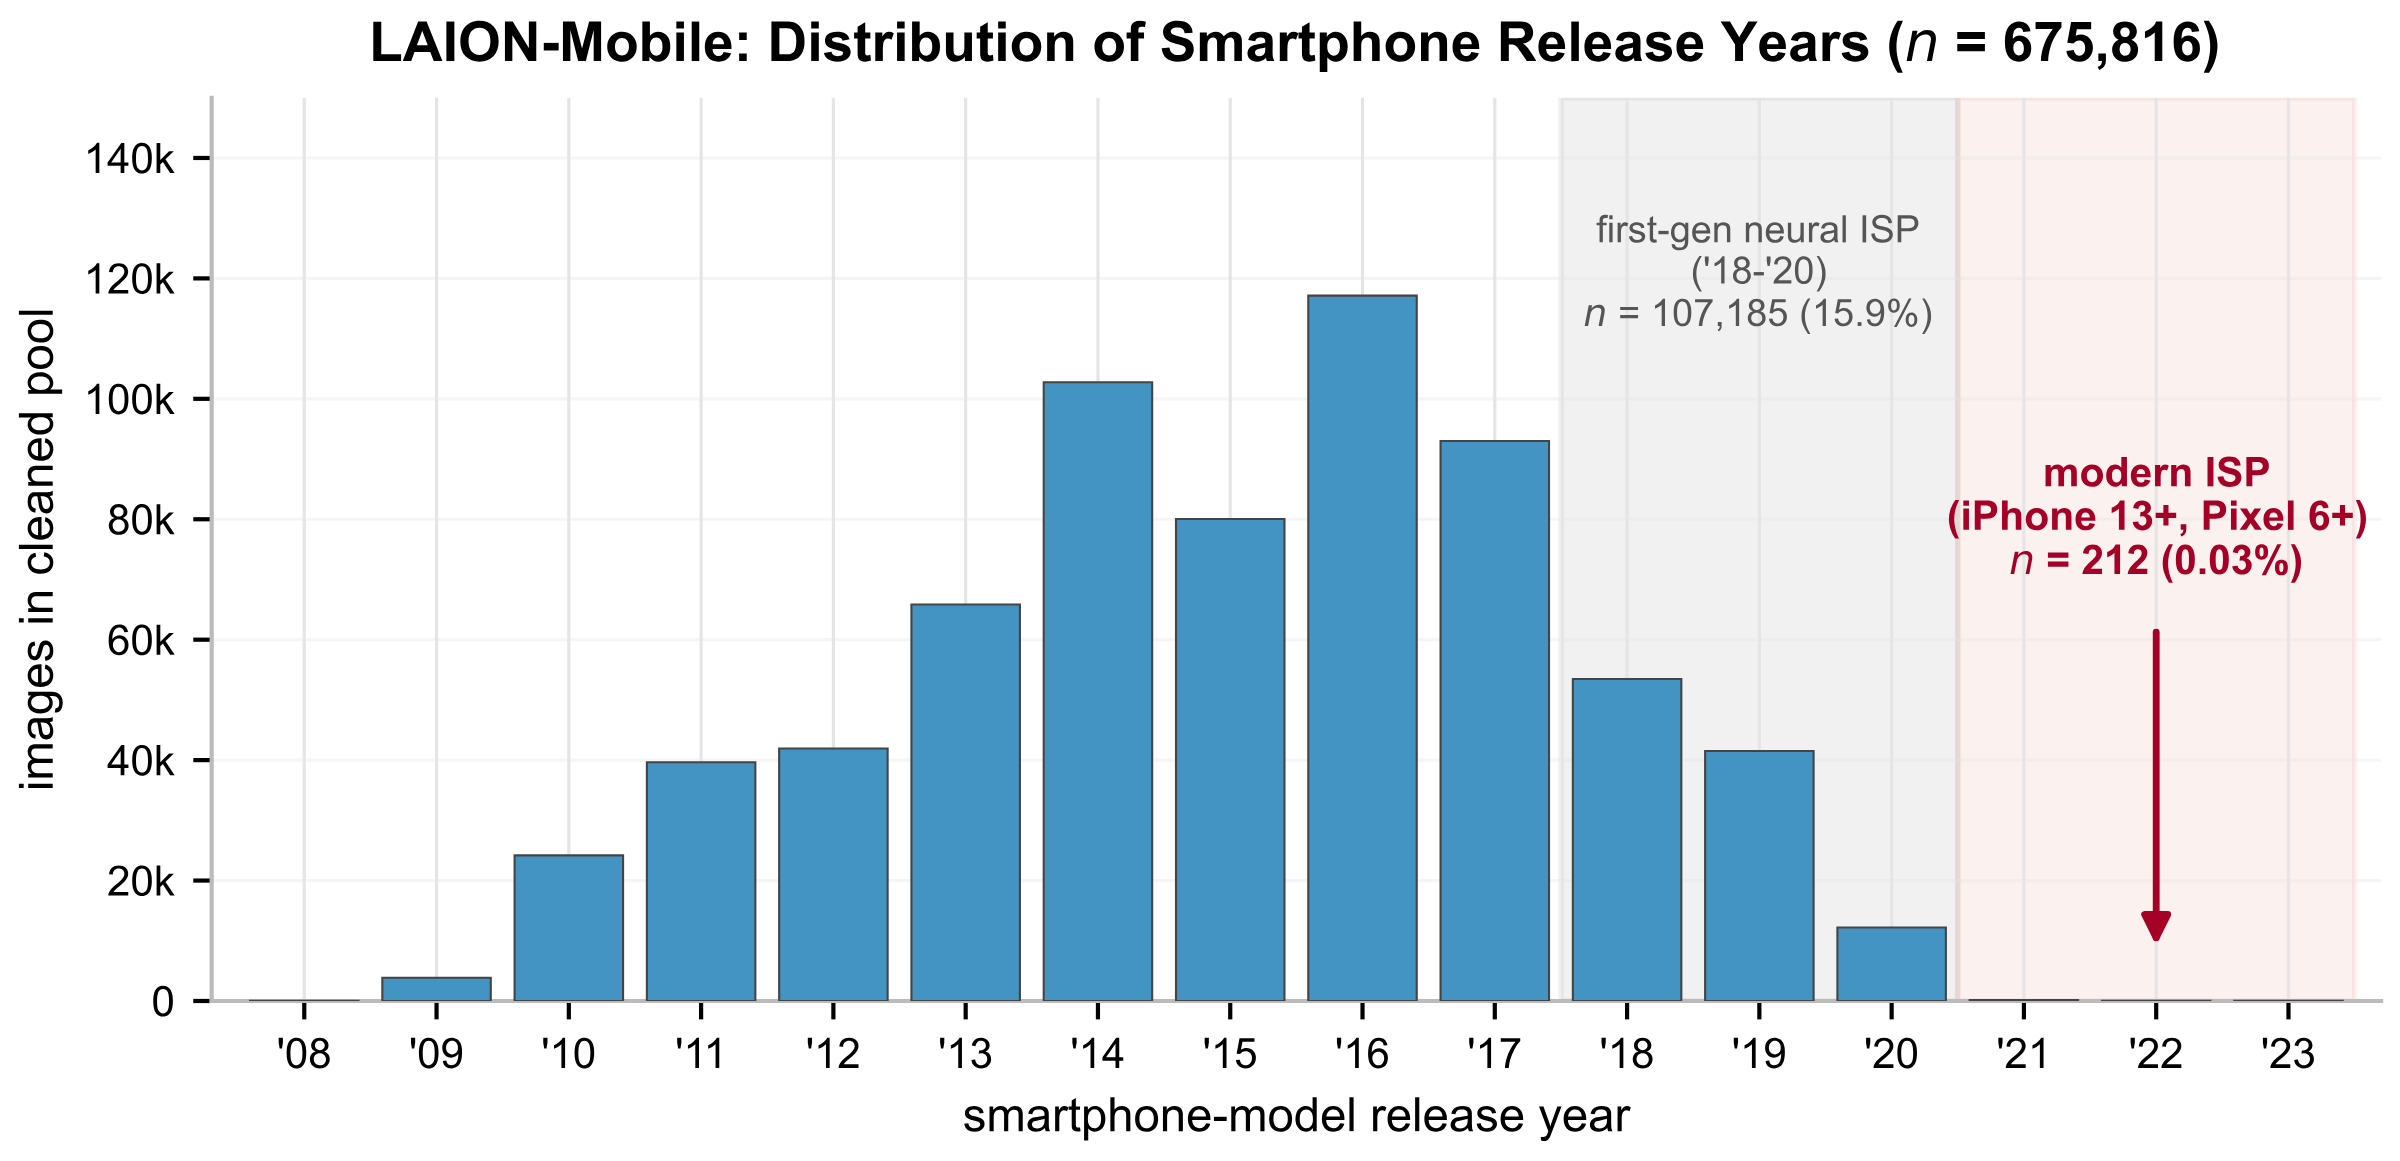
포지션 페이퍼의 예측은 "신경망 ISP가 무거운 폰일수록 오탐이 높다"였다. 기종을 none/light/heavy로 나누고 heavy와 none 빈을 비교(두 비율 z-검정, Benjamini-Hochberg 보정)하면 예측대로 움직이는 탐지기는 두 개뿐이고, 네 개는 반대로 유의하게 움직이며(Tiny-LaDeDa Δ=−0.494, AIDE −0.388), 여섯 개는 차이가 없다. 출시 연도와 가짜 점수의 Spearman 상관도 고주파 탐지기에서 단조 감소다(Tiny-LaDeDa ρ=−0.40, AIDE −0.34). 신형 ISP가 생성 인공물을 더하는 게 아니라, 이 탐지기들이 합성의 증거로 오인하던 노이즈 잔여물을 제거하는 쪽에 가깝다는 해석이다.
하지만 저자들은 이를 "현대 ISP는 무해하다"로 읽지 말라고 강조한다. 위 그림(Figure 4)이 이유다. heavy 빈의 이미지는 전부 20182020년 기기(iPhone XS12, Galaxy S9)에서 왔다. 이는 생성적 텍스처 합성이 아니라 고전적 멀티프레임 디노이징이 주를 이루는 1세대 신경망 ISP다. 출시 연도가 있는 675,816장 중 2021년 이후 기기는 **212장(0.03%)**이고, 포지션 페이퍼가 겨냥한 iPhone 13~15, Pixel 6+ 급은 아예 없다. 2021년 이후에 촬영된 이미지로 한정해도 2021년 이후 하드웨어는 0.3%에 불과하므로, 이는 수집 시점이 아니라 "사람들이 실제로 들고 다니는 기기"를 반영한다. 웹 코퍼스는 가설이 흥미로워지는 바로 그 지점에서 끝난다.
📐 두 논문을 겹쳐 읽기
두 논문은 서로 다른 층위에서 같은 결론으로 수렴한다.
첫째, 벤치마크가 현실을 정의해버렸다. Raza는 FF++ 계열 벤치마크가 "어떤 위협이 딥페이크인가"를 고정했다고 말하고, LAION-Mobile은 ForenSynths 계열 벤치마크와 그 위에서 맞춘 임계값이 "어떤 사진이 진짜인가"를 2019년대 GAN 시절의 인터넷 이미지로 고정했다고 말한다. 전자는 탐지 대상의 분포를, 후자는 음성(negative) 클래스의 분포를 묶어 둔 셈이다. 2025년 시리즈에서 반복해서 언급했던 "일반화 문제"는 이 두 고정의 결과물로 다시 읽힌다.
둘째, 보고된 숫자와 배포 가능성 사이의 거리. 논문 AUC 1.000이 NTIRE에서 0.47(CNNDetection)이나 0.457(Effort)로 떨어지고, 같은 탐지기가 보정 집합에 따라 오탐 3.6%와 91.3%(Effort) 사이를 오간다. Raza의 "모델 역량이 병목이 아니다"라는 주장은 T1에서 탐지기가 충분히 좋다는 뜻이 아니라, 지금의 노력 배분으로는 더 큰 피해를 줄일 수 없다는 뜻으로 읽힌다. LAION-Mobile은 T1 안에서조차 탐지기의 역량이 넉넉하지 않음을 보여주므로, 두 논문을 합치면 "어느 쪽으로 보나 지금의 틀은 부족하다"는 결론이 된다.
셋째, 다음에 필요한 것은 모델보다 측정 도구다. Raza의 세 아젠다는 각각 "지금은 존재하지 않는 벤치마크"(실제 전화 채널·지연 지표, 연합 평가, 재인코딩 강건성·유통 그래프)를 요구한다. LAION-Mobile 역시 다음 단계로 현행 플래그십에서 RAW와 ISP 처리본, image-to-image 생성본을 짝지은 통제 수집 데이터셋을 계획한다. 둘 다 "새 아키텍처"가 아니라 "새 자(ruler)"를 먼저 만들자고 말한다.
🧐 한계와 열린 질문
두 논문 모두 자신의 약점을 비교적 솔직하게 적어 둔다.
Raza의 코퍼스는 보안·포렌식·HCI 학회(CCS, NDSS, USENIX, S&P, FAccT, CHI)를 과소 표집한다. 이 학회들은 "주요 학회" 필터를 통과하지만 키워드 매칭이 거의 안 되는데, NCII·출처 증명·플랫폼 정책 연구의 일부가 여기 있다. 분류는 별도의 수작업 검증 없이 키워드 규칙으로 했고, 경계에서의 동점은 T1 반대 방향으로 깨뜨렸으며 저신뢰 논문을 전부 T1 쪽으로 몰아도 T1 우세가 유지된다는 강건성 검사로 대신했다. 피해 데이터는 영어권·서구 집행 기관에 치우쳐 있다. 저자는 저대표 언어권의 음성·NCII 피해가 논지를 약화시키기보다 강화할 것이라 본다. 그리고 "탐지 연구가 있었기 때문에 정치 딥페이크가 억제된 것 아니냐"는 반론에는, 발생한 사건들이 사람에게 잡혔고 플랫폼 투명성 보고서에 탐지기 배포 증거가 없으며 억제 주장의 반사실 구조가 충족되지 않는다고 답하지만, 이것이 완전한 반증은 아니다.
LAION-Mobile은 진짜만 있는 1-클래스 세트라 자체 AUC를 낼 수 없고, "진짜" 라벨은 EXIF와 필터에 기반한 고정밀 휴리스틱이지 인증된 정답이 아니다(남극 좌표 18건 같은 흔적이 남아 있다). ISP 시대 구분은 제조사 공개 사양에 의존해 펌웨어 업데이트된 기기를 오분류할 수 있고, 무엇보다 코퍼스가 2021년 이전 하드웨어에 치우쳐 현행 플래그십 ISP는 검증하지 못한다. 저작권 때문에 이미지 자체는 재배포하지 않고 매니페스트·EXIF·탐지기 점수·콘텐츠 해시만 공개하므로 URL 소실은 계속 쌓인다.
열린 질문은 결국 하나로 모인다. 2025년에 우리가 추적했던 AUC 경쟁은 어떤 사진을 "진짜"로, 어떤 피해를 "위협"으로 전제하고 있었는가. 두 논문은 그 전제가 2017~2019년에 묶여 있었다고 말한다. 다음 시리즈 글은 아마 탐지기 하나를 더 소개하는 대신, 이 두 전제를 바꾼 벤치마크가 나왔는지를 확인하는 글이 될 것 같다.
📚 참고
- 원문 1: The Deepfakes We Missed: We Built Detectors for a Threat That Didn't Arrive (Shaina Raza, Vector Institute, arXiv 2605.12075, 2026.05) · HTML 버전
- 원문 2: LAION-Mobile: Evaluating Deepfake Detectors On One Million Smartphone Photos (Achim von Stryk, Janis Keuper, Stralsund University / IMLA Offenburg University, arXiv 2609.11134, 2026.09) · HTML 버전 · 데이터셋
- Keuper & Keuper, Position: we need to re-think the concept of "real" images (ICML 2026 position paper)
- NTIRE 2026 challenge on robust AI-generated image detection in the wild (Gushchin et al., arXiv 2604.11487)
- FaceForensics++ (Rössler et al., ICCV 2019), Celeb-DF (Li et al., CVPR 2020), DFDC (Dolhansky et al., 2020)
- 블로그 관련 글: Understanding Audiovisual Deepfake Detection 서베이 리뷰, DeepShield: Fortifying Deepfake Video Detection
본 글의 그림은 원문에서 가져왔습니다.